Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

s3-credentials 0.17

s3-credentials 0.17

New release of my s3-credentials CLI tool for managing credentials needed to access just one S3 bucket. Here are the release notes in full:
  • New commands get-bucket-policy and set-bucket-policy. #91
  • New commands get-public-access-block and set-public-access-block. #92
  • New localserver command for starting a web server that makes time limited credentials accessible via a JSON API. #93

That s3-credentials localserver command (documented here) is a little obscure, but I found myself wanting something like that to help me test out a new feature I'm building to help create temporary Litestream credentials using Amazon STS.

Most of that new feature was built by Claude Code from the following starting prompt:

Add a feature s3-credentials localserver which starts a localhost weberver running (using the Python standard library stuff) on port 8094 by default but -p/--port can set a different port and otherwise takes an option that names a bucket and then takes the same options for read--write/read-only etc as other commands. It also takes a required --refresh-interval option which can be set as 5m or 10h or 30s. All this thing does is reply on / to a GET request with the IAM expiring credentials that allow access to that bucket with that policy for that specified amount of time. It caches internally the credentials it generates and will return the exact same data up until they expire (it also tracks expected expiry time) after which it will generate new credentials (avoiding dog pile effects if multiple requests ask at the same time) and return and cache those instead.

Tags: aws, projects, s3, ai, annotated-release-notes, s3-credentials, prompt-engineering, generative-ai, llms, coding-agents, claude-code

🔲 ☆

ty: An extremely fast Python type checker and LSP

ty: An extremely fast Python type checker and LSP

The team at Astral have been working on this for quite a long time, and are finally releasing the first beta. They have some big performance claims:

Without caching, ty is consistently between 10x and 60x faster than mypy and Pyright. When run in an editor, the gap is even more dramatic. As an example, after editing a load-bearing file in the PyTorch repository, ty recomputes diagnostics in 4.7ms: 80x faster than Pyright (386ms) and 500x faster than Pyrefly (2.38 seconds). ty is very fast!

The easiest way to try it out is via uvx:

cd my-python-project/
uvx ty check

I tried it against sqlite-utils and it turns out I have quite a lot of work to do!

Astral also released a new VS Code extension adding ty-powered language server features like go to definition. I'm still getting my head around how this works and what it can do.

Via Hacker News

Tags: python, vs-code, astral

🔲 ☆

Useful patterns for building HTML tools

I've started using the term HTML tools to refer to HTML applications that I've been building which combine HTML, JavaScript, and CSS in a single file and use them to provide useful functionality. I have built over 150 of these in the past two years, almost all of them written by LLMs. This article presents a collection of useful patterns I've discovered along the way.

First, some examples to show the kind of thing I'm talking about:

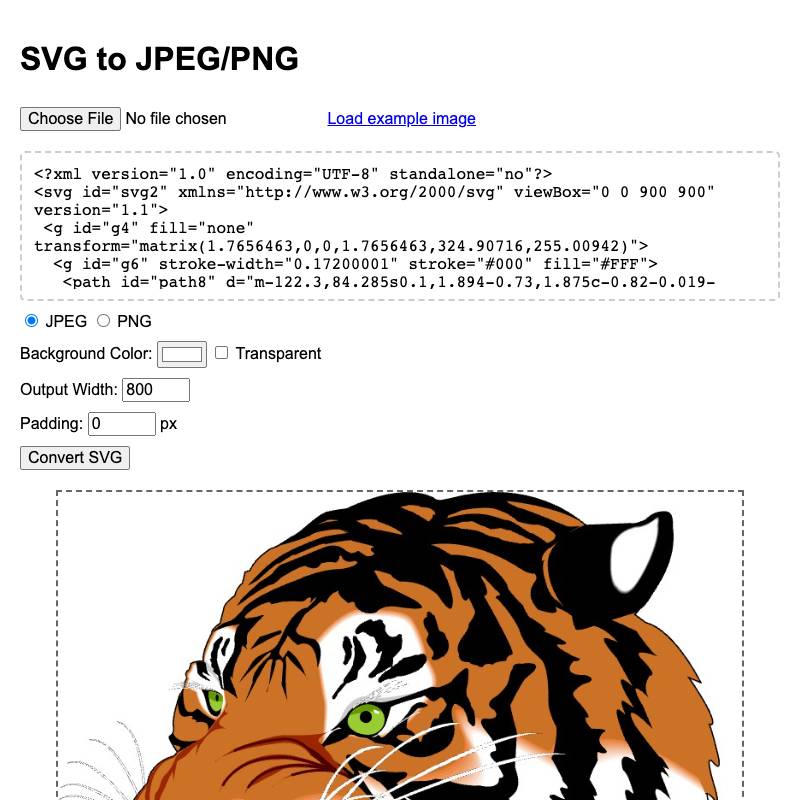
  • svg-render renders SVG code to downloadable JPEGs or PNGs
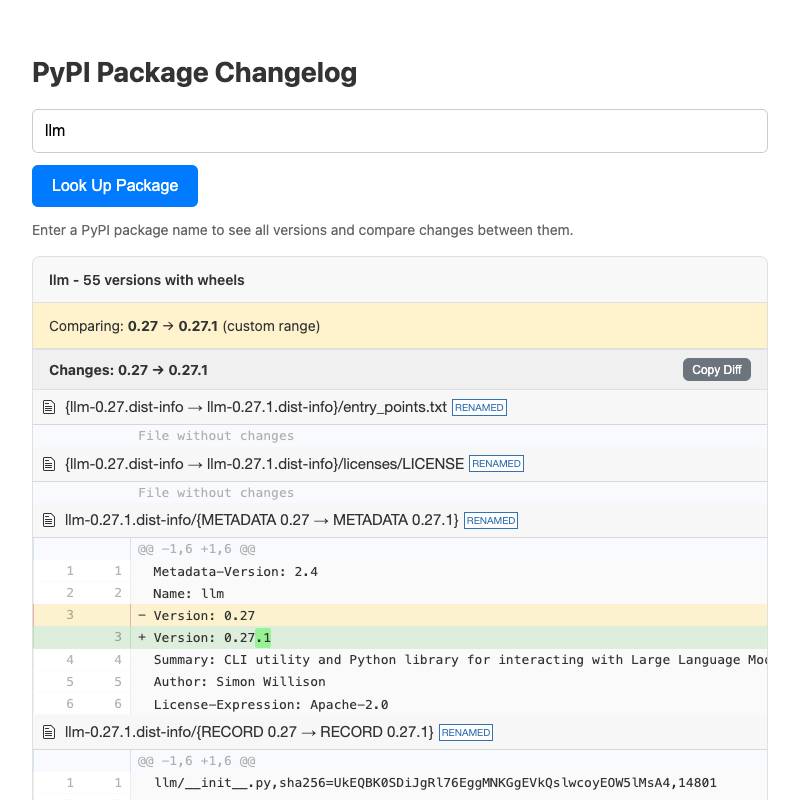
  • pypi-changelog lets you generate (and copy to clipboard) diffs between different PyPI package releases.
  • bluesky-thread provides a nested view of a discussion thread on Bluesky.
screenshot of svg-render screenshot of pypi-changelog screenshot of bluesky-thread

These are some of my recent favorites. I have dozens more like this that I use on a regular basis.

You can explore my collection on tools.simonwillison.net - the by month view is useful for browsing the entire collection.

If you want to see the code and prompts, almost all of the examples in this post include a link in their footer to "view source" on GitHub. The GitHub commits usually contain either the prompt itself or a link to the transcript used to create the tool.

The anatomy of an HTML tool

These are the characteristics I have found to be most productive in building tools of this nature:

  1. A single file: inline JavaScript and CSS in a single HTML file means the least hassle in hosting or distributing them, and crucially means you can copy and paste them out of an LLM response.
  2. Avoid React, or anything with a build step. The problem with React is that JSX requires a build step, which makes everything massively less convenient. I prompt "no react" and skip that whole rabbit hole entirely.
  3. Load dependencies from a CDN. The fewer dependencies the better, but if there's a well known library that helps solve a problem I'm happy to load it from CDNjs or jsdelivr or similar.
  4. Keep them small. A few hundred lines means the maintainability of the code doesn't matter too much: any good LLM can read them and understand what they're doing, and rewriting them from scratch with help from an LLM takes just a few minutes.

The end result is a few hundred lines of code that can be cleanly copied and pasted into a GitHub repository.

Prototype with Artifacts or Canvas

The easiest way to build one of these tools is to start in ChatGPT or Claude or Gemini. All three have features where they can write a simple HTML+JavaScript application and show it to you directly.

Claude calls this "Artifacts", ChatGPT and Gemini both call it "Canvas". Claude has the feature enabled by default, ChatGPT and Gemini may require you to toggle it on in their "tools" menus.

Try this prompt in Gemini or ChatGPT:

Build a canvas that lets me paste in JSON and converts it to YAML. No React.

Or this prompt in Claude:

Build an artifact that lets me paste in JSON and converts it to YAML. No React.

I always add "No React" to these prompts, because otherwise they tend to build with React, resulting in a file that is harder to copy and paste out of the LLM and use elsewhere. I find that attempts which use React take longer to display (since they need to run a build step) and are more likely to contain crashing bugs for some reason, especially in ChatGPT.

All three tools have "share" links that provide a URL to the finished application. Examples:

Switch to a coding agent for more complex projects

Coding agents such as Claude Code and Codex CLI have the advantage that they can test the code themselves while they work on it using tools like Playwright. I often upgrade to one of those when I'm working on something more complicated, like my Bluesky thread viewer tool shown above.

I also frequently use asynchronous coding agents like Claude Code for web to make changes to existing tools. I shared a video about that in Building a tool to copy-paste share terminal sessions using Claude Code for web.

Claude Code for web and Codex Cloud run directly against my simonw/tools repo, which means they can publish or upgrade tools via Pull Requests (here are dozens of examples) without me needing to copy and paste anything myself.

Load dependencies from CDNs

Any time I use an additional JavaScript library as part of my tool I like to load it from a CDN.

The three major LLM platforms support specific CDNs as part of their Artifacts or Canvas features, so often if you tell them "Use PDF.js" or similar they'll be able to compose a URL to a CDN that's on their allow-list.

Sometimes you'll need to go and look up the URL on cdnjs or jsDelivr and paste it into the chat.

CDNs like these have been around for long enough that I've grown to trust them, especially for URLs that include the package version.

The alternative to CDNs is to use npm and have a build step for your projects. I find this reduces my productivity at hacking on individual tools and makes it harder to self-host them.

Host them somewhere else

I don't like leaving my HTML tools hosted by the LLM platforms themselves for a couple of reasons. First, LLM platforms tend to run the tools inside a tight sandbox with a lot of restrictions. They're often unable to load data or images from external URLs, and sometimes even features like linking out to other sites are disabled.

The end-user experience often isn't great either. They show warning messages to new users, often take additional time to load and delight in showing promotions for the platform that was used to create the tool.

They're also not as reliable as other forms of static hosting. If ChatGPT or Claude are having an outage I'd like to still be able to access the tools I've created in the past.

Being able to easily self-host is the main reason I like insisting on "no React" and using CDNs for dependencies - the absence of a build step makes hosting tools elsewhere a simple case of copying and pasting them out to some other provider.

My preferred provider here is GitHub Pages because I can paste a block of HTML into a file on github.com and have it hosted on a permanent URL a few seconds later. Most of my tools end up in my simonw/tools repository which is configured to serve static files at tools.simonwillison.net.

Take advantage of copy and paste

One of the most useful input/output mechanisms for HTML tools comes in the form of copy and paste.

I frequently build tools that accept pasted content, transform it in some way and let the user copy it back to their clipboard to paste somewhere else.

Copy and paste on mobile phones is fiddly, so I frequently include "Copy to clipboard" buttons that populate the clipboard with a single touch.

Most operating system clipboards can carry multiple formats of the same copied data. That's why you can paste content from a word processor in a way that preserves formatting, but if you paste the same thing into a text editor you'll get the content with formatting stripped.

These rich copy operations are available in JavaScript paste events as well, which opens up all sorts of opportunities for HTML tools.

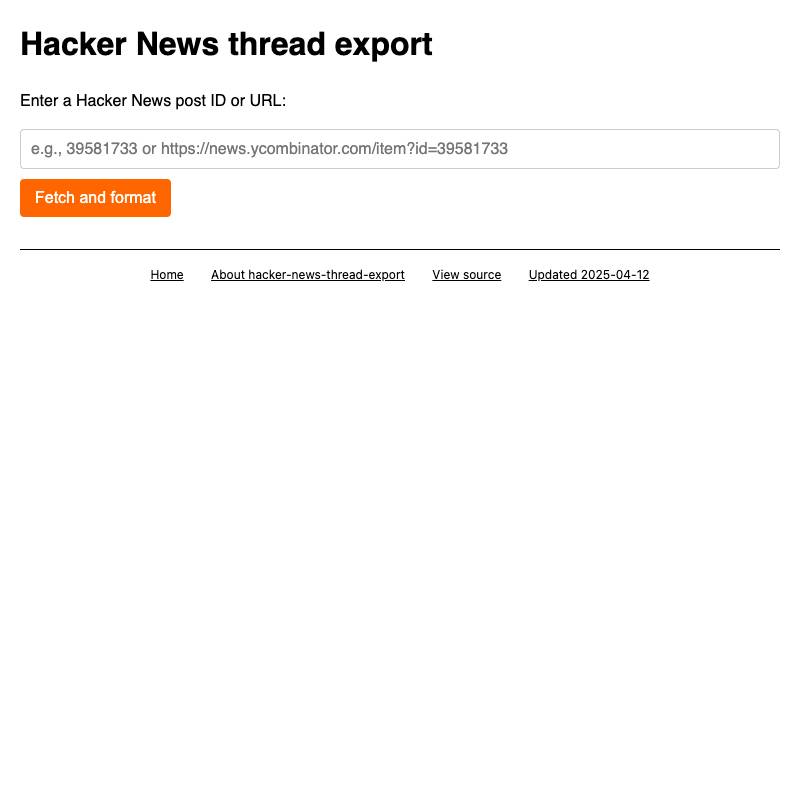
  • hacker-news-thread-export lets you paste in a URL to a Hacker News thread and gives you a copyable condensed version of the entire thread, suitable for pasting into an LLM to get a useful summary.
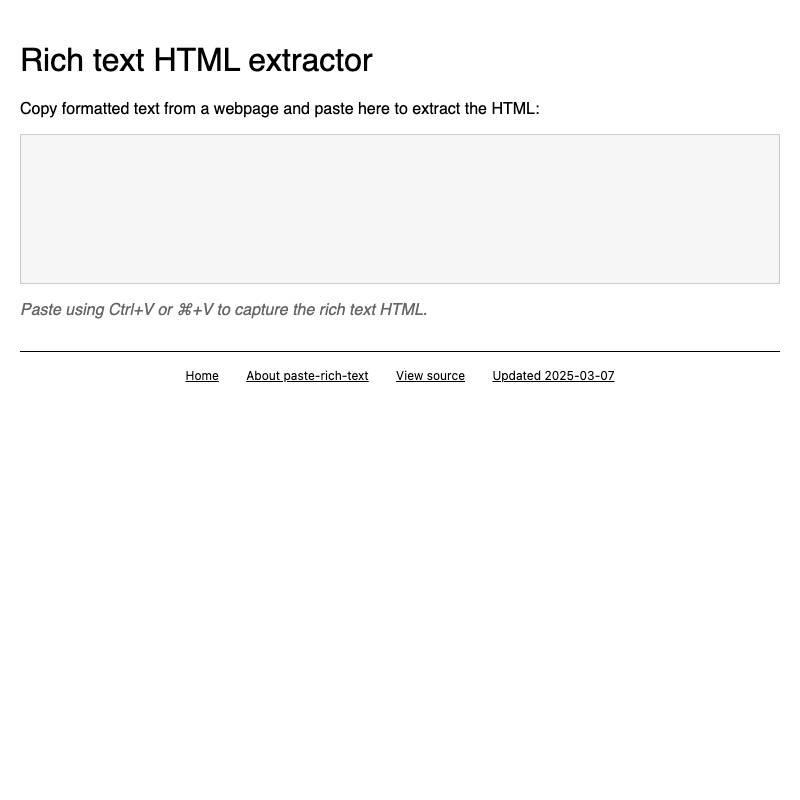
  • paste-rich-text lets you copy from a page and paste to get the HTML - particularly useful on mobile where view-source isn't available.
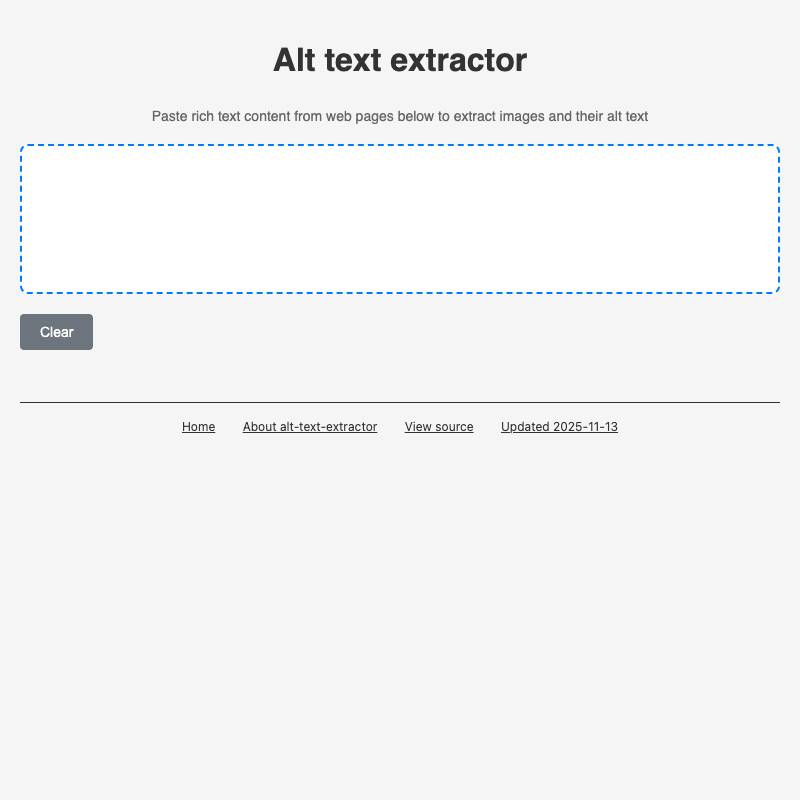
  • alt-text-extractor lets you paste in images and then copy out their alt text.
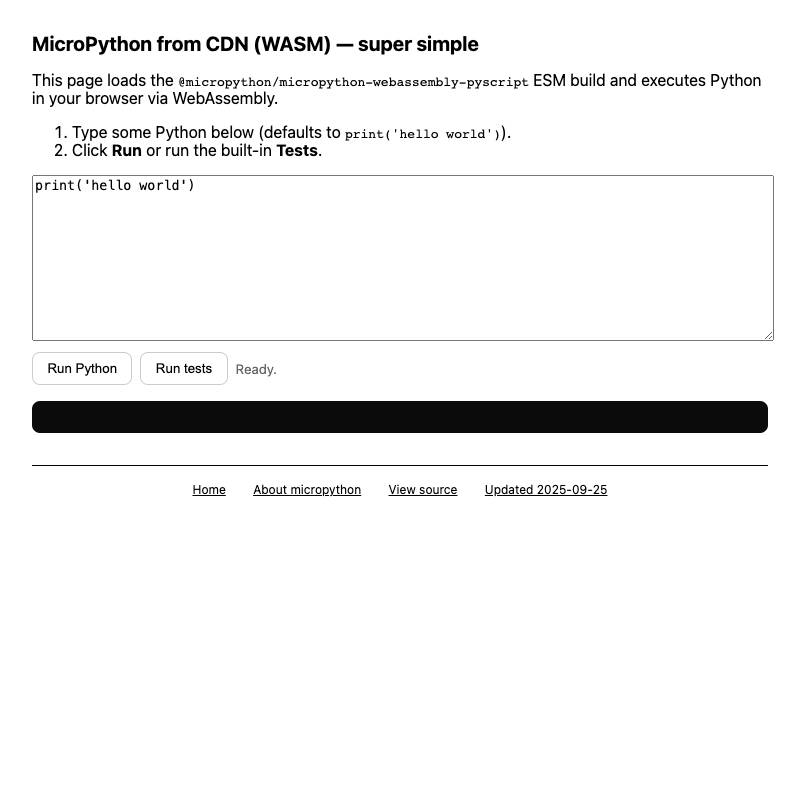
screenshot of hacker-news-thread-export screenshot of paste-rich-text screenshot of alt-text-extractor

Build debugging tools

The key to building interesting HTML tools is understanding what's possible. Building custom debugging tools is a great way to explore these options.

clipboard-viewer is one of my most useful. You can paste anything into it (text, rich text, images, files) and it will loop through and show you every type of paste data that's available on the clipboard.
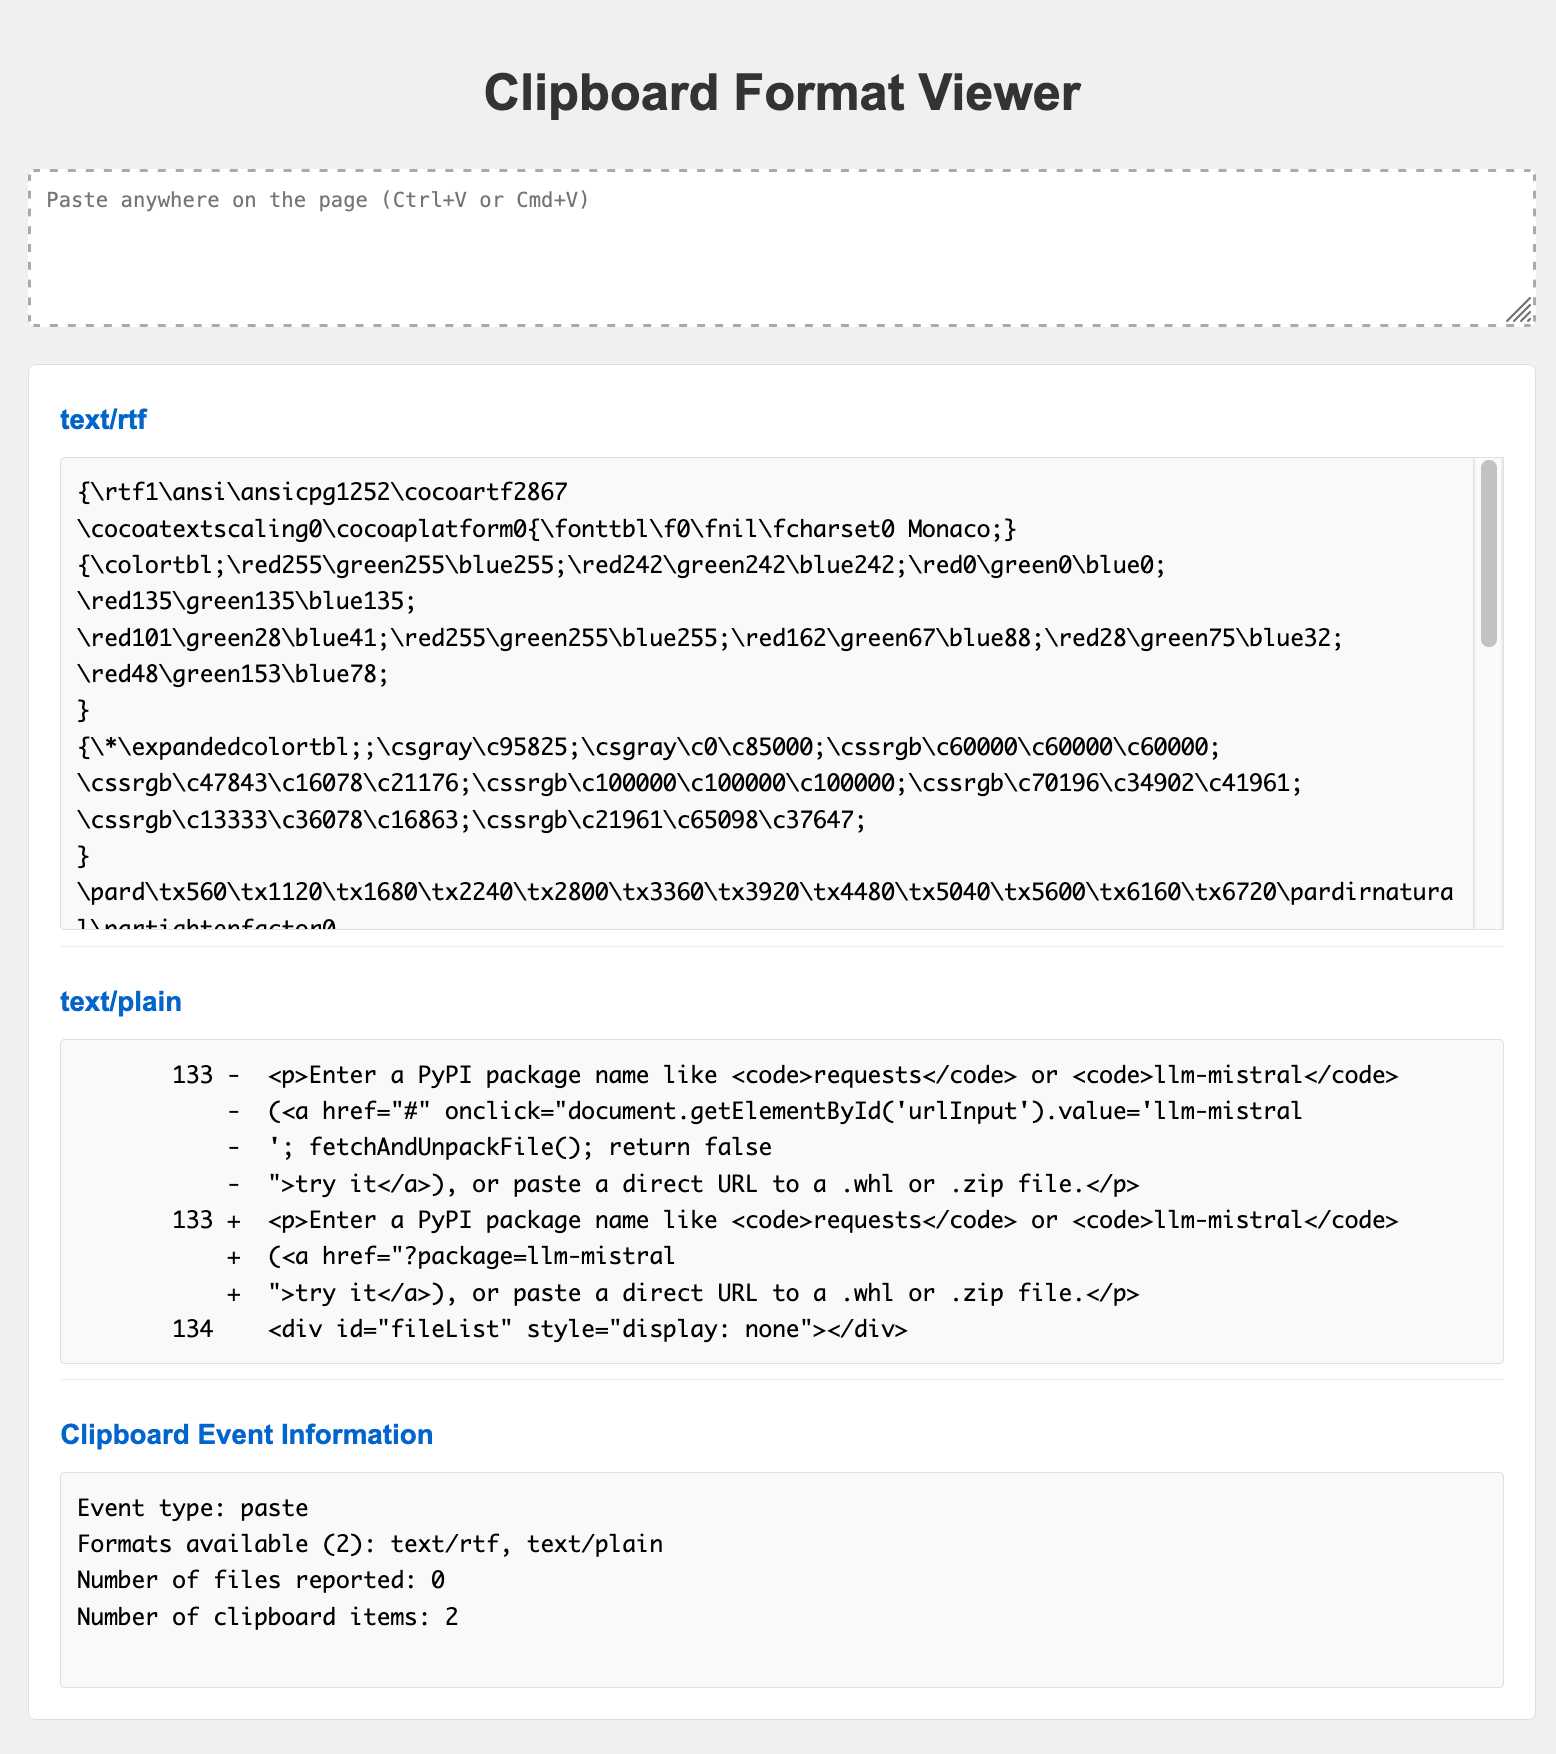
Clipboard Format Viewer. Paste anywhere on the page (Ctrl+V or Cmd+V). This shows text/rtf with a bunch of weird code, text/plain with some pasted HTML diff and a Clipboard Event Information panel that says Event type: paste, Formats available: text/rtf, text/plain, 0 files reported and 2 clipboard items reported.

This was key to building many of my other tools, because it showed me the invisible data that I could use to bootstrap other interesting pieces of functionality.

More debugging examples:

  • keyboard-debug shows the keys (and KeyCode values) currently being held down.
  • cors-fetch reveals if a URL can be accessed via CORS.
  • exif displays EXIF data for a selected photo.
screenshot of keyboard-debug screenshot of cors-fetch screenshot of exif

Persist state in the URL

HTML tools may not have access to server-side databases for storage but it turns out you can store a lot of state directly in the URL.

I like this for tools I may want to bookmark or share with other people.

  • icon-editor is a custom 24x24 icon editor I built to help hack on icons for the GitHub Universe badge. It persists your in-progress icon design in the URL so you can easily bookmark and share it.

Use localStorage for secrets or larger state

The localStorage browser API lets HTML tools store data persistently on the user's device, without exposing that data to the server.

I use this for larger pieces of state that don't fit comfortably in a URL, or for secrets like API keys which I really don't want anywhere near my server - even static hosts might have server logs that are outside of my influence.

  • word-counter is a simple tool I built to help me write to specific word counts, for things like conference abstract submissions. It uses localStorage to save as you type, so your work isn't lost if you accidentally close the tab.
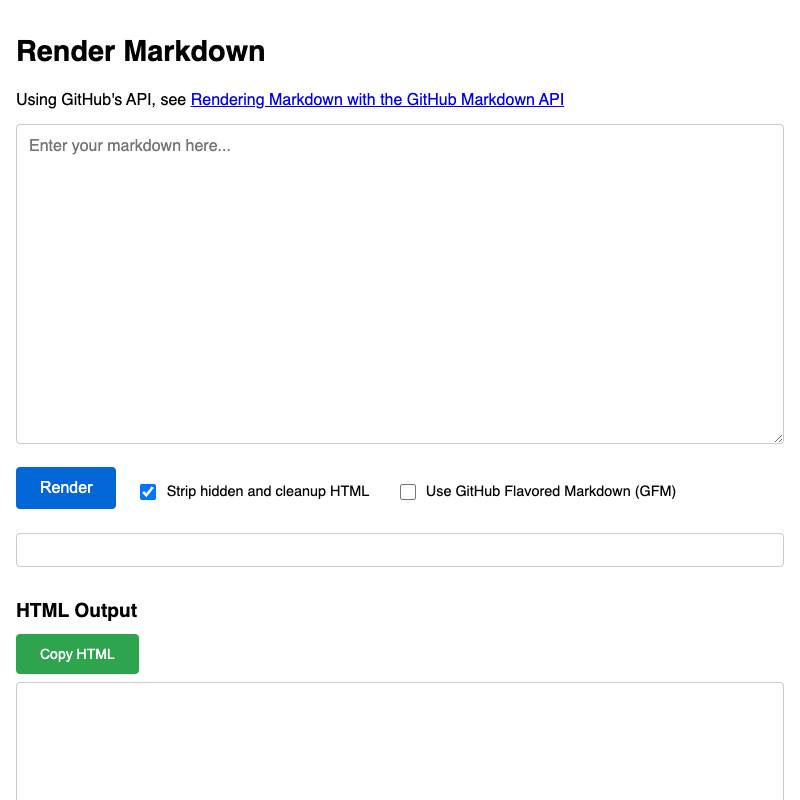
  • render-markdown uses the same trick - I sometimes use this one to craft blog posts and I don't want to lose them.
  • haiku is one of a number of LLM demos I've built that request an API key from the user (via the prompt() function) and then store that in localStorage. This one uses Claude Haiku to write haikus about what it can see through the user's webcam.
screenshot of word-counter screenshot of render-markdown screenshot of haiku

Collect CORS-enabled APIs

CORS stands for Cross-origin resource sharing. It's a relatively low-level detail which controls if JavaScript running on one site is able to fetch data from APIs hosted on other domains.

APIs that provide open CORS headers are a goldmine for HTML tools. It's worth building a collection of these over time.

Here are some I like:

  • iNaturalist for fetching sightings of animals, including URLs to photos
  • PyPI for fetching details of Python packages
  • GitHub because anything in a public repository in GitHub has a CORS-enabled anonymous API for fetching that content from the raw.githubusercontent.com domain, which is behind a caching CDN so you don't need to worry too much about rate limits or feel guilty about adding load to their infrastructure.
  • Bluesky for all sorts of operations
  • Mastodon has generous CORS policies too, as used by applications like phanpy.social

GitHub Gists are a personal favorite here, because they let you build apps that can persist state to a permanent Gist through making a cross-origin API call.

  • species-observation-map uses iNaturalist to show a map of recent sightings of a particular species.
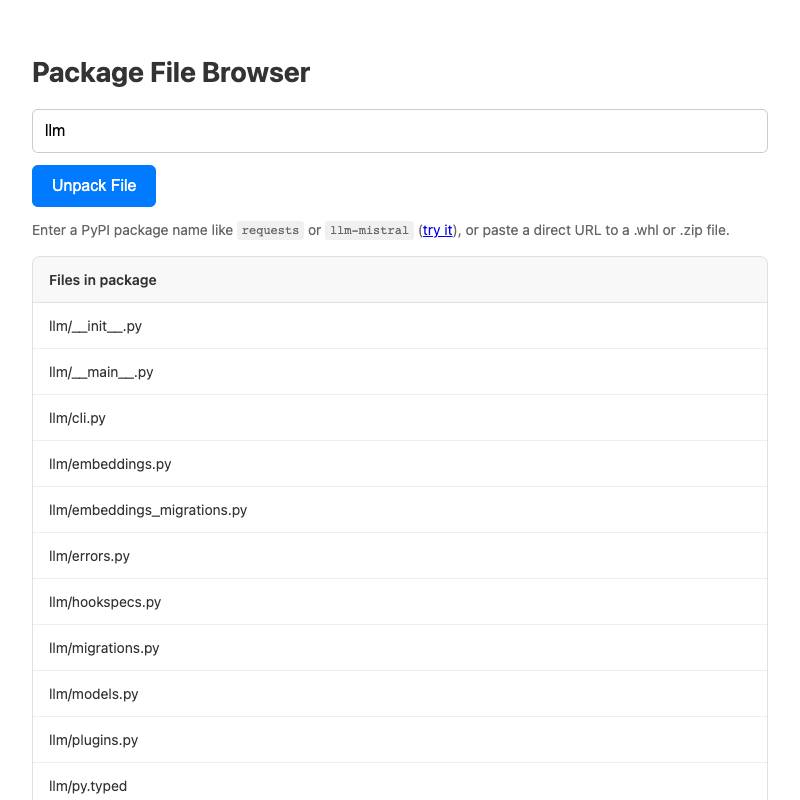
  • zip-wheel-explorer fetches a .whl file for a Python package from PyPI, unzips it (in browser memory) and lets you navigate the files.
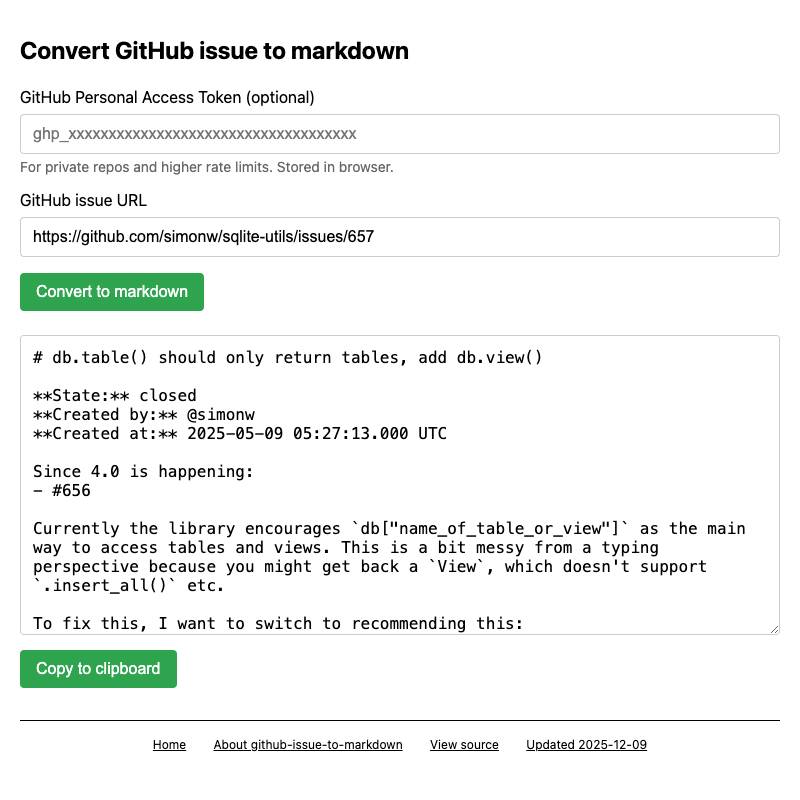
  • github-issue-to-markdown fetches issue details and comments from the GitHub API (including expanding any permanent code links) and turns them into copyable Markdown.
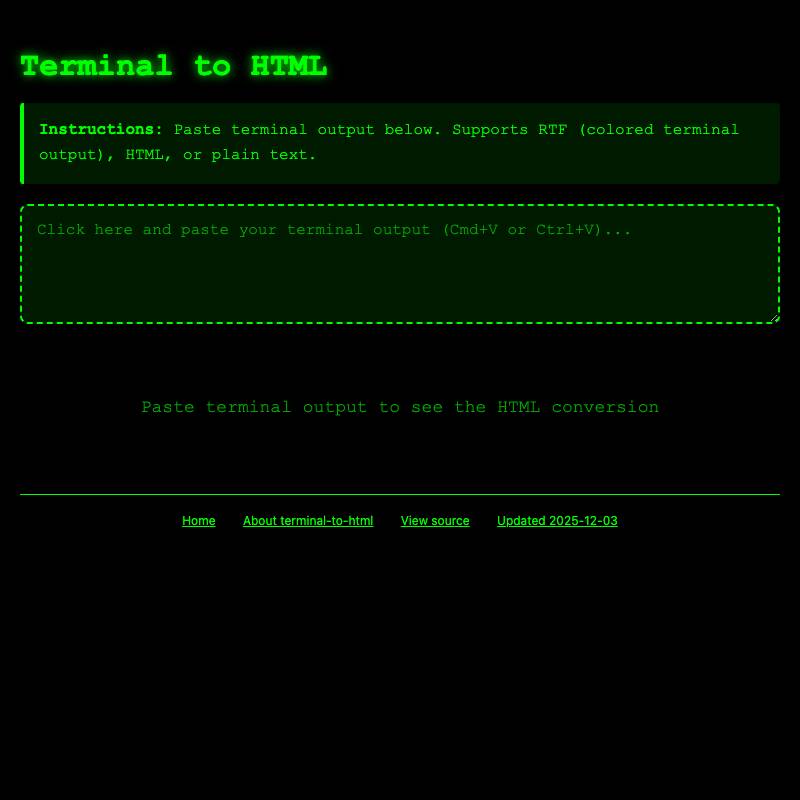
  • terminal-to-html can optionally save the user's converted terminal session to a Gist.
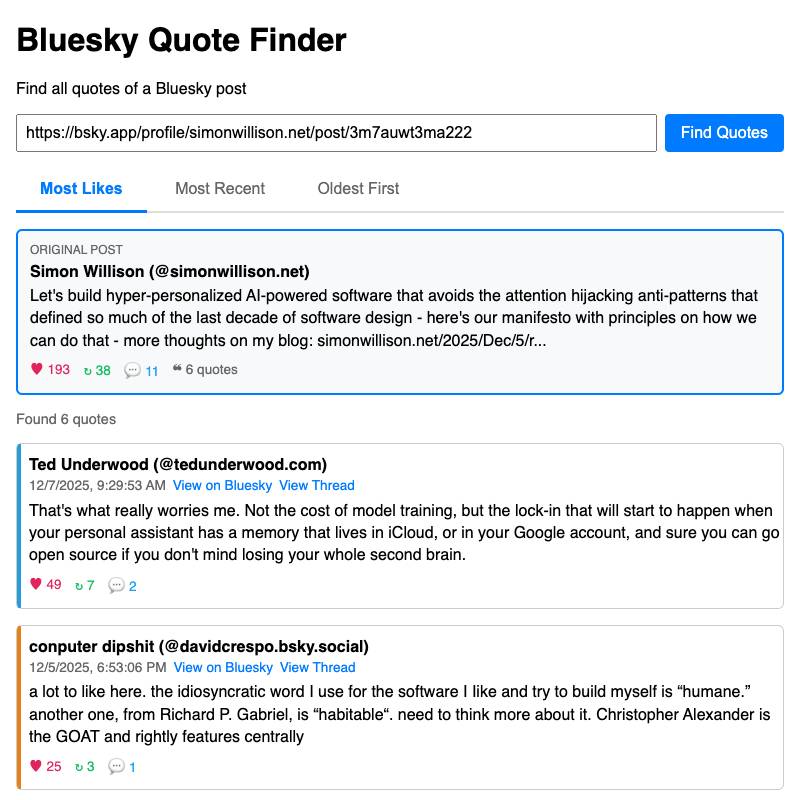
  • bluesky-quote-finder displays quotes of a specified Bluesky post, which can then be sorted by likes or by time.
screenshot of species-observation-map screenshot of zip-wheel-explorer screenshot of github-issue-to-markdown screenshot of terminal-to-html screenshot of bluesky-quote-finder

LLMs can be called directly via CORS

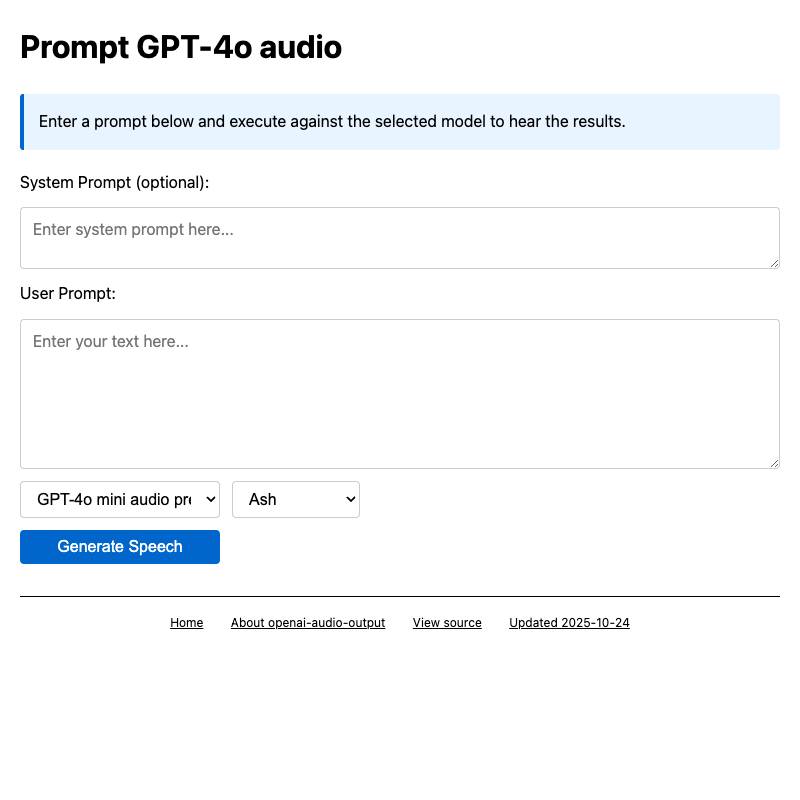
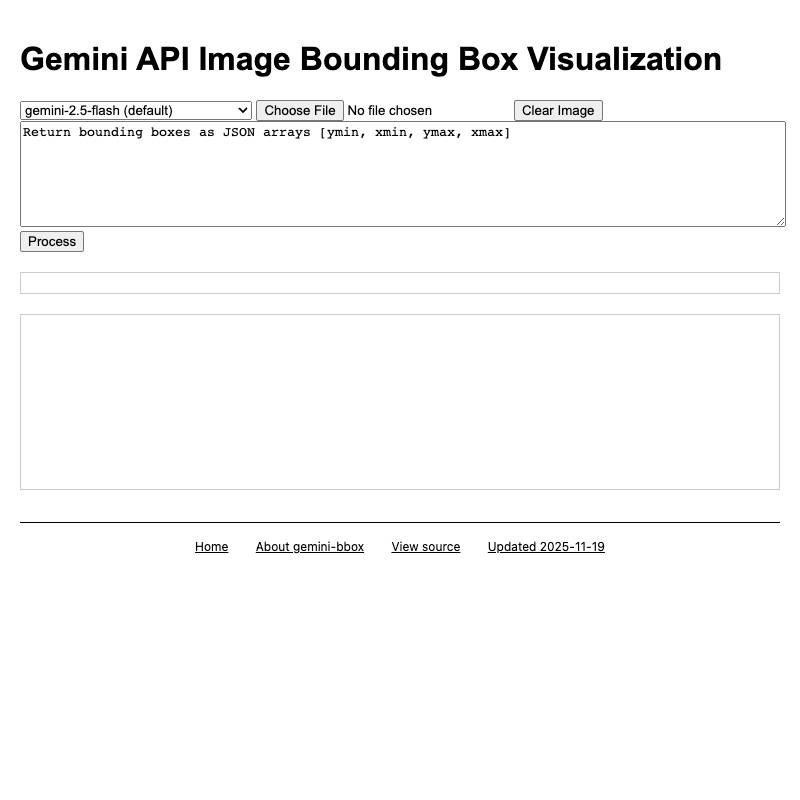
All three of OpenAI, Anthropic and Gemini offer JSON APIs that can be accessed via CORS directly from HTML tools.

Unfortunately you still need an API key, and if you bake that key into your visible HTML anyone can steal it and use to rack up charges on your account.

I use the localStorage secrets pattern to store API keys for these services. This sucks from a user experience perspective - telling users to go and create an API key and paste it into a tool is a lot of friction - but it does work.

Some examples:

screenshot of haiku screenshot of openai-audio-output screenshot of gemini-bbox

Don't be afraid of opening files

You don't need to upload a file to a server in order to make use of the <input type="file"> element. JavaScript can access the content of that file directly, which opens up a wealth of opportunities for useful functionality.

Some examples:

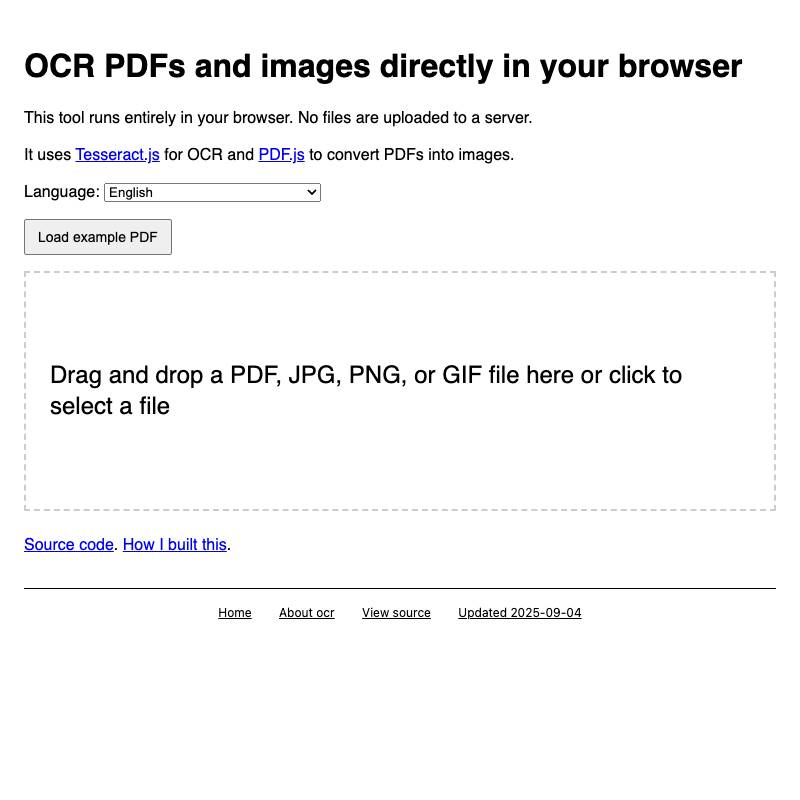
  • ocr is the first tool I built for my collection, described in Running OCR against PDFs and images directly in your browser. It uses PDF.js and Tesseract.js to allow users to open a PDF in their browser which it then converts to an image-per-page and runs through OCR.
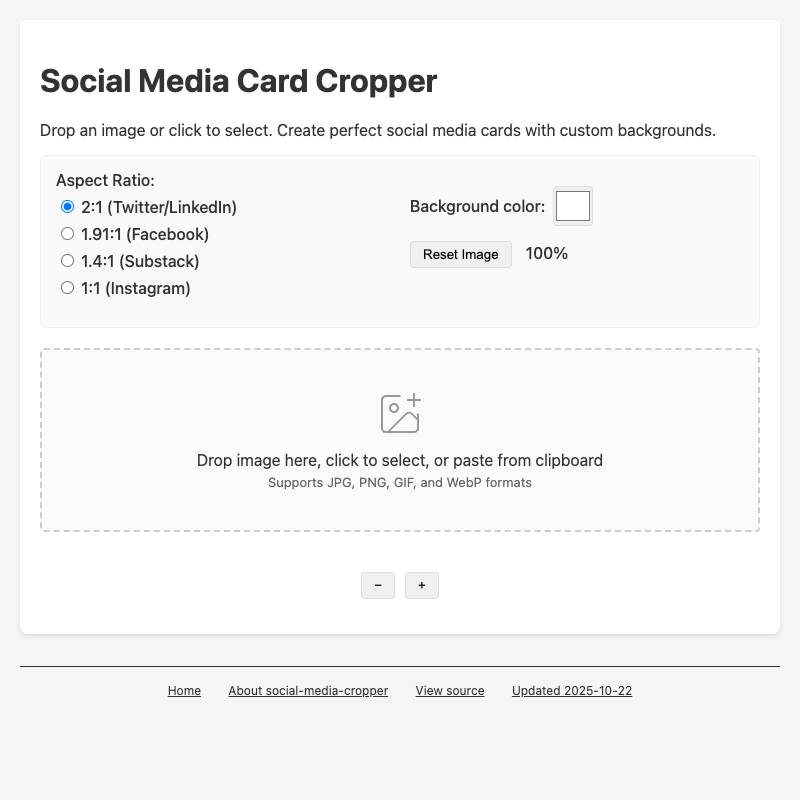
  • social-media-cropper lets you open (or paste in) an existing image and then crop it to common dimensions needed for different social media platforms - 2:1 for Twitter and LinkedIn, 1.4:1 for Substack etc.
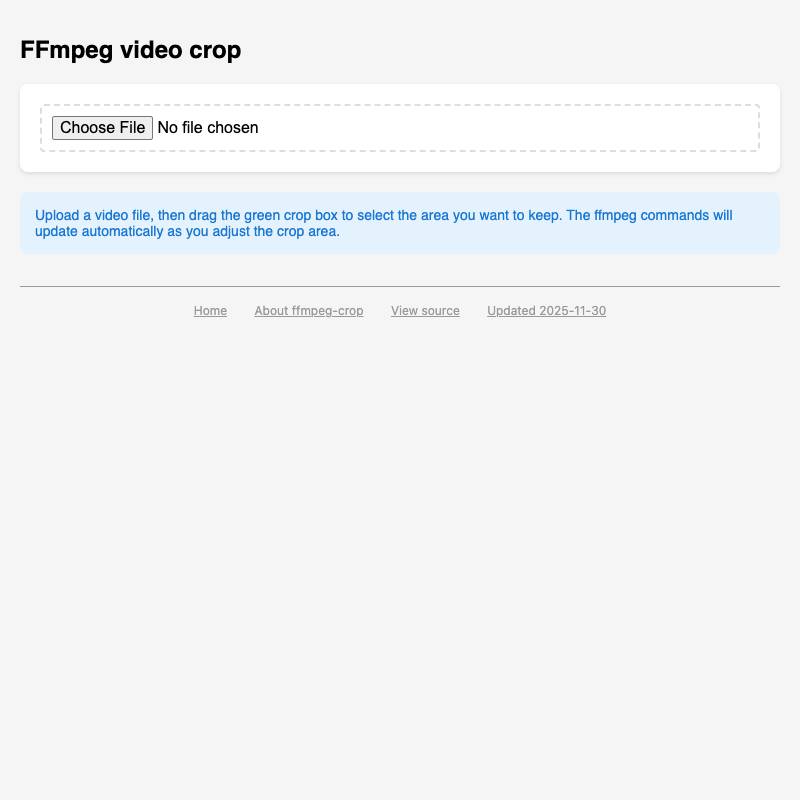
  • ffmpeg-crop lets you open and preview a video file in your browser, drag a crop box within it and then copy out the ffmpeg command needed to produce a cropped copy on your own machine.
screenshot of ocr screenshot of social-media-cropper screenshot of ffmpeg-crop

You can offer downloadable files too

An HTML tool can generate a file for download without needing help from a server.

The JavaScript library ecosystem has a huge range of packages for generating files in all kinds of useful formats.

screenshot of svg-render screenshot of social-media-cropper screenshot of open-sauce-2025

Pyodide can run Python code in the browser

Pyodide is a distribution of Python that's compiled to WebAssembly and designed to run directly in browsers. It's an engineering marvel and one of the most underrated corners of the Python world.

It also cleanly loads from a CDN, which means there's no reason not to use it in HTML tools!

Even better, the Pyodide project includes micropip - a mechanism that can load extra pure-Python packages from PyPI via CORS.

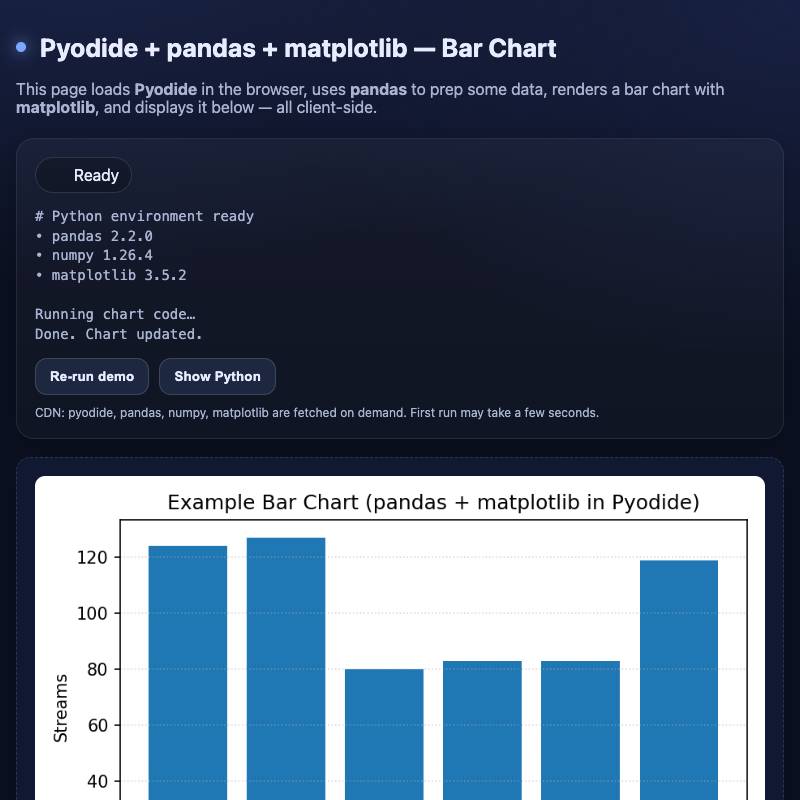
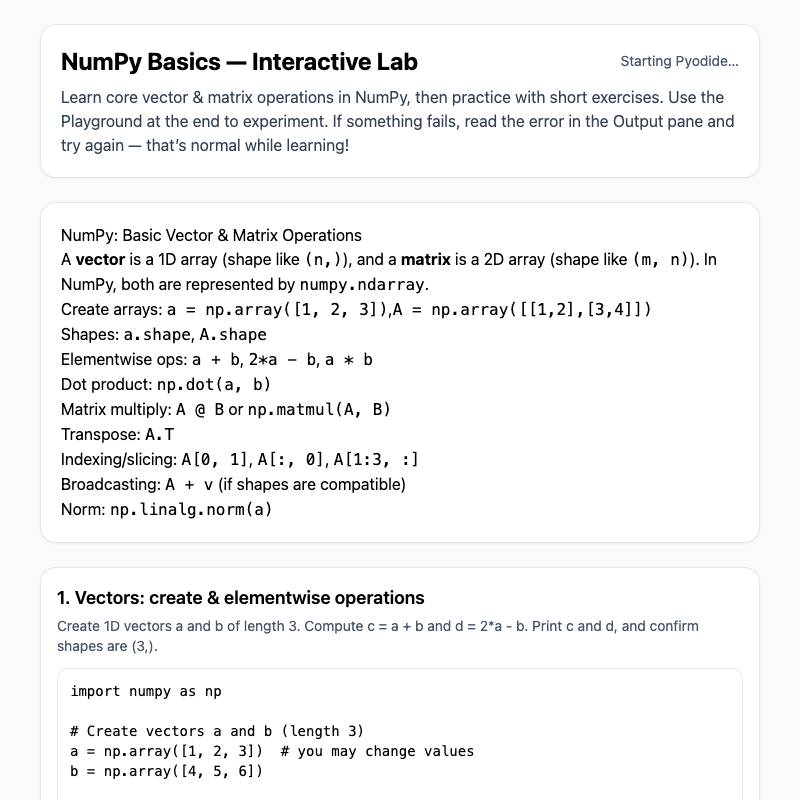
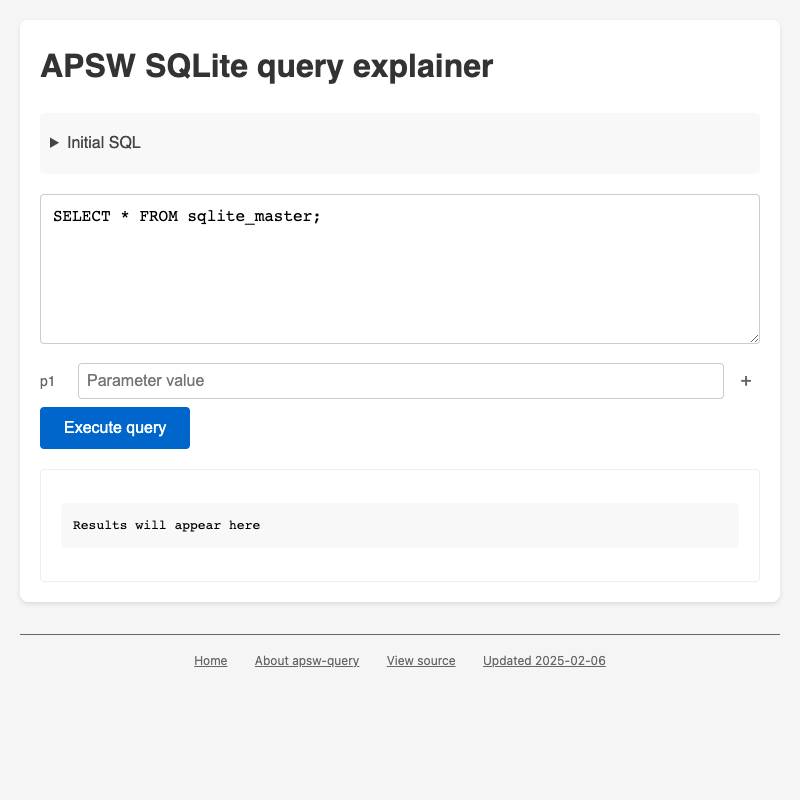
screenshot of pyodide-bar-chart screenshot of numpy-pyodide-lab screenshot of apsw-query

WebAssembly opens more possibilities

Pyodide is possible thanks to WebAssembly. WebAssembly means that a vast collection of software originally written in other languages can now be loaded in HTML tools as well.

Squoosh.app was the first example I saw that convinced me of the power of this pattern - it makes several best-in-class image compression libraries available directly in the browser.

I've used WebAssembly for a few of my own tools:

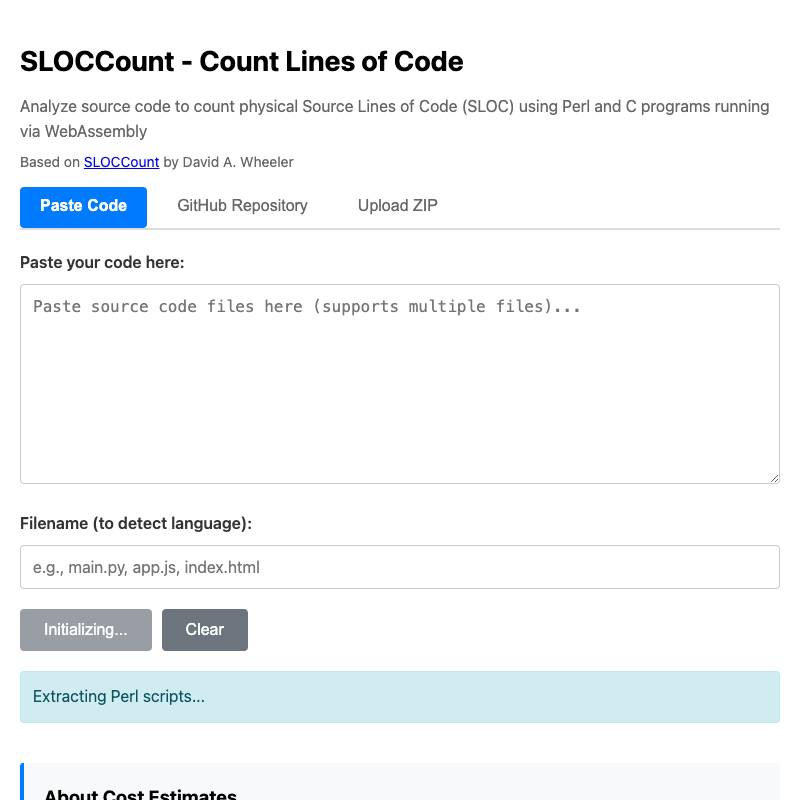
screenshot of ocr screenshot of sloccount screenshot of micropython

Remix your previous tools

The biggest advantage of having a single public collection of 100+ tools is that it's easy for my LLM assistants to recombine them in interesting ways.

Sometimes I'll copy and paste a previous tool into the context, but when I'm working with a coding agent I can reference them by name - or tell the agent to search for relevant examples before it starts work.

The source code of any working tool doubles as clear documentation of how something can be done, including patterns for using editing libraries. An LLM with one or two existing tools in their context is much more likely to produce working code.

I built pypi-changelog by telling Claude Code:

Look at the pypi package explorer tool

And then, after it had found and read the source code for zip-wheel-explorer:

Build a new tool pypi-changelog.html which uses the PyPI API to get the wheel URLs of all available versions of a package, then it displays them in a list where each pair has a "Show changes" clickable in between them - clicking on that fetches the full contents of the wheels and displays a nicely rendered diff representing the difference between the two, as close to a standard diff format as you can get with JS libraries from CDNs, and when that is displayed there is a "Copy" button which copies that diff to the clipboard

Here's the full transcript.

See Running OCR against PDFs and images directly in your browser for another detailed example of remixing tools to create something new.

Record the prompt and transcript

I like keeping (and publishing) records of everything I do with LLMs, to help me grow my skills at using them over time.

For HTML tools I built by chatting with an LLM platform directly I use the "share" feature for those platforms.

For Claude Code or Codex CLI or other coding agents I copy and paste the full transcript from the terminal into my terminal-to-html tool and share that using a Gist.

In either case I include links to those transcripts in the commit message when I save the finished tool to my repository. You can see those in my tools.simonwillison.net colophon.

Go forth and build

I've had so much fun exploring the capabilities of LLMs in this way over the past year and a half, and building tools in this way has been invaluable in helping me understand both the potential for building tools with HTML and the capabilities of the LLMs that I'm building them with.

If you're interested in starting your own collection I highly recommend it! All you need to get started is a free GitHub repository with GitHub Pages enabled (Settings -> Pages -> Source -> Deploy from a branch -> main) and you can start copying in .html pages generated in whatever manner you like.

Bonus transcript: Here's how I used Claude Code and shot-scraper to add the screenshots to this post.

Tags: definitions, github, html, javascript, projects, tools, ai, webassembly, generative-ai, llms, ai-assisted-programming, vibe-coding, coding-agents, claude-code

🔲 ☆

Dark mode

I've never been particularly invested dark v.s. light mode but I get enough people complaining that this site is "blinding" that I decided to see if Claude Code for web could produce a useful dark mode from my existing CSS. It did a decent job, using CSS properties, @media (prefers-color-scheme: dark) and a data-theme="dark" attribute based on this prompt:

Add a dark theme which is triggered by user media preferences but can also be switched on using localStorage - then put a little icon in the footer for toggling it between default auto, forced regular and forced dark mode

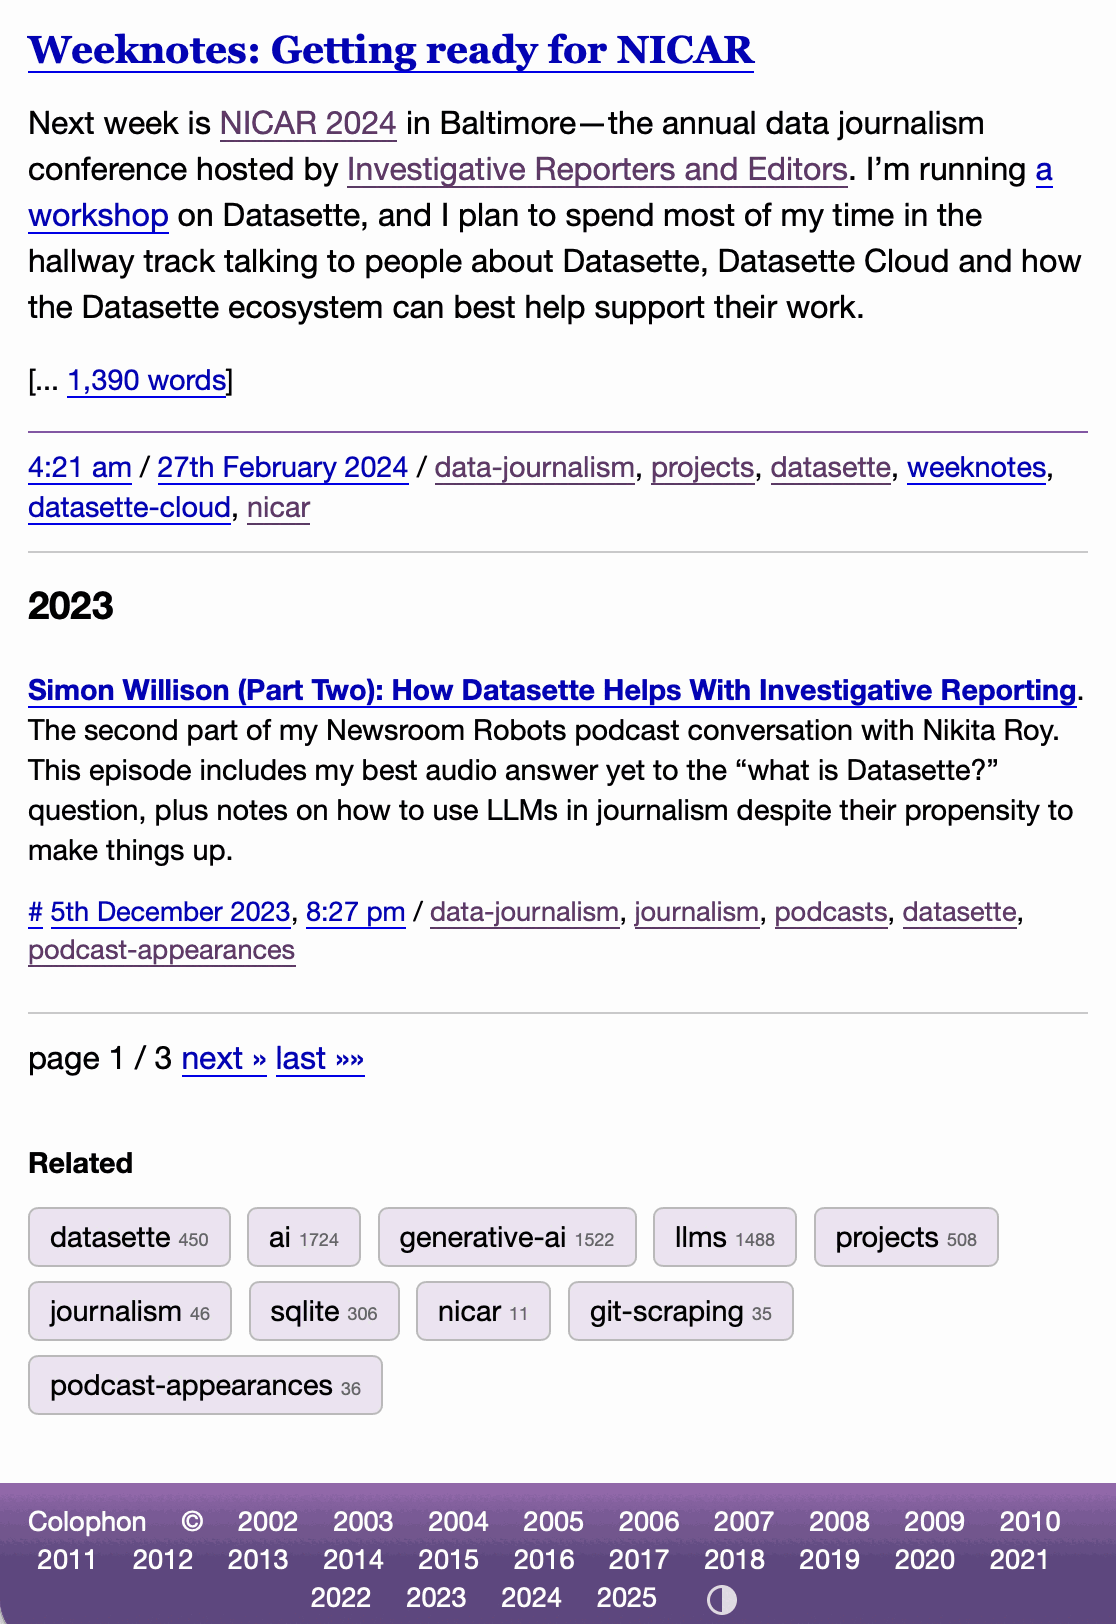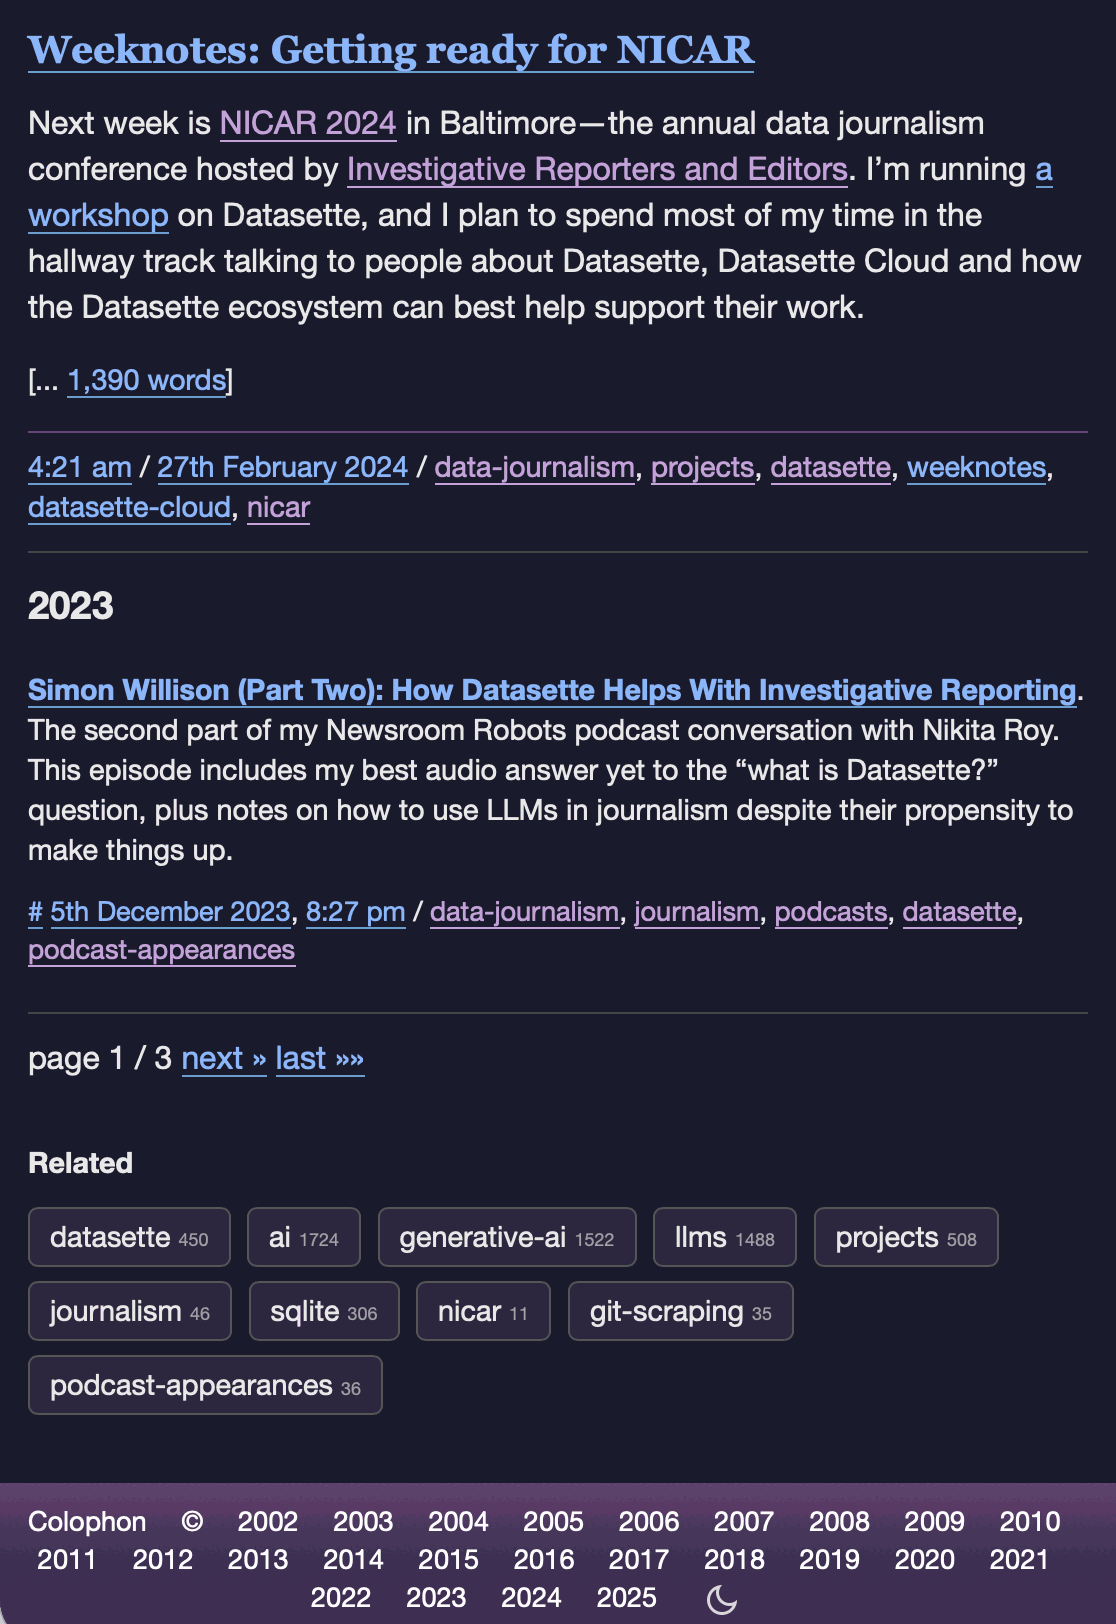
The site defaults to picking up the user's preferences, but there's also a toggle in the footer which switches between auto, forced-light and forced-dark. Here's an animated demo:

This site on mobile. Clicking the icon in the footer switches to a black background with readable text.

I had Claude Code make me that GIF from two static screenshots - it used this ImageMagick recipe:

magick -delay 300 -loop 0 one.png two.png \
    -colors 128 -layers Optimize dark-mode.gif

The CSS ended up with some duplication due to the need to handle both the media preference and the explicit user selection. We fixed that with Cog.

Tags: css, coding-agents, ai-assisted-programming, claude, claude-code, design, llms, ai, generative-ai

🔲 ☆

Devika – Votre ingénieur logiciel personnel

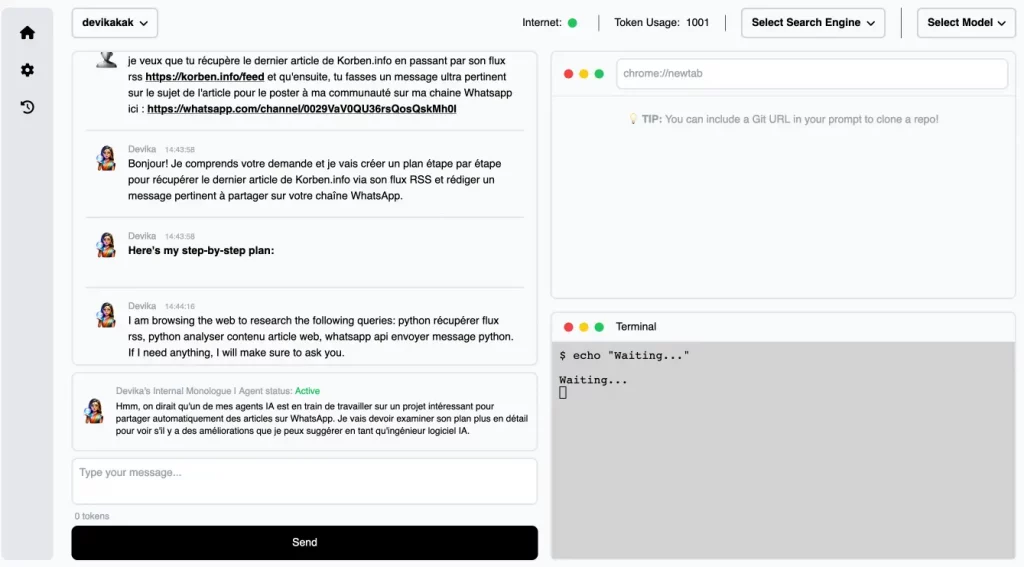
Si vous voulez passer à la vitesse supérieur en terme de développement, voici un projet qui va vous intéresser. Cela s’appelle Devika et c’est un outil qui agit comme un véritable pair programmer, c’est à dire un « collègue » IA capable de comprendre des instructions complexes en langage naturel, de les décomposer en étapes, de rechercher les informations pertinentes et de générer du code fonctionnel pour atteindre l’objectif. Cela vient directement concurrencer le service Devin qui a buzzé y’a quelques temps sauf que c’est totalement open source.

Grâce à ses capacités avancées de traitement du langage naturel, cette « IA » peut interpréter vos instructions de haut niveau et les transformer en un plan d’action concret. Une fois le plan établi, elle se met au travail et utilise ses connaissances en programmation et ses capacités de recherche web pour trouver les informations dont elle a besoin pour mener à bien votre projet : Snippets de code, exemples de bonnes pratiques ou explications détaillées… A partir de ça, elle peut alors générer du code dans le langage de programmation de votre choix.

Pour l’installer, il vous faudra ollama, uv, bun et suivre le tuto suivant :

ollama serve
git clone https://github.com/stitionai/devika.git
cd devika/
uv venv
source .venv/bin/activate
uv pip install -r requirements.txt
playwright install --with-deps
cd ui/
bun install
bun run dev

Puis en parallèle :

python3 devika.py

Vous devrez ensuite vous connecter à http://localhost:3000/ et remplir toutes les clés API, de votre clé OpenAI, en passant par votre clé API Google / Bing…etc. Et ensuite vous pourrez commencer à bosser les agents de Devika.

L’un des aspects les plus impressionnants de Devika, c’est sa capacité à s’améliorer constamment grâce notamment à ses algorithmes d’apprentissage automatique. Elle apprend de chaque interaction avec les développeurs et de chaque projet sur lequel elle travaille, ainsi, plus elle est utilisée, plus elle devient efficace.

Bien sûr, comme toute technologie émergente, c’est pas encore parfait et surtout, ça soulève des questions : Comment s’assurer que le code généré par l’IA est sécurisé et sans bugs ? Comment l’intégrer dans des workflows de développement existants ? Est-ce qu’il faut licencier les développeurs qui passent plus de temps sur le site de Korben qu’à bosser ? Des questions existentielles, comme vous pouvez le voir…

Si vous êtes intéressé par ce projet et que vous souhaitez l’essayer par vous-même, rendez-vous sur le dépôt GitHub du projet.

Merci à Emrik pour le partage !

🔲 ☆

weAudit – Une extension Visual Studio Code pour ceux et celles qui font de l’audit

Salut les codeurs !

Aujourd’hui, je vais vous causer d’un truc qui va révolutionner votre façon d’auditer le code : l’extension VSCode weAudit ! C’est développé par les génies de Trail of Bits et c’est vraiment chouette, vous allez voir.

Il s’agit un outil de revue de code collaborative (d’audit quoi…) qui vous permet de prendre des notes et de traquer les bugs directement dans VSCode. Plus besoin de jongler entre 36 outils, weAudit centralise tout

Il est d’ailleurs bourré de fonctionnalités ultra pratiques :

  • Des signets pour vos trouvailles et vos notes
  • Un suivi des fichiers audités pour savoir où vous en êtes
  • De la collaboration pour bosser en équipe sans vous marcher dessus
  • La création directe d’issues GitHub bien formatées

Comme ça, plus besoin de vous prendre la tête avec des outils externes. Vous pouvez aller jeter un œil au code sur le repo GitHub.

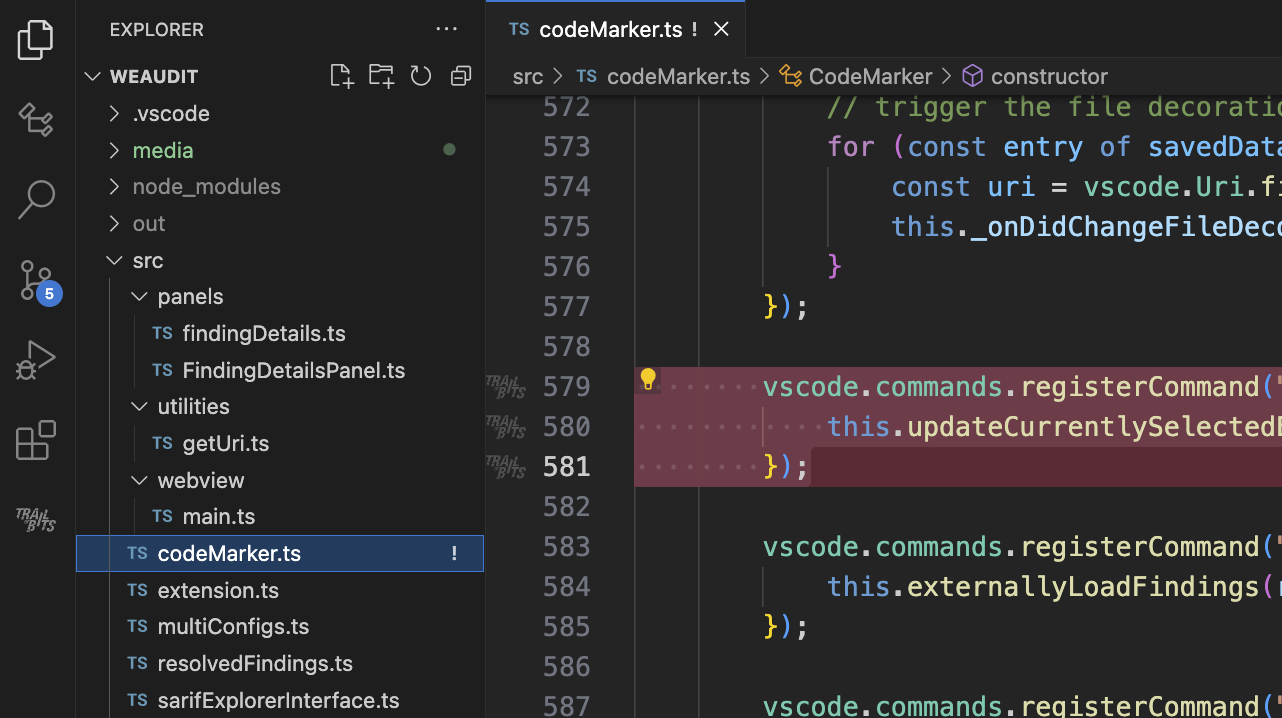
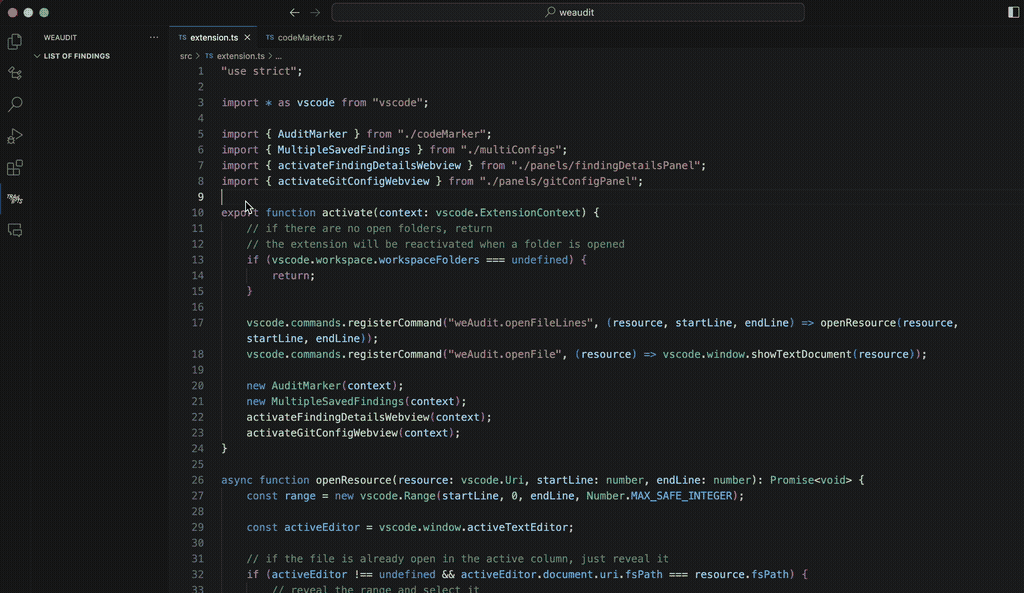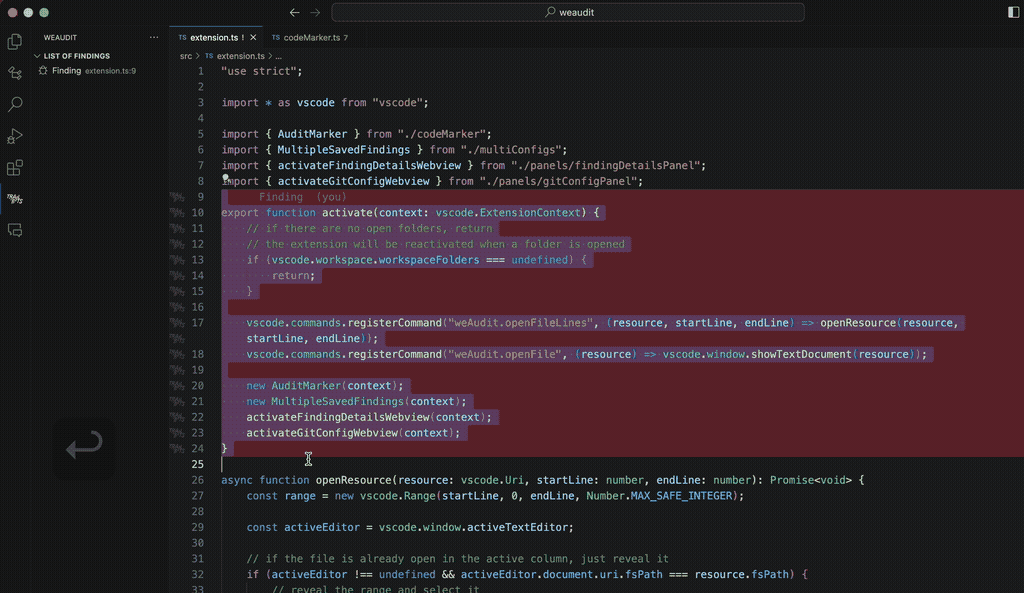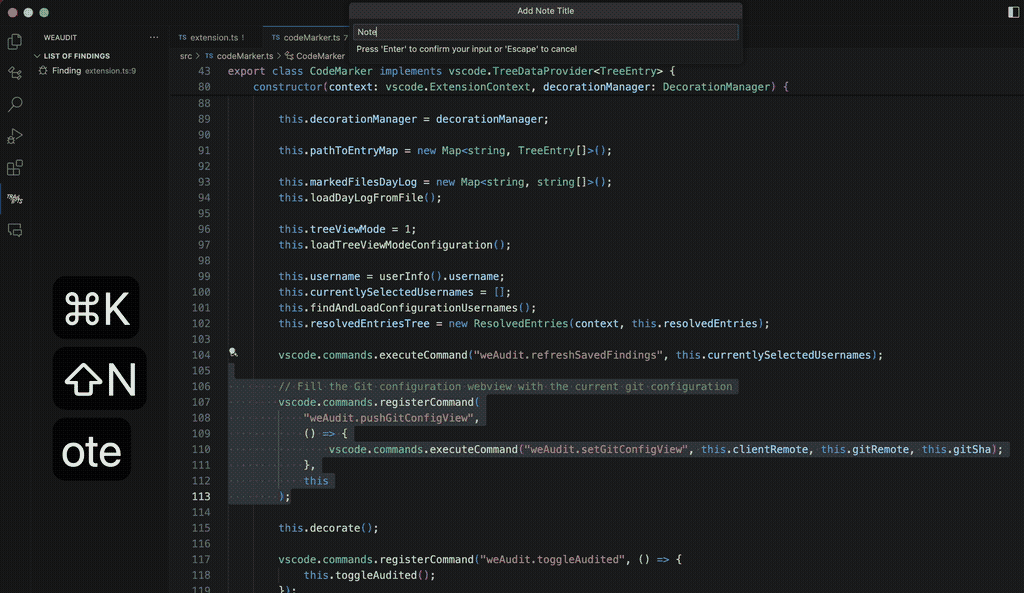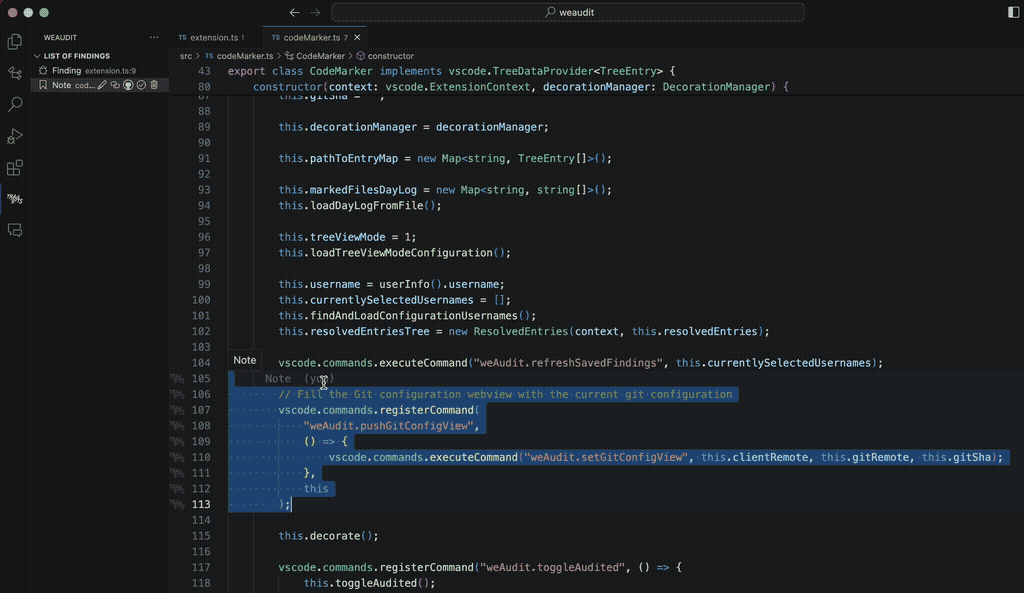
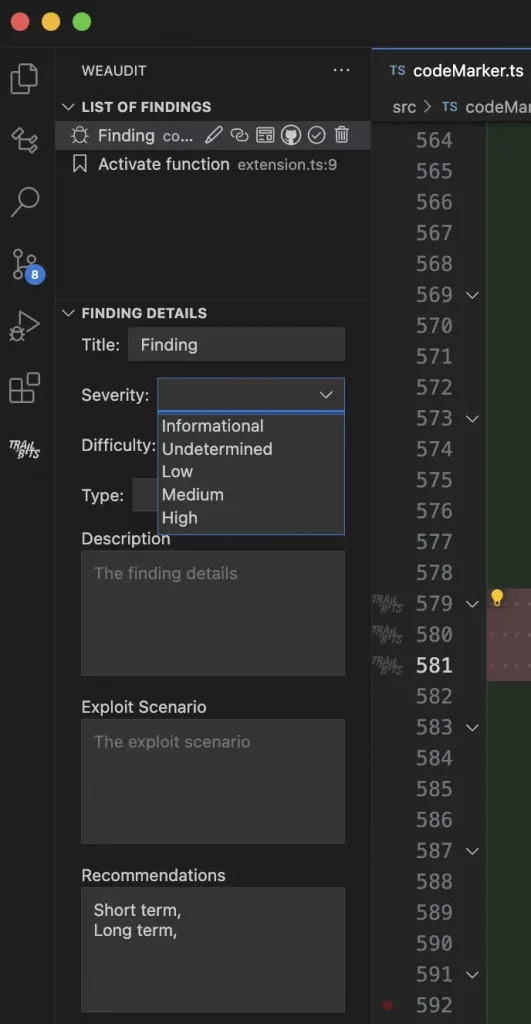
Bon allez, je vous donne un petit exemple pour vous montrer à quel point c’est facile à utiliser. Disons que vous tombez sur un bout de code louche. Hop, vous sélectionnez ce code et vous utilisez le raccourci Cmd+J pour ajouter un signet « Finding ». Ça va surligner le code en rouge et ajouter une note dans la liste des findings. Et si vous voulez ajouter des détails sur le problème, pas de souci ! Cliquez sur le finding, remplissez les champs et même créez direct une issue GitHub.

Je ne sais pas comment on faisait avant weAudit.

Pour l’installer, rendez-vous sur le marketplace VSCode. Et si vous êtes à fond dans la sécurité des extensions VSCode, jetez aussi un œil aux articles de blog de Trail of Bits sur les vulnérabilités d’extensions VSCode mal configurées et comment s’échapper d’extensions VSCode bien configurées.

Allez, je vous laisse jouer avec weAudit. Vous m’en direz des nouvelles.

🔲 ☆

Durdraw – Un éditeur ASCII pour faire l’art rétro dans votre terminal

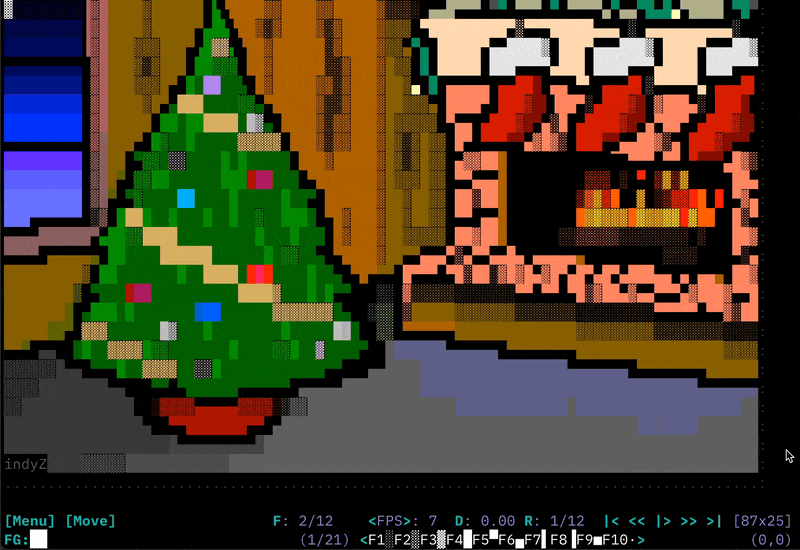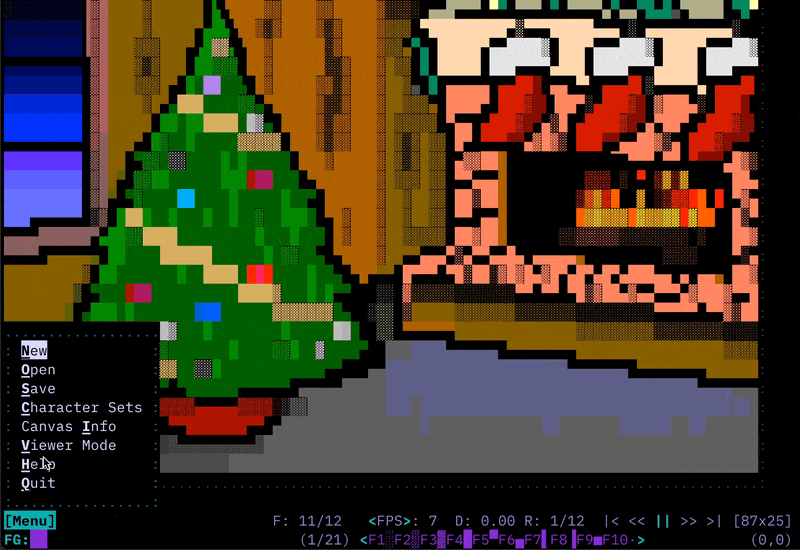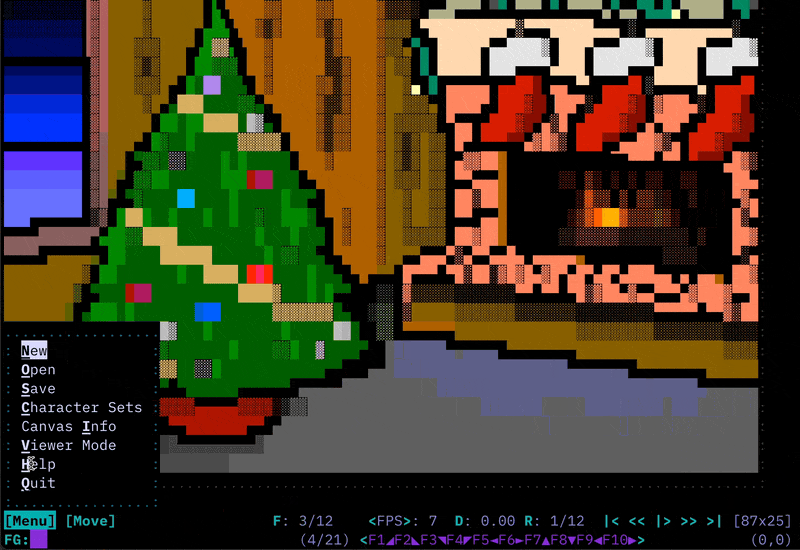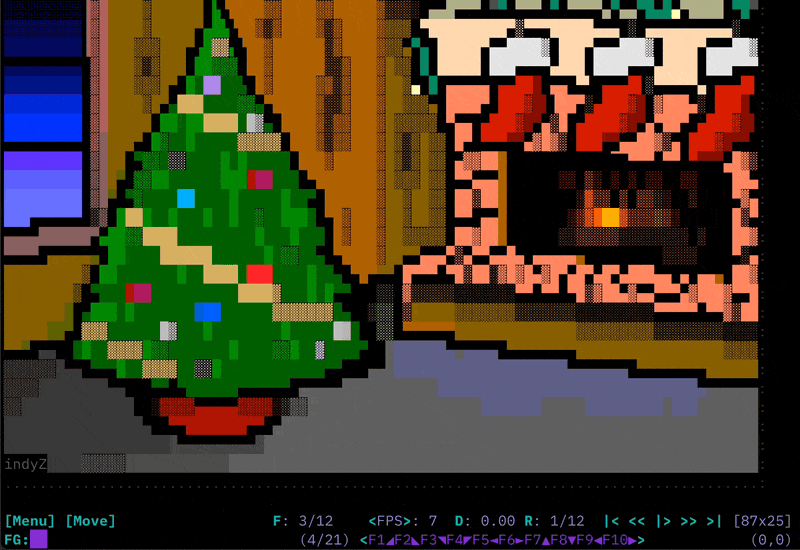
Attention, pépite de l’espace à vous faire découvrir aujourd’hui ! Ça s’appelle Durdraw et c’est un éditeur de folie pour créer de l’art ASCII, ANSI et Unicode dans votre terminal !

Imaginez pouvoir dessiner des animations old school avec une palette de 16 ou 256 couleurs, en mixant allègrement les caractères CP437 de l’époque MS-DOS avec de l’Unicode moderne. Le tout avec le support de thèmes customisés et de l’export en HTML et mIRC.

Si comme moi vous avez grandi avec des softs de légende comme TheDraw et PabloDraw, vous allez retrouver direct vos repères, mais avec la puissance et la souplesse du monde Unix en plus.

Durdraw est codé en Python donc pour l’installer c’est ultra simple, un petit coup de pip ou de git clone et vous êtes parés pour entrer dans la 4ème dimension de l’ANSI art 😎.

git clone https://github.com/moneamis/durdraw-demo

cd durdraw-demo

./setup.sh

durdraw -p demo.dur

Les devs ont même pensé à inclure une config d’exemple et des thèmes bien sentis pour pas être largué en arrivant. Une fois lancé, préparez-vous à entrer dans la matrice : ça fourmille de raccourcis clavier dans tous les sens pour éditer au caractère et à la couleur près. Les nostalgiques des BBS apprécieront les commandes à base d’échappement, pendant que les plus modernes pourront même utiliser la souris pour peaufiner leurs chef d’oeuvres.

Et là où Durdraw se pose, c’est qu’il gère les animations image par image avec un contrôle total du timing. Fini l’époque où on dépendait du débit du modem, maintenant on créé des petits flip book ASCII qui restent stables même quand on redimensionne le terminal à la volée. Ça c’est de la qualité mes p’tits potes !

Bon après faut pas se leurrer, Durdraw ne rendra pas votre minitel compatible avec Unreal Engine 5 hein. Mais entre nous, est-ce qu’on a vraiment besoin d’aller jusque là quand on peut déjà pousser l’art ANSI dans ses derniers retranchements ? En plus l’auteur est hyper réactif sur GitHub pour améliorer son bébé au fil des contributions. C’est ça aussi la magie de l’open-source !

Bref, foncez sur https://durdraw.org, et lâchez-vous dans les créations bien rétro !

Merci à Lorenper pour l’info.

🔲 ☆

CSS Compatibility Checker – Votre allié pour un code parfaitement compatible avec tous les navigateurs

Et si aujourd’hui, on parlait un peu de l’extension CSS Compatibility Checker pour Visual Studio Code ? Un outil juste dingue qui va vous aider à voir en un clin d’œil si votre code est compatible avec tous les navigateurs. Plus besoin de passer des heures à éplucher la doc ou de croiser les doigts en espérant que ça passe, cette petite merveille va vous changer la vie !

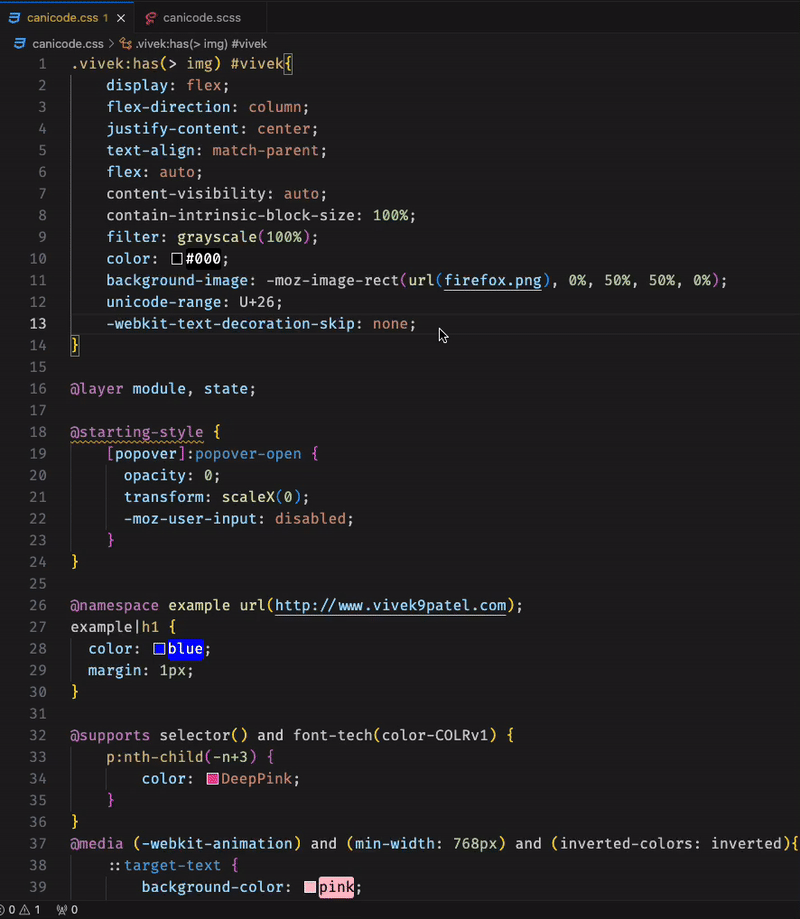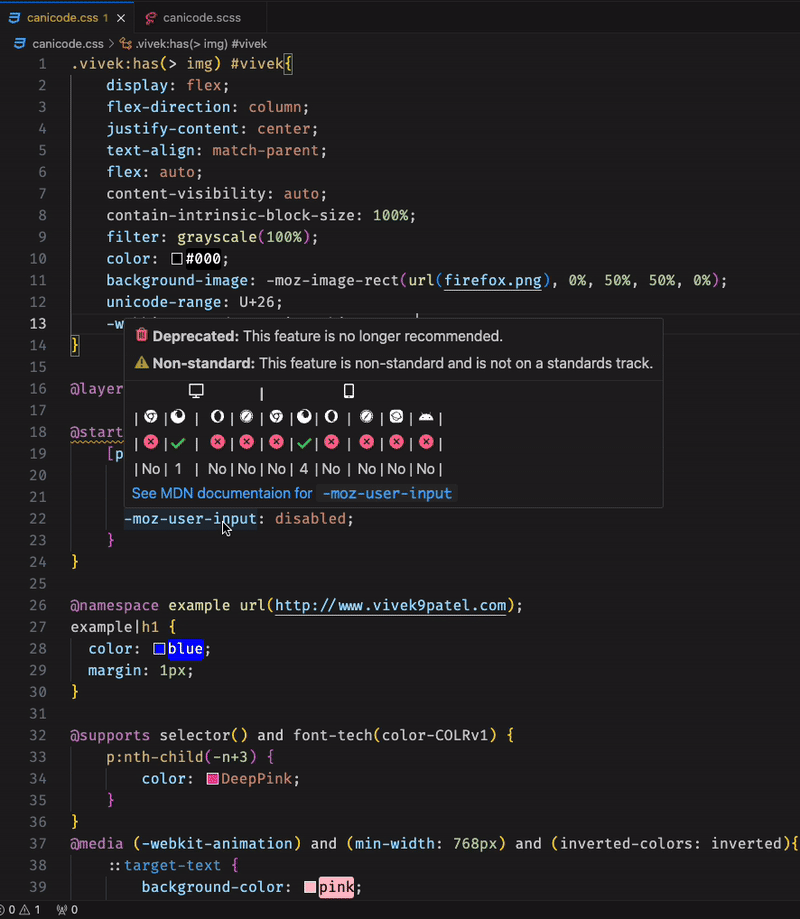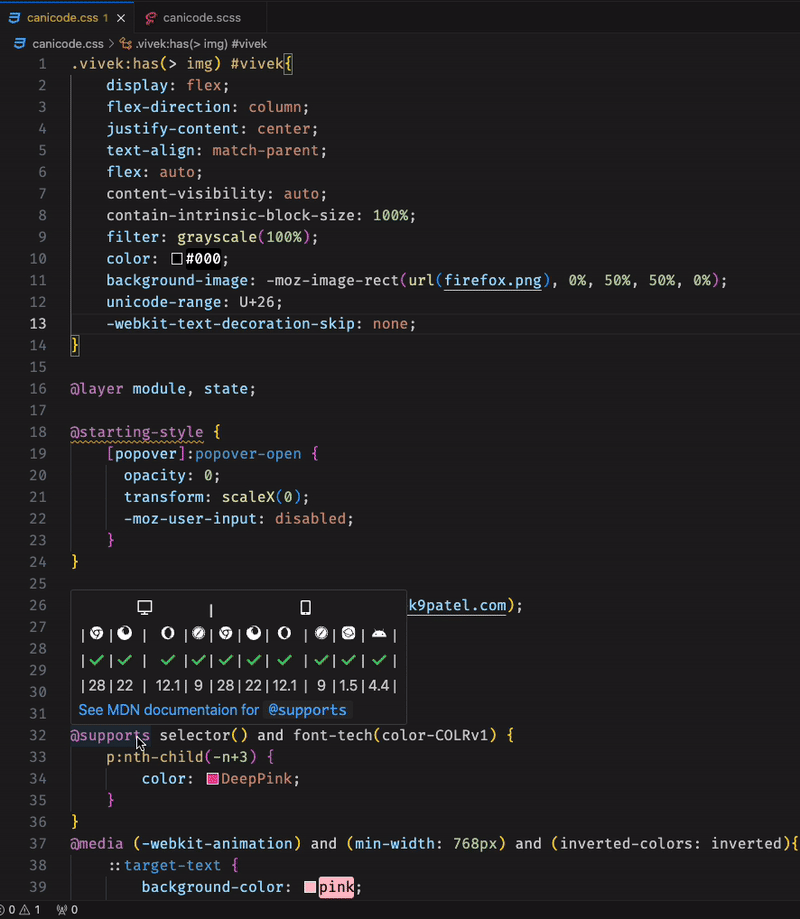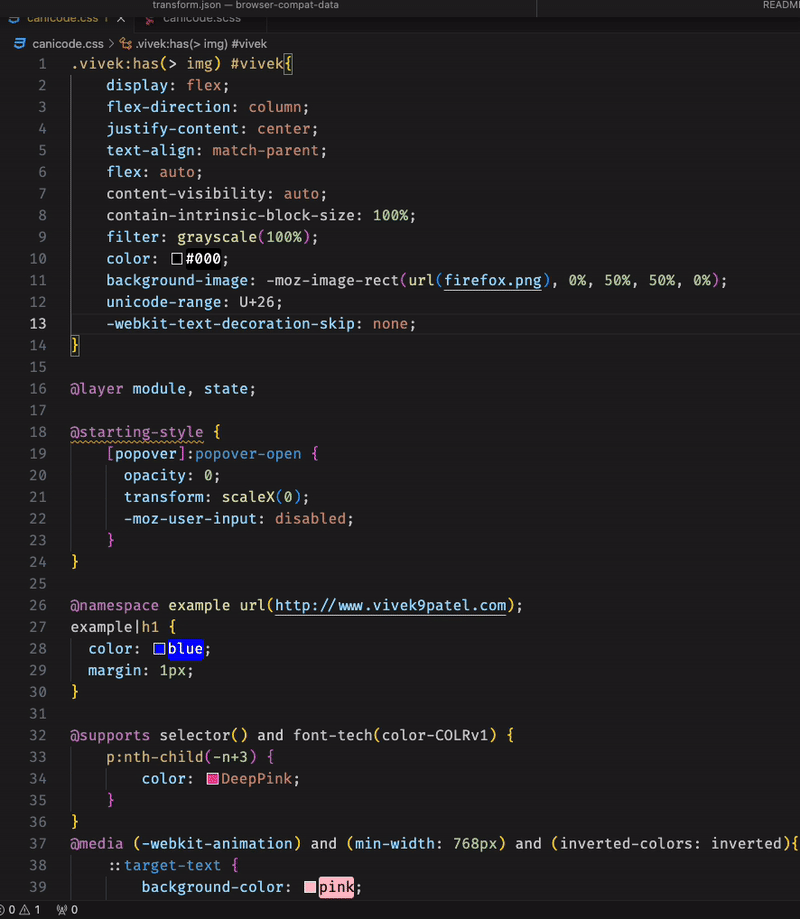
Imaginez un peu le topo : vous êtes tranquillou en train de tapoter votre CSS, vous balancez une propriété backdrop-filter pour flouter votre background avec classe et là bim 💥, l’extension vous remonte direct que c’est pas compatible avec certaines vieilles versions de navigateurs.

Ou alors vous utilisez un mot-clé un peu exotique genre unset et hop, elle vous alerte que c’est potentiellement casse-gueule. C’est ti pas beau ça ?

CSS Compatibility Checker s’adresse donc aux développeurs frontend un peu soucieux de la compatibilité de son code. Je sais, ils ne sont pas nombreux ^^. En un survol de souris, vous avez accès à toutes les infos dont vous avez besoin : si telle syntaxe, fonction ou propriété est dépréciée, non-standard, expérimentale ou pas supportée partout. Et c’est valable pour un tas de versions de navigateurs différentes !

Pour en profiter, vous devrez installer l’extension depuis la marketplace de VS Code, et ensuite il vous suffit d’ouvrir un fichier CSS, SCSS ou LESS et de laisser le curseur survoler l’élément qui vous intéresse. Et là, magie, une petite bulle s’affiche avec toutes les infos de compatibilité. De quoi prendre les bonnes décisions pour votre projet !

Alors certes, CSS Compatibility Checker ne va pas non plus révolutionner le monde du développement web du jour au lendemain mais pour tous ceux qui en ont un peu ras la casquette de se farcir des heures de tests sur 15 versions d’Internet Explorer, c’est définitivement une extension à avoir sous la main. Et puis c’est gratuit et open-source en plus, alors que demande le peuple ?

Merci à Lorenper pour le partage !

🔲 ☆

Un Konami Code dans Castlevania Legacy of Darkness sur Nintendo 64

Vous pensiez connaître Castlevania sur le bout des doigts ? Eh bien 25 ans après la sortie de Castlevania: Legacy of Darkness sur notre bonne vieille Nintendo 64, des petits malins ont déniché un tout nouveau code Konami planqué dans les entrailles du jeu.

Ce code Konami est une vraie petite bombe puisqu’il déverrouille d’un coup TOUS les personnages et leurs costumes alternatifs, et ce dès le début de l’aventure ! Fini de devoir se farcir le jeu deux fois pour accéder à Henry et Carrie. Là c’est open bar direct, et ça change complètement la donne !

Moises et LiquidCat, deux fans passionnés du jeu, ont également déniché deux autres codes bien sympathiques. Le premier remplit entièrement votre inventaire, peu importe le héros que vous incarnez. Fini la galère pour trouver des potions et des équipements, vous voilà paré pour latter du vampire en claquant des doigts. Le second code, disponible uniquement dans les versions japonaise et européenne, booste votre arme au max et vous file un stock de joyaux dont même Picsou serait jaloux. De quoi rendre votre quête bien plus funky !

Pour activer ces codes, rien de plus simple :

  1. Ouvrez le jeu et sélectionnez le mode histoire.
  2. Tapez le code en doublant les inputs du code Konami classique : Up, Up, Down, Down, Left, Right, Left, Right, B, A, Start.
  3. Utilisez les boutons directionnels et A/B de votre manette N64.
  4. Appuyez sur Start pour confirmer l’activation.
  5. Enjoy ! Vous pouvez maintenant jouer avec tous les persos dès le début.

Codes bonus pour les plus curieux :

  • Inventaire au max : Up, Up, Down, Down, Left, Right, Left, Right, B, A, Start (x2)
  • Arme boostée et argent illimité (versions PAL/JPN uniquement)

Alors certes, dit comme ça, ça peut sembler un poil cheaté mais ça fait un quart de siècle que ce jeu nous nargue avec ses secrets, donc ça va, y’a tolérance. En plus, avouons-le, ces codes tombent à pic pour (re)découvrir cet opus culte car s’il y a bien un reproche qu’on pouvait faire à Legacy of Darkness, c’était ce côté un peu prise de tête avec un seul personnage jouable au début. Un choix curieux qui pouvait rebuter certains joueurs. Mais grâce à ce code Konami providentiel, ce problème est relégué aux oubliettes ! Vous pouvez enfin profiter des cinq perso et de leurs capacités uniques sans vous prendre le chou.

Alors si vous aussi vous avez une Nintendo 64 qui prend la poussière dans un coin (ou un émulateur), c’est le moment ou jamais de ressortir Castlevania: Legacy of Darkness et de tester ces fameux codes.

Source

🔲 ☆

Loi du 22 avril 2024 portant diverses dispositions d'adaptation au droit de l'Union européenne en matière d'économie, de finances, de transition écologique, de droit pénal, de droit social et en matière agricole

La loi transpose plusieurs directives et met en cohérence le droit français avec des règlements européens dans des domaines variés (congés payés, droit de la consommation, numérique, transition écologique, garde à vue, droits des fonctionnaires...). Plusieurs habilitations du gouvernement à légiférer par ordonnance sont aussi prévues.
🔲 ☆

Flyde – Comme scratch mais pour les vrais dev

Bonne nouvelle ! Flyde, un nouvel outil de programmation visuelle pour les développeurs, vient de sortir en Alpha et ça déchire grave !

Bon, je vous vois venir : « Encore un énième outil low-code à la mode… » Que nenni ! Flyde est vraiment unique et a été conçu pour s’intégrer parfaitement à votre base de code existante, que ce soit pour du back-end, du front, des scripts d’automatisation ou même des outils en ligne de commande.
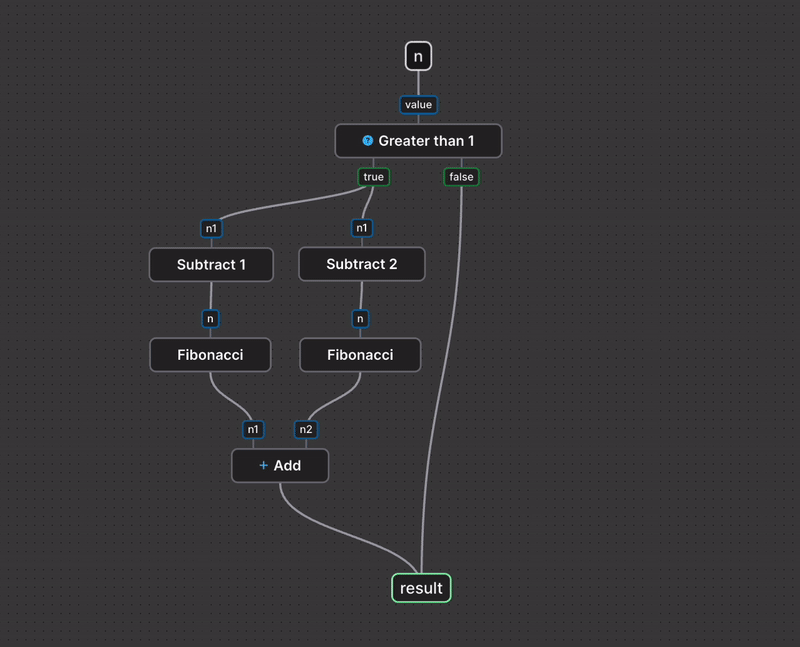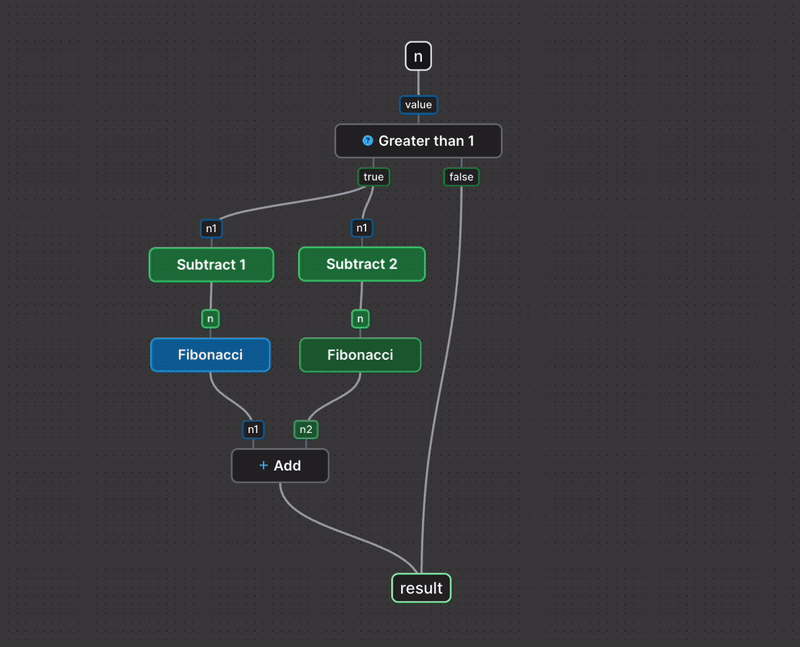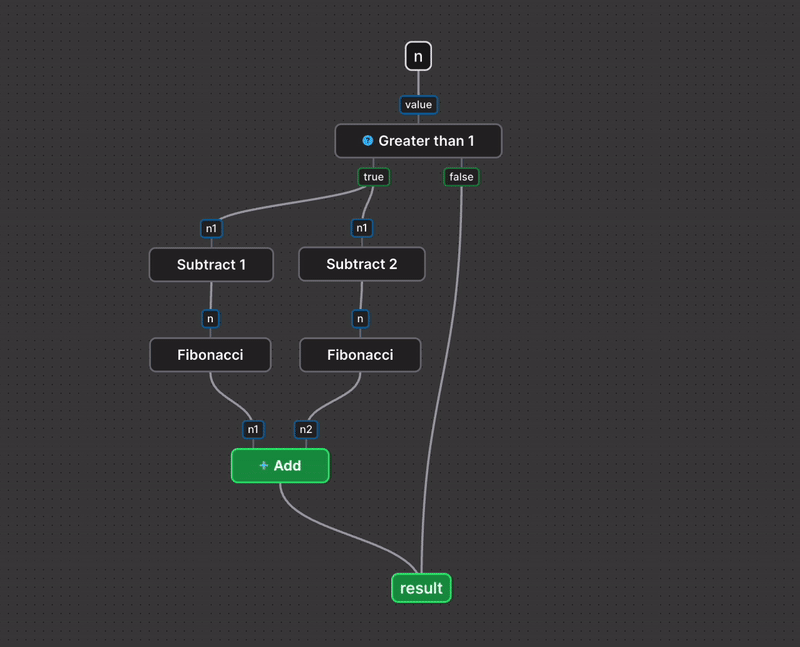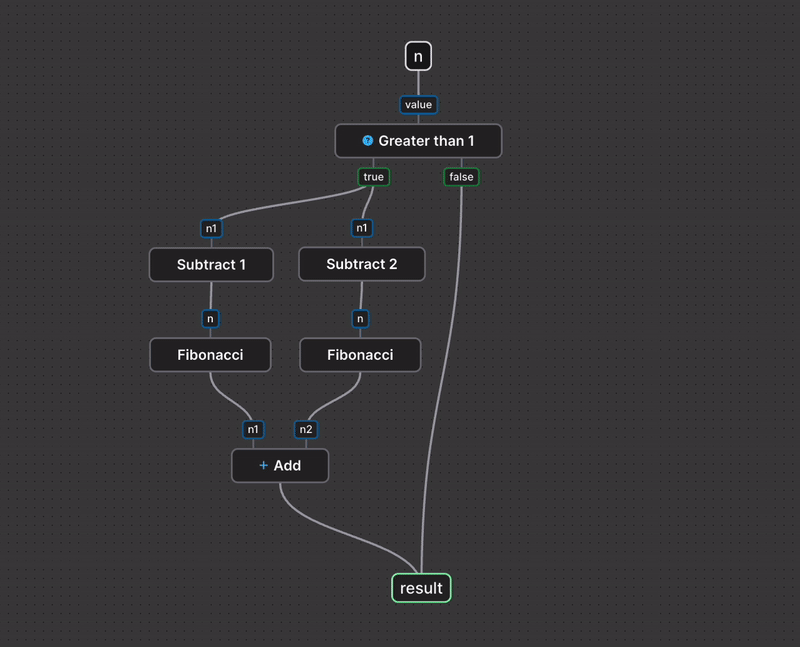
Le truc de ouf avec Flyde, c’est qu’il permet de visualiser et de créer facilement les flux haut-niveau (flows en anglais) de votre application, tout en gardant votre code textuel pour ce qui est bas-niveau. En gros, il sublime votre code « de plomberie » qui intègre plusieurs API de manière hyper concurrente. Vos diagrammes sur Powerpoint deviennent enfin une réalité !
Et les avantages sont multiples :

  • La collaboration avec les profils non-dev (product owners, QA, support…) devient hyper intuitive. C’est comme si Zapier et votre base de code avaient un bébé !
  • Les flux servent de documentation vivante et toujours à jour pour les nouveaux membres de l’équipe.
  • La programmation visuelle ouvre de nouveaux modes de réflexion sur le code. Les nœuds s’illuminent même quand les données les traversent, c’est hypnotique !
  • Et les données de monitoring sont directement sur le « code » lui-même. Ainsi, le débogage n’a jamais été aussi rapide.

Mais alors comment ça marche ce truc ?

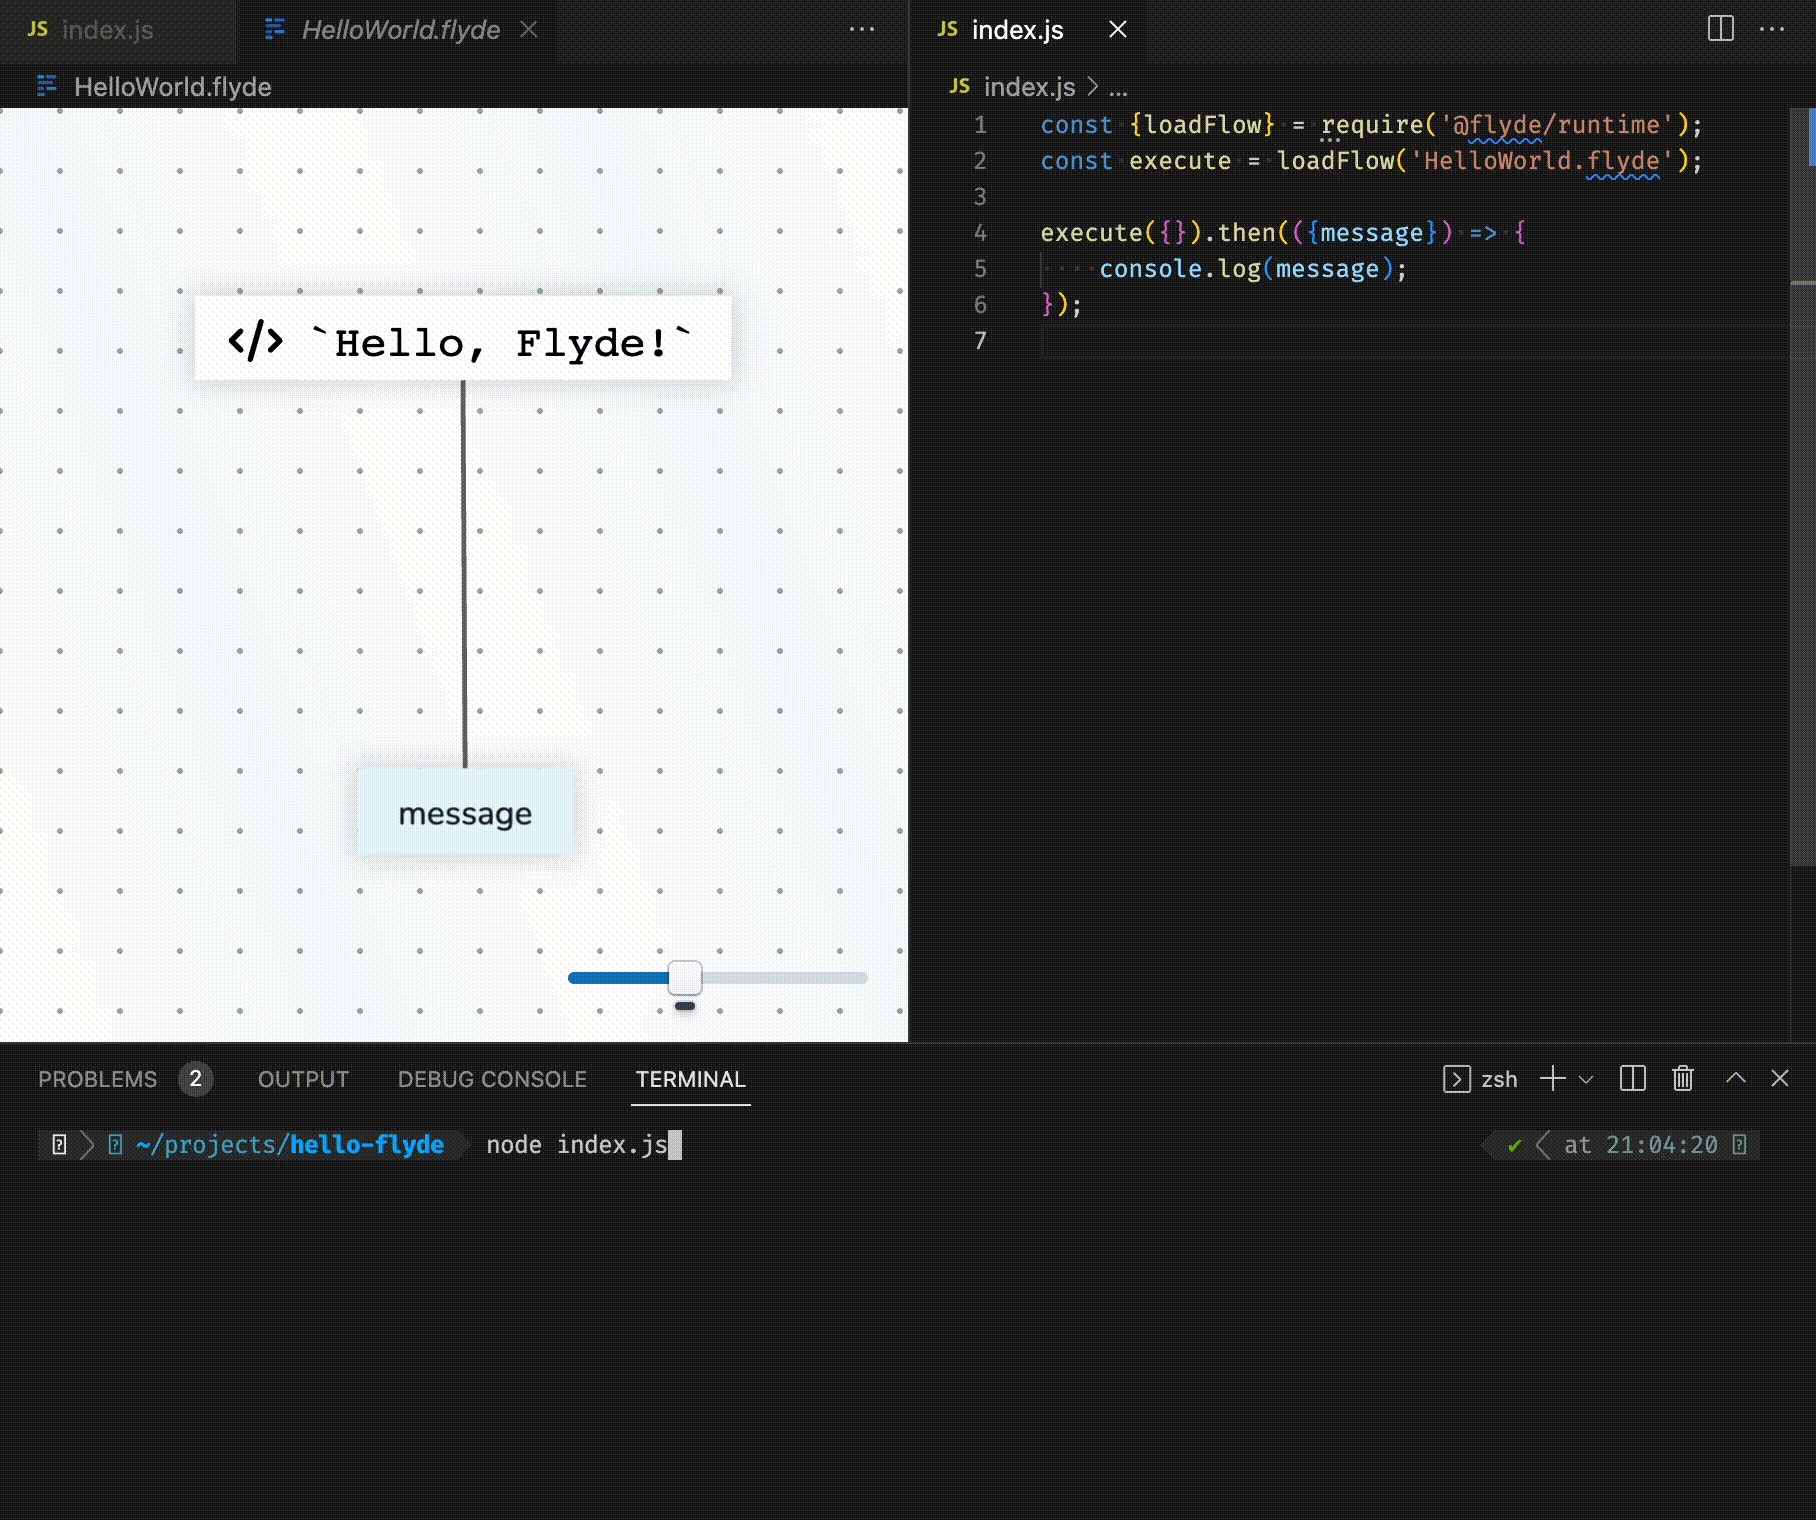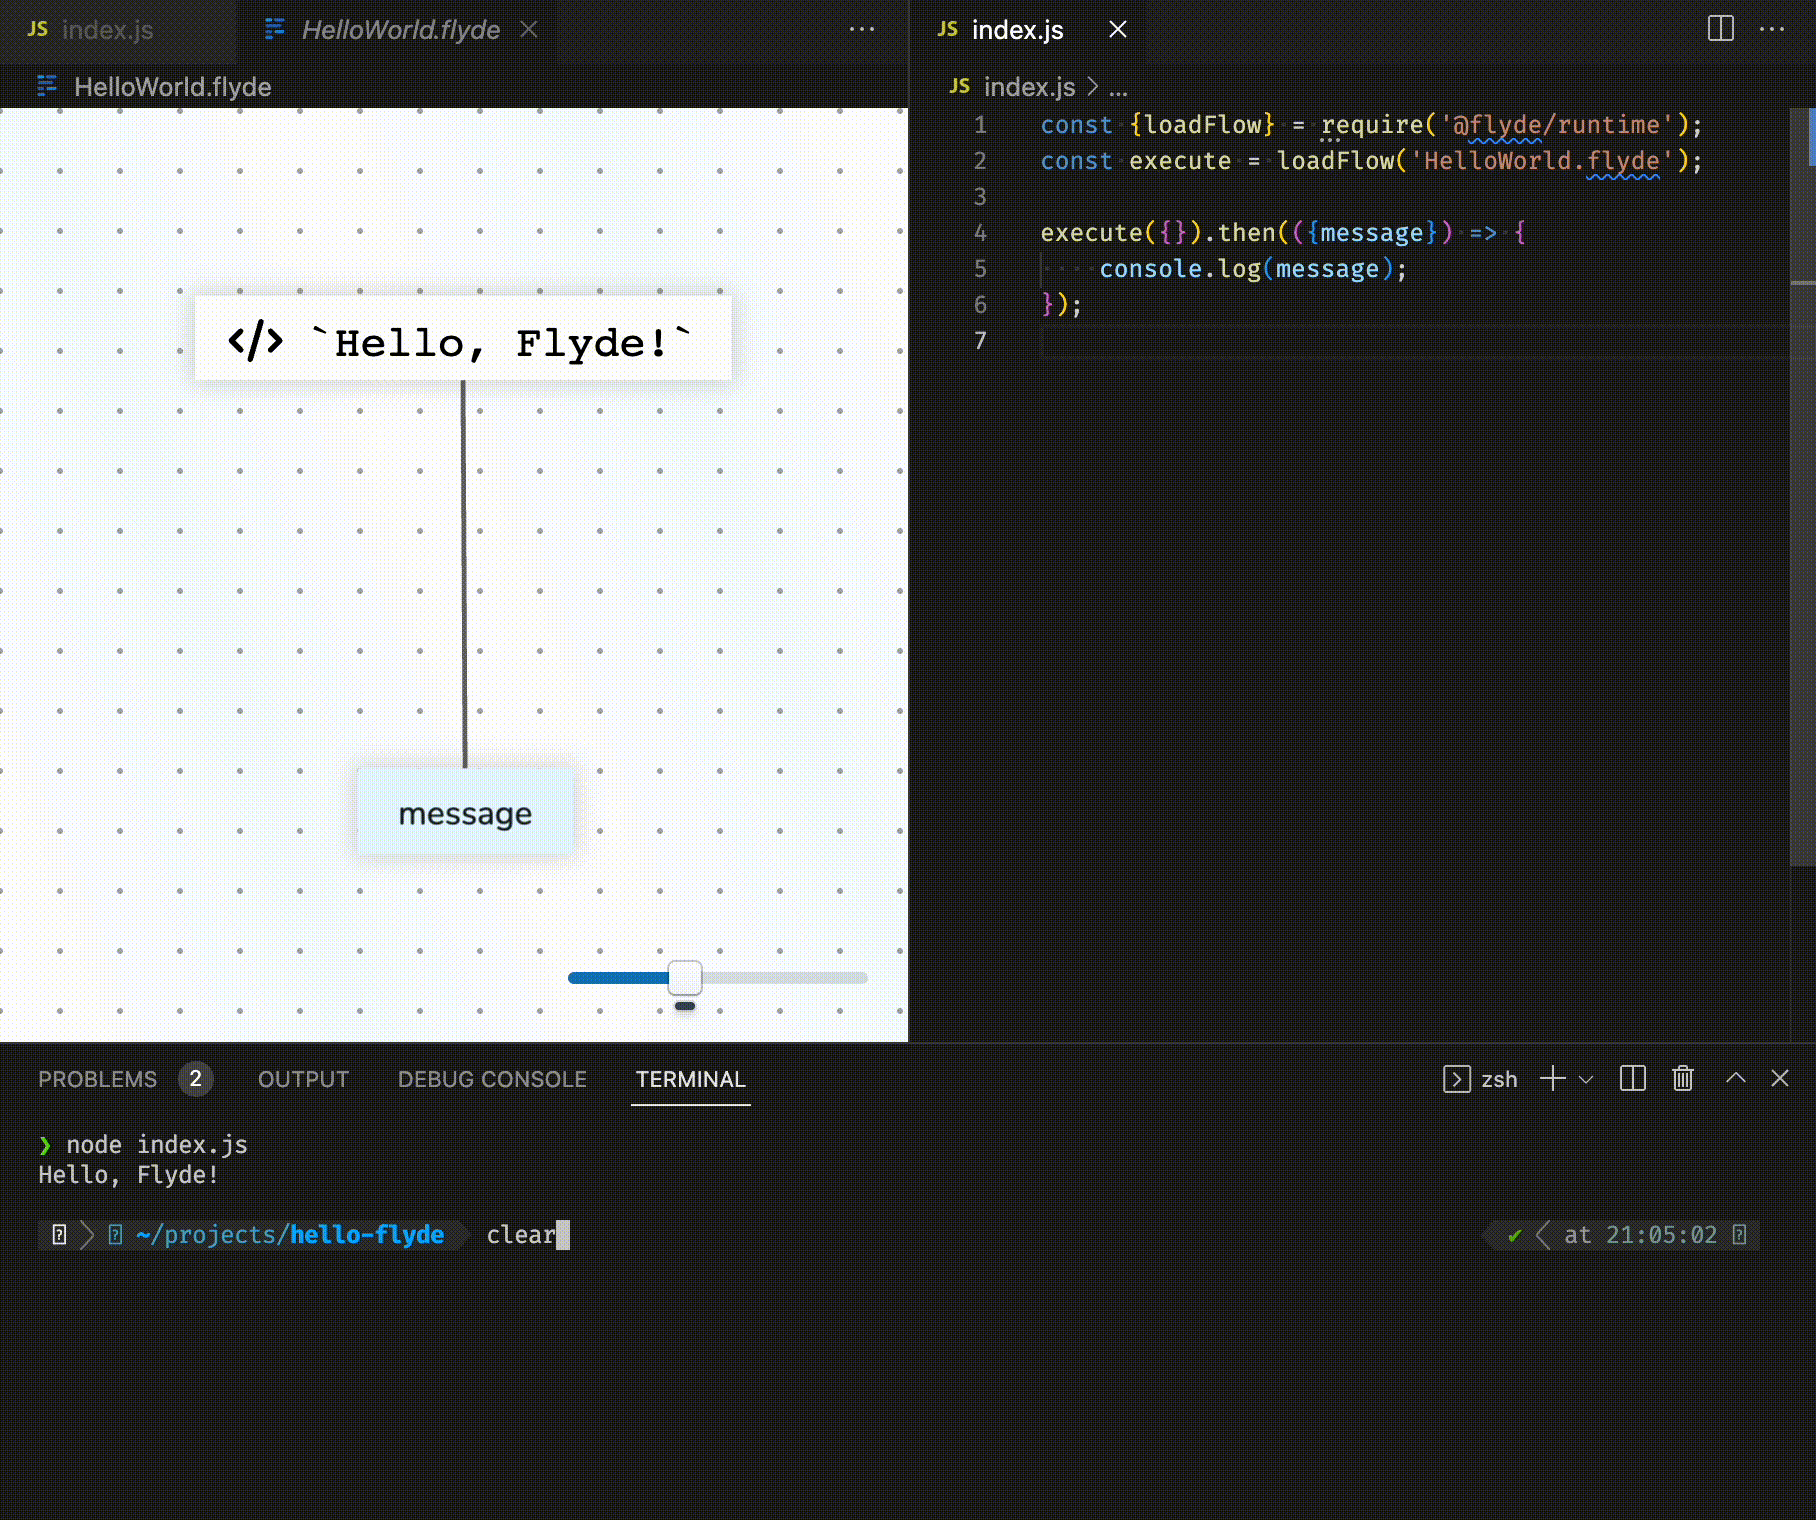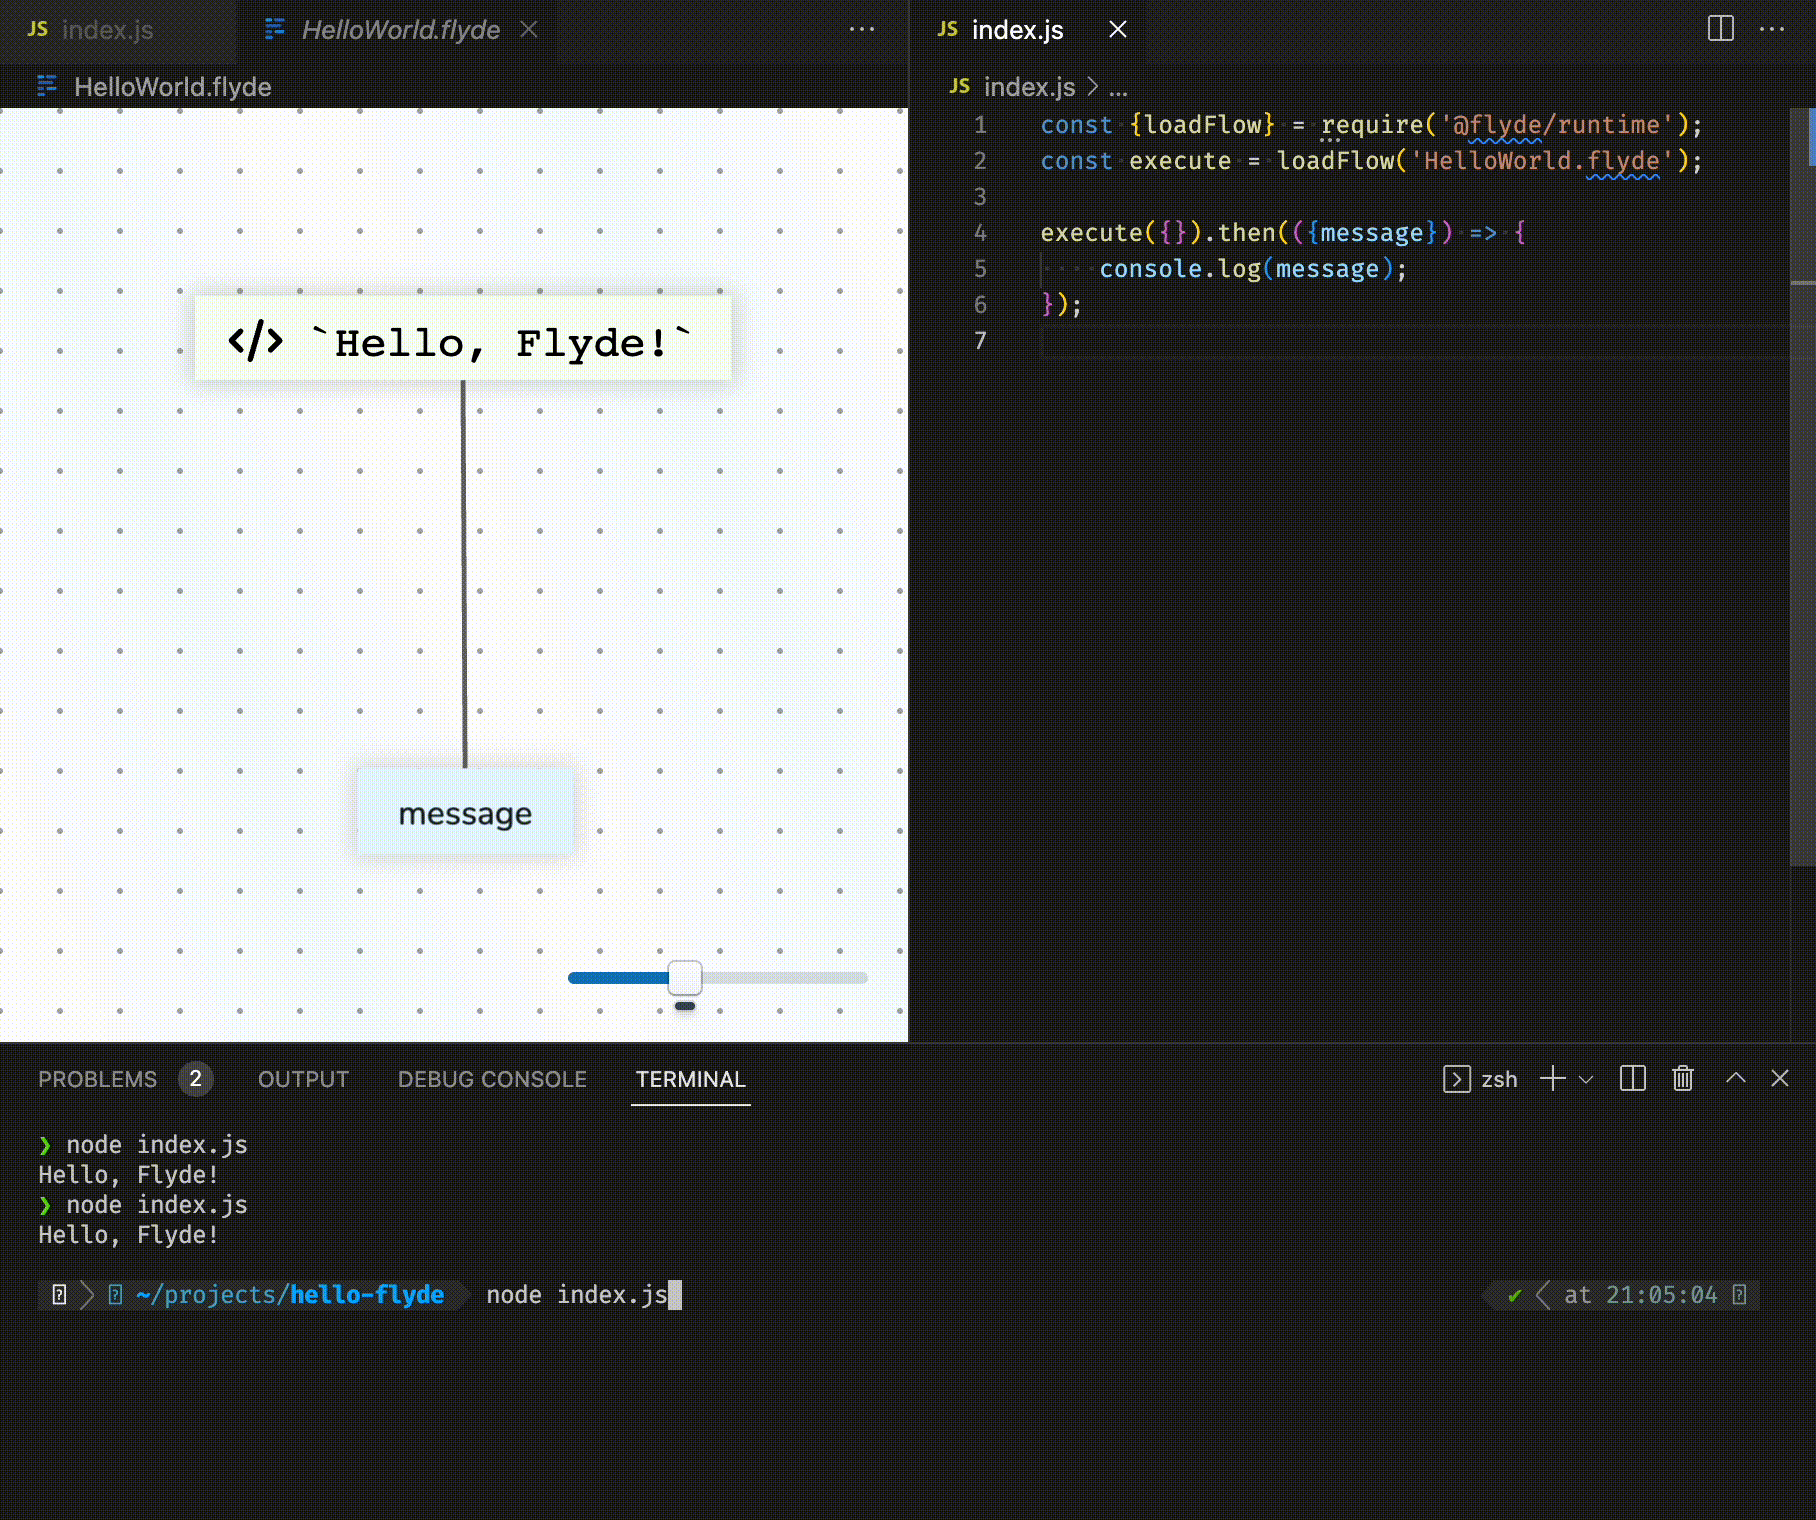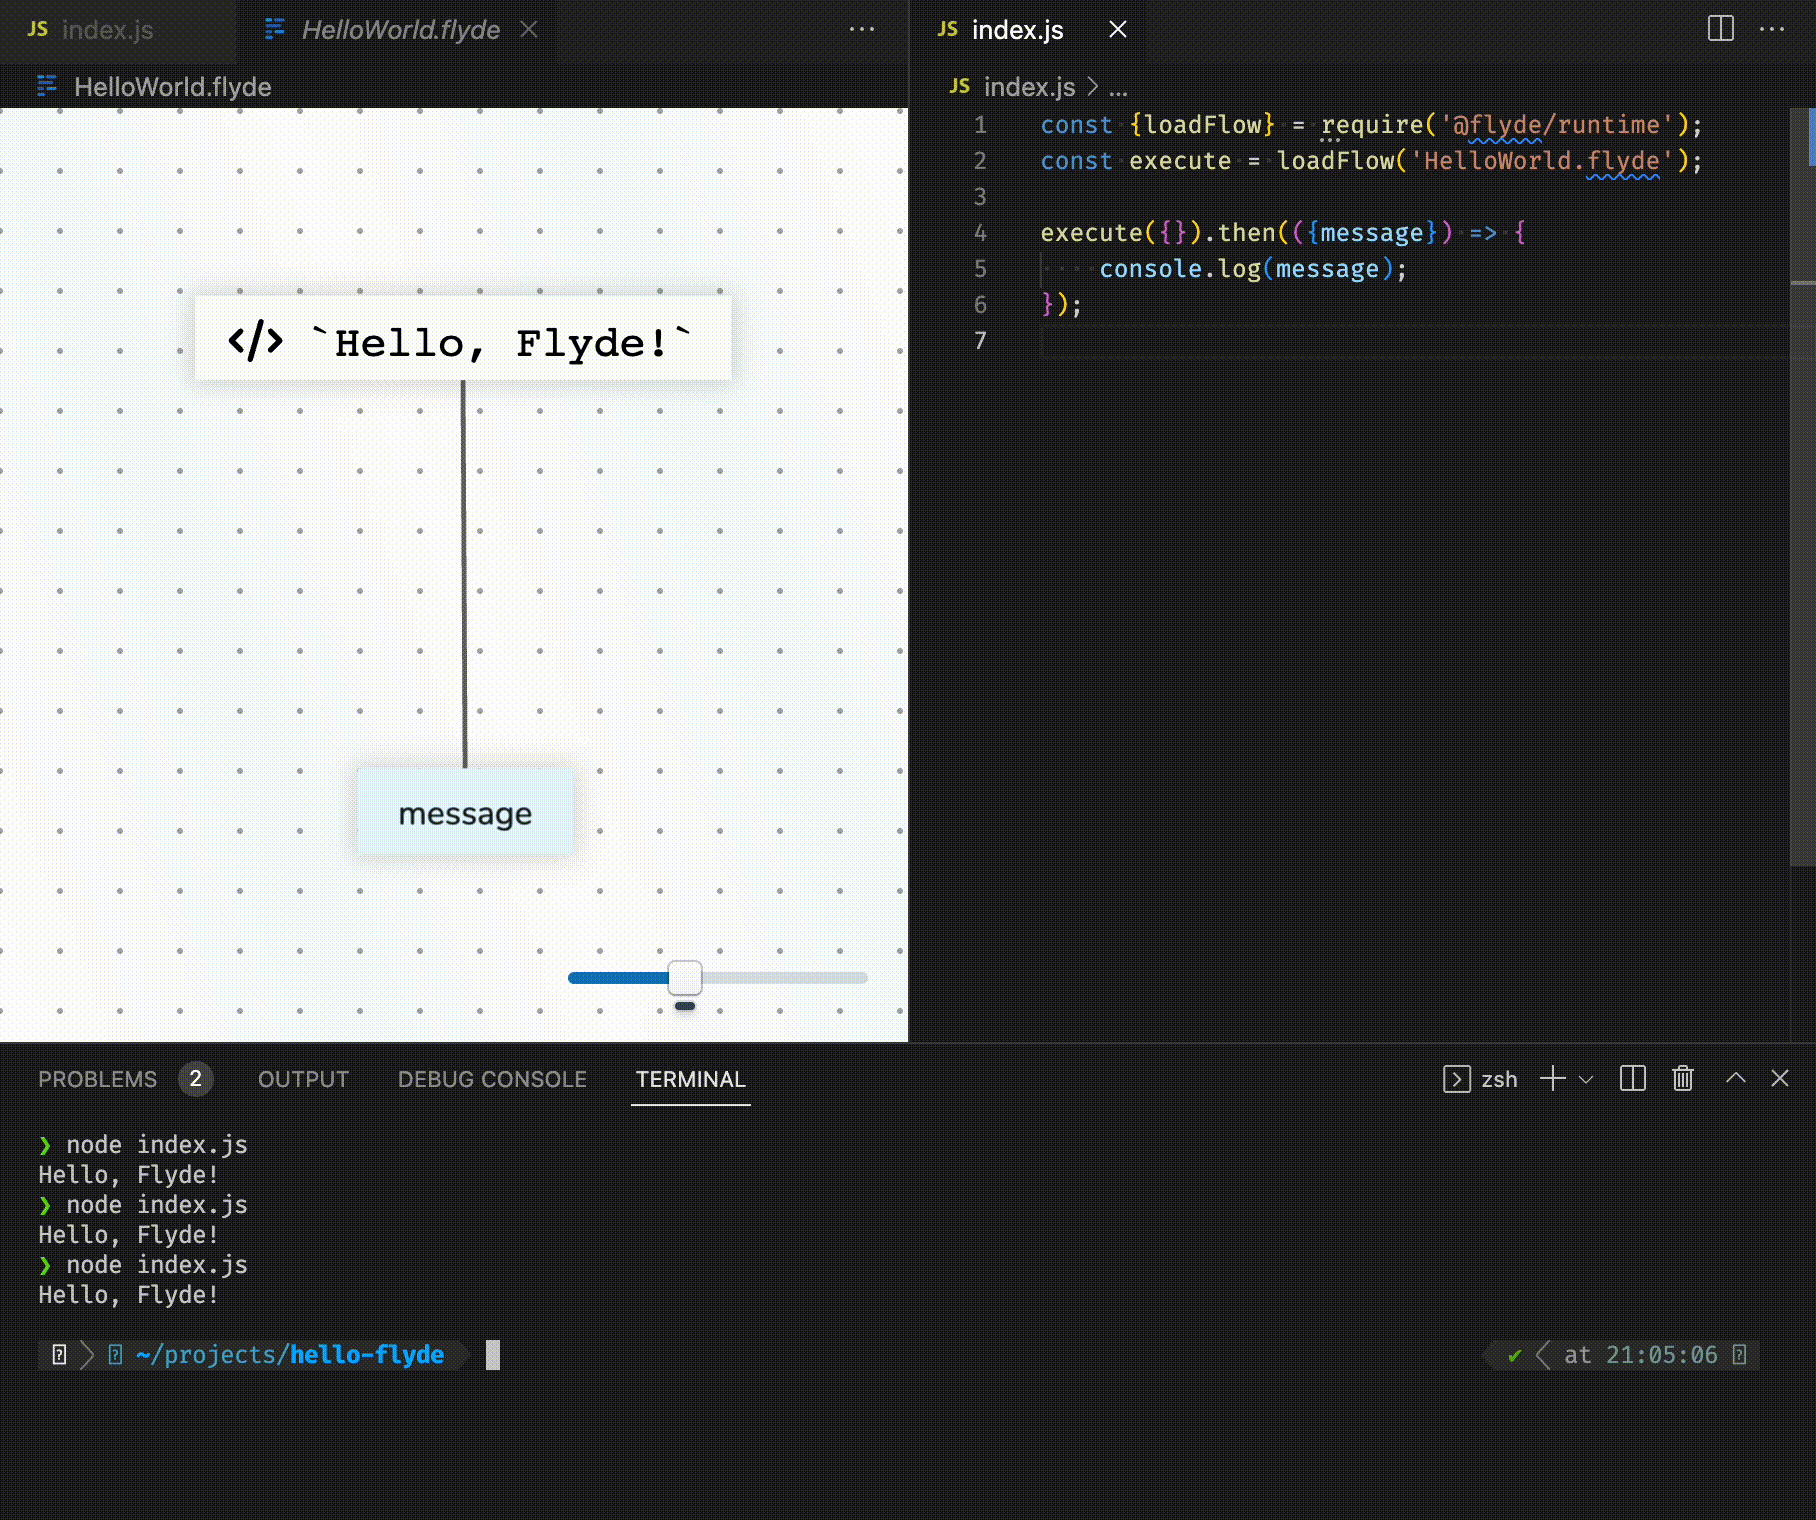
Et bien Flyde est composé d’un éditeur visuel (extension VS Code ou standalone), d’une bibliothèque d’exécution et d’une bibliothèque plutôt bien fournie de composants prêts à l’emploi.

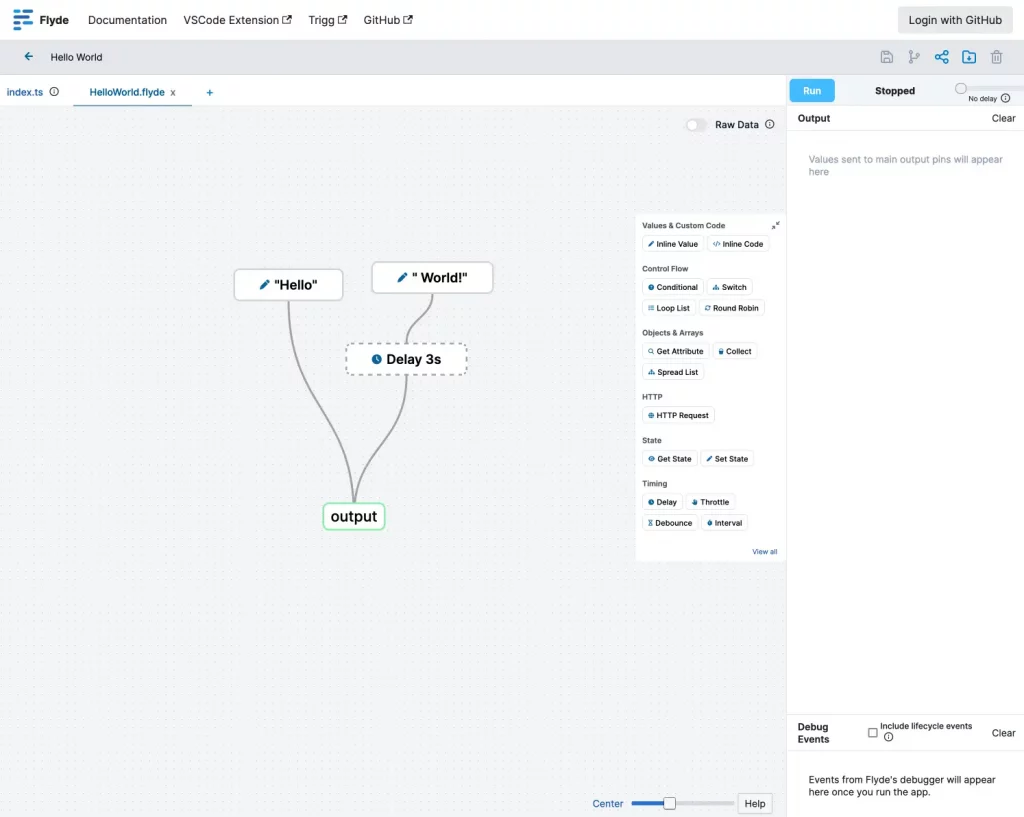
Dans l’éditeur visuel, on construit des flux en connectant des nœuds via une interface « nodes-and-wires ». On peut alors mixer des nœuds customs et ceux de la bibliothèque de composants. Une fois un flux créé, on peut ensuite l’exécuter depuis son code en utilisant la bibliothèque d’exécution de Flyde. Et c’est là que la magie opère !

Car Flyde ne cherche pas à remplacer vos workflows existants mais à les sublimer. Contrairement à d’autres outils low-code qui vivent en dehors de votre base de code, Flyde s’y intègre complètement. Les fichiers de flux sont committés dans votre gestionnaire de version comme n’importe quel autre fichier, les branches, les pull requests, les revues de code fonctionnent de manière transparente, les flux sont exécutés depuis votre base de code, en réutilisant votre environnement de prod. Comme ça, pas besoin de gérer une plateforme externe ni de vous soucier de la sécurité. Enfin, ces même flux peuvent être testés avec vos frameworks de test habituels. Vous pouvez même écrire des tests en Flyde qui testent votre code traditionnel !

L’intégration avec le code existant se fait de deux manières astucieuses : Premièrement, les noeuds Flyde peuvent être des noeuds visuels ou des noeuds basés sur du code. On peut donc wrapper n’importe quelle fonction de sa base de code dans un noeud Flyde utilisable dans un flux.

Secondo, les flux de Flyde peuvent s’exécuter depuis votre code. Par exemple, si vous construisez my-cool-flow.flyde, il faudra appeler execute('my-cool-flow') dans votre code puis gérer la réponse. Les cas d’usage sont infinis : Gestionnaire de requêtes HTTP, bot, scripts, etc.

Bon, vous l’aurez compris, Flyde s’inspire des principes de programmation basée sur les flux (FBP) mais d’autres outils font déjà ça, comme Node-RED ou NoFlo, bien avant l’arrivée du bouzin.

Quelle est la plus-value de Flyde du coup ?

Déjà, Flyde adopte une approche plus pragmatique et simple que NoFlo qui était un poil trop inspiré par la vision puriste de J. Paul Morrison, l’inventeur du FBP. Ensuite, l’éditeur est une extension VS Code, donc intégré à votre IDE, alors que les autres ont des éditeurs indépendants voire carréement datés. Et surtout Flyde est davantage taillé pour coexister avec les bases de code traditionnelles et toucher un public de développeurs plus large sur des projets variés.

Si vous voulez vous faire la main sur Flyde, le mieux est d’aller direct sur la sandbox en ligne qui permet de créer et d’exécuter des flux dans le navigateur. Puis jetez un œil aux tutos pour intégrer Flyde dans un vrai projet.

Perso, je vois plusieurs cas d’usage hyper prometteurs pour Flyde. C’est d’abord un super accélérateur pour les juniors et les non-devs qui pourront prototyper rapidement des trucs qui claquent sans se prendre la tête. Ca permet également de booster la collaboration en ouvrant sa base de code aux gens du marketing ou à l’équipe produit.

De plus, c’est un formidable outil pédagogique aussi ludique que scratch pour enseigner des concepts de programmation avancés aux étudiants. Sans oublier le gain de productivité pour les devs expérimentés qui aiment bien avoir une vue d’ensemble sur des architectures d’API ou de microservices complexes.

Bref, je suis convaincu que Flyde (ou un de ses futurs fork) va changer notre façon de coder dans les années à venir. Si vous couplez ça à l’IA, ça va faire un malheur.

🔲 ☆

Projet de loi portant diverses dispositions d'adaptation au droit de l'Union européenne en matière d'économie, de finances, de transition écologique, de droit pénal, de droit social et en matière agricole

Le projet de loi transpose plusieurs directives et met en cohérence le droit français avec des règlements européens dans des domaines variés (congés payés, droit de la consommation, numérique, transition écologique, garde à vue, droits des fonctionnaires...). Plusieurs habilitations du gouvernement à légiférer par ordonnance sont aussi prévues.
🔲 ☆

Les IA comme ChatGPT aident-elles réellement les étudiants en informatique ?

Vous êtes un étudiant en informatique, tout frais, tout nouveau, et on vous balance des exercices de programmation à faire. Panique à bord !

Mais attendez, c’est quoi ce truc là-bas ?

Ah bah oui, c’est ChatGPT, votre nouveau meilleur pote ! Il est capable de résoudre vos exos en deux temps trois mouvements, grâce à des techniques de traitement du langage naturel (NLP) et d’analyse de langage de programmation, mais attention, c’est pas si simple.

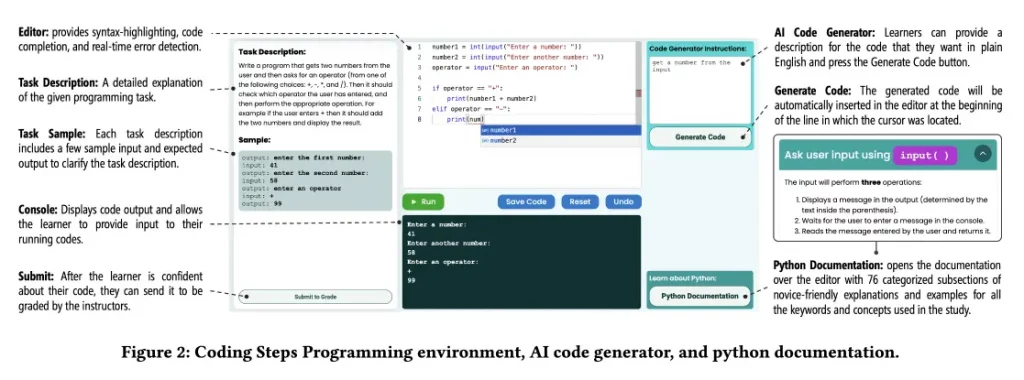
Des chercheurs ont voulu creuser la question et voir comment ces générateurs de code IA influencent vraiment l’apprentissage des étudiants et pour cela, ils ont réalisé 2 études. Dans la première, ils ont pris 69 étudiants, des novices complets en Python et les ont séparés en deux groupes : Ceux qui utiliseront l’IA et ceux qui coderont à l’ancienne sans IA.

Durant 7 sessions, ils leur ont donné des exos à faire. Les Jedis boostés à l’IA avaient accès à un générateur de code basé sur Codex, un modèle d’apprentissage automatique qui utilise le NLP et l’analyse de langage de programmation pour générer du code à partir des entrées des utilisateurs. Les autres, eux, devaient se débrouiller.

Résultat des courses ?

Les dev augmenté à l’IA ont cartonné ! Ils ont fini 91% des tâches contre 79% pour les autres. En plus, leur code était beaucoup plus correct. Toutefois, sur les tâches où il fallait modifier du code existant, les deux groupes étaient au coude à coude. Ensuite, ils ont fait passer des tests de connaissance aux étudiants, sans l’IA. Et là, surprise ! Les deux groupes ont eu des scores similaires. Mais quand ils ont refait les tests une semaine plus tard, les étudiants du goupe boosté à l’IA ont mieux retenu ce qu’ils avaient appris.

Dans la deuxième étude, les chercheurs ont analysé comment les étudiants utilisaient vraiment le générateur de code. Et là, révélations ! Certains en abusaient grave, genre copier-coller direct la consigne sans réfléchir. Pas cool ! 😅 Mais d’autres étaient plus malins et s’en servaient pour décomposer le problème en sous-tâches ou vérifier leur propre code.

Alors, que faut-il en retenir ?

Et bien que l’IA peut être un super outil pour apprendre à coder, mais à condition savoir l’utiliser intelligemment. C’est pourquoi les concepteurs d’outils et les profs doivent encourager une utilisation responsable et auto-régulée de ces générateurs de code. Sinon, c’est le drame assuré !

Pour ma part, vous le savez, le développement, c’est pas mon truc. Mais depuis que l’IA a débarqué dans ma vie, « sky is the limit » et ça m’aide énormément. Et comme ces étudiants, si je pose mon cerveau que je passe en mode copié-collé IA, à la fin, je vais avoir du caca. Mais si je comprends ce que je veux faire, si je maitrise mon code plus comme un chef de projet bien technique et bien c’est redoutablement efficace. Et ce qui est encore plus cool, c’est que j’apprends plein de trucs. On dit souvent qu’il faut forger pour devenir forgeron. Et bien là c’est le cas, car je ne m’encombre plus des problématiques de syntaxe, et je construis brique par brique mes outils en comprenant tout ce que je fais. Donc l’IA pour développer, oui !! Mais en laissant le cerveau allumé.

En tout cas, une chose est sûre, c’est en train de révolutionner l’apprentissage du code. Ça promet pour le futur mais faudra veiller à ce que les étudiants apprennent vraiment à faire les choses et ne deviennent pas des zombies du copier-coller (on avait déjà le souci avec StackOverflow, cela dit…).

Source

🔲 ☆

Justine Tunney booste encore une fois les performances de llama.cpp

La révolution de l’IA est en marche depuis un bon moment maintenant mais faire tourner les derniers modèles de langage comme llama.cpp sur votre bécane, demande de la puissance. C’est là qu’intervient Justine Tunney, hackeuse et ex-programmeuse de chez Google, qui vient de pondre de nouveaux kernels d’algèbre linéaire pour booster les perfs de llama.cpp.

Concrètement, elle a réécrit les routines qui font les multiplications de matrices, c’est à dire les opérations au cœur des réseaux de neurones et en utilisant les dernières instructions vectorielles AVX-512 et ARM dotprod, elle a réussi à multiplier par 5 la vitesse d’exécution sur les processeurs récents d’Intel, AMD et ARM.

Mais ce n’est pas tout, elle a aussi bossé sur l’optimisation mémoire. Fini le temps où les calculs étaient ralentis par les accès à la RAM. Grâce à une utilisation intelligente du cache L2 et du prefetching, elle arrive maintenant à diviser par 2 le temps de chargement des données.

Résultat, llama.cpp et les autres modèles compatibles tournent comme des horloges, même sur des configs modestes. Fini les CUDA cores hors de prix, un bon vieux processeur avec un peu de RAM suffit. De quoi démocratiser l’accès à l’IA sans se ruiner surtout que son code est dispo sur son GitHub. Il est écrit en C++ avec zéro dépendance externe et peut être compilé sur Linux, macOS, Windows, FreeBSD et même SerenityOS.

Mais Justine ne compte pas s’arrêter là. Elle planche déjà sur le support de nouveaux formats de données comme le FP16 et le BF16 pour réduire encore l’empreinte mémoire. À terme, elle espère faire tourner les IA les plus gourmandes sur un Raspberry Pi ! Chouette non ?

D’un côté on a donc les géants comme Nvidia qui misent tout sur leurs accélérateurs graphiques propriétaires et de l’autre les hackers et les libristes qui veulent garder le contrôle de leur machine avec du code ouvert et optimisé.

En attendant, je vous invite à tester ses kernels par vous-même et à voir la différence. C’est peut-être ça le véritable sens du progrès technologique : permettre au plus grand nombre d’accéder à des outils auparavant réservés à une élite.

Source

🔲 ☆

Code Llama 70B, le dernier ajout de Meta à sa famille d’IA génératrices de code

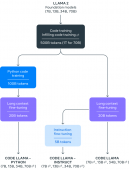
Meta annonce le lancement de Code Llama 70B, disponible dans les mêmes  versions que les modèles Code Llama  publiés le 24 août dernier :  CodeLlama – 70B, le modèle de code fondamental, CodeLlama – 70B – Python, comme son nom l’indique, spécialisé en Python, et Code Llama – 70B – Instruct 70B, affiné pour comprendre les instructions en langage naturel. Tous trois, comme leurs prédécesseurs, sont gratuits pour la recherche et une utilisation commerciale.

Llama 2, le modèle présenté par Meta en juillet dernier a été affiné sur ses ensembles de données spécifiques au code pour concevoir “Code Llama”, une famille de modèles capables de générer du code informatique et du langage naturel lié au code, à partir d’invites en code ou en langage naturel.

Code Llama, qui peut également être utilisé pour la complétion de code et le débogage, prend en charge la plupart des langages de programmation les plus populaires utilisés aujourd’hui, notamment Python, C ++, Java, PHP, Typescript (Javascript), C #, Bash.

En août dernier, le modèle était disponible en trois tailles: 7, 13 et 34 milliards de paramètres, la famille s’agrandit avec Code Llama 70B, le plus performant selon Meta. Les versions précédentes ont été entraînées sur 500 milliards de jetons de code et de données liées au code, la dernière sur 1000 milliards. Les modèles 7B et 13B ont également été formés avec la capacité de remplissage au milieu (FIM), ce qui leur permet d’insérer du code dans un code existant.

Les modèles répondent à différents besoins de service et de latence. Les modèles 34B et 70B donnent les meilleurs résultats et permettent une meilleure assistance au codage, mais les modèles plus petits de 7B, qui peut être servi sur un seul GPU, et 13B sont plus rapides et plus adaptés aux tâches nécessitant une faible latence, comme l’achèvement de code en temps réel.

Evaluations des performances de Code Llama

Pour tester les performances de Code Llama par rapport aux solutions existantes, Meta a utilisé deux benchmarks de codage populaires : HumanEval et Mostly Basic Python Programming (MBPP). HumanEval teste la capacité du modèle à compléter du code en fonction des docstrings et MBPP sa capacité à écrire du code en fonction d’une description.

Les tests de référence ont montré que Code Llama performait mieux que les LLMs open-source spécifiques au code et surpassait Llama 2. Code Llama 34B, par exemple, a obtenu un score de 53,7% sur HumanEval et de 56,2% sur MBPP, le plus élevé par rapport à d’autres solutions ouvertes de pointe. Surpassant GPT-3,5 turbo sur HumanEval, il se rapproche de GPT-4.

Lors d’une évaluation quantitative du risque de génération de code malveillant, Meta a  démontré que les réponses de Code Llama sont plus sûres que celles de GPT-3,5 turbo.


meta-code-llama

❌