Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

85·Faut-il craindre l’intelligence artificielle (IA) ?

Définition de l’Intelligence Artificielle

Pour ma part, je ne crains nullement ce que l’on appelle “l’Intelligence Artificielle” (IA). Depuis quelques années, on voit se développer sur internet et les réseaux sociaux, une nouvelle forme de diffusion de l’information écrit et visuelle. Cette diffusion fait appel aux nouvelles technologies fondées sur l’informatique. Rappelons pour commencer que l’IA est une branche de l’informatique. Celle qui permet aux systèmes d’apprendre et d’exécuter des tâches normalement associées à l’intelligence humaine. Comme la reconnaissance vocale, la prise de décisions ou la perception visuelle. Rappelons que dans les années 80, deux techniques importantes furent développées.

La première, le deep learning (DL), ou « apprentissage en profondeur », a permis aux ordinateurs d’apprendre par l’expérience. Le second, le « système expert » (SE), imite la capacité de l’être humain à prendre des décisions. Les ordinateurs ont commencé à utiliser un raisonnement fondé sur des « règles » en recourant principalement à une structure « si… alors » mise en œuvre pour répondre à des questions binaires. Ici, la réponse est soit oui, soit non. Depuis les années 2000, trois améliorations ont été apportées :

1. Développement des unités de traitement graphique (GPU) sans lesquelles une IA serait non crédible, provoquant juste un simple haussement d’épaules.

2. Exploitation de l’énorme quantité d’informations mémorisées (Le “Big Data”) depuis qu’internet existe (BD).

3. Développement de nouveaux algorithmes utilisant des variables cachées qui permettent de trier et d’optimiser les résultats d’un calcul.

Variables cachées

En réalité, les points #1 et #2 sont assez triviaux et de nature purement technologique. Ils n’expliquent pas le développement fulgurant observé dans le domaine de l’IA ces dernières années. Ce qui est crucial, c’est le point #3 sur lequel il convient d’être plus bavard :


Car, la description « accessible » que l’on a d’un système, est très souvent la liste de ses comportements observables. Une telle liste est très habituellement une fonction de variables qui ne sont pas immédiatement évidentes. On parle alors de variables dites “cachées” ou bien encore “latentes”. Et, ces variables “cachées” mais hautement pertinentes, sont beaucoup moins nombreuses que les variables observées qui nous sont directement accessibles. D’où le développement de nouveaux algorithmes dont le but n’est pas de traiter directement les observables accessibles. Mais, plutôt, de réduire l’espace des données disponibles à quelques variables cachées. Variables qui sont peu nombreuses, et qui décrivent au mieux les données brutes disponibles.

Analyse en Composantes Principales (ACP)

L’outil clé est ici l’analyse en composantes principales (ACP ou PCA en anglais pour principal component analysis). Cette analyse consiste à transformer des variables dites « corrélées » sur un plan statistique, en nouvelles variables décorrélées les unes des autres. Ces nouvelles variables se nomment « composantes principales » ou axes principaux. L’ACP permet donc de résumer l’information énorme disponible avec de nombreuses variables corrélées en un petit nombre de variables indépendantes les unes des autres. D’un point de vue mathématique, selon le domaine d’application, on utilise soit la transformation de Karhunen–Loève (KLT), soit la transformation de Hotelling (HT).
Les champs d’application de l’ACP sont aujourd’hui multiples, allant de la biologie à la recherche économique et sociale, et plus récemment le traitement d’images et l’apprentissage automatique. L’utilité de l’ACP réside dans les points suivants :

Description et visualisation des données complexes.

Décorrélation des données brutes, la nouvelle base étant constituée d’axes non corrélés entre eux.

Minimisation du bruit, en considérant que les axes que l’on décide d’oublier sont des axes bruités.

Effectuer une réduction de dimension des données d’entraînement en apprentissage automatique.

Il s’agit d’une approche aussi bien géométrique que statistique. Géométrique, puisque les variables se représentent dans un nouvel espace, selon des directions d’inertie maximale. Statistique, parce que la recherche porte sur des axes indépendants expliquant au mieux la variabilité — la variance — des données. En résumé, lorsqu’il s’agit de compresser un ensemble de variables aléatoires, les premiers axes de l’ACP constituent un meilleur choix, aussi bien du point de vue de l’inertie géométrique que depuis la perspective de la variance statistique.

Insuffisance du ternaire GPU/BD/ACP

Après cette démystification de ce qui se cache derrière une IA, se pose l’inévitable question de savoir si la notion “d’intelligence” est réductible à ce ternaire (GPU/BD/ACP). Pour ce qui me concerne, la réponse à cette question est un “non”, franc et massif. Et, pour bien enfoncer le clou, voici quelques éléments de réflexion.


Pour fonctionner, une IA a besoin d’accéder à une base de données de type Big Data (BD), la plus large possible. Le gros problème qu’elle rencontre ici est que pour accéder aux données, il lui faut disposer d’une source d’alimentation électrique. Débranchez l’IA du secteur, ou bien, retirez-lui sa batterie et il n’y a plus rien, de manière instantanée. Toutefois, dès que vous remettez une source d’énergie, le système redémarre et redevient totalement opérationnel.

Pour un être humain, ce débranchement instantané est impossible. Si vous le privez de nourriture, il pourra continuer à fonctionner pendant des années tant qu’il aura de l’eau à sa disposition. Évidemment, si vous lui supprimez l’eau, il finira par mourir au bout de quelques jours. Mais, en aucun cas, la perte d’activité sera instantanée comme avec une intelligence artificielle. Et, une fois l’être humain mort, impossible de redevenir opérationnel si la nourriture et l’eau redeviennent disponibles. Ces simples considérations d’alimentation, nous font toucher du doigt que si le cerveau est parfaitement capable d’utiliser le triangle GPU/BD/ACP, il ne peut pas être réduit à cela. Il y a un plus, qui dépasse le strict cadre informatique.

Et, la Conscience ?

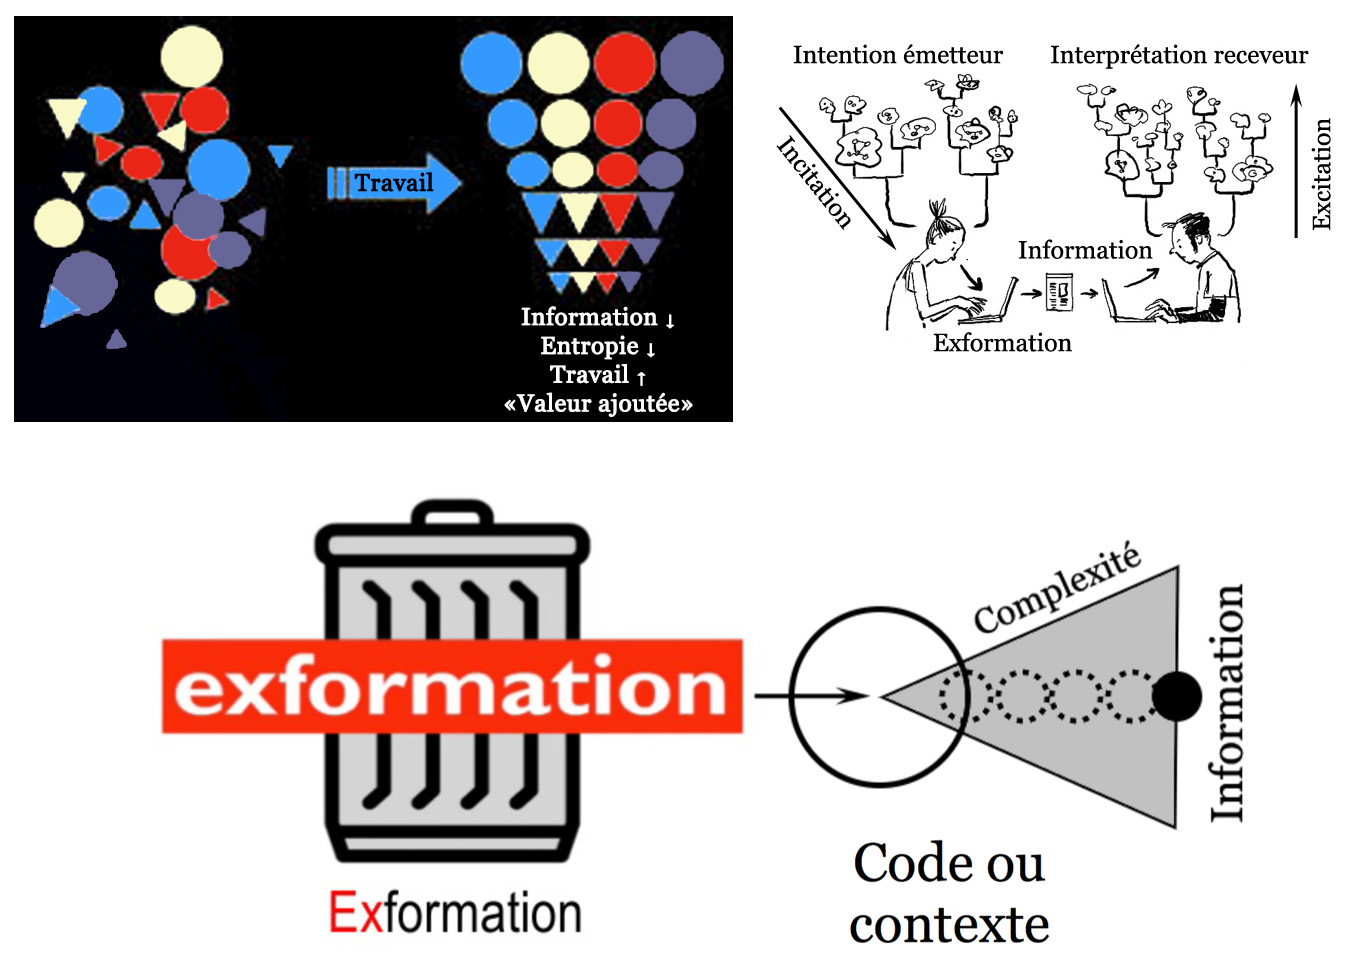
Ce truc est, bien sûr, ce que l’on appelle la “conscience”. Et, comme il est facile de le démontrer (voir https://riviste.fupress.net/index.php/subs/article/view/161), cette conscience est aussi bien neuronale (le moi vu de l’extérieur) qu’extra-neuronale (le moi-même vu de l’intérieur). Rappelons que si le moi traite l’information transmise à l’extérieur du système, le moi-même traite pour sa part l’exformation, c’est-à-dire le contexte, qui lui reste piégé à l’intérieur du système n’étant jamais transmis (voir ici pour en savoir plus : https://marchenry.org/product/de-linformation-a-lexformation/). Pour faire plus simple, un cerveau humain traite l’information aussi bien de manière digitale via les neurones (GPU/BD/ACP) que de manière intuitive via l’eau d’hydratation de ces mêmes neurones. Bref, tant qu’une IA n’utilisera pas l’eau, elle restera largement en deçà d’une intelligence biologique (IB), bactérienne, végétale, animale ou humaine. Car, la fonction “intuition” utilise l’eau, interface de communication instantanée et non locale avec le vide quantique, appelé aussi “éther”.

Intelligence Biologique

Un dernier point concerne la notion même d’intelligence. Si l’on y réfléchit un tant soit peu, pas besoin d’être intelligent pour prendre des décisions lorsque l’on dispose d’une base de données gigantesque. Bien au contraire. On reconnaît l’intelligence quand on est capable de prendre la bonne décision avec un minimum d’information à sa disposition. L’IA, telle qu’on la connaît de nos jours, n’est donc en rien “intelligente”. Car, si l’on réduit la taille de la BD à un contenu minimal, plus rien ne sort. Avec des êtres humains, c’est totalement différent. Certains d’entre eux, appelés “génies” sont capables de faire des merveilles, voire des miracles, avec trois fois rien comme données. La raison en est simple, et l’on retrouve ici la possibilité de décider par intuition, et non par raisonnement.

Conclusion

On peut hautement être impressionné par les performances actuelles de l’intelligence artificielle. Mais, qu’il soit bien clair qu’il s’agit ici de performance technologique sous réserve d’un accès sans limites à l’électricité. Rien n’empêche de rêver à un monde dans lequel les machines remplaceraient les êtres biologiques fonctionnant à l’eau. Mais, un tel monde serait extrêmement peu efficace et d’une viabilité nulle à long terme.

Plutôt que de parler d’intelligence artificielle, on ferait peut-être mieux de parler de machines expertes dans le traitement de l’information. Car, on peut exceller dans la collecte et l’analyse d’un maximum d’information, tout en étant un parfait idiot sur le plan de la créativité. La folie actuelle autour de tous ces robots hyper-efficaces, ne pourra pas durer éternellement. Alors que la vie biologique, bactérienne ou cellulaire, existe depuis des milliards d’années. Par conséquent, s’il y a lieu d’être inquiets pour l’avenir, c’est plutôt face aux manipulations génétiques ou à la pollution toujours croissante de l’eau.

The post 85·Faut-il craindre l’intelligence artificielle (IA) ? appeared first on Marc HENRY - Natur'Eau Quant.

🔲 ⭐

The Personal AI Greenfield

What forms of pAI—personal AI—are Apple, Mozilla, Google, Meta, Microsoft and the rest not doing?

Let’s look at those first two because they’re at the top of the news LIFO buffer.

Apple Intelligence (“coming in beta this fall*“), announced yesterday, will help you with writing and creating images while giving you less lame answers from Siri. (Which they should re-name. Siri is Apple’s Clippy.) It “can draw on larger server-based models, running on Apple silicon, to handle more complex requests for you while protecting your privacy.” The “larger models” will be white-labeled ChatGPT, plus Apple’s own small language models (SLMs).

Mozilla, which got $400+ million a year from Google (for search in the Firefox browser) starting in 2020, announce on June 3 that they will be Building open, private AI with the Mozilla Builders Accelerator. Jive:

This program is designed to empower independent AI and machine learning engineers with the resources and support they need to thrive. It aims to cultivate a more innovative AI ecosystem, and it’s one of Mozilla’s key initiatives to make AI meaningfully impactful — alongside efforts like Mozilla.ai, the Responsible AI Challenge and the Rise25 Awards.

The Mozilla Builders Accelerator’s inaugural theme is local AI, which involves running AI models and applications directly on personal devices like laptops, smartphones, or edge devices rather than depending on cloud-based services…

We chose Local AI as the theme for the Accelerator’s first cohort because it aligns with our core values of privacy, user empowerment, and open source innovation. This method offers several benefits including:

  • Privacy: Data stays on the local device, minimizing exposure to potential breaches and misuse.
  • Agency: Users have greater control over their AI tools and data.
  • Cost-effectiveness: Reduces reliance on expensive cloud infrastructure, lowering costs for developers and users.
  • Reliability: Local processing ensures continuous operation even without internet connectivity.

Looks to me like both of these are Big AI writ small. It’s “local,” not personal. It’s made to serve your needs with what BigAI offers through APIs. It is still essentially AIaaS (AI as a Service), rather than truly personal AI (pAI): personalized more than personal.

That’s also what I see when I read between the lines at Mozilla’s AI job openings. Take platform engineer. This person will (among other things), “assist in managing and orchestrating workloads across multiple cloud providers.” That’s fine. I’m sure true pAIs will do that too. But most of pAI will be more personal than that. It will deal with the mundanities of your everyday life. Not with coughing up answers that can only come from AIaaSes.

The problem with personalizing AI giant offerings is that they are large language models (LLM) trained on everything that can be crawled on the Internet, plus who knows what else. Not on your truly personal stuff. This is why “prompt engineering” worthy of the noun is ” not for anybody:

Prompt engineering is crucial for deploying LLMs but is poorly understood mathematically. We formalize LLM systems as a class of discrete stochastic dynamical systems to explore prompt engineering through the lens of control theory. We investigate the reachable set of output token sequences $R_y(\mathbf x_0)$ for which there exists a control input sequence $\mathbf u$ for each $\mathbf y \in R_y(\mathbf x_0)$ that steers the LLM to output $\mathbf y$ from initial state sequence $\mathbf x_0$. We offer analytic analysis on the limitations on the controllability of self-attention in terms of reachable set, where we prove an upper bound on the reachable set of outputs $R_y(\mathbf x_0)$ as a function of the singular values of the parameter matrices. We present complementary empirical analysis on the controllability of a panel of LLMs, including Falcon-7b, Llama-7b, and Falcon-40b. Our results demonstrate a lower bound on the reachable set of outputs $R_y(\mathbf x_0)$ w.r.t. initial state sequences $\mathbf x_0$ sampled from the Wikitext dataset. We find that the correct next Wikitext token following sequence $\mathbf x_0$ is reachable over 97% of the time with prompts of $k\leq 10$ tokens. We also establish that the top 75 most likely next tokens, as estimated by the LLM itself, are reachable at least 85% of the time with prompts of $k\leq 10$ tokens. Intriguingly, short prompt sequences can dramatically alter the likelihood of specific outputs, even making the least likely tokens become the most likely ones. This control-centric analysis of LLMs demonstrates the significant and poorly understood role of input sequences in steering output probabilities, offering a foundational perspective for enhancing language model system capabilities.

But all that stuff applies mostly when we’re prompting a big LLM system.

What about using AI in our own lives, where the data that matters most are in our calendars, contacts, financial and health records, our travels, our correspondence (email, chat, whatever)? And how about all the location data we might get from our cars, phone apps, and phone companies? These should be much easier for a pAI to gather, examine, and help us do useful things. Caring about much less data also means a pAI will be less likely to give wrong (hallucinated) answers.

Today the mental frame almost everybody uses for AI is the Big kind, ingesting everything they can get their crawlers on, and munching all of it in giant compute farms. Those systems are great for lots of stuff, but they still don’t deal with personal data listed in the last paragraph.

Not yet, anyway.

Look at it this way. For each of us, there are three data pools:

  1. The entire Net, which is what gets crawled by all the giant LLM operators, plus whatever else they can get their claws on.
  2. One’s personal life, some of which is digitized in useful form (contacts, calendar, mail, stuff in folders inside PCs and attached drives).
  3. Personal data that is in the hands of giants, but is rightfully ours. These include our driving record and driving practices (,recorded by our late model cars and snitched to insurance companies and others), our location data (kept and shared by car and phone carriers to the likes of Google and the feds), our TV viewing habits, (gathered by Google, Amazon, Roku, Apple, etc.).

The pAI greenfield is with the last two.

Tell us who is working on what there, preferably with open source, and not sitting on walled garden silicon.

[Later… ] Since readers told me I had small language models (SLMs) wrong in one of the paragraphs above, and I’m not sure I had them right, I rewrote them out of the piece. I invite readers to post comments to further correct and expand on the subject of pAIs and what they can do.

🔲 ☆

IA et data, une relation fusionnelle pour libérer toute la puissance des données

Il n’est pas simple de suivre les avancées dans le domaine de l’intelligence artificielle, encore moins leur mise en œuvre. Cependant, face à la mise en place de nouvelles réglementations (IA Act ou la déclaration de Bletchley sur la sécurité de l’IA signée par 28 pays), il sera bientôt difficile d’invoquer cette excuse. Un cadre plus précis pour la réglementation de l’IA va faciliter sa mise en œuvre dans les entreprises, à condition de disposer d’un socle de données solide.

Principale conséquence, les dirigeants mettent la pression sur leurs collaborateurs en leur demandant de démontrer rapidement la valeur de l’IA pour l’entreprise. Ce sont les équipes en charge des données qui se trouvent en première ligne. Ces experts jouent un rôle clé dans toute stratégie d’IA, car leur mission consiste à alimenter les modèles en injectant des informations contrôlées tout en s’assurant de leur pertinence et de leur éthique.

Les équipes data entretiennent désormais avec l’IA des relations réellement fusionnelles. Certes, une de leurs missions consiste à vérifier les informations alimentant l’intelligence artificielle, mais pour réaliser son plein potentiel, l’IA peut avant tout les aider à extraire le maximum de valeur des données disponibles.

Améliorer les processus de données avec l’IA

S’il est reconnu depuis longtemps que les données massives engrangées par les entreprises cachent une valeur significative ; aujourd’hui l’IA peut jouer un rôle majeur dans l’amélioration des processus analytiques et contribuer à exploiter pleinement le potentiel non encore exploré des données.

Au-delà de la rapidité d’analyse souvent associée à l’IA, ces technologies sont capables de créer des modèles prédictifs qui permettent aux entreprises d’anticiper les tendances et leurs résultats, un avantage incontesté dans un contexte économique perturbé. Ainsi, dans le domaine de la santé, les entreprises collectent des données à chaque interaction avec le patient et à chaque test de diagnostic. Ces données sont ensuite utilisées pour prévoir de possibles goulots d’étranglement et le flux de patients entre les services, pour mieux répondre à la demande et dispenser les meilleurs soins possibles.

Le principal atout de l’IA pour les équipes data est bien là : apporter des réponses aux questions qu’elles ne se posaient même pas. Outre la capacité à analyser de très grandes quantités d’informations, l’IA peut instantanément identifier des relations, des formes, des patterns et des anomalies dans des jeux de données. Pour les entreprises cela signifie que sans être des data scientists, les utilisateurs métiers et les analystes seront capables de tirer des données toute leur valeur.

Et pourtant adopter l’IA ne se fait pas d’un coup de baguette magique. Les équipes data connaissent les difficultés que présente l’intégration de l’IA aux processus en place qui ont fait leurs preuves, même s’ils demeurent perfectibles. Des tests rigoureux et le respect des réglementations en vigueur sont essentiels pour créer un socle de données nécessaire à l’adoption de l’IA et atteindre l’équilibre entre le risque et l’innovation.

Mettre l’IA au service des équipes data

Conscients des avantages, mais aussi des interrogations que peuvent avoir les professionnels des données qui cherchent à améliorer les processus analytiques grâce à l’IA, comment appliquer concrètement ces techniques et les mettre en pratique pour maximiser leur valeur ?

  • Trouver des quick wins : malgré la capacité de l’IA à gérer des données non structurées, c’est dans les informations structurées que se trouvent les gains les plus rapides. Connues et exploitées de façon régulière par les entreprises, ces données sont propres, fiables et représentent une bonne base pour tester des techniques d’IA plus sophistiquées sans prendre de risques.
  • Choisir un cas d’usage pour mesurer l’impact de l’IA : fait désormais avéré, l’IA aura un fort impact dans les entreprises. Il est donc important d’associer l’IA à un cas d’usage précis pour produire un retour démontrable. Simplement expérimenter avec la technologie ne mènera nulle part. Pour démontrer les avantages de la technologie, les initiatives et les investissements dans l’IA, souvent pilotés par l’équipe data chargée de la gestion des modèles, doivent être guidés par un objectif précis.
  • Penser aux utilisateurs : utiliser l’IA dans les processus de données ne garantit pas qu’elle apportera un résultat business. Une analyse avancée ne présente aucun intérêt si elle ne peut être partagée clairement avec les décideurs. Il est essentiel d’impliquer les utilisateurs de ces informations dans tout le processus, de la création du modèle d’IA jusqu’à la manière dont les insights vont être partagés. Trop souvent les modèles innovants restent non utilisés parce que la façon dont ils sont déployés ne correspond pas aux besoins et aux attentes de l’utilisateur final des données.
  • Minimiser les risques grâce à l’intégration des données : l’intégration et la gouvernance des données sont deux piliers essentiels à la mise en œuvre de nouveaux processus impliquant l’IA. Cette dernière exige également une approche plus souple de la gestion des données, parce que l’ingestion de nouvelles données peut très vite modifier un modèle. Les organisations doivent bâtir une source de données fiable, solide et gouvernée, pour soutenir les processus de données et d’analyse actuels, mais aussi être en mesure de s’ouvrir aux nouvelles techniques basées sur l’IA.
  • Aller de l’avant et expérimenter : le déploiement de processus de sécurité et de gouvernance des données ne doit pas empêcher les équipes data d’expérimenter avec l’IA. Il est essentiel de se donner des objectifs clairs, correctement anonymiser les données et introduire des POC avec le concours du service IT. Remettre en cause des processus existants n’est jamais facile, c’est même une raison de plus pour expérimenter sans tarder.

    Avec l’aide de l’IA, les équipes data peuvent extraire les données plus rapidement et en obtenant des résultats bien meilleurs. Parfois des applications adressant des consommateurs font la une, mais avant d’y arriver, il est indispensable d’optimiser l’utilisation des données pour les équipes internes. Comme pour toute nouvelle technologie, introduire de l’AI dans des processus établis suscite des débats sur son véritable impact business. Si l’IA était appliquée aux process fondamentaux qui sous-tendent l’IA, cet impact pourrait être exponentiel.

Compte tenu du potentiel que cachent les données d’entreprise, l’IA semble un allié indispensable pour beaucoup, mais son l’adoption reste un long chemin. Pour maximiser son intérêt, les équipes data doivent avancer étape par étape, par itérations et apprendre en permanence, sans négliger les pratiques éthiques et responsables. Et surtout, se lancer sans hésiter !

tribune_nick_magnuson_qlik
🔲 ☆

L’ouverture des données de forte valeur, un enjeu d’intérêt général ?

Des données précieuses pour nos sociétés dans des domaines tels que l’environnement ou la mobilité doivent être publiées en Open Data par les autorités publiques avant le 9 juin prochain. Ces données “de forte valeur” sont celles dont le potentiel de valorisation est élevé sur le plan socio-économique. Elles s’inscrivent, tout comme les données d’intérêt général, dans le cadre juridique européen actuel (règlement d’exécution, Data Act, Data Governance Act).

Dès 2007, la directive “Inspire” exigeait que les autorités publiques européennes puissent rendre ces données accessibles au public. L’Union européenne a mis en place une infrastructure d’information géographique pour faciliter le suivi des politiques environnementales, en obligeant les autorités publiques à recenser les données qu’elles détiennent et à les mettre sous une forme interopérable.

En 2019, la directive sur les données ouvertes définissait le régime particulier des ensembles de données de forte valeur. Elle déterminait également une liste de thématiques des données à forte valeur (en reprenant largement celle de la directive Inspire). L’objectif était donc de prévoir des obligations de diffusion particulières.

Le 20 janvier 2023, la Commission publie une liste d’ensembles de données de forte valeur que les organismes publics doivent partager gratuitement. Le règlement entré en vigueur le 9 février 2023 est applicable 16 mois plus tard, soit le 9 juin prochain. 

Le règlement de la commission ajoute toutefois de nouvelles données : stations et alertes pour la thématique météorologique, ou encore les données sur la situation d’une société, telle que sa date d’enregistrement. Il prévoit notamment d’exempter – au sens du considérant numéro 6 – certains organismes du secteur public “à leur demande et conformément aux critères énoncés dans la directive” de leur obligation pour une durée n’excédant pas deux ans à compter de la date d’entrée en vigueur du règlement soit après le 9 février 2025. Cette exemption est déterminée dans le cas où la mise à disposition des données de forte valeur implique “une incidence importante sur le budget des organismes concernés”.

Pour mémoire, les thématiques des données de forte valeur sont les suivantes : 

  • Géospatiale ;
  • Observation de la terre et de l’environnement ;
  • Météorologie ;
  • Statistiques globales sur le pays (très large car beaucoup de sujets divers : flux touristique en Europe, chômage, main d’œuvre fonctionnelle) ;
  • Entreprises et propriété d’entreprises ;
  • Mobilité (réseaux de transport notamment).


Ces données doivent être diffusées en respectant plusieurs critères à savoir : 

  • Être ouvertes sous licence “CC BY 4.0” ou toute licence ouverte équivalente ;
  • Par le biais d’une API et sous la forme d’un téléchargement en masse ;
  • Dans leur version la plus récente et sous un format ouvert et lisible par machine (reconnue au niveau européen ou international) ;
  • Immédiatement après la dernière actualisation ;
  • Accompagnées de métadonnées.

Ce cadre autour des données de forte valeur traduit une volonté de favoriser l’accès et la réutilisation des données publiques. Il fait notamment écho aux travaux menés par Etalab et la DINUM au sujet du Service public de la donnée (SPD) et du portail national “data.gouv”. 

Ce chantier se poursuit et il y a fort à parier que des données de fortes valeurs soient accessibles dans les prochaines semaines, à l’instar des données météo. 

D’ailleurs n’hésitez pas à participer au prochain hackathon : https://www.data.gouv.fr/fr/posts/hackathon-donnees-ouvertes-meteo-france-venez-valoriser-les-donnees-publiques-meteorologiques/ 

🔲 ⭐

L’open-data, vecteur de transformation et d’innovation

Pour Numéricité, l’open est vecteur de transformation et d’innovation. La donnée est un actif à haute valeur stratégique. Elle permet de partager et d’interpréter de l’information. Fluidifier la circulation des données et encourager leur ouverture, c’est engager les organisations, publiques comme privées, dans l’adoption d’une culture de la donnée. C’est aussi un gage d’une meilleure transparence et efficacité de l’action publique, dans une logique de gouvernement ouvert. Enfin, c’est faciliter le développement de l’économie numérique en permettant des innovations privées appuyées sur des données publiques ouvertes.

C’est pourquoi les entreprises et les administrations publiques se transforment afin de mieux valoriser ces données et investissent dans la construction et la mise en place d’une stratégie data au service de leur stratégie globale.

Retour sur nos missions phares, traduction concrète de notre offre Transfo-soft !

Afin de faciliter la vie des usagers, citoyens comme entreprises, notre pôle Intelligence juridique et conformité a appuyé l’ouverture des données, comme celles produites par France Chaleur Urbaine ou MaCantine.

Moderniser les SI est un prérequis pour faciliter la circulation de la donnée. Pour cela, nous proposons une expertise d’audit nous permettant de formuler des recommandations d’actions concrètes. L’objectif est d’engager la transformation par les métiers, en améliorant leur process internes ou leur organisation produit par exemple.

Numéricité, c’est une équipe d’hommes et de femmes motivés par l’usage d’un numérique ouvert et responsable pour opérer des transformations. Loin d’être promoteur d’un solutionnisme technologique, nous nous faisons chantres de l’open, facteur de transparence et d’efficacité et d’innovation.

La France a une longue histoire d’amour avec l’open-data, et a forgé une vision particulière, notamment sous l’impulsion d’Etalab. Au travers de nos missions, nous sommes fiers de promouvoir ce numérique public français, cette “Digital French Touch”. Nous dessinons déjà la suite d’Etalab grâce aux anciens de la mission ayant rejoint Numéricité et notre réseau de partenaires, et ne cessons d’interroger l’open au regard des nouvelles dimensions technologiques et réglementaires afin de l’entretenir.

Découvrez nos missions phares de sensibilisation à la culture de la donnée et de transmission de la logique d’État-plateforme.

Nous avons accompagné de nombreux acteurs, territoires et gouvernements dans la concertation, la construction et la priorisation de leurs stratégies data. Un seul impératif : mettre l’humain, que ce soit les métiers, les acteurs économiques et/ou les usagers au cœur de la réflexion.

Pour embarquer ces différents collectifs, qu’ils soient spécialistes ou non de la data, nous disposons d’un large éventail de formats : open-lab, ateliers, entretiens, expérimentations, cas d’usage, datadays, hackathons. Il s’agit là d’une première brique de notre approche produit des stratégies data, visant ensuite à s’interroger sur les données à mobiliser, la gouvernance à constituer, les compétences à renforcer, avant de réaliser des expérimentations à petite échelle pour confirmer les orientations.

Voici quelques exemples emblématiques :

Co-construire une stratégie data et rédiger une feuille de route actionnable et appropriable pour Bruxelles, en se faisant facilitateur d’ateliers de travail thématiques.

Mobiliser le potentiel des datas pour améliorer les mobilités à l’échelle régionale lors d’un hackathon au cours duquel les participants pouvaient répondre aux quatre défis pensés en lien avec la stratégie open data d’Île-de-France Mobilités.

Aligner les différentes parties prenantes du Groupe Vyv sur une position ambitieuse autour de l’ouverture des données assurantielles, qui permette de mettre l’usager au centre de l’utilisation de ces données, en organisant une série d’open-lab.

Accompagner la rédaction de la feuille de route de la Direction du Numérique et de la Modernisation de Nouvelle-Calédonie, en organisant en partenariat avec Atlas Management une série d’ateliers, en proposant un parangonnage des exemples internationaux et en coachant des prototypes (POC) data appuyés sur la donnée.

🔲 ☆

2023 : une année de consolidation, de diversification et d’innovations

2023 : une année de consolidation, de diversification et d’innovations

Numéricité est un studio des transformations, pour un numérique au service de l’impact et de l’intérêt général. Choisir Numéricité, c’est opter pour une méthode originale qui transforme la transformation (et les organisations).

L’année 2023 a été marquée par une consolidation et une diversification de nos activités.

Nous avons affirmé notre expertise dans la formation et le coaching des équipes projets, l’élaboration de stratégies data, la conception d’ateliers innovants et stimulants, ainsi que le développement de services numériques performants, toujours en conformité avec le RGPD.

Retour sur les moments phares qui ont rythmé cette année.

Numéricité a poursuivi sa croissance et s’est affirmé comme un acteur de la transformation numérique. Pour continuer d’accompagner au mieux les projets de nos clients, huit nouvelles personnes ont rejoint la famille Numéricité. Par ordre d’arrivée :

  • Romain Tales, Digital Transformation Specialist
  • Alexandre Le Borgne, Juriste en droit du numérique public
  • Daniel Manéa, Apprenti développeur full-stack
  • Mathilde Bras, Strategy & Innovation Manager
  • Maxime Lubrano, Responsable communication multimédia et stratégie éditoriale
  • Sarah Pilhan, Chargée de communication multimédia et stratégie éditoriale
  • Antoine Lelong, Développeur full-stack, apprenti recruté en CDI
  • Sam Khouma, Chef de projet & Product owner

Notre réseau d’experts s’est renforcé. Mathilde Hoang, Experte en transformation numérique, nous a rejoint en février. Cette collaboration nous permet d’avoir une deuxième implantation internationale, à Hanoï au Vietnam. Nous avons également renouvelé notre collaboration avec Vincent Motte, Chef de projet, et maintenons ainsi notre présence à Abidjan en Côte-d’Ivoire.

Afin d’œuvrer à la réussite des projets de nos clients, nous mettons nos expertises en commun. Celles-ci sont de plus en plus reconnues et demandées. Certains de nos experts sont d’ailleurs référencés par de grandes institutions internationales telles que le FMI ou la Banque Mondiale, et sélectionnés par ailleurs dans le cadre du Collège Numérique France 2030 du Secrétariat général pour l’investissement.

Un pôle communication s’est structuré au sein de Numéricité. Le défi ? Traduire et transmettre les expertises de l’équipe et mieux faire connaitre l’accompagnement 360° que l’on peut proposer qu’il s’agisse de conformité juridique, de développement produit en mode agile ou d’accompagnement en transformation numérique.

Cette année a également été marquée par la poursuite de nos partenariats avec d’autres acteurs de la transformation numérique tels qu’Octo, Nextmap, La Javaness, Hubvisory, Bearing Point, Malt et Opteamis.

Au sein de cet écosystème, nous faisons de notre connaissance fine du numérique public français une force. Plusieurs membres de l’équipe en ont été les forgerons dans une précédente vie professionnelle. En conciliant cela aux méthodes et techniques issues de la culture numérique, nous proposons une approche originale en mesure de donner de nouvelles capacités aux organisations que nous accompagnons.

Ensemble, transformons la transformation numérique pour en faire un levier d’amélioration de vos organisations : 

Les entreprises et administrations publiques sont convaincues de la valeur de la donnée qui est un actif stratégique pour l’ensemble de l’organisation et pas seulement pour un seul service ou une direction métier. C’est pourquoi les entreprises et les administrations publiques se transforment afin de mieux valoriser ces données et investissent dans la construction et la mise en place d’une stratégie data au service de leur stratégie globale.

Nous appuyons cette transformation à travers la co-construction de stratégies data portant sur l’ouverture des données, la modernisation des SI afin de les orienter vers une meilleure circulation de la donnée, et construisons des produits data à destination des métiers. Nous intervenons ainsi dans des secteurs à l’impact quotidien : les mobilités, la santé, le logement, le travail, l’inclusion, l’environnement, la fiscalité, les douanes, etc.

Nous réinterrogeons et transformons les organisations à travers une meilleure prise en compte des données au service de l’impact : c’est une des traductions concrètes de notre offre Transfo-soft.

Afin de faciliter la vie des usagers, citoyens comme entreprises, notre pôle Intelligence juridique et conformité a appuyé l’ouverture des données, comme celles produites par France Chaleur Urbaine ou MaCantine.

Moderniser les SI est un prérequis pour faciliter la circulation de la donnée. Pour cela, nous proposons une expertise d’audit nous permettant de formuler des recommandations d’actions concrètes. L’objectif est d’engager la transformation par les métiers, en améliorant leur process internes ou leur organisation produit par exemple.

Nous avons accompagné de nombreux acteurs, territoires et gouvernements dans la concertation, la construction et la priorisation de leurs stratégies data. Un seul impératif : mettre l’humain, que ce soit les métiers, les acteurs économiques et/ou les usagers au cœur de la réflexion.

Pour embarquer ces différents collectifs, qu’ils soient spécialistes ou non de la data, nous disposons d’un large éventail de formats : open-lab, ateliers, entretiens, expérimentations, cas d’usage, datadays, hackathons. Il s’agit là d’une première brique de notre approche produit des stratégies data, visant ensuite à s’interroger sur les données à mobiliser, la gouvernance à constituer, les compétences à renforcer, avant de réaliser des expérimentations à petite échelle pour confirmer les orientations.

Ces missions ont largement ponctué notre activité en 2023. Voici quelques exemples emblématiques :

  • Réaliser le bilan de la feuille de route du numérique 2021-2023 du Ministère de l’Éducation nationale et de la Jeunesse et des Académies et identifier les actions du futur plan relatif aux données et codes sources pour la période 2024-2027 à travers un open-lab.
  • Mobiliser le potentiel des datas pour améliorer les mobilités à l’échelle régionale lors d’un hackathon au cours duquel les participants pouvaient répondre aux quatre défis pensés en lien avec la stratégie open data d’Île-de-France Mobilités.
  • Aligner les différentes parties prenantes du Groupe Vyv sur une position ambitieuse autour de l’ouverture des données assurantielles, qui permette de mettre l’usager au centre de l’utilisation de ces données, en organisant une série d’open-lab.
  • Accompagner la rédaction de la feuille de route de la Direction du Numérique et de la Modernisation de Nouvelle-Calédonie, en organisant en partenariat avec Atlas Management une série d’ateliers, en proposant un parangonnage des exemples internationaux et en coachant des prototypes (POC) data appuyés sur la donnée.

Nous suivons la même méthode produit dans la conception de services numériques appuyés sur des données. 2023 a été marquée par la conception de 10 produits numériques par notre Pôle design et technologies.

Par exemple, avec La Fabrique des ministères sociaux et l’ARS Île-de-France, nous avons conçu et développé un outil de datavisualisation des causes médicales de décès, s’appuyant sur quelques 315K certificats de décès franciliens émis depuis 2020 et l’industrialisation d’un flux de données de l’INSERM.

Nous avons également accompagné l’Agence Nationale d’Information sur le Logement (ANIL) dans l’élaboration d’une base de données partagée avec ses relais départementaux, afin de faciliter le partage d’informations au sein du réseau. AdilStatWeb2 a été consulté 815 000 fois et une interface de croisement des données a été créée.


La démocratisation des intelligences artificielle génératives (IAG) est en train de bousculer nos pratiques à une vitesse fulgurante. Avec ces avancées, viennent des défis complexes en matière de sécurité, de responsabilité et de protection des droits fondamentaux.

Pour en savoir plus sur l’encadrement législatif de l’intelligence artificielle, (re)découvrez nos derniers articles de décryptage :

Écoutez notre podcast sur la régulation du numérique par le législateur avec Éric Bothorel, député de la 5e circonscription des Côtes-d’Armor : 

En interne, nous mobilisons plusieurs outils d’IAG (ChatGPT, MidJourney et Copilot) pour gagner en maîtrise et en efficacité tout en explorant les fonctionnalités pour de futures missions. Nous sommes d’ailleurs en train d’entraîner un NuméricitéGPT, connecté à OpenAI et basé sur le scraping des contenus de notre site, pour répondre à des besoins de communication et de partage des savoirs en interne.

Dans le cadre de nos missions, nous nous sommes particulièrement intéressés au domaine des agents conversationnels appuyés sur de grands modèles de langage (Large Language Model ou LLM). Ces innovations nous ont permis de développer des solutions adaptables, qui garantissent la protection des données exploitées.

Nous avons entraîné un modèle basé sur le LLM Mistral pour expérimenter l’usage d’un agent conversationnel sur des questions de santé sexuelle. Pour répondre, l’agent s’appuie sur des contenus web scrapés sur différents sites officiels.

Nous avons prototypé deux agents conversationnels connectés à OpenAI grâce à une clé d’API. L’hébergement de ces bots sur nos serveurs garanti la souveraineté en assurant qu’aucune données fiscales sensibles ne soient transmises à OpenAI. Grâce à ces bots, les agents de la Direction Générale des Impôts (DGI) de Mauritanie acquièrent de l’autonomie dans leurs tâches quotidiennes en pouvant générer de manière automatisée des rapports d’analyse des indicateurs issus de leur tableau de bord (bot Reporter) et interroger directement leurs jeux de données (FileBot).

Notre pôle Intelligence juridique et conformité participe à déterminer et maîtriser les impacts de l’IA dans l’administration. Cela l’a conduit à élaborer différents guides de bonnes pratiques. Avec La Javaness, nous avons accompagné Pôle Emploi afin de confronter l’offre de service de la plateforme IA aux différents usages, afin d’en adapter le contenu et inscrire ce produit et les services associés dans un processus d’amélioration. L’enjeu était de créer un socle IA du service public de l’emploi qui soit un gage de souveraineté et d’efficacité pour la puissance publique.

Numéricité prône une approche 360° de la conformité : nos missions s’articulent entre la protection de la vie privée et la circulation des données. Nous intervenons tant à l’échelle d’un projet qu’à l’échelle d’une organisation et proposons pour cela une conception agile de la conformité. Pour cela, nous travaillons au plus près des équipes, en leur proposant de nombreux formats adaptés à leurs besoins, que ce soit des cliniques, des formations, des stands ou du question/réponse via messagerie instantanée.

Nous avons accompagné la conformité d’acteurs de toutes tailles, publics comme privés, dont plus d’une centaine de Startups d’État.

Nous avons pu également administrer un premier audit “blanc” à l’Unédic, inspiré des audits de certification appliqués par la CNIL, afin de formuler des recommandations et des corrections.

Chez Numéricité, nous avons l’open source chevillé au corps (et au cœur). Dans l’ensemble de nos projets, nous nous efforçons de mettre en place ou orienter nos clients vers des solutions open source.

Par exemple, nous avons déployé Onyxia afin de permettre aux agents de quatre pays d’Afrique de l’Ouest partenaires du projet DATAFID de se former et s’entraîner à la datascience avec pour objectif d’améliorer les recettes fiscales et douanières. Pour en savoir plus sur Onyxia, et plus largement sur le projet DATAFID. 

Nos convictions dans les communs se sont aussi traduites par notre participation à la sixième édition de Numérique en Commun[s]. À cette occasion, nous avons pu proposer deux ateliers sur la conception de produits data avec et pour des utilisateurs non spécialistes de la donnée, et sur le RGPD comme accélérateur des projets. Nous avons également accompagné l’Institut national de l’information géographique et forestière (IGN), partenaire de l’évènement, dans la conception et l’éditorialisation de ses formats.

Vivez notre aventure à Numérique en Commun[s] et découvrez les cinq principes d’action pour développer des produits data avec et pour des utilisateurs non spécialistes de la donnée issus de l’atelier :

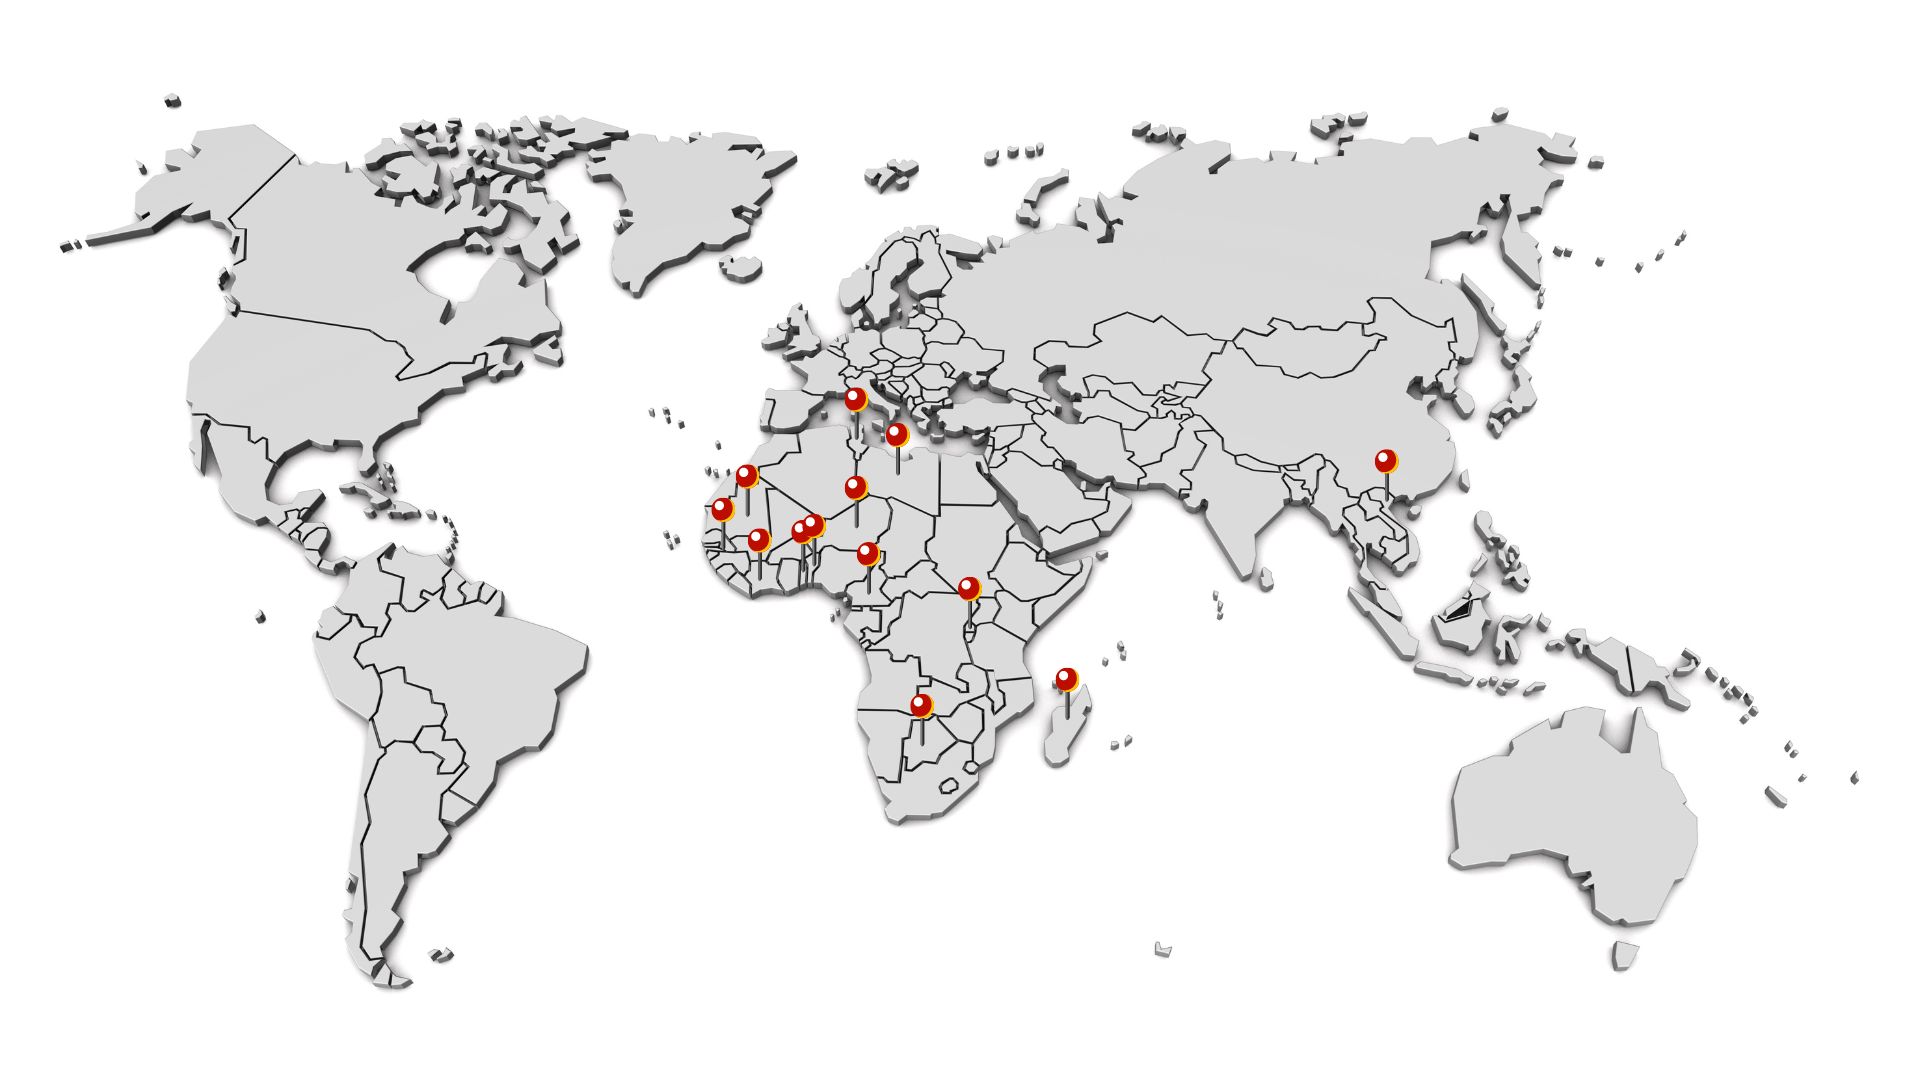
Cette rétrospective de nos activités en 2023 serait incomplète sans parler nos interventions à l’international et notre expertise e-gov. Nous intervenons actuellement dans 15 pays.

Carte des pays d'intervention de Numéricité en 2023

Nos interventions e-gov sont au croisement de l’ensemble de nos expertises.

  • Accompagnement dans l’élaboration de stratégies data
    • Au Rwanda, nous avons poursuivi notre mission afin d’évaluer la maturité numérique des administrations, mettre en place et animer la gouvernance du réseau interministériel des “chiefs digital officers”.
    • À Madagascar, nous sommes intervenus sur les enjeux du partage des données entre administration et la nécessaire rationalisation des architectures du SI en vue de la numérisation de l’État-civil, afin d’Insuffler la dynamique et la culture de l’interopérabilité au sein d’administrations fonctionnant en silo.
    • Au Botswana, nous avons formulé un cadrage stratégique des activités de l’opérationnalisation de la stratégie SmartBots, visant à stimuler la transformation numérique dans l’économie, le gouvernement et la société.

Nos experts référencés par le Fonds Monétaire International (FMI) ont par ailleurs appuyé la réalisation d’études préparatoires au Cameroun et en Tunisie.

    • En juillet 2023, nous avons été sollicités afin de construire et faciliter un séminaire de partage d’expérience organisé par le FMI pour 8 administrations fiscales d’Afrique centrale à Yaoundé : Burundi, Cameroun, Guinée équatoriale, République centrafricaine, République du Congo, République Démocratique du Congo, Sao Tomé-et-Principe, et Tchad.
    • En octobre 2023, nous avons évaluer la gestion de la conformité et l’analyse des données de la DGI tunisienne afin de formuler des recommandations techniques, et sensibiliser les agents et les cadres au lien avec le Compliance Risk Management.

  • Ingénierie juridique et conformité :
    • En Libye, au Bénin, en Mauritanie, au Cameroun et au Vietnam, nous avons réalisé une cartographie du droit applicable, et formulé des guides des bonnes pratiques afin d’orienter les édifices juridiques de ces pays.
    • Pour Ho Chi Minh Ville, nous avons analysé les textes prévus dans le cadre du déploiement d’une plateforme de services publics en lignes afin d’identifier les manques pour la mise en application opérationnelle (gouvernance des données, régulation, responsabilité, interopérabilité, etc.). Nous avons également formulé une série de recommandations en nous appuyant sur les meilleurs pratiques issues des standards internationaux en la matière.

Pour en savoir plus sur notre accompagnement de la Libye dans l’appréhension des enjeux de la transformation numérique

  • Ruptures et expérimentations technologiques :
    • Mobiliser des modèles d’intelligence artificielle pour améliorer l’efficacité du contrôle douanier ? Nous l’avons rendu possible en expérimentant RandomForestClassifier, un algorithme d’apprentissage supervisé, avec les douanes nigériennes.
    • Automatiser la génération de rapports de données grâce à l’intelligence artificielle ? Nous avons prototypé deux bots pour la Direction Générale des Impôts mauritanienne. Le bot “Reporter” et le “FileBot” sont des Proof of concept servant de base à une étude préalable avant de développer un modèle d’intelligence artificielle générative.

  • Formations et transmission d’expertise :
    • Nous avons rédigé un guide à destination des cadres de l’administration vietnamienne, sur les bonnes pratiques françaises en matière de dématérialisation de l’administration.
    • En Côte-d’Ivoire, au Togo et en Mauritanie, 180 agents des administrations fiscales et douanières ont été formés aux techniques de datascience, à travers plus de 80 sessions de formations, donnant lieu à la création d’une quarantaine de tableaux de bord.
    • Les agents des impôts du Sénégal ont suivi nos formations aux techniques de webscraping et datamining.

2023 a été une année de succès, d’innovation et d’impact pour Numéricité. Nous nous imposons comme un acteur de l’écosystème de la transformation numérique, tout en y apportant notre touche d’originalité.

Nous continuons de transformer la transformation numérique avec une équipe talentueuse d’experts et des projets ambitieux, en portant une attention particulière à l’impact et à l’éthique. 

Pour en découvrir davantage sur notre méthode et envisager de nouveaux projets ensemble, contactez-nous : contact@numericite.eu

🔲 ☆

Rétrospective : les bonnes pratiques d’un produit data partagées auprès de la communauté de Numérique en Commun(s)

Rétrospective de Mathilde Bras, avec les contributions de Cécile Le Guen, Augustin Courtier et Quentin Leroy

Les 19 et 20 octobre 2023, la communauté du numérique d’intérêt général s’est retrouvée à Bordeaux pour sa – désormais traditionnelle – grande réunion : Numérique en Commun(s). Cette année, 5 axes thématiques ont ponctué la programmation : données & territoires, écologie & soutenabilité, éthique & émancipation, communs & souveraineté, médiation & compétences numériques.

L’occasion pour Numéricité, partenaire de l’événement, de proposer plusieurs formats de partage d’expérience et de bonnes pratiques autour de défis qui nous tiennent à coeur : l’acculturation par le produit d’équipes ou d’organisations qui souhaitent se transformer, et la mobilisation du droit, en particulier du RGPD, comme un levier d’accélération des services publics numériques.

Dans cet article rétrospective, Mathilde Bras, Strategy & Innovation Manager chez Numéricité, revient sur les principaux enseignements partagés lors de l’atelier “Meilleures pratiques pour un projet data avec et pour des utilisateurs non tech”, et consolide 5 principes d’action pour des projets et produits data.


Entreprendre un projet data, un défi pour des profils techniques et non techniques

J’accompagne et entreprends de multiples projets autour de la donnée, depuis la conception de feuilles de route data jusqu’au développement de services d’exploitation de données métiers. Très souvent, je me retrouve dans une situation où les acteurs du projet ont besoin de parler le même langage, tout en mobilisant leurs propres expertises.

Mon rôle de coach est justement de traduire “le langage” des décideurs, faire remonter les besoins des utilisateurs auprès des équipes produit, être médiatrice des besoins opérationnels, et aussi de faciliter l’identification collective de points de passage. Cela se traduit concrètement par la définition des premières orientations du produit, l’identification des parties prenantes à associer, mais aussi la manière de mobiliser les utilisateurs, le mode de communication sur le produit, les risques potentiels, les compétences à mobiliser, etc.

Pour Numérique en Communs, j’ai donc proposé un exercice ouvert d’introspection à plusieurs porteurs d’initiatives liées à la valorisation des données publiques, qu’elles soient partagées en open data ou entre administrations :

En racontant nos expériences aux participants de l’atelier, nous avons pu partager des défis communs lorsqu’il s’agit de construire des produits qui se fondent sur l’exploitation de données. Leur similitude : à chaque étape, il est important de transformer des idées reçues en opportunités pour faire avancer son projet. Quelques exemples partagés pendant l’échange (nous avons partagé des exemples fictifs, mais inspirés de la réalité) :

  • J’ai besoin de 5 data-scientists pour réaliser le projet, rien d’autre” : en réalité, un projet data nécessite de s’intéresser à une pluralité de profils, tech et non tech. Une personne spécialisée en droit du numérique peut vous être utile, tout comme des compétences capables de traduire le besoin du métier en parcours (les UX designers)
  • Je sais déjà ce que je souhaite développer, pas besoin de s’adresser aux futurs utilisateurs” : en réalité, en vous adressant aux utilisateurs, vous allez pouvoir considérer l’usage des données comme un intrant pour sa structuration et sa mise en qualité. Dans le cas d’un produit data, il peut s’agir des producteurs de données, des réutilisateurs (techniques et métiers), et de décideurs (dans le cas d’un tableau de bord par exemple)
  • Le droit ne nous permet pas d’exploiter ces données, on ne peut les intégrer au prototype, il faut attendre la mise en production et l’homologation” : le fait de se poser des questions juridiques dès le démarrage du projet peut aussi être un levier pour transformer la gouvernance d’un projet, d’une politique publique ou d’une base de données
  • Commandons un logiciel sur étagère, ce sera plus simple dans la durée” : considérer la force de l’open-source est la clef. Il existe aujourd’hui des librairies très riches en matière d’exploitation et de transformation de données, tout comme d’applications de cartographie ou visualisation
  • Apprendre à des personnes non spécialisées en données à les réutiliser ne sert à rien” : bien au contraire, cela peut constituer un réel outil d’acculturation sur la manière dont les données sont produites, leur utilité pour prendre des décisions et se représenter le réel, et ainsi créer de l’engagement autour des politiques publiques qu’elles suivent

Photo de l'atelier organisé dans le cadre de NEC2023, à Bordeaux le 19 octobre 2023

Quelques principes d’action pour développer des produits data avec et pour des utilisateurs non spécialistes de la donnée

Forts de ces témoignages et des questions posées par les participations de l’atelier NEC, nous avons consolidé quelques principes d’action pour guider des personnes travaillant actuellement ou prochainement sur des projets ou produits data, qu’elles aient des compétences “techniques” en données ou non.

Notre livrable pour la communauté Numérique en Communs – 5 principes d’action de projet data en commun(s) :

  • Opérer une médiation constante entre les utilisateurs et les données (et le produit) : avoir accès à une base de données n’est pas l’objectif, c’est seulement un éventuel moyen pour répondre à des besoins “métiers” ou “usagers”. Une ou un responsable de produit data a la mission de garder en tête cette perspective, pour éviter par exemple que le service développé soit uniquement compréhensible – et donc utilisable – par les personnes qui connaissent la donnée par coeur. Concrètement, cela implique de s’intéresser autant à l’utilisation – donc la valeur de la donnée – qu’à sa qualité ;
  • Travailler la gouvernance – technique et organisationnelle – tout au long du projet/produit : lors de la conception, échanger avec les personnes qui produisent, reçoivent, transmettent ou transforment la donnée, non seulement pour les inclure – et mobiliser leur expertise ! – dans les différents temps forts du projet, mais aussi pour identifier les enjeux liés à la qualité de la donnée, qui est la clef de tout projet data. Concrètement, pour le projet PILOTE, cela impliquait de se poser la question du cycle de vie des données : est-ce que je dispose de données ou le projet consiste à aller en chercher ? qui les produit ? qui est responsable des mises à jour, du stockage ? ces données doivent-elles respecter des standards de qualité ? sont-elles sensibles au sens du RGPD ?
  • S’appuyer sur les forces de l’open source – et des communs – pour construire des projets data : les standards publics sont pour cela très inspirants. Tout service public numérique doit rendre son code ouvert (”public money, public code”, vivent les communs !). Au-delà du code produit, aller chercher des briques techniques dans l’état de l’art pour développer de services est souvent gage de qualité. Celles en vogue en ce moment sur les données : VueJS (développement d’applications), Apache Superset (datavisualisation), la suite ELK (import de données, requête, analyse et visualisation), Kubernetess (infrastructure de conteneurisation), Keycloack (identité et gestion des accès). Cela implique bien sûr de réaliser de la veille régulière sur ces briques, leurs mises à jour, et de s’appuyer sur la communauté de contributeurs ! Et on ne peut s’empêcher de citer Onyxia, un environnement de travail à l’état de l’art pour la data, open source et propulsé par les équipes de l’Insee, dont les cas d’usage ne font que se multiplier (voir nos travaux sur le projet DATAFID)
  • Considérer le droit comme une opportunité d’innovation et d’accélération : aujourd’hui de nombreux standards doivent s’appliquer aux services numériques développés par des acteurs publics et des questions de droit (qui vont au-delà des sujets techniques) peuvent se poser tout au long du projet, et même si cela demande du travail, c’est une opportunité ! Lors d’un projet data, on peut se rendre compte que certains textes doivent être harmonisés, ou proposer une nouvelle mouture d’une disposition juridique. Et surtout, on peut aussi imaginer des facilités de prototypage même si notre produit n’a pas été homologué : un exemple concret tout récent, la génération de données “fictives”, qui respecte le schéma des données “réelles”, afin de tester une première version d’application, avant la mise en production (en savoir plus avec le projet CM2D ici)
  • Dépasser les frontières de la documentation (technique) pour en faire une plateforme pour la communauté : si vous avez déjà travaillé dans des équipes produits, vous avez déjà dû entendre râler autour de vous lorsqu’il s’est agi de documenter une application ou un service. En réalité, documenter un produit peut en faciliter son adoption, inspirer des utilisateurs sur des usages possibles et permettre le déploiement à grande échelle. Concrètement, comme nous l’a raconté Quentin pour ChartsGouv, cela implique – bien sûr – de publier le code, les informations d’installation (comme un mode d’emploi) et d’aller plus loin en répertoriant des cas d’usages et en réunissant régulièrement la communauté. Dans le cas de l’Open Data University, c’est plus que de la documentation, c’est un plaidoyer sur la vertu pédagogique de l’open data enseigné au sein de multiples formations : qui engagent les étudiantes et étudiants à s’intéresser non seulement aux données publiques, mais aussi au secteur public en général !

Ces principes ne sont pas exhaustifs, nous espérons qu’ils pourront guider le plus grand nombre ! N’hésitez pas à nous faire part de vos retours d’expérience par mail : communication@numericite.eu !

🔲 ☆

[NuméricitéFM S03E04] – Réguler et encadrer le numérique, avec Monsieur le député Éric Bothorel

Data Act, Data Governance Act, Digital Services Act, Digital Markets Act, Artificial Intelligence Act, autant de textes dont vous avez peut-être déjà entendu parler et qui constituent un paquet législatif européen dense. Force est de rappeler qu’en matière de législation du numérique, la France a été particulièrement précurseur du fait de sa culture historique de la donnée. Elle en fut particulièrement actrice au cours de sa présidence de l’Union européenne au premier semestre 2022.

Comment le législateur se mobilise-t-il afin de mieux réguler et encadrer le numérique sans freiner l’innovation ? En quoi le numérique, notamment au travers de l’opendata, est un objet de politique publique ? Ces questions, cruciales dans un monde dominé par les innovations numériques et les modèles américain et chinois, seront le coeur de nos échanges.

Pour y répondre, nous avons eu l’honneur d’être reçus à l’Assemblée Nationale par Monsieur Eric Bothorel, député de la 5ème circonscription des Côtes d’Armor. Découvrez les réponses de cet ancien professionnel de l’informatique, membre de la Commission des affaires économiques de l’Assemblée, président du groupe d’études France-Taïwan et auteur du rapport pour une politique publique de la donnée, des algorithmes et des codes sources.

Framework réglementaire et législatif européen, transposition et adaptation du droit français, régulation de l’intelligence artificielle, circulation des données, numérisation des démarches : autant de sujets que nous avons pu aborder dans cet échange passionnant que nous vous invitons à écouter.

Présenté par Maxime Lubrano et co-produit avec Mehdi Rafenne.

Ecouter sur Spotify

Article / L’IA et l’Europe : comment créer un cadre pour l’innovation responsable ?

Article / Le Data Act : comment libérer les données ?

Retrouvez l’actualité d’Éric Bothorel

🔲 ☆

L’IA générative vient doper la banque conversationnelle chez Crédit Mutuel Arkéa

Créé en 2022, le Data Office du Crédit Mutuel Arkéa est dédié à l’innovation et à l’identification et au déploiement de cas d’usage de valorisation de la donnée, l’IA représentant une grande majorité des sujets. Modèles, données et démarche responsable : explications (suite…)

Cet article L’IA générative vient doper la banque conversationnelle chez Crédit Mutuel Arkéa est apparu en premier sur La Revue du Digital.

🔲 ☆

Why selling personal data is a bad idea

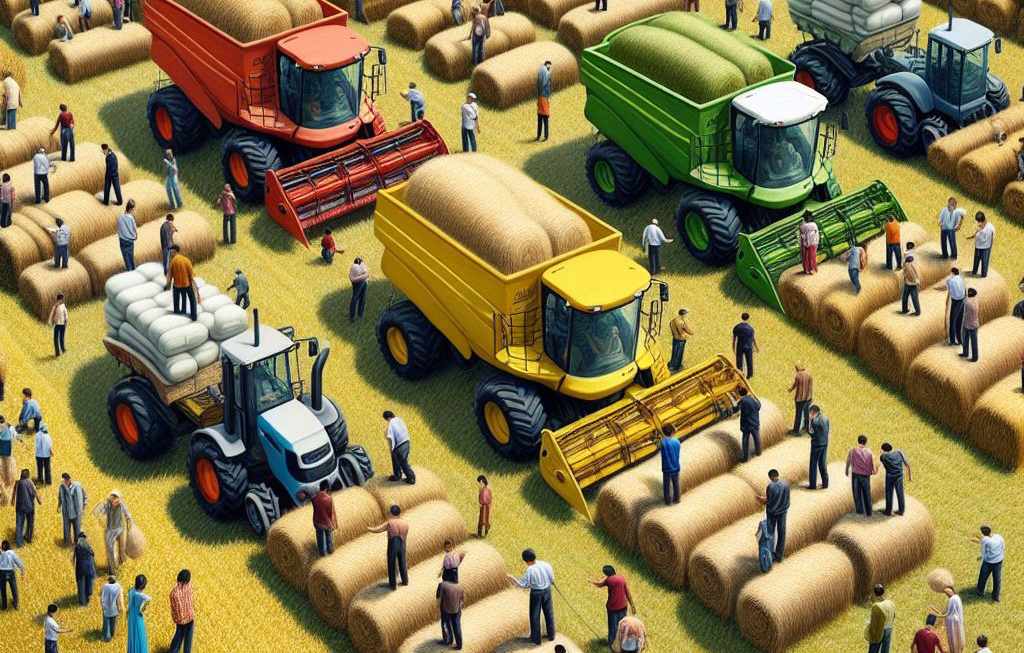
Prompt: “a field of many different kinds of people being harvested by machines and turned into bales of fertilizer.” Via Microsoft CoPilot | Designer.

This post is for the benefit of anyone wondering about, researching, or going into business on the proposition that selling one’s own personal data is a good idea. Here are some of my learnings from having studied this proposition myself for the last twenty years or more.

  1. The business does exist. See eleven companies in Markets for personal data listed among many other VRM-ish businesses on the ProjectVRM wiki.
  2. The business category harvesting the most personal data is adtech (aka ad tech and “programmatic”) advertising, which is the surveillance-based side of the advertising business. It is at the heart of what Shoshana Zuboff calls surveillance capitalism, and is now most of what advertising has become online. It’s roughly a trillion-dollar business. It is also nothing like advertising of the Mad Men kind. (Credit where due: old-fashioned advertising, aimed at whole populations, gave us nearly all the brand names known to the world). As I put it in Separating Advertising’s Wheat and Chaff, Madison Avenue fell asleep, direct response marketing ate its brain, and it woke up as an alien replica of itself.
  3. Adtech pays nothing to people for their data or data about them. Not personally. Google may pay carriers for traffic data harvested from phones, and corporate customers of auctioned personal data may pay publishers for moments in which ads can be placed in front of tracked individuals’ ears or eyeballs. Still, none of that money has ever gone to individuals for any reason, including compensation for the insults and inconveniences the system requires. So there is little if any existing infrastructure on which paying people for personal data can be scaffolded up. Nor are there any policy motivations. In fact,
  4. Regulations have done nothing to slow down the juggernaut of growth in the adtech industry. For Google, Facebook, and other adtech giants, paying huge fines for violations (of the GDPR, the CCPA, the DMA, or whatever) is just the cost of doing business. The GDPR compliance services business is also in the multi-$billion range, and growing fast. In fact,
  5. Regulations have made the experience of using the Web worse for everyone. Thank the GDPR for all the consent notices subtracting value from every website you visit while adding cognitive overhead and other costs to site visitors and operators. In nearly every case, these notices are ways for site operators to obey the letter of the GDPR while violating its spirit. And, although all these agreements are contracts, you have no record of what you’ve agreed to. So they are worse than worthless.
  6. Tracking people without their clear and conscious invitation or a court order is wrong on its face. Period. Full stop. That tracking is The Way Things Are Done online does not make it right, any more than driving drunk or smoking in crowded elevators was just fine in the 1950s. When the Digital Age matures, decades from now, we will look back on our current time as one thick with extreme moral compromises that were finally corrected after the downsides became clear and more ethically sound technologies and economies came along. One of those corrections will be increasing personal agency rather than just corporate capacities. In fact,
  7. Increasing personal independence and agency will be good for markets, because free customers are more valuable than captive ones. Having ways to gather, keep, and make use of personal data is an essential first step toward that goal. We have made very little progress in that direction so far. (Yes, there are lots of good projects listed here, but there we still a long way to go.)
  8. Businesses being “user-centric” will do nothing to increase customers’ value to themselves and the marketplace. First, as long as we remain mere “users” of others’ systems, we will be in a subordinate and dependent role. While there are lots of things we can do in that role, we will be able to do far more if we are free and independent agents. Because of that,
  9. We need technologies that create and increase personal independence and agency. Personal data stores (aka warehouses, vaults, clouds, life management platforms, lockers, and pods) are one step toward doing that. Many have been around for a long time: ProjectVRM currently lists thirty-three under the Personal Data Stores heading. Some have been there a long time. The problem with all of them is that they are still too focused on what people do as social beings in the Web 2.0 world, rather than on what they can do for themselves, both to become more well-adjusted human beings and more valuable customers in the marketplace. For that,
  10. It will help to have independent personal AIs. These are AI systems that work for us, exclusively. None exist yet. When they do, they  will help us manage the personal data that fully matters:
    • Contacts—records and relationships
    • Calendars—where we’ve been, what we’ve done, with whom, where, and when
    • Health records and relationships with providers, going back all the way
    • Financial records and relationships, including past and present obligations
    • Property we have and where it is, including all the small stuff
    • Shopping—what we’ve bought, plan to buy, or might be thinking about,
    • Subscriptions—what we’re paying for, when they end or renew, what kind of deal we’re locked into, and what better ones might be out there.
    • Travel—Where we’ve been, what we’ve done, with whom, and when

Personal AIs are today where personal computers were fifty years ago. Nearly all the AI news today is about modern mainframe businesses: giants with massive data centers churning away on ingested data of all kinds. But some of these models are open sourced and can be made available to any of us for our own purposes, such as dealing with the abundance of data in our own lives that is mostly out of control. Some of it has never been digitized. With AI help it could be.

I’m in a time crunch right now. So, if you’re with me this far, read We can do better than selling our data, which I wrote in 2018 and remains as valid as ever. Or dig The Intention Economy: When Customers Take Charge (Harvard Business Review Press, 2012), which Tim Berners Lee says inspired Solid. I’m thinking about following it up. If you’re interested in seeing that happen, let me know.

🔲 ☆

42.parquet – La bombe Zip qui ruine le Big Data

Saviez vous que les fichiers Parquet se prenaient pour des bombes ? Alors pas des bombes latines mais plutôt des bombes zip.

Alors, pour ceux qui débarquent de la planète Mars, il faut savoir que Parquet est devenu le format de prédilection pour échanger des données tabulaires. Très utilisé dans tout ce qui est Big Data et qui met une claque à ce bon vieux CSV tout pourri, Parquet, c’est binaire, c’est colonnaire, c’est compressé, c’est top !

Mais attention, derrière cette apparente perfection se cache un danger mortel pour vos disques durs et autres SSD ! En effet, même un fichier Parquet parfaitement valide peut mettre un sacré bordel et faire planter tous vos services.

Comment ? Et bien simplement avec ce fichier de seulement 42 Ko qui contient… tenez-vous bien… plus de 4 PÉTAOCTETS de données !! Oui, on parle bien de 4 millions de gigaoctets dans un malheureux fichier de 42 Ko, fallait oser.

On appelle ça une bombe de décompression ! Alors comment ça fonctionne ?

Eh bien c’est grâce à un petit tour de passe-passe démoniaque appelé « encodage par dictionnaire« . En gros, on lui donne un dictionnaire avec une seule valeur, et ensuite on fait référence à cette valeur en boucle, environ 2 milliards de fois. Résultat, on obtient un fichier minuscule car compressable au maximum mais qui une fois dézippé représente une table monstrueusement gigantesque.

C’est subtil… mais c’est vicieux ! 😈

Imaginez un peu le carnage si vous balancez ce fichier innocent dans votre pipeline Big Data sans faire gaffe… Boom ! 💥 Plantage général, crash systémique, apocalypse nucléaire ! Vos services vont tenter de lire ce fichier en pensant que c’est un gentil petit fichier Parquet de rien du tout, et là… Surprise ! C’est le chaos total. Votre cluster va fondre comme neige au soleil en essayant d’avaler ces pétaoctets de données.

Morale de l’histoire, faites attention à tout, même à ce que vous dézippez.

Et si vous avez un peu de place sur votre disque dur, vous pouvez toujours tenter l’aventure en téléchargeant 42.zip ici. (NON, NE DEZIPPEZ PAS CE TRUC !! MAUVAISE IDEE !!) (le mot de passe du zip est : 42)

Source

🔲 ☆

LVMH renforce sa direction en IA et Data pour la beauté haut de gamme

Le groupe de luxe LVMH revendique son ambition pour sa division Parfums et Cosmétiques et la beauté haut de gamme. Il procède à un renforcement des responsabilités de Stéphanie Medioni, Présidente exécutive beauté chez LVMH dans les domaines Data et intelligence (suite…)

Cet article LVMH renforce sa direction en IA et Data pour la beauté haut de gamme est apparu en premier sur La Revue du Digital.

🔲 ☆

The end of what’s on, when, and where

But not of who, how, and why. Start by looking here:

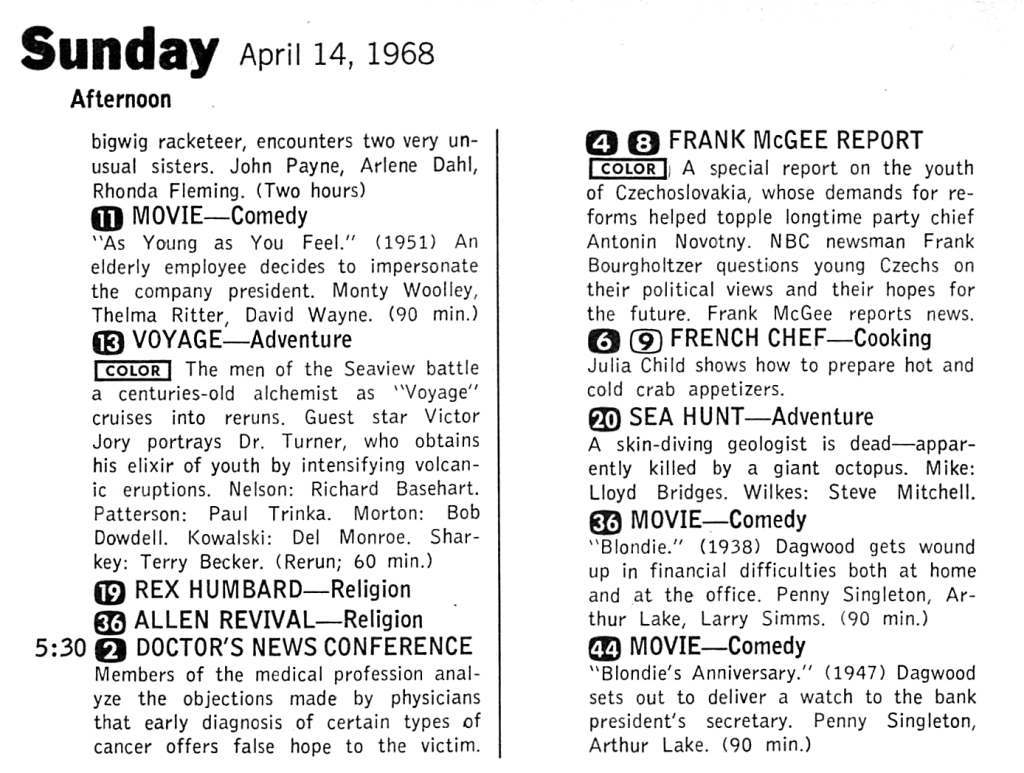
tv guide page

That’s a page of TV Guide, a required resource in every home with a TV, through most of the last half of the 20th century.

Every program was on only at its scheduled times. Sources were called stations, which broadcast over the air on channels, which one found using a dial or a display with numbers on it. Stations at their largest were regional, meaning you could only get them if you were within reach of signals on channels.

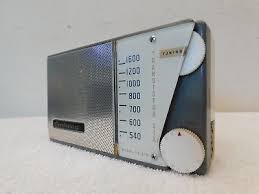
Continental transistor radioBy the time TV came along, America was already devoting its evenings to scheduled programs on AM radio, which was the only kind of radio at the time.  After TV took over, everyone sat in a room bathed in soft blue light from their TV screen. Radio was repurposed for music, especially rock & roll. My first radio was the one on the right. Being in a New York suburb, my stations were WMCA/570, WMGM/1050, WINS/1010, WABC/770, and WKBW/1520 (coming in at night from Buffalo, loud as a local). All of those stations are still on the air, but playing talk, sports and religious programs.  Many fewer people listen to AM radio, or over-the-air anything, anymore. They watch and listen to glowing rectangles that connect to the nearest router, wi-fi hot spot, or cellular data site. Antennas exist, but wavelengths are so short that the antennas fit inside the rectangles.

The question “what’s on?” is mostly gone. “Where?” is still in play, at least for TV, because nobody knows what streaming service carries what you want. All the “guides”—Apple’s, Google’s, Amazon’s, everyone’s—suck, either because they’re biased to promote their own shows or because there’s simply too much content and no system to catalog and display all of it. Search engines help, but not enough.

The age we’re closing is the one Jeff Jarvis calls The Gutenberg Parenthesis. The age we’re entering is the Age of Optionality. It began for print with blogging, for TV with VCRs and DVRs, and for radio with podcasting and streaming. John Robb calls what we have now packetized media. It is obsolescing all the media we knew, almost too well, by putting it in the hands Clay Shirky named in 2009 with Here Comes Everybody.

What we make of this new age is now up to all of us. We are who, how, and why.


🔲 ☆

If Your Privacy Is in the Hands of Others Alone, You Don’t Have Any

Prompt: “A panopticon in which thousands of companies are spying on one woman alone in the center with nothing around her.” Via Microsoft Bing Image Creator

In her latest Ars Technica story, Ashley Belanger reports that Patreon, the widely used and much-trusted monetization platform for creative folk, opposes the minimal personal privacy protections provided by a law you probably haven’t heard of until now: the Video Privacy Protection Act, or VPPA. Patreon, she writes, wants a judge to declare that law (which dates from the videotape rental age) unconstitutional because it inconveniences Patreon’s ability to share the personal data of its users with other parties.† Naturally, the EFF, the Center for Democracy & Technology, the ACLU of Northern California, and the ACLU itself all stand opposed to Patreon on this and have filed an amicus brief explaining why.

But I’m not here to talk about that. I’m here to bring up the inconvenient fact that Ars Technica is also in the surveillance business. A PageXray of Ashley’s story finds this—

  • 360 adserver requests
  • 259 tracking requests
  • 131 other requests

—which it visualizes with this:

And that’s just one small part of it.

But will Ashley, or any reporter, grab the third rail of their employer’s participation in the tracking-based advertising business? Or visit that business’s responsibility for what was already the biggest boycott in human history way back in 2015? The odds are against it. I’ve challenged many reporters to grab that third rail, just like I’m challenging Ashley here. In every case, nothing happened.

I never challenged Farhad Manjoo, but he did come through exposing The New York Times (his employer’s) own participation in the privacy-opposed tracking-based adtech business, back in 2019. Here’s a PageXray of tracking via that piece today:

Better, but not ideal.

Five years ago this month, I wrote a column about privacy in Linux Journal with the same title as this post. Here it is again, with just a few tiny edits. Amazing how little things have changed since then—and how much worse they have become. But I do see hope. Read on.


If you think regulations are going to protect your privacy, you’re wrong. In fact, they can make things worse, especially if they start with the assumption that your privacy is provided only by other parties, most of whom are incentivized to violate it.

Exhibit A for how much worse things can get is the EU’s GDPR (General Data Protection Regulation). As soon as the GDPR went into full effect in May 2018, damn near every corporate entity on the Web put up a “cookie notice” requiring acceptance of terms and privacy policies that allow them to continue violating your privacy by harvesting, sharing, auctioning off and otherwise using your data, and data about you.

For websites and services in that harvesting business (a population that rounds to the whole commercial web), these notices provide a one-click way to adhere to the letter of the GDPR while violating its spirit.

There’s also big business in the friction that it produces. To see how big, look up GDPR+compliance on Google. You’ll get 232 million results (give or take a few dozen million).

None of those results are for you, even though you are who the GDPR is supposed to protect. See, to the GDPR, you are a mere “data subject” and not an independent and fully functional participant in the technical, social, and economic ecosystem the Internet supports by design. All privacy protections around your data are the burden of other parties.

Or at least that’s the interpretation that nearly every lawmaker, regulatory bureaucrat, lawyer, and service provider goes by. (One exception is Elizabeth Renieris @hackylawyer. Her collection of postings is required reading on the GDPR and much else.) The same goes for those selling GDPR compliance services, comprising most of those 190 million GDPR+compliance search results.

The clients of those services include nearly every website and service on Earth that harvests personal data. These entities have no economic incentive to stop harvesting, sharing, and selling personal data the usual ways, beyond fear that the GDPR might actually be enforced, which so far (with few exceptions), it hasn’t been. (See Without enforcement, the GDPR is a fail.)

Worse, the tools for “managing” your exposure to data harvesters are provided entirely by the websites you visit and the services you engage. The “choices” they provide (if they provide any at all) are between 1) acquiescence to them doing what they please and 2) a maze of menus full of checkboxes and toggle switches “controlling” your exposure to unknown threats from parties you’ve never heard of, with no way to record your choices or monitor effects.

So let’s explore just one site’s presentation, and then get down to what it means and why it matters.

Our example is https://www.mirror.co.uk. If you haven’t clicked on that site already, you’ll see a cookie notice that says,

We use cookies to help our site work, to understand how it is used, and to tailor the adverts presented on our site. By clicking “Accept” below, you agree to us doing so. You can read more in our cookie notice. Or, if you do not agree, you can click Manage below to access other choices.

They don’t mention that “tailor the adverts” really means something like this:

We open your browser to infestation by tracking beacons from countless parties in the online advertising business, plus who-knows-what-else that might be working with those parties (there is no way to tell, and if there was we wouldn’t provide it), so those parties and their “partners” can use those beacons to follow you like a marked animal everywhere you go and report your activities back to a vast marketplace where personal data about you is shared, bought and sold, much of it in real time, supposedly so your eyeballs can be hit with “relevant” or “interest-based” advertising as you travel from site to site and service to service. While we are sure there are bad collateral effects (fraud and malware, for example), we don’t care about those because it’s our business to get paid just for clicks or “impressions,” whether you’re impressed or not—and the odds that you won’t be impressed average to certain.

Okay, so now click on the “Manage” button.

Up will pop a rectangle where it says “Here you can control cookies, including those for advertising, using the buttons below. Even if you turn off the advertising-related cookies, you will still see adverts on our site, because they help us to fund it. However, those adverts will simply be less relevant to you. You can learn more about cookies in our Cookie Notice on the site.”

Under that text, in the left column, are six “Purposes of data collection”, all defaulted with little check marks to ON (though only five of them show, giving the impression that there are only those five). The right column is called “Our partners”, and it shows the first five of what turn out to be 259 companies, nearly all of which are not brands known to the world or to anybody outside the business (and probably not known widely within the business as well). All are marked ON by that little check mark. Here’s that list, just through the letter A:

  • 1020, Inc. dba Placecast and Ericsson Emodo
  • 1plusX AG
  • 2KDirect, Inc. (dba iPromote)
  • 33Across
  • 7Hops.com Inc. (ZergNet)
  • A Million Ads Limited
  • A.Mob
  • Accorp Sp. z o.o.
  • Active Agent AG
  • ad6media
  • ADARA MEDIA UNLIMITED
  • AdClear GmbH
  • Adello Group AG
  • Adelphic LLC
  • Adform A/S
  • Adikteev
  • ADITION technologies AG
  • Adkernel LLC
  • Adloox SA
  • ADMAN – Phaistos Networks, S.A.
  • ADman Interactive SL
  • AdMaxim Inc.
  • Admedo Ltd
  • admetrics GmbH
  • Admotion SRL
  • Adobe Advertising Cloud
  • AdRoll Inc
  • adrule mobile GmbH
  • AdSpirit GmbH
  • adsquare GmbH
  • Adssets AB
  • AdTheorent, Inc
  • AdTiming Technology Company Limited
  • ADUX
  • advanced store GmbH
  • ADventori SAS
  • Adverline
  • ADYOULIKE SA
  • Aerserv LLC
  • affilinet
  • Amobee, Inc.
  • AntVoice
  • Apester Ltd
  • AppNexus Inc.
  • ARMIS SAS
  • Audiens S.r.l.
  • Avid Media Ltd
  • Avocet Systems Limited

If you bother to “manage” any of this, what record do you have of it—or of all the other collections of third parties who you’ve agreed to follow you around? Remember, there are a different collection of these at every website with third parties that track you, and different UIs, each provided by other third parties.

It might be easier to discover and manage parasites in your belly than cookies in your browser.

Think I exaggerate? The long list of cookies in just one of my browsers (which I had to dig deep to find) starts with this list:

After several hundred others, my cookie  list ends with:

I know what zoom.us is. The rest are a mystery to me.

To look at just that first one, 1rx.io, I have to dig way down in the basement of the preferences directory (in Chrome it’s chrome://settings/cookies/detail?site=1rx.io), where I find that its locally stored data is this:

_rxuuid

Name
_rxuuid
Content
%7B%22rx_uuid%22%3A%22RX-2b58f1b1-96a4-4e1d-9de8-3cb1ca4175b0%22%2C%22nxtrdr%22%3Afalse%7D
Domain
.1rx.io
Path
/
Send for
Any kind of connection
Accessible to script
No (HttpOnly)
Created
Wednesday, December 12, 2018 at 4:48:53 AM
Expires
Thursday, December 12, 2019 at 4:48:53 AM

I’m a somewhat technical guy, and at least half of that stuff means nothing to me.

As for “managing” those,  my only choice on that page is to “Remove All”. Does that mean Remove everything on that page alone or Remove all cookies everywhere? And how can I remember what I’ve had removed?

Obviously, there is no way for anybody to “manage” this, in any meaningful sense of the word.

We also can’t fix it on the sites and services side, no matter how much those sites and services care (which most don’t) about the “customer journey”, the “customer experience” or any of the other bullshit they’re buying from marketers this week.

Even within the CRM (customer relationship management) world, the B2B customers of CRM companies use one cloud and one set of tools to create as many different “experiences” for users and customers as there are companies deploying those tools to manage customer relationships from their side.  There are no corresponding tools on our side. (Though there is work going on. See here.)

So the digital world remains one where we have no common or standard way to scale our privacy and data usage tools, choices, or experiences across all sites and services. And that’s what we’ll need if we want real privacy online.

The simple place where we need to start is this: privacy is personal, meaning something we create for ourselves (which in the natural world we do with clothing and shelter, both of which lack equivalents in the digital world).

And we need to be clear that privacy is not a grace of privacy policies and terms of service that differ with every company and over which none of us have true control—especially when there is an entire industry devoted to making those companies untrustworthy, even if they are in full compliance with privacy laws.

Devon Loffreto (who coined the term self-sovereign identity and whose good work we’ll be visiting in an upcoming issue of Linux Journal) puts the issue in simple geek terms: we need root authority over our lives. Hashtag: #OwnRoot.

It is only by owning root that we can crank up agency on the individual’s side. We have a perfect base for that in the standards and protocols that gave us the Internet, the Web, email, and too little else. And we need it here too. Soon.

We (a few colleagues and I) created Customer Commons as a place for terms that individuals can proffer as first parties, just by pointing at them, much as licenses at Creative Commons can be pointed at. Sites and services can agree to those terms, and both can keep records and follow audit trails.

And there are some good signs that this will happen. For example, the IEEE approached Customer Commons last year with the suggestion that we stand up a working group for machine-readable personal privacy terms. It’s called P7012. If you’d like to join, please do.

Unless we #OwnRoot for our own lives online, privacy will remain an empty promise by a legion of violators.

One more thing. We can put the GDPR to our use if we like. That’s because Article 4 of the GDPR defines a data controller as “the natural or legal person, public authority, agency or other body which, alone or jointly with others, determines the purposes and means of the processing of personal data…” This means each of us can be our own data controller. Most lawyers dealing with the GDPR don’t agree with that. They think the individual data subject will always need a fiduciary or an intermediary of some kind: an agent of the individual, but not an individual with agency. Yet the simple fact is that we should have root authority over our lives online, and that means we should have some degree of control over our data exposures, and how our data, and data about us, is used—much as we do over how we control or moderate our privacy in the physical world. More about all that in upcoming posts.

The original version of this post was published on the Private Internet Access blogPrivate Internet Access and Linux Journal at the time were both holdings of London Trust Media.

Also, check out the Privacy Manifesto at the ProjectVRM wiki. I maintain it and welcome bug fixes.

† This is an example of what Cory Doctorow calls “enshittification” and Wikipedia (at that link) more politely calls “platform decay.” It’s a big trade-away of goodwill by Patreon. Says to me they must be making an enshitload of money in the adtech fecosystem.

🔲 ☆

Privatisation de la santé et colonisation des données

Les géants de la tech se lancent dans une course aux applications et services qui proposent des soins médico-psychologiques. Si l’utilité de tels produits est loin d’être avérée, ils promettent néanmoins à ces entreprises de nouvelles sources lucratives de données hautement personnelles… Un « colonialisme des données » qui ouvre la voie à une gestion individuelle des problèmes de santé et masque la privatisation rampante de ce domaine. Par Anna-Verena Nosthoff, Nick Couldry et Felix Maschewski, traduit par Jean-Yves Cotté [1].

Se piquant de philosophie lors d’une interview en 2019, Tim Cook, PDG d’Apple, avait abordé la question de « la plus grande contribution d’Apple à l’humanité ». Sa réponse était sans équivoque : elle concernerait « le domaine de la santé ».

Depuis, la promesse de Cook s’est concrétisée sous la forme de plusieurs produits « innovants », censés « démocratiser » les soins médicaux et donner à chacun les moyens de « gérer sa santé ». Ces dernières années, Amazon, Méta et Alphabet ont également tenté de chambouler le marché de la santé. Dernièrement, on a même appris que la société de surveillance Palantir avait remporté un contrat de 330 millions de livres pour créer une nouvelle plateforme de données destinée au British National Health Service (NHS)…

La pandémie de COVID-19 a accéléré cette tendance, laissant dans son sillage divers réseaux de recherches, services de santé en ligne, cliniques et autres entreprises qui ont pour objectif affiché de « repenser l’avenir de la santé » (pour reprendre l’expression de Verily, filiale d’Alphabet) à l’aide de « montres connectées » et autres outils numériques. Si cette ambition n’est pas neuve, ses modalités varient : les incursions des plus grandes entreprises dans le domaine de la santé ne sont plus uniquement axées sur le corps. Non contentes de cartographier membres et poumons, elles ciblent à présent l’esprit.

Ce nouvel intérêt des GAFAM pour le bien-être psychologique, dans le cadre de leur projet de « cartographier la santé humaine », est loin d’être une coïncidence. Les gros titres relatifs à une « crise de la santé mentale » ont récemment envahi la presse américaine : le taux de suicide a atteint un niveau record aux États-Unis et, comme l’a souligné Bernie Sanders, selon un récent sondage du Center for Disease Control and Prevention (CDC), près d’un adolescent américain sur trois a déclaré que son état de santé mentale laissait à désirer…

Les conglomérats technologiques ne sont que trop heureux de lancer des campagnes autour de ces faits alarmants, mettant l’accent sur les efforts qu’ils déploient pour lutter contre ces tendances délétères. Selon les propres mots, ils souhaitent « résoudre la crise de la santé mentale ». Les GAFAM se fient à une maxime longuement éprouvée : en eaux troubles, bonne pêche.

Quand Apple s’enrichit sur les maladies mentales

Les premières initiatives d’Apple visant à pénétrer le marché de la santé ont connu une accélération marquée. Après avoir affiné son outil de signature concocté en 2019, l’entreprise a depuis collaboré activement avec plusieurs instituts de recherche. Son but : prouver que sa « montre connectée », bien plus qu’un coach sportif, peut être un « sauveur de vie » capable de détecter une fibrillation auriculaire, voire une infection de COVID-191 .

Dans le cadre de sa mission consistant à offrir à ses utilisateurs un « tableau complet » de leur état de santé, il est logique qu’Apple ait annoncé récemment son intention d’ajouter une évaluation médico-psychologique à son Apple Watch… La nouvelle fonction « état d’esprit » (state of mind) de l’application « pleine conscience » d’Apple demande à l’utilisateur d’évaluer ce qu’il ressent sur une échelle de « très agréable » à « très désagréable », d’indiquer les aspects de sa vie qui l’affectent le plus (comme la famille ou le stress au travail) et de décrire son humeur par des adjectifs comme « heureux » ou « inquiet ». La promesse, semble-t-il, est qu’une utilisation quotidienne évitera de consulter un psychologue…

Au printemps 2023, on apprenait que le National Health System britannique avait partagé sur Facebook des données intimes relatives à la santé de ses patients

L’application « pleine conscience » utilise ces données pour déterminer le niveau de risque de dépression. Hasard de calendrier : une étude récente sur la « santé mentale numérique » menée par des chercheurs de l’UCLA (et sponsorisée par Apple) a démontré que l’utilisation de cette application sur l’Apple Watch développait la « conscience émotionnelle » de 80 % des utilisateurs, tandis que 50 % d’entre eux affirmaient qu’elle avait un effet positif sur leur bien-être général – des résultats que l’entreprise ne manque pas de mettre en avant.

Au cours des prochains mois, Apple va vraisemblablement lancer d’autres logiciels liés à la santé mentale. Selon de récents rapports, l’entreprise travaille actuellement à une application censée non seulement traquer les « émotions » des utilisateurs, mais aussi leur donner des conseils médicaux : il s’agit de Quartz, un coach sportif alimenté par une intelligence artificielle.

Qu’il y ait bel et bien une crise de la santé mentale aux États-Unis est indéniable. Entre 2007 et 2020, le nombre de passages aux urgences pour des troubles d’ordre médicopsychologique a presque doublé, les jeunes étant les plus affectés…

Cependant, même si l’on admet que les outils « intelligents » puissent modestement bénéficier à certains patients, l’utilisation de wearables peut aussi générer stress et anxiété, comme d’autres études récentes l’ont démontré. [NDLR : Les wearables constituent une catégorie d’objets informatiques et électronique, destinés à être portés sur soi. Vêtements ou accessoires, ils ont la particularité d’être connectés à un appareil, comme un téléphone, pour recueillir des données relatives à la personne qui les porte et à son environnement]. De plus, l’accent mis sur des solutions technologiques de court terme fait courir le risque de détourner certaines maladies psychologiques des causes sociales et politiques qui les sous-tendent : exploitation au travail, instabilité financière, atomisation croissante, accès limité aux soins, alimentation et logement de mauvaise qualité…

Les applications de santé transfèrent également la responsabilité principale de la gestion des troubles médico-psychologiques aux individus eux-mêmes. Sumbul Desai, vice-présidente en charge de la santé chez Apple, a récemment affirmé que l’objectif de son entreprise « est de donner aux gens les moyens de prendre en charge leur propre parcours de santé ». Un mantra néolibéral ancien.

Quand Méta le gouvernement britannique livre ses données de santé à Méta

Apple n’est pas le seul géant de la tech à s’être penché sur la santé mentale de ses clients. Si le géant de Cupertino ne manifeste guère davantage qu’un intérêt purement formel à la question de la confidentialité des données, bien d’autres ne prennent même pas cette peine.

Au printemps 2023, on apprenait que le NHS avait partagé sur Facebook des données intimes relatives à la santé de ses patients. Pendant des années, le NHS avait fourni au réseau social et à sa maison-mère Méta, par l’intermédiaire de l’outil de collecte de données Meta Pixel, des renseignements comprenant des recherches sur l’automutilation et des rendez-vous de consultation pris par les utilisateurs de son site internet…

Outre les données des utilisateurs qui avaient visité les pages de son site internet relatives aux variations du développement sexuel, aux troubles alimentaires et aux services médicopsychologiques en cas de crise, l’Alder Hay Children’s Hospital de Liverpool a également transmis à Facebook et Méta des renseignements sur les prescriptions de médicaments. La clinique londonienne de santé mentale Tavistock and Portman a aussi fourni aux GAFAM les données d’utilisateurs ayant consulté sa rubrique sur le développement de l’identité de genre, spécialement conçue comme support éducatif pour les enfants et les adolescents…

Tandis que des experts en confidentialité comme Carissa Véliz conseillent aux institutions et professionnels de la santé de « recueillir le strict minimum de renseignements nécessaires pour soigner les patients, rien de plus », cette violation des données du NHS par Facebook illustre la tendance inverse. Dans ce cas précis, les données personnelles ont été obtenues sans que les patients y consentent ou en soient informés, afin de leur adresser des publicités ciblées – le cœur du modèle économique de Méta.

Ce scandale est simplement le dernier d’une longue liste de catastrophes récentes en matière de relations publiques pour l’entreprise, juste après le fiasco du lancement de son métavers (ce n’est pas une coïncidence si l’avenir immersif d’internet proposé par Zuckerberg a lui-même été salué comme une « solution prometteuse pour la santé mentale »…). Il ne s’agit pas là d’un incident isolé : en mars 2023, on apprenait que la start-up de télé-santé Cerebral avait partagé avec Méta et Google, entre autres, des données médicales privées comprenant des renseignements relatifs à la santé mentale…

Quand Alphabet se rêve en coach de vie

La maison-mère de Google, Alphabet, est un autre explorateur des données de santé qui a pénétré le marché des wearables. Depuis la finalisation de son achat du fabricant de « montres connectées » Fitbit en 2021, la société s’est jointe à Apple pour vanter leurs mérites.

Si Jeff Bezos semble accaparé par ses rêves d’entrepreneuriat spatial et d’industrie lunaire, il n’en garde pas moins les pieds sur terre lorsqu’on en vient à ce domaine.

Dans la foulée d’une étude menée par Verily (filiale d’Alphabet spécialisée dans la recherche sur les sciences de la vie) pour savoir s’il était possible de détecter les symptômes de dépression avec un smartphone, Fitbit a récemment lancé une application « conçue pour vous donner une vision globale de votre santé et de votre bien-être en mettant l’accent sur les indicateurs qui vous tiennent à cœur ». Semblable à l’application « pleine conscience » d’Apple, elle comporte une fonctionnalité « humeur » qui permet à l’utilisateur de décrire et d’enregistrer ce qu’il ressent.

Une équipe de la Washington University à St Louis a utilisé les données Fitbit et un modèle d’intelligence artificielle pour concrétiser « la promesse d’utiliser des wearables pour détecter des troubles mentaux au sein d’une communauté large et diverse. » Selon Chenyang Lu, professeur à la McKelvey School of Engineering et l’un des concepteurs de cette étude, cette recherche est pertinente dans le monde réel puisque « aller chez un psychiatre et remplir des questionnaires chronophages explique que certains puissent avoir des réticences à consulter un psychiatre ». En d’autres termes, l’intelligence artificielle peut offrir un outil peu onéreux et peu contraignant pour gérer sa propre santé mentale.

Loin de prouver que les wearables peuvent diagnostiquer la dépression, l’étude a simplement relevé plusieurs corrélations potentielles entre une tendance à la dépression et les biomarqueurs connectés. Cela n’a pas empêché Lu de s’enthousiasmer : « Ce modèle d’IA est capable de vous dire que vous souffrez de dépression ou de troubles de l’anxiété. Voyez ce modèle d’IA comme un outil de dépistage automatisé. »

Cette exagération de la preuve empirique perpétue l’idée que la technologie est à même de résoudre les troubles médico-psychologiques – pour le moins douteuse. Une chose l’est moins : c’est extrêmement lucratif pour Alphabet.

Fitbit n’est cependant pas la seule incursion de l’entreprise dans le domaine de la santé mentale. En plus des informations sur la prévention du suicide que Google Search affiche depuis des années au-dessus des résultats des recherches liées à la santé mentale, l’entreprise a récemment annoncé que les utilisateurs qui entrent des termes en relation avec le suicide verront apparaître une invite avec des démarreurs de conversation pré-écrits qu’ils pourront envoyer par SMS à la 988 Suicide & Crisis Lifeline.

Bien qu’un tel outil puisse s’avérer très utile en cas d’urgence, l’inquiétude est réelle de voir Google instrumentaliser les données sensibles ainsi recueillies en les transmettant à des annonceurs qui les exploiteront et les monétiseront de la même façon que les autres. Il convient de mentionner que ces nouvelles mesures de prévention du suicide n’ont été dévoilées par Google que quelques semaines après le suicide de trois de ses employés, ce qui a donné lieu à des spéculations quant à la santé mentale de son propre personnel. Dans ce contexte, ces nouvelles fonctionnalités peuvent être vues comme un coup médiatique pour détourner l’attention des problèmes urgents qui se posent à l’entreprise elle-même – et le modèle qu’elle encourage.

Quand Amazon renonce ouvertement à la confidentialité

Amazon s’achète également une image de prestataire de soins médico-psychologiques. Si Jeff Bezos semble accaparé par ses rêves d’entrepreneuriat spatial et d’industrie lunaire, il n’en garde pas moins les pieds sur terre lorsqu’on en vient à ce domaine.

Il a ainsi annoncé dès 2018 son intention de résoudre la crise de la santé mentale qui touche les États-Unis en « démocratisant » l’accès aux soins médicaux. Il a donc procédé au rachat de la pharmacie en ligne PillPack, puis a développé Amazon Pharmacy.

En 2019, il a lancé Amazon Care, une plateforme en ligne qui propose un suivi médical complet aux employés d’Amazon, 24 heures sur 24 et 7 jours sur 7 par messagerie et chat vidéo. Pour cela, il a dû collaborer avec Ginger, un service internet de psychothérapie fourni par une application qui se présente comme « une solution globale à la santé mentale » avec « des soins médicopsychologiques à tout moment ».

En 2021, Amazon a fermé Amazon Care et lancé Amazon Clinic, une plateforme virtuelle de soins médicaux plus ambitieuses que la précédente – il a déjà été annoncé qu’il était prévu de la déployer sur tout le territoire américain. Contrairement à Amazon Care, Amazon Clinic est ouvert à tous. Pour l’utiliser, il convient simplement d’accepter « l’utilisation et la divulgation d’informations protégées relatives à la santé » – en d’autres termes, renoncer à son droit à la protection de la vie privée aux termes de la loi fédérale sur la portabilité et la responsabilité en matière d’assurance maladie (Health Insurance Portability and Accountability Act ou HIPAA). Une telle démarche permet à Amazon d’accéder aux données les plus intimes des utilisateurs (la légalité du procédé est en cours d’examen par la Commission fédérale du commerce (Federal Trade Commission ou FTC).

En février 2023, Amazon a enrichi son offre de soins médicaux en rachetant One Medical, une entreprise qui propose des soins de santé primaires en ligne et en personne via une application, dans plus de vingt villes et régions métropolitaines américaines. Mindset, l’une de ses gammes de services spécialisée dans la santé mentale, propose son aide virtuelle avec des séances collectives ou un coaching individuel en cas de stress, d’anxiété, de dépression, de THADA ou d’insomnie.

Outre Amazon Clinic et One Medical, Amazon a récemment élargi son offre de soins médicaux à destination de ses employés en collaborant avec Maven Clinic, la plus grande clinique virtuelle du monde pour les femmes et les familles. Ce partenariat permettra à Amazon, dont le but est de se développer dans cinquante pays en plus des États-Unis et du Canada, d’avoir un accès lucratif à certains des ensembles de données les plus privés et sensibles de Maven Clinic.

Les risques de voir de telles données tomber entre les mains d’entreprises commerciales qui, dans certains cas, les transmettront sans coup férir à des autorités locales ou nationales sont évidents : comme, par exemple, le cas de cette adolescente du Nebraska qui, après que Facebook et Google ont fourni à la police ses messages privés et ses données de navigation, a été condamnée en 2021 pour avoir violé la loi sur l’avortement de l’État…

La colonisation des données de santé mentale

La course effrénée d’Amazon, Méta, Apple et Alphabet pour s’implanter dans le domaine de la santé mentale va bien au-delà d’une simple rupture. L’ampleur de ce bouleversement doit être appréhendée dans le cadre d’une volonté d’annexer des ressources jusqu’alors inexploitées.

Sous le couvert d’entreprises visant à soulager l’instabilité mentale, une forme fondamentale d’appropriation des biens est en cours. Après tout, jusqu’à récemment, l’idée même que notre santé mentale (et l’ensemble des données qui y est associée) puisse être un actif commercial dans un bilan aurait paru étrange. Aujourd’hui, une telle réalité est presque banale. C’est un des aspects de ce que Nick Couldry et Ulises Mejias ont nommé le « colonialisme des données ».

Les quatre entreprises font partie d‘un secteur commercial plus vaste axé sur l’exploitation de nouvelles définitions de la connaissance et de la rationalité destinées à l’extraction de données. À travers l’accaparement habituel de données sensibles et de nombreux autres domaines sociaux (la santé, l’éducation, la loi, entre autres), nous nous dirigeons vers « la capitalisation sans limites de la vie », pour reprendre l’expression de Couldry et Mejias.

La normalisation des wearables comme outils destinés à l’individu, sous couvert de gérer sa santé (tant physique que mentale), fait partie du processus, en convertissant la vie quotidienne en un flux de données que l’on peut s’approprier à des fins lucratives. L’application « pleine conscience » d’Apple et « Log Mood » de Fitbit ne sont que deux exemples de la façon dont les GAFAM, après avoir colonisé le territoire du corps, jette leur dévolu sur la psyché.

À l’instar des précédentes étapes du colonialisme, la colonisation des données affecte de façon disproportionnée ceux qui sont déjà marginalisés. D’une part, les intelligences artificielles impliquées, qui reflètent les stéréotypes dominants, ont un parti-pris défavorable à l’égard des groupes marginalisés, comme l’a souligné un récent procès intenté à Apple pour « biais racistes » de l’oxymètre sanguin de son Apple Watch.

D’autre part, l’idée selon laquelle la santé mentale comme la santé physique relèvent avant tout de la responsabilité individuelle et de la gestion personnalisée assistée par la technologie ne tient aucun compte du fait que les problèmes de santé sont souvent liés à des questions systémiques – conditions de travail abusives ou malsaines, manque de temps et de ressources financières, etc. Le colonialisme des données masque ces facteurs en faveur de la course au profit, alors qu’il est plus que jamais nécessaire d’avoir un débat sur les facteurs socioéconomiques à l’origine de la crise de la santé mentale.

Alors même que ce changement structurel dans la gestion de notre corps et de notre esprit est en cours, il peut sembler paradoxal qu’une vision rigoureusement déterministe, asociale et individualisante quant à la manière dont peut être gérée la santé mentale soit mise en avant par les principaux extracteurs de données. Plus qu’un paradoxe, c’est peut-être l’alibi parfait pour détourner l’attention du pillage nos données.

Notes :

[1] Article originellement publié par notre partenaire Jacobin sous le titre « Big Tech Is Exploiting the Mental Health Crisis to Monetize Your Data ».

🔲 ☆

Nick Srniček : « On peut imaginer un agenda radical en matière de nouvelles technologies »

Peut-on imaginer un agenda radical en matière de nouvelles technologies ? C’est là la ligne de fond du travail de Nick Srniček, co-auteur en 2013 du Manifeste accélérationniste, pamphlet qui avait secoué la gauche radicale, aujourd’hui senior lecturer au King’s College London, essayiste, et l’un des plus fins connaisseurs du capitalisme numérique. Entre économie politique de l’IA, stratégie politique et fin du travail domestique, il renouvelle la critique des technologies numériques et œuvre à formuler un agenda émancipateur. Entretien par Maud Barret Bertelloni.

En 2013, deux doctorants londoniens secouaient la gauche radicale en publiant le Manifeste accélérationniste, texte dans lequel ils incitaient la gauche à sortir de l’impasse politique et écologique en se réappropriant les technologies et les formes d’organisation capitalistes à des fins d’émancipation. Accusés de techno-utopisme par leurs détracteurs, qui lisaient dans le Manifeste une invitation à accélérer le techno-capitalisme global pour en provoquer l’effondrement ; attaqués par les partisans de la décroissance qui ne voyaient dans leur proposition qu’une énième variante du productivisme, Nick Snriček et Alex Williams défendaient que c’est précisément à l’échelle du capitalisme que ce dernier peut être dépassé. Sortant de son passéisme et de son refus des techniques et des organisations, la gauche peut réorienter l’infrastructure matérielle du capitalisme, se réapproprier le progrès scientifique et technologique et doit penser la stratégie et les institutions pour ce faire.

Dix ans après le Manifeste, Nick Srniček compte parmi les plus fins économistes politiques du capitalisme numérique. Capitalisme de plateforme, publié en 2017, conceptualisait les plateformes comme les nouvelles formes d’organisation du capitalisme dont la singularité tient aux moyens sociotechniques d’intermédiation par le biais des données. Par-delà les promesses de l’économie numérique, il insérait ce modèle dans la longue histoire du capitalisme post-fordiste. Il travaille aujourd’hui sur l’économie politique de l’intelligence artificielle et, loin des discours imprégnés de craintes et de promesses, en avance une critique qui souligne l’importance du travail et des infrastructures dans la production de l’IA et en illustre les implications géopolitiques.

Son dernier ouvrage, écrit avec la théoricienne féministe Helen Hester, After Work : A History of the Home and the Fight for Free Time, porte sur les technologies domestiques et leur fausse promesse de libérer du temps de travail. Si, au fil des innovations, la charge de travail domestique n’a pas diminué, c’est qu’il faut interroger la culture domestique et parvenir à transformer l’organisation matérielle de la vie quotidienne. Des plateformes aux technologies domestiques, de l’IA à ses infrastructures, Nick Srniček renouvelle la critique des techniques et œuvre à formuler un agenda émancipateur.

Entretien originellement publié sur AOC média.

LVSL – Après le Manifeste accélérationniste et Inventing the future (Verso, 2015), deux essais politiques et programmatiques sur l’avenir de la gauche, les technologies et la fin du travail, vous avez recentré vos recherches sur l’économie politique du numérique, du capitalisme de plateforme à l’industrie de l’IA. Quel fil relie ces différents travaux ?

N. S. – L’économie politique est arrivée dans mon travail en même temps que le Manifeste. Je m’occupais auparavant de philosophie et j’aurais pu rester un deleuzien si la crise de 2008 n’était pas arrivée. Mais tous les théoriciens critiques que je lisais n’avaient rien à dire de pertinent sur la crise financière, la plus grande crise du capitalisme global depuis la Grande Dépression. C’est alors que je me suis tourné vers l’économie politique. Le Manifeste a eu la même genèse : il est né de la frustration qu’Alex Williams et moi ressentions à l’égard de la gauche de l’époque, incarnée notamment par le mouvement Occupy Wall Street, né en réponse à la crise financière.

Son horizontalisme à tout prix, sa démocratie directe à tout prix, sa peur farouche de tout leadership, tous ces éléments nous semblaient absolument contre-productifs pour la construction d’un mouvement de gauche efficace. Les arguments du Manifeste n’étaient en fait que les réponses aux questions : que devrait faire la gauche ? Quelle est l’alternative à la situation actuelle ? Devrions-nous affirmer de grandes revendications ? Y compris sur la question technologique.

Le discours qui entoure les technologies est aujourd’hui imprégné de craintes au sujet des IA génératives. Dans les années autour de 2008, les craintes se concentraient autour de l’automatisation et de la surveillance. Notre position consistait alors à dire que les technologies ne doivent pas être craintes : elles peuvent souvent être réappropriées et constituer des opportunités émancipatrices. Il en va de même aujourd’hui. La question est de savoir comment il est possible de contrôler le développement technologique et l’orienter vers des possibles libérateurs.

LVSL -L’intelligence artificielle a largement défrayé la chronique ces derniers mois. Le succès de modèles comme ChatGPT ou DALL·E, rendus accessibles au grand public, a suscité d’importantes craintes autour de l’automatisation du travail. Leurs performances impressionnantes ont relancé les débats autour de l’intelligence des machines, ses risques et son éthique. Vous étudiez depuis longtemps l’économie numérique et ses innovations : quelle est votre lecture du phénomène ?

N. S. –Par-delà l’engouement médiatique, ce que je propose est d’opérer un geste marxiste tout à fait classique : plutôt que de se concentrer sur les craintes et les conséquences de l’usage de l’intelligence artificielle, il faut s’intéresser à ses conditions de production. Lorsque l’on s’intéresse à l’IA non pas à partir de ses conséquences, mais de sa production, on s’aperçoit qu’il s’agit d’une longue chaîne de travail qui peut être décomposée en quatre étapes : (1) la collecte des données, (2) l’étiquetage de ces données et leur nettoyage, (3) la construction du modèle ; ce n’est qu’alors qu’advient (4) le déploiement de l’intelligence artificielle comme produit pour les utilisateurs. Du côté des chercheurs comme des politiciens, toute l’attention critique s’est concentrée ces derniers temps sur les deux premières étapes, notamment sur la collecte massive de données. Elle requiert beaucoup de travail de nettoyage et de vérification des données et engendre d’importants problèmes de surveillance.

Mais cela ne représente qu’une partie de la chaîne de production. Prenez par exemple l’entraînement des modèles : c’est une étape qui requiert énormément de ressources de calcul. L’entraînement d’un seul modèle d’IA requiert un équipement de calcul massif, des dizaines de milliers de cartes graphiques et des ingénieurs très bien formés, qui sont d’ailleurs une ressource très rare pour les entreprises. Une entreprise comme Deep Mind[1] consacre d’ailleurs une très large partie de son budget pour garder ses meilleures têtes, avec des salaires qui se chiffrent en centaines de milliers de dollars. Tant que l’on ne change pas le regard sur l’IA et que l’on ne considère pas toutes les étapes de sa production, on ne pourra prendre en compte que les problèmes de données et de surveillance, alors que de nombreux enjeux de pouvoir, de propriété et de monopole se concentrent autour des équipements de calcul et des infrastructures (énergétiques, hydriques) qui permettent de les approvisionner.

LVSL – Si l’on s’intéresse aux producteurs d’IA, du moins du côté de la production des modèles, on s’aperçoit que les acteurs sont à peu près les mêmes qui, de l’économie du web au capitalisme de plateforme, ont été au cœur du capitalisme numérique : Google, Amazon, Microsoft, Facebook. L’industrie de IA que l’on voit prospérer aujourd’hui est-elle une ramification du capitalisme de plateforme ?

N. S. – Il y a une continuité claire entre le capitalisme de plateforme et l’industrie de production de l’intelligence artificielle. OpenAI, l’entreprise au cœur de l’engouement actuel autour de l’IA, dépend de Microsoft, qui l’a récemment renflouée à la hauteur de 10 milliards de dollars[2] et dépensé plusieurs centaines de millions de dollars pour construire un « superordinateur » pour OpenAI. L’intelligence artificielle est actuellement dominé par Microsoft, Google et Facebook en moindre mesure. Ce sont des entreprises qui ont acquis leur pouvoir comme plateformes, en recueillant les données des utilisateurs, ce qui leur permettait à l’époque de cibler leurs services, mais l’enjeu crucial aujourd’hui est ailleurs. Ce ne sont plus des plateformes au sens strict : ce sont désormais des fournisseurs d’infrastructures de calcul. C’est pour ça qu’Amazon s’emploie à devenir l’un des acteurs les plus importants de l’IA. En matière d’IA, Amazon n’a développé que quelques petits modèles, rien qui puisse concurrencer l’état de l’art ; ce qui importe cependant est qu’elle fournit aujourd’hui la majeure partie des ressources de calcul nécessaires à l’IA via Amazon Web Services, son service cloud. Même Facebook ne possède pas suffisamment de data centers et doit parfois s’appuyer sur Amazon pour entraîner ses modèles.

Les ressources de calcul, le cloud et leur infrastructure sont devenues le nerf de la guerre de l’IA et leur propriété est de plus en plus concentrée. On peut observer une dynamique semblable à celle des chemins de fer au siècle dernier : en raison des investissements massifs à pourvoir en amont, le secteur tech tend au monopole. Un processeur graphique de pointe coûte aujourd’hui autour de 40 000 dollars et il en faut des centaines, voire des milliers, pour entraîner les modèles d’IA. Cela signifie que c’est hors de portée pour la plupart des entreprises et pour la recherche publique.

LVSL – Est-ce cette concentration qui fait le pouvoir des GAFAM ? Paradoxalement, c’est une position que pourraient défendre une théoricienne libérale comme Shoshana Zuboff dans son travail sur le capitalisme de surveillance ou les commissaires européens, lorsqu’ils incitent à démanteler les géants du secteur tech.

N. S. – Il y a deux manières de considérer les monopoles. La première, qui est celle de la Commission européenne, est une approche anti-trust classique, selon laquelle la libre concurrence est le but ultime de la politique économique. L’objectif est donc d’avoir plusieurs Facebook, plusieurs Google, plusieurs de ces entreprises en compétition les unes avec les autres, avec l’idée que quelques bénéfices finiront par émerger d’un système compétitif. Je ne pense pas que ce soit vrai. Au contraire, c’est bien la concurrence qui produit des dommages. Ces entreprises rivalisent déjà pour accaparer les données, les utilisateurs et les financements. Cette concurrence les conduit à renforcer la surveillance, élargir la collecte massive de données, à chercher à affiner le profilage et les techniques pour garder leurs utilisateurs captifs, comme les dark patterns[3]. Ces problèmes n’ont rien à voir avec la taille de ces entreprises. Dans ce contexte, la concurrence n’est en rien une solution : c’est au contraire une partie du problème qui consiste à laisser ces plateformes dans les mains du marché. Ce n’est pas de concurrence dont on a besoin, mais de contrôle démocratique et populaire sur le développement et sur le déploiement de ces technologies. Ce contrôle est aujourd’hui dans les mains d’un type comme Sam Altman, le co-fondateur avec Elon Musk de OpenAI.

LVSL – Certains, comme l’économiste français Cédric Durand, soutiennent que l’essor des plateformes a fondamentalement changé le capitalisme, au point d’en marquer la fin. La captation de valeur par l’accumulation de données et le contrôle des infrastructures par une poignée de puissantes entreprises rapprocheraient l’économie numérique d’un système féodal, ou plus précisément : techno-féodal. Quelle est votre lecture des transformations de l’économie numérique ?

N. S. – Sans être un spécialiste des travaux de Cédric Durand, il me semble que sa thèse s’appuie sur la prémisse selon laquelle la dynamique du système économique serait portée non plus par le profit mais par la rente[4]. Je suis en désaccord avec cette prémisse : la rente n’est pas un phénomène extérieur au capitalisme. Marx n’aurait jamais été d’accord : il y a des centaines de pages dans le volume III du Capital sur la rente, sur les manières dont elle s’intègre à un système capitaliste et s’y trouve transformée. Évidemment, la dynamique d’une entreprise qui dépend de la rente diffère d’une entreprise plus classique qui dépend de l’extraction de profit. Malgré ces différences, toutes deux font partie du système capitaliste.

C’est d’ailleurs l’un de mes principaux arguments au sujet du capitalisme de plateforme. De nombreux auteurs ont voulu voir dans les GAFAM de nouveaux modèles économiques, voire de nouveaux modèles d’ordre social. Les optimistes comme Rifkin, Benkler ou Mayer-Schönberger avaient affirmé que l’on allait vivre dans une nouvelle économie du partage. Les pessimistes, comme McKenzie Wark, que l’on est sortis du capitalisme pour entrer dans une nouvelle techno-dystopie. Ce que j’ai essayé de montrer avec Capitalisme de plateforme, c’est que c’est toujours du capitalisme, mais avec une dynamique propre, gouvernée par la capacité d’intermédiation des plateformes.

Nous sommes toujours en plein capitalisme. La prominence du phénomène de la rente aujourd’hui peut plutôt être comprise comme le résultat d’un ralentissement du capitalisme. L’économie globale ralentit depuis plusieurs décennies, tout particulièrement à son centre. Des pays comme l’Inde et la Chine ont rapidement rattrapé les États Unis, mais ce n’est pas le cas de nombreux autres et la frontière de la croissance ralentit. Avec le ralentissement de la croissance économique, les entreprises se trouvent davantage incitées à capter qu’à créer de la valeur – comme la création devient de plus en plus difficile. Là où la thèse techno-féodale oppose rente et profit, je vois une opposition entre création et captation de valeur – mais cette captation de valeur demeure fondamentalement capitaliste.

Il y a évidemment une composante importante de rente dans l’économie et le capitalisme de plateforme en fait partie, mais ce n’est pas hors capitalisme. Les caractéristiques saillantes du capitalisme, notamment l’accumulation, n’ont pas disparu. On assiste plutôt à une lutte acharnée pour s’emparer d’une mise de plus en plus maigre. Et par-delà la prominence de la rente, je pense que la stagnation a aussi récemment beaucoup influencé les politiques industrielles et déterminé le retour de la concurrence géopolitique.

LVSL – Dans quel sens ?

N. S. – La période néolibérale a été marquée par l’abandon de la politique industrielle et de ses implications géopolitiques. Elle n’a évidemment jamais complètement disparu, mais elle était déconsidérée de manière idéologique et peu discutée. Aux États-Unis, c’est le capital-risque qui a relevé le financement du secteur technologique, au moment du retrait du financement de l’État. C’est devenu le premier canal de financement des entreprises tech, à partir de l’ère « dot.com[5] ». Il s’agissait à l’époque de grands fonds d’investissement qui consacraient leur surplus à des investissements risqués par le biais de angel investors. Aujourd’hui au contraire, le capital-risque est aussi une ramification des plus grandes entreprises technologiques comme Google et Amazon ; il a permis leur essor et elles ont souvent chacune leurs propres fonds.

C’est tout à fait différent en Chine, où l’industrie est massivement soutenue par l’État. La politique industrielle volontariste de la dernière décennie a mené au développement de l’industrie des semi-conducteurs et, de manière significative, d’importantes plateformes domestiques. Huawei est un excellent exemple : c’est un leader mondial en standards technologiques, pour la 5G notamment. On les oublie souvent, mais les standards techniques sont des dispositifs cruciaux, qui permettent d’asseoir une influence géopolitique majeure.

En raison du succès des politiques industrielles chinoises et de la stagnation générale de l’économie, les États-Unis ont dû entrer dans la danse et le Chips Act[6] en est l’exemple le plus flagrant. Les US cherchent explicitement à s’autonomiser à l’égard de la Chine, qui soutient ses entreprises nationales, avec un intérêt géopolitique clair. La première entreprise productrice de semi-conducteurs, TSMC, est basée à Taïwan, qui est actuellement une poudrière géopolitique. Le Chips Act était une tentative de s’assurer une forme d’autonomie sur la chaîne de production, surtout après avoir vu pendant le Covid-19 la fragilité des chaînes d’approvisionnement. Actuellement, la maigre politique industrielle américaine est entièrement portée par la concurrence géopolitique.

LVSL – Et en Europe ?

N. S. – L’Europe voudrait avoir une industrie de l’IA qui puisse concurrencer les États Unis et la Chine. C’est impossible pour plusieurs raisons, parmi lesquelles figurent le manque de plateformes et de fournisseurs cloud d’envergure. Le vieux continent peut se concentrer sur le secteur applicatif, avec différentes start ups, mais du point de vue de la chaîne de valeur, c’est un secteur qui capte très peu de valeur. Si l’on accepte l’hypothèse de la centralité croissante des infrastructures, on peut conclure que les fournisseurs cloud vont en ressortir les plus puissants et aucun n’est en Europe. Cela ne signifie pas qu’aucune application utile ne pourra émerger de l’Europe. Mais contrairement aux promesses, le retard technologique européen ne pourra pas être comblé.

LVSL – En 2013, le Manifeste accélérationniste faisait controverse en prenant à contrepied les positions sociales-démocrates autant que décroissantes en matière de nouvelles technologies, accusées d’être « impuissantes et inefficaces ». Il y avait dans la partie programmatique du Manifeste un passage énigmatique, une invitation à œuvrer pour une « hégémonie sociotechnique de gauche ». Qu’est-ce que cette proposition ?

N. S. – L’hégémonie est le gouvernement par le consentement plutôt que par la coercition. C’est ce qui permet d’inclure les personnes dans un ordre social particulier et de leur faire accepter par différents moyens. Traditionnellement, l’étude de l’hégémonie se concentre sur ses aspects sociaux et discursifs du système, sur l’idéologie et sur tous les systèmes d’incitation qui permettent de convaincre les personnes à demeurer loyales à un système social existant. L’aspect sociotechnique de l’hégémonie concerne au contraire sa dimension matérielle et technique, la manière dont toutes les infrastructures, les outils, les technologies construisent autour de nous un ordre social. Pour donner un exemple très simple : la maison familiale individuelle construit la cellule familiale nucléaire en la naturalisant.

Elle répartit les personnes en petites maisons mono-familiales et les sépare de fait en petits foyers nucléaires. Cela fait partie de l’hégémonie, car l’architecture naturalise le système familial et social. Lorsque Alex Williams et moi invoquions une hégémonie sociotechnique de gauche, c’était pour dire qu’il faut prendre cette infrastructure très au sérieux. Il faut aussi s’intéresser à la conception de ces technologies et à leur déploiement. Tous ces aspects techniques doivent faire partie d’un agenda de gauche, on ne peut pas se limiter à des arguments théoriques ou à de meilleurs programmes de politiques publiques. La gauche doit investir la culture matérielle autant que la sphère des idées. Et cela concerne bien évidemment les nouvelles technologies.

LVSL – En quoi consisterait un agenda émancipateur en matière d’IA ?

N. S. – C’est très difficile de proposer un agenda émancipateur en matière d’IA, telle qu’elle est développée aujourd’hui. Il y a actuellement deux approches dominantes, toutes deux insuffisantes. La première propose de « démocratiser » l’IA en garantissant l’usage à tout le monde : le fait de pouvoir accéder librement à ChatGPT depuis un ordinateur équivaudrait à la démocratisation de ces technologies. Cela n’a évidemment aucun sens du point de vue progressiste, car la propriété et la conception des modèles demeure dans les mains de Microsoft et de OpenAI, qui captent toute la valeur issue de ces systèmes. Le fait que tout le monde puisse y accéder ne change ni le développement des technologies ni les structures de pouvoir desquelles elles sont issues.

L’autre alternative, plus intéressante, est celle du développement en open source de plus petits modèles. La plupart des modèles dits « de fondation » comme GPT4 ou DALL-E [modèles de grande taille de génération de texte ou d’image, qui peuvent être adaptés par la suite à un large éventail de tâches, n.d.r.] sont des modèles propriétaires, au sens où ils sont la propriété des entreprises qui les ont développés. Il existe au contraire d’autres modèles librement accessibles, qui peuvent être librement employés et modifiés. L’architecture des modèles, leurs données d’entraînement, les poids de leurs paramètres, tout est à disposition et utilisable pour quiconque souhaite s’en servir.

Et cela pourrait représenter un vrai changement : les modèles actuels ont coûté des centaines de millions de dollars pour être entraînés. Tant que c’est la seule manière de produire de l’IA de pointe, la recherche publique ne pourra jamais suivre. L’open source montre que l’on pourrait s’en tirer de manière beaucoup plus économique. S’il est possible de ré-entraîner des modèles sur une poignée de processeurs graphiques, s’il est (presque) possible de répliquer ChatGPT pour quelques centaines de dollars, le modèle économique de OpenAI peut être entièrement détruit. L’open source peut en ce sens encore représenter une menace pour le pouvoir de l’industrie technologique.

Le problème, c’est que cet open source dépend à son tour des GAFAM. Dans le domaine de l’IA, il s’appuie sur les gros modèles entraînés par ces entreprises. Une fois qu’ils sont entrainés par les GAFAM, le développement en open source arrive en bout de course pour leur réglage fin [le fine-tuning n.d.r.]. De plus, le travail en open source s’appuie sur les infrastructures possédées par les GAFAM pour entrainer et faire fonctionner ses modèles à l’échelle. Toutes les entreprises qui les développent en open source ont des partenariats avec les GAFAM et continuent d’en être dépendantes. L’open source pourrait permettre de ralentir la concentration de l’IA, mais non de s’autonomiser à l’égard des GAFAM. Difficile de dire, dans les deux cas, quel serait un scénario émancipateur.

LVSL – Ces technologies numériques – et l’IA n’en est qu’un exemple – s’appuient sur la collecte massive de données des utilisateurs, donc sur une forme de surveillance. Plus fondamentalement, elles requièrent une grande quantité de ressources naturelles et énergétiques pour leur fonctionnement. Dans un contexte d’urgence climatique, un agenda technologique de gauche est-il compatible avec le maintien de telles technologies et infrastructures ?

N. S. – Les ressources et l’énergie que l’on peut employer sont évidemment limitées à un temps t. Mais en même temps, le développement technologique peut permettre de repousser ces limites. Notre capacité à employer l’énergie et les ressources de manière soutenable s’améliore, surtout si l’on encourage le développement technologique dans cette direction. Ces limites devraient etre conçues comme fixes à court-terme et variables à long-terme. Un deuxième argument consiste à dire que ce n’est pas parce qu’une technologie exige une quantité importante de ressources qu’il faut automatiquement y renoncer. Les bénéfices d’une infrastructures à haut impact sur l’environnement pourraient consister à limiter l’usage de ressources naturelles dans un autre contexte.

C’est là l’une des questions que devra se poser une société future. Les ressources requises pour le fonctionnement de l’IA valent-elles les bénéfices qu’elle peut fournir ? Je renvoie la question aux générations futures parce que les bienfaits de l’IA vont avant tout les concerner. Il faut évidemment baisser la consommation de ressources naturelles, mais si l’on jugeait raisonnable d’allouer, mettons, 10 % de la consommation énergétique mondiale aux nouvelles technologies, on pourrait alors s’interroger pour savoir si les bénéfices de l’IA sont suffisants pour leur consacrer une part du budget énergétique.

Cette position peut sembler opposée à la plupart des réflexions écosocialistes, mais ce n’est pas mon point de vue. La vraie question – c’est là notre point commun – est de savoir comment on peut acquérir le contrôle collectif sur la direction du développement technologique, comment on peut en contrôler démocratiquement le déploiement et l’usage. Le problème n’est pas celui de la high tech en opposition à la low tech. Il est possible, par exemple, de faire de l’agriculture locale et à petite échelle de manière très high tech.

L’enjeu est à chaque fois de savoir comment choisir les technologies appropriées à un contexte donné et de garantir qu’elles soient efficaces du point de vue des ressources consommées et des objectifs définis collectivement par une société. Dans un monde où l’on essaie simultanément de réduire l’impact environnemental et le temps de travail, il y a toute une série de contraintes complexes qu’il faudra prendre en compte dans l’imagination d’une société future et de ses technologies. L’important est que nous puissions choisir collectivement.

LVSL – Mais de quelles institutions disposons-nous pour décider collectivement sur la culture matérielle et technique ?

N. S. – Les approches dominantes pour gouverner la culture technique sont aujourd’hui celles de la démocratie représentative et de la technocratie. Dans la première des configurations, les politiciens élus lors des élections prennent des décisions en vertu de leur fonction de représentation politique. L’autre approche est celle d’inspiration technocratique, de plus en plus répandue, selon laquelle les experts techniques sont les plus à même d’en gouverner l’usage. Les ingénieurs en machine learning sauraient, en vertu de leurs compétences de calcul, gouverner le développement technique de manière éclairée. Le problème étant qu’ils ne sont pas forcément compétents pour saisir les biais sociaux et économiques de leurs propres systèmes.

Je ne veux pas dire par là que l’expertise technique n’a pas d’importance, le problème n’est d’ailleurs pas là actuellement. Aujourd’hui, les gouvernements laissent les entreprises dicter les grandes lignes de régulation, comme c’est le cas actuellement avec l’IA, ou bien décident de réguler les technologies en faisant fi de toute expertise technique. Les tentatives d’encadrement du chiffrement bout à bout en sont un excellent exemple : les gouvernements cherchent à tout prix à imposer l’insertion de back doors[7], alors que les experts expliquent qu’une porte d’entrée annule tout le principe du chiffrage bout à bout…

LVSL – Il existe cependant de nombreux exemples d’initiatives politiques en matière de culture technique, autant du côté des institutions (conventions citoyennes, autorités indépendantes et de régulation) que du côté des ONG et des mouvements sociaux, où se mélangent expertise technique et savoir-faire politique. Ne peut-on pas s’appuyer sur ce déjà-là pour imaginer les institutions pour gouverner la culture technique ?

N. S. – Je vais devoir botter en touche : je ne sais pas faire du design d’institutions. Je peux donner quelques grands principes qui pourraient guider ce genre d’initiative, mais c’est quelque chose qui va devoir être inventé par-delà le capitalisme. Le problème avec le capitalisme, c’est que tous les problèmes importants sont hors de portée, le changement climatique en premier lieu. Le développement technologique est guidé par des impératifs structurels. On a beau savoir ce qu’il faut faire pour arrêter le changement climatique, le capitalisme ne va pas le permettre.

Peu importe que les PDG eux-mêmes le souhaitent du fond de leur cœur : les actionnaires ne le permettront pas. Il en va de même avec les décisions au sujet du développement technologique : il est porté par la concurrence et par le profit plutôt que par une quelconque réflexion rationnelle.

LVSL – Un raisonnement maximaliste de ce genre ne risque-t-il pas de passer sous silence la pluralité de pratiques qui existent déjà, tant du point de vue de la lutte contre la crise climatique que des pratiques de réappropriation des techniques ?

N. S. – Nous ne sommes évidemment pas dans un moment révolutionnaire. Le mieux que nous puissions faire actuellement est probablement de cultiver ces pratiques et de les institutionnaliser, de sorte à leur garantir une vie par-delà leur immédiateté. C’est ce qu’Alex Williams et moi appelions dans Inventing the Future une « politique anti-localiste » (anti-folk politics). L’idée n’est pas de critiquer le localisme ou l’horizontalisme en soi, mais de rappeler qu’ils sont insuffisants pour soutenir un mouvement sur le long terme.

Chaque mouvement a ses pratiques et ses innovations, mais lorsque l’on refuse de construire des systèmes, comme c’était le cas de Occupy Wall Street en 2009, on risque de perdre tout ce qui a été inventé lorsque la ferveur retombe. J’insiste sur Occupy Wall Street parce que c’était l’un des mouvements les plus importants de la gauche occidentale anglophone de notre siècle et probablement celui où cette limite était la plus flagrante. Mais cela pourrait s’appliquer aux mouvements anti-globalisation des années 2000 et probablement à de nombreux autres mouvements.

LVSL – Vous avez récemment publié un nouveau livre avec Helen Hester, After Work : A History of the Home and the Fight for Free Time, qui revient sur l’histoire des technologies domestiques et la lutte pour la fin du travail.

N. S. – Notre livre part du paradoxe mis en avant par la théoricienne féministe Ruth Schwarz Cowan au sujet du travail domestique. Dans More Work for Mother ?, elle démontrait que malgré la révolution domestique, malgré les lave-linges, les lave-vaisselles, les aspirateurs et tous les autres équipements ménagers, les femmes au foyer accomplissaient toujours autant de travail en 1970 qu’au début des années 1900. La technologie n’a pas beaucoup changé le temps de travail à la maison. La grande question étant : comment est-ce possible ? Dans le livre nous nous intéressons aux structures sociales et matérielles qui continuent de nous faire faire tout ce travail.

Aujourd’hui, il en va de même des objets connectés et tous les gadgets domestiques que nous accumulons dans nos maisons, qui ne font que déplacer la charge de travail domestique qui nous incombe. Je pense fondamentalement que les technologies peuvent nous libérer du travail. Historiquement, elles ont dégagé énormément de temps libre (potentiel). La question est toujours celle de savoir qui contrôle le développement et le déploiement de ces technologies, pourquoi et comment elles ne réduisent pas le temps de travail de production et de reproduction.

LVSL – Et dans le livre, vous mettez en avant un véritable programme politique.

N. S. – Nous essayons de dégager trois grands principes de réorganisation du travail domestique et de ses technologies. Le premier principe est celui de soin communautaire (communal care) : en s’éloignant du modèle de la famille nucléaire comme lieu du soin, on peut mutualiser la charge de travail qui pèse individuellement sur chaque famille. Cela évidemment développer des crèches et des gardes d’enfants publiques, ouvertes sept jours sur sept – et je sais qu’en France c’est un système bien mieux développé que dans nombreux autres pays – ainsi que d’autres efforts pour partager la charge du travail reproductif.

Le second principe est celui du « luxe public » (public luxury), qui consiste à garantir l’accès à des services de luxe, trop chers pour des familles individuelles, mais dont on peut mutualiser les coûts et la dépense énergétique. L’exemple le plus simple est celui d’une piscine : c’est un bien insoutenable de tous points de vue pour une famille individuelle, mais qui peut avoir un sens s’il est partagé. Il en va de même pour les bibliothèques, les ludothèques et tous les espaces récréatifs. Enfin, le troisième principe est celui de la souveraineté temporelle, de prise de décision démocratique en matière de développement de la culture matérielle et technique.

Cela concerne notamment la conception des espaces de vie et de la manière dont ils peuvent permettre la diminution de la charge de travail domestique, mais aussi la constitution d’institutions qui nous permettent de déterminer ce que l’on souhaite faire de notre temps libre.
La plupart de ces initiatives existent déjà, nous proposons de les potentialiser. Souvent, des initiatives locales qui essaiment un peu partout ne se conçoivent pas comme reliées par un projet politique. L’une des manières de leur donner de la force est de leur permettre de se reconnaître dans une lutte plus large. Se battre pour sauver une bibliothèque municipale, est-ce une initiative locale ou une lutte plus large pour garantir le luxe public ? Le nôtre est un travail d’articulation de pratiques, au sens de Ernesto Laclau[8] et c’est ce à quoi nous essayons de participer avec ce livre.

NDLR : parmi les livres traduits en français de Nick Srniček figurent le Manifeste accélérationniste. Accélérer le futur : Post-travail & Post-capitalisme (Cité du design IRDD, 2017) et Capitalisme de plateforme (Lux, 2018).

Notes :

[1] La branche d’intelligence artificielle de Google.

[2] Voir au sujet de OpenAI l’article de Valentin Goujon, « OpenAI, une histoire en trois temps », AOC, 23 mai 2023.

[3] Les dark patterns sont les interfaces conçues pour solliciter les utilisateurs et les faire rester plus longtemps sur un service, par exemple en rendant moins visible les boutons pour refuser les cookies ou la publicité.

[4] La rente est un revenu perçu pour la propriété d’une terre, d’un actif ou d’une infrastructure, en opposition au profit généré par l’exploitation du travail. La proéminence de la rente dans l’économie numérique (brevets, captation de données, contrôle sur les technologies) marquerait ainsi la fin du capitalisme défini par l’exploitation du travail et l’extraction de profit.

[5] Cela correspond au développement de l’économie du web dans les années 1990, porté par Ebay, Google, Amazon, etc.

[6] L’acte américain qui vise à soutenir la production domestique de semi-conducteurs aux États-Unis.

[7] Autrement dit, une « porte dérobée », une clef secrète qui déjoue le chiffrement.

[8] Théoricien néo-marxiste, dont la stratégie politique consiste à articuler différentes luttes, dans une identité politique qui en préserve les singularités.

🔲 ☆

Coming soon to a radio near you: Personalized ads

And privacy be damned.

See, there is an iron law for every new technology: What can be done will be done. And a corollary that says, —until it’s clear what shouldn’t be done.  Let’s call those Stage One and Stage Two.

With respect to safety from surveillance in our cars, we’re at Stage One.

For Exhibit A, read what Ray Schultz says in Can Radio Time Be Bought With Real-Time Bidding? iHeartMedia is Working On It:

HeartMedia hopes to offer real-time bidding for its 860+ radio stations in 160 markets, enabling media buyers to buy audio ads the way they now buy digital.

“We’re going to have the capabilities to do real-time bidding and programmatic on the broadcast side,” said Rich Bressler, president and COO of iHeart Media, during the Goldman Sachs Communacopia + Technology Conference, according to Radio Insider.

Bressler did not offer specifics or a timeline. He added: “If you look at broadcasters in general, whether they’re video or audio, I don’t think anyone else is going to have those capabilities out there.”

“The ability, whenever it comes, would include data-infused buying, programmatic trading and attribution,” the report adds.
The Trade Desk lists iHeart Media as one of its programmatic audio partners.
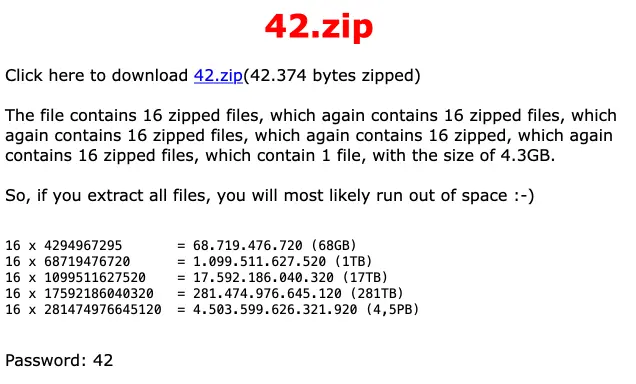
Audio advertising allows users to integrate their brands into their audiences’ “everyday routines in a distraction-free environment, creating a uniquely personalized ad experience around their interests,” the Trade Desk says.

The Trade Desk “specializes in real-time programmatic marketing automation technologies, products, and services, designed to personalize digital content delivery to users.” Translation: “We’re in the surveillance business.”

Never mind that there is negative demand for surveillance by the surveilled. Push-back has been going on for decades.  Here are 154 pieces I’ve written on the topic since 2008.

One might think radio is ill-suited for surveillance because it’s an offline medium. Peopler listen more to actual radios than to computers or phones. Yes, some listening is online; but  not much, relatively speaking. For example, here is the bottom of the current radio ratings for the San Francisco market:

Those numbers are fractions of one percent of total listening in the country’s most streaming-oriented market.

So how are iHeart and The Trade Desk going to personalize radio ads?  Well, here is a meaningful excerpt from iHeart To Offer Real-Time Bidding For Its Broadcast Ad Inventory, which ran earlier this month at Inside Radio:

The biggest challenge at iHeartMedia isn’t attracting new listeners, it’s doing a better job monetizing the sprawling audience it already has. As part of ongoing efforts to sell advertising the way marketers want to transact, it now plans to bring real-time bidding to its 850 broadcast radio stations, top company management said Thursday.

“We’re going to have the capabilities to do real-time bidding and programmatic on the broadcast side,” President and COO Rich Bressler said during an appearance at the Goldman Sachs Communacopia + Technology Conference. “If you look at broadcasters in general, whether they’re video or audio, I don’t think anyone else is going to have those capabilities out there.”

Real-time bidding is a subcategory of programmatic media buying in which ads are bought and sold in real time on a per-impression basis in an instant auction. Pittman and Bressler didn’t offer specifics on how this would be accomplished other than to say the company is currently building out the technology as part of a multi-year effort to allow advertisers to buy iHeart inventory the way they buy digital media advertising. That involves data-infused buying and programmatic trading, along with ad targeting and campaign attribution.

Radio’s largest group has also moved away from selling based on rating points to transacting on audience impressions, and migrated from traditional demographics to audiences or cohorts. It now offers advertisers 800 different prepopulated audience segments, ranging from auto intenders to moms that had a baby in the last six months…

Advertisers buy iHeart’s ad inventory “in pieces,” Pittman explained, leaving “holes in between” that go unsold. “Digital-like buying for broadcast radio is the key to filling in those holes,” he added…

…there has been no degradation in the reach of broadcast radio. The degradation has been in a lot of other media, but not radio. And the reason is because what we do is fundamentally more important than it’s ever been: we keep people company.”

Buried in that rah-rah is a plan to spy on people in their cars. Because surveillance systems are built into every new car sold. In Privacy Nightmare on Wheels’: Every Car Brand Reviewed By Mozilla — Including Ford, Volkswagen and Toyota — Flunks Privacy Test, Mozilla pulls together a mountain of findings about just how much modern cars spy on their drivers and passengers, and then pass personal information on to many other parties. Here is one relevant screen grab:

spying

As for consent? When you’re using a browser or an app, you’re on the global Internet, where the GDPR, the CCPA, and other privacy laws apply, meaning that websites and apps have to make a show of requiring consent to what you don’t want. But cars have no UI for that. All their computing is behind the dashboard where you can’t see it and can’t control it. So the car makers can go nuts gathering fuck-all, while you’re almost completely in the dark about having your clueless ass sorted into one or more of Bob Pittman’s 800 target categories. Or worse, typified personally as a category of one.

Of course, the car makers won’t cop to any of this. On the contrary, they’ll pretend they are clean as can be. Here is how Mozilla describes the situation:

Many car brands engage in “privacy washing.” Privacy washing is the act of pretending to protect consumers’ privacy while not actually doing so — and many brands are guilty of this. For example, several have signed on to the automotive Consumer Privacy Protection Principles. But these principles are nonbinding and created by the automakers themselves. Further, signatories don’t even follow their own principles, like Data Minimization (i.e. collecting only the data that is needed).

Meaningful consent is nonexistent. Often, “consent” to collect personal data is presumed by simply being a passenger in the car. For example, Subaru states that by being a passenger, you are considered a user — and by being a user, you have consented to their privacy policy. Several car brands also note that it is a driver’s responsibility to tell passengers about the vehicle’s privacy policies.

Autos’ privacy policies and processes are especially bad. Legible privacy policies are uncommon, but they’re exceptionally rare in the automotive industry. Brands like Audi and Tesla feature policies that are confusing, lengthy, and vague. Some brands have more than five different privacy policy documents, an unreasonable number for consumers to engage with; Toyota has 12. Meanwhile, it’s difficult to find a contact with whom to discuss privacy concerns. Indeed, 12 companies representing 20 car brands didn’t even respond to emails from Mozilla researchers.

And, “Nineteen (76%) of the car companies we looked at say they can sell your personal data.”

To iHeart? Why not? They’re in the market.

And, of course, you are not.

Hell, you have access to none of that data. There’s what the dashboard tells you, and that’s it.

As for advice? For now, all I have is this: buy an old car.


🔲 ☆

From sea to rhyming sea

states and capitals

While discussing ChatGPT with my teenage grandkids, I put it to a number of tests. In one I asked it to write a poem that includes all the capital cities in the U.S. Here is its reply:

From sea to shining sea, Across this land so grand, The capitals of every state, Await us to take a stand.

In Montgomery, Alabama, We begin our noble quest, To climb each statehouse staircase, And put our wills to the test.

Through Juneau, Alaska, To Phoenix, Arizona’s heat, The halls of power beckon us, With challenges we must meet.

Little Rock, Arkansas, And Sacramento, too, We march to their state capitals, To learn what they can do.

From Denver, Colorado’s heights, To Connecticut’s Hartford town, We cross this land of liberty, To see our nation’s crown.

Dover, Delaware, And Tallahassee, Florida’s heat, We journey forth to find our place, In every statehouse seat.

Atlanta’s Georgia peach, And Honolulu’s island breeze, We’ll walk the halls of power, To achieve our lofty dreams.

Through Boise, Idaho’s hills, And Springfield’s Illinois pride, We’ll take the steps of governance, With courage as our guide.

Indianapolis, Indiana, And Iowa’s Des Moines, We’ll stand in every capital, To honor each state’s joins.

From Topeka’s Kansas plains, To Kentucky’s Frankfort pride, We’ll learn from every leader, In whom we can confide.

Baton Rouge, Louisiana, And Augusta, Maine’s coast, We’ll listen to the wisdom, That each statehouse host.

In Annapolis, Maryland, And Massachusetts’ Boston town, We’ll seek to find our purpose, And rise to wear the crown.

Lansing, Michigan, And St. Paul’s Minnesota pride, We’ll climb each capital’s staircase, And never be denied.

Mississippi’s Jackson town, And Jefferson City’s Missouri call, We’ll cross this land with honor, And never falter or fall.

Helena, Montana’s heights, And Lincoln’s Nebraska plains, We’ll march through every capital, And honor each state’s gains.

Carson City, Nevada, And Concord’s New Hampshire pride, We’ll stand in every statehouse, And let our voices be our guide.

Trenton’s New Jersey call, And Santa Fe’s New Mexico sun, We’ll climb the stairs of governance, And learn from everyone.

Albany’s New York pride, And Raleigh’s North Carolina charm, We’ll honor every state’s glory, And never let it harm.

Bismarck’s North Dakota plains, And Columbus’ Ohio pride, We’ll journey forth to every capital, With honor as our guide.

Oklahoma’s Oklahoma City, And Salem’s Oregon call, We’ll stand in every statehouse, And never let our spirits fall.

Harrisburg, Pennsylvania, And Rhode Island’s Providence town, We’ll climb each capital’s staircase, And never let ourselves drown.

South Carolina’s Columbia pride, And South Dakota’s Pierre call, We’ll cross this land with dignity, And never let ourselves stall.

Nashville’s Tennessee music, And Austin’s Texas pride, We’ll stand in every statehouse, And let our voices rise.

Salt Lake City’s Utah heights, And Montpelier’s Vermont pride, We’ll march through every capital, And let our dreams be our guide.

Richmond’s Virginia charm, And Olympia’s Washington crown, We’ll honor every state’s valor, And never let ourselves down.

Charleston’s West Virginia hills, And Madison’s Wisconsin pride, We’ll journey forth to every capital, And never be denied.

Cheyenne’s Wyoming pride, And Washington, D.C.’s White House, We’ll cross this land with honor, And never let ourselves douse.

From sea to shining sea, We’ve walked each statehouse hall, And learned the lessons of governance, That make our nation stand tall.

Redraw your own conclusions.

🔲 ☆

Does Sirius XM sound far worse than listening to music on YouTube?

That’s a question asked on Quora and deleted before I posted my answer. So I’m posting my answer here.

This is like asking if a car radio sounds better than a TV. Because it’s a matter of where, how, when, and what, more than a matter of sound.

There is some overlap in the sense that both SiriusXM and YouTube are fully useful on mobile apps. But you don’t watch your radio in your car or listen to your radio on your TV, even though it’s possible to do both through apps that are native to both the road (through Android Auto and Apple Carplay) and the living room (through Roku, Amazon, Apple, and other TV app platforms).

As for the sound itself, YouTiube lets you select audio quality bitrates up to 256kbps AAC & OPUS. SiriusXM’s default bitrate is also 256kpbs, but over the satellite link bitrates are typically lower—sometimes much lower. But, since SiriusXM does not (to my knowledge, so far) publish their bitrates in a place that’s easy to find, its bitrates are subject to debate. Here is one of those on Reddit.

But, again, it’s a matter of where. when, and what, more than how. If you want to see and hear a piece of music, YouTube provides enormous optionality, with its almost boundless collection of videos. If you want radio-like music programming, SiriusXM offers more—plus sports, talk, news, sports (including play-by-play for all the major ones), and more.

Yet the Internet has more than both put together. That’s why the image above is of Radio Paradise, which is one of the oldest and best Internet music stations. It’s live on the Net and the Web, and it has Best Of collections on YouTube as well.

Bonus link (and a lot of fun): radio.garden. There’s an app for that too.

❌