Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

Comment créer un cluster maître-maître PostgreSQL en natif

Un peu de contexte

PostgreSQL est un système de gestion de base de données relationnelle et objet. Le projet était initialement nommé POSTGRES en référence à la base de données Ingres. Il a démarré en 1985. En 1995, les premières fonctionnalités SQL ont été ajoutées. Le projet sera renommé PostgreSQL l’année suivante.

Logo PostgreSQL

PostgreSQL est un logiciel open source avec sa propre licence PostgreSQL dont le code est hébergé sur le site de PostgreSQL. La dernière version majeure publiée est la version 16. Les versions 12, 13, 14 et 15 sont encore maintenues.

La communauté francophone est très active et compte parmi ses participants l’association PostgreSQLFr. Cette association assure notamment la coordination de la traduction de la documentation et l’hébergement d’un forum qui permet d’échanger à propos de PostgreSQL. Elle fait aussi partie des organisateurs de PGDay France, le rendez-vous annuel de la communauté PostgreSQL.

Chez Worteks nous utilisons PostgreSQL comme base de données de plusieurs applications, en particulier NextCloud et LemonLDAP::NG. Ces applications étant souvent déployées en haute-disponibilité, nous sommes en veille constante sur les possibilités techniques de fonctionnement en cluster de cette base de données.

Dans ce billet de blog, nous allons montrer comment mettre en place un cluster bi-directionnel natif dans PostgreSQL 16. Nous allons utiliser la réplication logique pour créer une configuration maître-maître. L’objectif est d’avoir deux serveurs capables d’accepter des commandes d’écriture.

La version PostgreSQL 16 est sortie le 14 septembre 2023 et sera maintenue jusqu’au 9 octobre 2028. Elle contient de nombreuses améliorations, en particulier concernant la réplication logique qui nous intéresse ici.

La documentation PostgreSQL définit la réplication logique comme “[…] une méthode permettant de répliquer des données au niveau objet ainsi que les modifications apportées à ces objets, ceci basé sur leur identité de réplication (habituellement la clé primaire)”. Elle se différencie de la réplication physique car elle ne copie pas “octet par octet” les données du serveur mais peut juste copier une table ou même une colonne.

La réplication logique par défaut nécessite un serveur éditeur (publisher) et un serveur abonné (subscriber). L’abonné récupère les données publiées par l’éditeur et construit ainsi ses données. La réplication logique est disponible en natif depuis PostgreSQL 10.

Les améliorations citées ci-dessus permettent aujourd’hui de configurer la réplication logique des serveurs dans les deux sens et ainsi d’obtenir deux serveurs maîtres.

Mise en place du cluster PostgreSQL

À la fin de ce tutoriel, nous aurons deux serveurs en cluster avec PostgreSQL installé ainsi qu’un serveur applicatif qui sert à interroger le cluster. Cette troisième machine représentera l’application qui interagit avec la base de données (LemonLDAP, Nextcloud, la station spatiale internationale, etc…). Les adresses IP sont les suivants:

  • Serveur PostgreSQL 1 - premier maître : 192.168.2.24 ;
  • Serveur PostgreSQL 2 - deuxième maître : 192.168.2.65 ;
  • Serveur applicatif: 192.168.2.54

PostgreSQL cluster maitre-maitre

L’installation se fera dans des machines Rocky Linux 8 nouvelles. Toutefois, il suffit d’adapter les commandes pour une distribution de la famille Debian.

L’utilisateur par défaut sera le super-utilisateur root. Lorsqu’il faudra changer d’utilisateur, les instructions l’expliciteront.

Nous allons installer et activer la version 16 de PostgreSQL sur chacun des serveurs :

dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-8-x86_64/pgdg-redhat-repo-latest.noarch.rpm
dnf -qy module disable postgresql
dnf install postgresql16-server -y
/usr/pgsql-16/bin/postgresql-16-setup initdb
systemctl enable postgresql-16
systemctl start postgresql-16

La première commande ajoute les dépôts PostgreSQL. Ces dépôts donnent accès aux versions plus récents de PostgreSQL. La deuxième désactive les modules par défaut de la distribution. Les quatre dernières commandes installent et configurent PostgreSQL. PostgreSQL est activé par défaut, c’est-à-dire qu’il sera actif dès le démarrage du système.

Il faut éditer le fichier de configuration pour permettre l’accès à distance et la réplication logique.

vim /var/lib/pgsql/16/data/postgresql.conf
#--------------------------------------------#
listen_addresses = '*'
wal_level = logical
max_worker_processes = 10

Les valeurs de max_worker_processes, max_replication_slots, max_wal_senders sont à adapter selon le contexte (nombre de cores, utilisation du serveur dédié à PostgreSQL, etc…). Pour plus de détails, il faudra consulter la documentation PostgreSQL .

Il faut aussi éditer le fichier d’accès pour autoriser les connexions distantes :

vim /var/lib/pgsql/16/data/pg_hba.conf
#--------------------------------------------#
# [....]
host    database_test   pgreplication   192.168.2.24/32         scram-sha-256
host    database_test   pgreplication   192.168.2.44/32         scram-sha-256
host    database_test   user_distant    192.168.2.54/24         scram-sha-256

Puis, redémarrer PostgreSQL pour prendre en compte les changements :

systemctl restart postgresql-16.service

Il ne faut pas oublier d’ouvrir le pare-feu et l’écoute sur les ports :

firewall-cmd --permanent --add-service=postgresql
firewall-cmd --reload

Ensuite, il faut configurer les utilisateurs locaux de PostgreSQL. Pour accéder à PostgreSQL en local, nous utilisons la commande suivante :

su - postgres -c psql

Pour ce tutoriel, nous allons créer la base de données database_test et un utilisateur pgreplication pour la réplication. Nous créerons également un utilisateur user_distant pour générer les données fictives et vérifier la réplication.

-- Pour des questions de sécurité
ALTER USER postgres WITH ENCRYPTED PASSWORD 'postgres1';
-- L’utilisateur qui permettra de faire la réplication
CREATE ROLE pgreplication LOGIN REPLICATION PASSWORD 'pgrepuser1';
GRANT ALL ON ALL TABLES IN SCHEMA public TO pgreplication;
-- L'utilisateur pour user_distant
CREATE USER user_distant WITH ENCRYPTED PASSWORD 'user1';
CREATE DATABASE database_test OWNER user_distant;
GRANT ALL PRIVILEGES ON DATABASE database_test TO user_distant;
GRANT ALL PRIVILEGES ON DATABASE database_test TO pgreplication;
\q

Nous allons maintenant créer des données sur le serveur PostgreSQL 1. Nous commencerons par la table test et quelques valeurs. Il est important d’utiliser une clé primaire (PRIMARY KEY) par table. C’est un point à ne pas oublier si ce tutoriel est appliqué à des base de données déjà existantes. La méthode de la réplication logique ne marchera pas sur des tables sans clé primaire :

\c database_test
-- Créer la table.
CREATE TABLE table_test (
    id integer PRIMARY KEY GENERATED BY DEFAULT AS IDENTITY,
    title varchar(40) NOT NULL,
    name  varchar(40) NOT NULL);
-- Peupler la table.
INSERT INTO table_test VALUES    
    ('001', 'El ultimo lector', 'Toscana'),
    ('002', 'Le Comte de Monte-Cristo', 'Dumas'),
    ('003', 'Ulysse', 'Joyce');
-- Création de la publication de la table
CREATE PUBLICATION publication_test1 FOR ALL TABLES;

Pour le serveur PostgreSQL 2, nous allons d’abord l’abonner au serveur PostgreSQL 1. Une fois cette abonnement validé, nous ferons l’abonnement dans le sens inverse pour avoir la configuration bi-directionnelle.

Les pré-requis qui permettent de s’abonner à une table ou base de données sont les schémas. Ici nous utilisons une base vide, la marche à suivre pour copier les schémas d’une base de données déjà existante est expliquée dans la section Extra. Dans notre cas, nous créons la table dans le deuxième serveur puis nous nous y abonnons.

\c database_test
-- Peupler la table.
CREATE TABLE table_test (
    id integer PRIMARY KEY GENERATED BY DEFAULT AS IDENTITY,
    title varchar(40) NOT NULL,
    name  varchar(40) NOT NULL);
-- Premier abonné
CREATE SUBSCRIPTION subscription_au_serveur1
    CONNECTION 'host=192.168.2.24 port=5432 user=pgreplication dbname=database_test password=pgrepuser1'
    PUBLICATION publication_test1
    WITH (copy_data=true, origin=none);
-- Subscription de l'abonné
CREATE PUBLICATION publication_test2 FOR ALL TABLES;

L’abonné se connecte à la base de données distante avec l’utilisateur pgreplication. Ensuite, il écrit les modifications via le propriétaire de la subscription. Le propriétaire est par défaut l’utilisateur qui a créé la subscription. Il faut s’assurer que cet utilisateur ait des droits suffisants, notamment le privilège pg_create_subscription. Par défaut, il s’agit de l’utilisateur postgres.

PostgreSQL cluster maitre-maitre

Le secret de la réplication logique bi-directionnelle est dans l’avant dernière ligne : WITH (copy_data=true, origin=none);. Cette ligne contient les paramètres de la subscription.

L’option copy_data=true défini si le serveur importera les données existantes dans l’éditeur lors de la première connexion. Pour ce premier abonnement, nous souhaitons peupler la table. Toutefois, lors de l’abonnement du serveur PostgreSQL 1 vers PostgreSQL 2, nous le désactiverons.

Finalement, le paramètre origin=none indique à l’éditeur de ne pousser que les changements qui n’ont pas d’origine. Le valeur par défaut est any, dans ce cas l’éditeur pousse tous les changements, quelque soit l’origine. Dans le cas d’une réplication bi-directionnelle cette option produit une boucle nommée transactional loopback. En d’autres termes, les modifications poussées par l’éditeur seront répercutés vers lui, créant ainsi une boucle infinie et donc une erreur.

La réplication peut être vérifiée en cherchant les entrées créées dans le PostgreSQL 1 sur le serveur PostgreSQL 2.

SELECT * FROM table_test;
id |          title           |  name   
----+--------------------------+---------
 1 | El ultimo lector         | Toscana
 2 | Le Comte de Monte-Cristo | Dumas
 3 | Ulysse                   | Joyce
(3 rows)

Pour finir, nous nous abonnons depuis le serveur PostgreSQL 1 au serveur PostgreSQL 2 :

\c database_test
-- Deuxième abonné
CREATE SUBSCRIPTION subscription_au_serveur2
    CONNECTION 'host=192.168.2.44 port=5432 user=pgreplication dbname=database_test password=pgrepuser1'
    PUBLICATION publication_test2
    WITH (copy_data=false, origin=none);

Vérification de la réplication entre les deux serveurs

La vérification la plus simple et directe est de suivre les différentes modifications dans les tables, par exemple via un SELECT * FROM table_test;. Les logs de PostgreSQL permettent aussi de savoir si la réplication existe.

Il existe des étapes intermédiaires qui permettent de déboguer en cas de problèmes. Les étapes de la réplication logique sont :

  • L’envoi des WAL de l’éditeur
  • La réception côté abonné puis leur application

Pour vérifier au niveau de l’éditeur, le process walsender doit exister:

ps aux | grep walsender

Il est aussi possible de vérifier la réplication depuis psql:

su - postgres -c psql
\x
SELECT * FROM pg_stat_replication;

Pour l’abonné, la vérification de la réception se fait via les process du système d’exploitation soit via psql :

ps aux | grep 'logical replication'
su - postgres -c psql
\x
SELECT * FROM pg_stat_subscription;

Limites de la méthode

La réplication logique bi-directionnelle est une méthode très intéressante et assez utile. Toutefois, cela n’est pas toujours la méthode adéquate ou optimale.

Il est important de savoir que la méthode à besoin d’une supervision ou au minimum d’un checkup régulier. En effet, lorsqu’un des abonnés rencontre une erreur, la réplication s’arrête. Dans ce cas, il faudra regarder les logs. Ces conflits sont abordés dans la documentation sous la section 31.5.Conflits. Par exemple, lorsque la clé primaire est dupliquée en local et à distance :

024-04-24 12:14:59.993 CEST [4973] ERROR:  duplicate key value violates unique constraint "table_test_pkey"
2024-04-24 12:14:59.993 CEST [4973] DETAIL:  Key (id)=(1) already exists.
2024-04-24 12:14:59.993 CEST [4973] CONTEXT:  processing remote data for replication origin "pg_16399" during message type "INSERT" for replication target relation "public.table_test" in transaction 816, finished at 0/1A09DB0
2024-04-24 12:14:59.994 CEST [2731] LOG:  background worker "logical replication worker" (PID 4973) exited with exit code 1

Cela peut se produire régulièrement si la clé primaire est incrémentale, par exemple si les deux serveurs sont sollicités en même temps.

Il faut donc envisager les erreurs et les prévenir. Il faut aussi pouvoir les repérer quand elles arrivent et les corriger avant que ce ne soit trop tard.

Conclusion

PostgreSQL continue de s’améliorer. Par exemple, en dix ans, la latence à été divisée par deux !. Toutefois, de grands pouvoirs impliquent de grandes complexités ! PostgreSQL n’est pas le logiciel le plus simple à prendre en main lors de sa première utilisation. Mais grâce à la liberté des outils Open Source nous pouvons partager nos connaissances, comme ce tutoriel, pour que vous puissiez créer votre cluster le plus facilement possible. Chez Worteks nous utilisons PostgreSQL et nous souhaitons que vous puissiez l’utiliser aussi.

N’oubliez pas de consulter la documentation qui est très complète en français !

Merci pour votre lecture.

Extra

Pour ce tutoriel, nous avons pris le cas le plus simple : une architecture pensée dès le début en mode cluster maître-maître. En effet, il est toujours plus simple de partir de zéro plutôt que de s’adapter à l’existant. Malheureusement, ce n’est pas toujours possible.

Dans le cas où la base de données existe déjà mais pas en mode cluster, la deuxième base de données doit être initialisée avec le schéma de la première base. Pour ce faire, nous devons dumper la base et l’ajouter dans le deuxième serveur. Voici un exemple d’application :

pg_dumpall --schema-only --dbname 'host=localhost dbname=database_test user=user_distant' > db_structures.out
scp  db_structures.out rocky@192.168.2.65:

Ensuite, nous devons importer ce fichier dans la deuxième base de données :

mv [path/to/file]/db_structures.out /var/lib/pgsql/
chown postgres:postgres /var/lib/pgsql/db_structures.out
su - postgres -c 'psql < db_structures.out 2> /tmp/errors.log'
# Verifier s'il y a eu des erreurs lors de la création du schema
cat /tmp/errors.log
# Seulement l'erreur suivant devrait apparaître
ERROR:  role "postgres" already exists

Sources

🔲 ☆

Diffuser votre conférence Jitsi sur Peertube

Dans cet article, nous allons détailler les différentes étapes pour réussir à diffuser votre conférence Jitsi sur Peertube.

1. Pourquoi ?

C’est sans doute la question la plus importante, pourquoi vouloir diffuser une conférence Jitsi au plus grand nombre, pourquoi passer par Peertube ?

D’abord on parle ici de diffusion en direct (ou streaming pour nos amis anglophiles) et non de rediffusion (donc du contenu enregistré et remis à la disposition du plus grand nombre après).

Ensuite nous parlons ici d’outils Open Source. Que ce soit Jitsi ou Peertube, ce sont des projets disponibles au public sans restriction, que tout le monde peut mettre en place sur un serveur et adapter à ses besoins (ce point là est particulièrement important). Il existe des alternatives propriétaires : Zoom, Twitch, Youtube, mais qui sont toutes la propriété de grands groupes et ne vous donnent que peu de marge de manoeuvre et surtout vont vouloir monétiser d’une façon ou d’une autre leur bande passante, stockage ou utilisation de serveur.

Le cas de figure classique va être une conférence avec quelques intervenants (qui sont physiquement à des endroits différents, de deux à dix intervenants par exemple) et une audience massive (plusieurs centaines / milliers de spectateurs).

La première solution va être de mettre tout le monde sur Jitsi… plusieurs milliers d’utilisateurs dont seulement quelques-uns vont avoir la parole semble vain, mais surtout va mettre à mal votre infrastructure (aussi bien le réseau que vos serveurs).

Le principe est donc ici de mettre en place une conférence relativement classique via Jitsi et de la diffuser massivement via Peertube. On limite ainsi aussi bien la bande passante, vos serveurs, mais on peut aussi mettre en place un replay pour les personnes qui auraient raté la conférence.

2. Jitsi c’est quoi ?

Jitsi est une solution Open Source de conférence, incluant audio et vidéo.

Pour faire court, c’est une alternative à d’autres solutions de conférence propriétaires comme Zoom. Elle va donc vous permettre de mettre en place des conférences privées ou publiques. Pour installer Jitsi, je vous conseille de suivre ce lien : Guide de démarrage

3. Peertube c’est quoi ?

Peertube est une solution Open Source d’hébergement et de diffusion de vidéo, un peu comme Youtube mais avec quelques fonctionnalités intéressantes, comme la fédération (le fait de pouvoir distribuer des vidéos sur différentes instances de Peertube, une sorte de redondance des vidéos si on veut), le partage de la bande passante entre clients via Peer to Peer, etc.

Cet outil va donc vous permettre d’héberger vos vidéos, mais ici surtout elle vous permettra de diffuser en direct (ou streamer) du contenu au plus grand nombre.

Pour installer Peertube, je vous conseille le lien suivant : Guide d’installation

4. La mise en place

Avant de pouvoir diffuser vos conférences Jitsi, il vous faudra installer différents éléments comme Jibri, Jicofo, Chromium, FFmpeg, Java8, … Voyons ensemble comment les mettre en place.

Configurer Jitsi et permettre à Jibri de se connecter et “participer” aux conférences vidéos

Quelques définitions:

  • Prosody - serveur XMPP qui permet à tous les composants de se connecter les uns aux autres : web, jicofo, jvb et tous les autres composants
  • Jicofo - service qui s’occupe de répartir les processus entre les participants à la conférence et le bridge video
  • Jitsi (ou Jitsi Meet) - service maître, visible, qui affiche les fonctionnalités à l’écran

Configurer Prosody

nano /etc/prosody/prosody.cfg.lua

Enlever les commentaires dans la section “conference”

---Set up a MUC (multi-user chat) room server on conference.example.com:
Component "conference.jitsi.example.com" "muc"
--- Store MUC messages in an archive and allow users to access it
modules_enabled = { "muc_mam" }

Créer une entrée dans le composant MCU interne. Indispensable pour que Jicofo puisse trouver des clients Jibri sur une MCU qui n’est pas accessible en externe.

Créez une entrée dans votre vhost pour le compte de session chrome de Jibri

A ajouter donc pour se “logger” sur le serveur jitsi

nano /etc/prosody/conf.avail/meet.worteks.com.cfg.lua

A la fin du fichier

-- internal muc component, meant to enable pools of jibri and jigasi clients
Component "internal.auth.meet.worteks.com" "muc"
    modules_enabled = {
	    "ping";
    }
    storage = "memory"
    muc_room_cache_size = 1000

VirtualHost "recorder.meet.worteks.com"
    modules_enabled = {
        "ping";
    }
    authentication = "internal_plain"

Recharger Prosody

systemctl reload prosody

Et on ajoute deux comptes sur Jibri (un pour le contrôle et un pour l’enregistrement)

prosodyctl register jibri auth.meet.worteks.com JibrisPass
prosodyctl register recorder recorder.meet.Worteks.com RecordersPass

Configurer Jicofo

Faire pointer le MCU vers les controllers Jibri

nano /etc/jitsi/jicofo/sip-communicator.properties

Ajouter ces deux lignes pour la salle de contrôle Jibri et le timeout

org.jitsi.jicofo.jibri.BREWERY=JibriBrewery@internal.auth.meet.worteks.com
org.jitsi.jicofo.jibri.PENDING_TIMEOUT=90

On recharge Jicofo

systemctl reload Jicofo

Configurer Jitsi Meet

S’assurer qu’il existe un bouton pour enregistrer et diffuser dans la configuration

nano /etc/jitsi/meet/meet.worteks.com-config.js

Utiliser les adresses ip plus que les noms de domaines pour la connection Bosh

Configuration par défaut avec nom de domaine

bosh: '//meet.worteks.com/http-bind'

Changé en

bosh: '//192.168.10.10/http-bind'

Et ajouter les propriétés suivantes

fileRecordingsEnabled: true, // If you want to enable file recording
liveStreamingEnabled: true, // If you want to enable live streaming
hiddenDomain: 'recorder.meet.worteks.com',

Installer Jibri

Pré-requis

ALSA et LoopBack Device

  • Assurez vous que le module Loopback Device est disponible. Ces modules peuvent être installés sur une Ubuntu 20.04 en utilisant le nom de paquet linux-image-extra-virtual
  • Faites les tâches suivantes en tant que root:
    • mettre le module au démarrage echo "snd-aloop" >> /etc/modules
    • charger le module dans le kernel modprobe snd-aloop
    • vérifier que le module est déjà chargé lsmod | grep snd_aloop
  • Si la sortie montre que le module snd_aloop est chargé, la configuration est finie.

FFmpeg et le support de X11 capture

Jibri requiert une version relativement moderne de FFmpeg avec le support x11 compilé dedans. Ceci est fait par défaut sur Ubuntu 16.04/18.04/20.04 en installant le package ffmpeg. Pour les versions précédentes c’est un peu plus complexe (et on n’abordera pas le sujet ici).

Autres paquets

sudo apt-get install wget gnupg software-properties-common default-jre-headless  curl alsa-utils icewm xdotool xserver-xorg-input-void xserver-xorg-video-dummy

Installer Google Chrome

curl -o - https://dl-ssl.google.com/linux/linux_signing_key.pub | apt-key add
echo "deb [arch=amd64] http://dl.google.com/linux/chrome/deb/ stable main" > /etc/apt/sources.list.d/google-chrome.list
apt update
apt install google-chrome-stable

Installer Chrome Driver

CHROME_DRIVER_VERSION=`curl -sS chromedriver.storage.googleapis.com/LATEST_RELEASE`
wget -N http://chromedriver.storage.googleapis.com/$CHROME_DRIVER_VERSION/chromedriver_linux64.zip -P ~/
unzip ~/chromedriver_linux64.zip -d ~/
rm ~/chromedriver_linux64.zip
sudo mv -f ~/chromedriver /usr/local/bin/chromedriver
sudo chmod 0755 /usr/local/bin/chromedriver

Enlever les alertes de contrôle de script dans Chrome

mkdir -p /etc/opt/chrome/policies/managed

echo '{ "CommandLineFlagSecurityWarningsEnabled": false }' >>/etc/opt/chrome/policies/managed/managed_policies.json

Installer Jibri (enfin !)

Il s’installe sur le même serveur que Jitsi

sudo apt-get install jibri

Ajouter Jibri dans les bons groupes

sudo usermod -aG adm,audio,video,plugdev jibri

Configurer Jibri

Nous allons installer les paquets nécessaires depuis le repository par défaut des Debian 10. Nous allons configurer l’environnement XMPP et l’endroit où vont être stockés les enregistrements

On ouvre donc le fichier de configuration

nano /etc/jitsi/jibri/config.json

Avec les options suivantes

{
    "recording_directory":"/srv/recordings",
    "finalize_recording_script_path": "/path/to/finalize_recording.sh",
    "xmpp_environments": [
        {
            "name": "prod environment",
            "xmpp_server_hosts": [
                "meet.worteks.com"
            ],
            "xmpp_domain": "meet.worteks.com",
            "control_login": {
                // The domain to use for logging in
                "domain": "auth.meet.worteks.com",
                // The credentials for logging in
                "username": "jibri",
                "password": "JibrisPass"
            },
            "control_muc": {
                "domain": "internal.auth.meet.worteks.com",
                "room_name": "JibriBrewery",
                "nickname": "jibri-nickname"
            },
            "call_login": {
                "domain": "recorder.meet.worteks.com",
                "username": "recorder",
                "password": "RecordersPass"
            },
            "room_jid_domain_string_to_strip_from_start": "conference.",
            "usage_timeout": "0"
        }
    ]
}

Code Jibri (disponible ici)

/src/main/kotlin/org/jitsi/jibri/selenium/JibriSelenium.kt

Changer le code pour accepter des certificats non sécurisés ou auto-signés

chromeOptions.addArguments("--ignore-certificate-errors")

chromeOptions.setAcceptInsecureCerts(true)

URL RTMP

src/main/kotlin/org/jitsi/jibri/service/impl/StreamingJibriService.kt

const val YOUTUBE_URL = "rtmp://zb01.lmt.glcx.cnpc:1935/myapp"

On compile le code de Jibri

mvn package -DskipTests

Après sa compilation on remplace l’ancien fichier jar par le nouveau

sudo /opt/jibri/target/jibri-8.0-Snapshot-with-dependies.jar /opt/jitsi/jibri

On recharge Jibri

systemctl reload jibri

On crée le répertoire pour les enregistrements et on lui donne les droits

mkdir /recordings
chown jibri:jibri /recordings

Installer Java 8 et configuration par défaut pour Jibri

Installer Java 8

wget -O - https://adoptopenjdk.jfrog.io/adoptopenjdk/api/gpg/key/public | sudo apt-key add -
add-apt-repository https://adoptopenjdk.jfrog.io/adoptopenjdk/deb/
apt update
apt install adoptopenjdk-8-hotspot

Ouvrir launch.sh

nano /opt/jitsi/jibri/launch.sh

Mettre Java8 par défaut pour Jibri au lieu de du java par défaut, remplacer le mot “java” par le chemin vers Java 8

/usr/lib/jvm/adoptopenjdk-8-hotspot-amd64/bin/java

Redémarre tous les services, mettre dispo et démarrer Jibri

systemctl restart prosody
systemctl restart jicofo
systemctl restart jitsi-videobridge2
systemctl enable --now jibri

5. La diffusion

Maintenant que tout le setup un peu fastidieux a été fait, il est temps de mettre en place les éléments sur les deux logiciels utilisés, c’est à dire Jitsi pour la conférence et Peertube pour la diffusion.

Peertube

La première étape va être de mettre en place la session live, le streaming si vous voulez sur Peertube.

Cliquez sur “Publier” (le bouton en haut à droite) et sélectionnez la tabulation “aller au direct”

Création du direct Peertube

Sélectionnez les options appropriées et cliquez sur “Aller au direct”

Sur la page suivante, cliquez sur la tabulation “Paramètres du direct”

Paramètres du direct Peertube

Vous avez accès aux informations de diffusion, en particulier l’url RTMP du direct ainsi que la clef de diffusion qui vous seront utiles dans l’étape suivante, copiez ces données temporairement quelque part.

Jitsi Meet

Sur votre session Jitsi, créez une conférence, invitez les personnes dont vous avez besoin pour votre diffusion/conférence, réglez l’audio, la vidéo, toutes ces choses qui feront de votre conférence un intérêt pour le public.

Diffusion en direct Jitsi

Dans les options, une nouvelle option est apparue “Démarrer la diffusion en direct”

Diffusion en direct Jitsi

Vous pouvez rentrer vos informations l’url RTMP vers votre Peertube ainsi que la clef de diffusion

Concaténez votre URL comme rtmp://peertube.olicha:1935/live avec un slash / suivi de votre clef de diffusion

url et clef de diffusion

Cliquez sur “Démarrer la diffusion en direct” et voilà votre conférence est visible par tous

6. Et après?

Vous n’avez pas de Jitsi ou Peertube disponible et installé et cherchez une solution OpenSource pour diffuser au plus grand nombre ?

Il existe des alternatives comme BBB qui peuvent vous permettre de faire ça… mais ce sera pour un autre article !

🔲 ☆

Utiliser le logiciel Mailtrain pour ses campagnes de communication

Présentation

Chez Worteks, nous souhaitons utiliser le maximum de logiciel libre dans notre activité quotidienne, et nous cherchions un remplaçant à MailChimp avec lequel nous gérions nos envois de lettres d’informations jusque fin 2022. Après plusieurs recherches et essais, nous avons opté pour Mailtrain.

Logo Mailtrain

Mailtrain est un logiciel libre (licence GPL v3.0) permettant de gérer ses campagnes de communication par mail. Comme ses principaux concurrents il propose les fonctionnalités attendues de ce type d’outil :

  • Liste de contact avec possibilité d’inscription et de désinscription
  • Modèle de lettre (template)
  • Campagne d’envoi, avec statistiques de consultation des mails et des ouvertures des liens

Un des manques actuels est sans nul doute la documentation utilisateur : il faut consacrer un certain temps à la prise en main de l’interface avant de pouvoir réussir sa première campagne. Cet article sera une de nos façons de contribuer à réduire ce manque, nous espérons qu’il vous sera utile !

Installation

L’installation du logiciel est assez facile et bien documentée (voir le fichier README.md du dépôt du projet).

Il faut bien comprendre la logique des trois adresses d’accès à mettre en place :

  • trusted : Interface d’administration, pour la gestion des listes et des campagnes. Peut rester privé.
  • sandbox : Moteur de rendu des modèles et des lettres lors de leur conception. Peut rester privé.
  • public : Pages devant être accessibles à tous les contacts, pour la gestion des inscriptions, la vue des lettres hors client de messagerie et les différentes ressources incluses dans la lettre envoyée par mail. Cette adresse doit obligatoirement être publique.

Chez Worteks, nous avons déployé Mailtrain dans un conteneur sur notre Openshift et configuré notre reverse-proxy pour donner l’accès à l’adresse public. La version installée est la dernière version stable (Mailtrain v2 2021-06-09). Des améliorations ont été apportées depuis, dont le support de la langue française, mais il faudra donc attendre la prochaine version stable pour l’avoir (ou alors installer depuis les sources). Dans la suite de l’article, les captures d’écran sont en anglais pour cette raison.

Une fois le logiciel installé, vous pouvez accéder à l’adresse trusted et vous connecter :

Connexion à Mailtrain

Vous arriverez alors sur la page d’accueil :

Connecté Mailtrain

Nous n’aborderons pas ici les fonctions de gestion de l’authentification, des comptes utilisateurs et des profils associés.

Création d’un modèle

Cliquez sur Templates puis Create template :

Création d'un template

Plusieurs types de moteurs de templates sont disponibles, nous avons fait le choix de Code editor qui permet d’écrire le code HTML complet souhaité.

Une fois le modèle créé, on peut commencer à modifier son contenu :

Template créé

Là vos compétences en HTML sont requises, mais il est assez simple sinon d’utiliser un éditeur et récupérer le code HTML généré.

Il faut néanmoins connaître quelques astuces pour utiliser au maximum les capacités de l’outil, nous en présentons quelques-unes ci-dessous.

Gestion des images

Vous souhaiterez généralement inclure quelques images dans l’email envoyé, a minima le logo de votre entreprise.

Pour cela cliquez en haut à droite sur Files puis téléchargez depuis votre ordinateur les images que vous voulez utiliser :

Chargement d'un fichier

Vous verrez dans la colonne la plus à droite deux logos permettant de télécharger le fichier ou de le supprimer. Il faut copier le lien de téléchargement et utiliser ce lien dans le code HTML du mail pour voir l’image apparaître.

Lorsque le mail sera envoyé à vos contacts, le client de messagerie ira récupérer l’image sur votre serveur. Il est donc important que votre adresse public soit bien configurée !

Utilisation des tags

Dans la page d’édition du modèle, cliquez sur le bouton Merge tag reference, seront alors affichés les différents tags disponibles.

Il suffit d’utiliser ceux-ci dans votre code HTML.

Par exemple pour le lien de désinscription :

<a href="[LINK_UNSUBSCRIBE]">Se désinscrire</a>

Voici par exemple à quoi ressemble un de nos modèles :

Modèle Worteks

Création d’une liste

Une liste est une collection de contects auxquels vous allez envoyer vos communications. Vous pouvez créer plusieurs listes et même des segments sur une même liste mais nous n’aborderons pas la notion de segment ici.

Cliquez sur Lists puis Create List :

Création d'une liste

Les champs importants à compléter sont :

  • Name : nom de la liste.
  • Representation of subscriber’s name : utilisation d’un seul champ pour le nom de votre contact, ou deux champs (nom et prénom). Cela va dépendre des informations que vous utiliserez pour importer vos contacts.
  • Send configuration : configuration à utiliser pour l’envoi des mails.
  • Subscription : autoriser l’inscription via un formulaire web.
  • Unsubscription : méthode pour la désinscription (nombre et nature des étapes).

Une fois la liste créée, il faut y importer vos contacts. Pour cela le plus simple est d’avoir un export CSV de votre base de contact avec a minima le champ Email et les champ nom complet (ou les champs nom et prénom en fonction de ce que vous avez configuré dans la liste).

En haut à droite de votre liste, cliquez sur Imports puis Create Import :

Création d'un import

Mailtrain va analyser le fichier CSV et vous demander l’association des champs :

Mapping CSV

Il ne reste plus qu’à lancer l’import et vérifier son statut :

Statut d'un import

On peut effectuer plusieurs imports sur la même liste, seuls les nouveaux contacts seront ajoutés.

Création d’une campagne

À présent nous pouvons créer une campagne en cliquant sur Campains > Create Campaign > Regular :

Création d'une campagne

Vous devez sélectionner dans cet écran la liste des contacts précédemment créée, ainsi que le modèle à utiliser en choisissant l’option Custom content cloned from template, ce qui vous permettra compléter le contenu.

Renseignez bien “Subject” line qui correspond à l’objet du mail qui sera envoyé.

Cliquez sur Save and edit content pour finaliser le mail en éditant le contenu issu du template. Vous pourrez ici aussi ajouter des images et des tags, comme nous l’avons vu avec les templates.

Voici par exemple notre carte de vœux pour 2023 :

Campagne Worteks

Et voilà comment souhaiter une bonne année à tous ses contacts !

🔲 ☆

Sortie d’OpenLDAP 2.5.12 et 2.6.2

Logo OpenLDAP

Courant janvier 2022, un évènement important a ébranlé la communauté OpenLDAP : l’annonce d’une nouvelle politique de publication de version d’OpenLDAP.

En effet, celle-ci propose un développement en parallèle de deux versions différentes d’OpenLDAP :

  • la version LTS (Long Term Support), d’une durée de 5 ans environ, est axée sur la stabilité et la sécurité
  • la version orientée fonctionnalités, qui permet l’ajout de nouvelles fonctionnalités et l’amélioration des performances, au prix d’incompatibilités potentielles

La version LTS actuelle est la 2.5, tandis que la version orientée fonctionnalités est la 2.6.

Logo LTB

L’initiative LDAP Tool Box (LTB project) propose du contenu lié aux annuaires LDAP, et en particulier des paquets pour les principales distributions Linux.

Depuis l’abandon de la version 2.4 d’OpenLDAP, l’équipe LTB a travaillé à la publication des nouveaux paquets pour la version à long terme 2.5 (depuis la 2.5.7). Elle est fière aujourd’hui de vous présenter les toutes dernières versions d’OpenLDAP, incluant la version orientée fonctionnalités :

Des dépôts dédiés soit aux versions 2.5, soit aux versions 2.6 ont été créés afin d’éviter une mise à jour majeure intempestive, cette dernière imposant des adaptations.

Par exemple, pour debian 11, le dépôt pour OpenLDAP 2.5 est :

deb [arch=amd64] https://ltb-project.org/debian/openldap25/bullseye bullseye main

tandis que pour OpenLDAP 2.6, il s’agit de :

deb [arch=amd64] https://ltb-project.org/debian/openldap26/bullseye bullseye main

Les paquets LTB pour OpenLDAP 2.5 et 2.6 sont disponibles en téléchargement direct ou bien dans des dépôts APT et RPM dédiés :

Nouveautés d’OpenLDAP LTB 2.5.12

Les principaux changements dans les paquets OpenLDAP LTB 2.5.12 sont les suivants :

  • la nouvelle version 2.2 du module étendu de politique de mots de passe ppm a été intégrée. Celle-ci peut maintenant être compilée indifféremment sur OpenLDAP 2.5 ou 2.6. Cette nouvelle version implémente un maximum de caractères autorisés pour chaque classe, et corrige quelques bugs mineurs.
  • la nouvelle version 2.9 de slapd-cli a été intégrée. Celle-ci gère maintenant les deux versions d’OpenLDAP à travers une variable SLAPD_VERSION. Elle intègre des templates de configuration et des jeux de données de tests pour OpenLDAP 2.5 et 2.6. Ces jeux de données utilisent maintenant par défaut le module étendu de politique de mots de passe.
  • un problème de permissions sur les répertoires sbin et share a été corrigé

Nouveautés d’OpenLDAP LTB 2.6.2

Les principaux changements dans les paquets OpenLDAP LTB 2.6.2 sont les suivants :

  • l’overlay lastbind a été supprimé. Celui-ci permettait de se souvenir de la date de dernière authentification des utilisateurs. Cette fonctionnalité est maintenant gérée par la configuration standard d’OpenLDAP (voir les paramètres olcLastBind et olcLastBindPrecision)
  • le chemin du module étendu de politique de mots de passe n’est plus défini dans chaque politique, mais dans la configuration de l’overlay ppolicy (voir paramètre ppolicy_check_module). Chaque politique peut alors décider d’activer ou non ce module étendu avec l’attribut pwdUseCheckModule.
  • la configuration du module de répartition de charge lload a évolué et doit être mise à jour. Les backends sont maintenant groupés par “tiers” qui précisent la stratégie de répartition.
  • OpenLDAP LTB n’utilise plus rsyslog pour la gestion de logs, mais les nouvelles fonctionnalités offertes par OpenLDAP : olcLogFile, olcLogFileFormat, olcLogFileOnly et olcLogFileRotate (voir pages de manuel). Ce nouveau système de logs promet d’être plus efficace que les implémentations syslog.
  • toutes les modifications d’OpenLDAP LTB 2.5.12 sont intégrées.

N’hésitez pas à donner leur chance à ces nouvelles versions !

🔲 ☆

Tekton : Intégration et déploiement continus sur Kubernetes

Tekton est un framework natif Kubernetes complet, orienté intégration et déploiement continus, ayant fait son apparition au début de l’année 2019.

La communauté s’étant formée autour de Tekton regroupe des contributeurs de RedHat, Google, … tous les grands acteurs Kubernetes. Tekton est aujourd’hui disponible sur OpenShift 4, pouvant se substituer aux BuildConfig ou autres pipelines Jenkins.

Profitant de l’ajout récent du support ARM, depuis Tekton Pipeline v0.19.0 (9 décembre 2020), Tekton Triggers v0.10.0 (26 octobre 2020) et Tekton Dashboard v0.12.2 (15 décembre 2020), et donnant suite à notre article concernant le deploiement d’un cluster Kubernetes sur Raspberry Pi, ainsi que celui sur la configuration de volumes persistants et d’une registry, nous regarderons aujourd’hui comment assembler nos propres images sur Kubernetes.

Tekton Pipelines

Build d’Images Docker

À ce stade, nous pourrons tester l’exécution d’un pipeline. Pour cela, commençons par créer une tâche, décrivant l’assemblage d’une image :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Task
metadata:
  name: docker-build-kaniko
  namespace: ci
spec:
  params:
  - default: gcr.io/kaniko-project/executor:multi-arch-v1.3.0
    description: The location of the kaniko builder image.
    name: builderimage
    type: string
  - default: Dockerfile
    description: The name of the Dockerfile
    name: dockerfile
    type: string
  - default: .
    description: Parent directory for your Dockerfile.
    name: dockerroot
    type: string
  - default: ""
    description: Forces USER in Dockerfile - either a specific uid, or any string would translate to 1001
    name: forceuid
    type: string
  - default: ""
    description: Forces FROM in Dockerfile.
    name: fromimage
    type: string
  resources:
    inputs:
    - name: source
      type: git
    outputs:
    - name: image
      type: image
  steps:
  - command:
    - /bin/sh
    - -c
    - |
        if echo "$(inputs.params.fromimage)" | grep -E '/.*/' >/dev/null; then \
            sed -i "s|^[ ]*FROM[ ]*[^ ]*$|FROM $(inputs.params.fromimage)|" \
                 "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
        elif test "$(inputs.params.fromimage)"; then \
            sed -i "s|^[ ]*FROM[ ]*[^ ]*$|FROM registry.registry.svc.cluster.local:5000/ci/$(inputs.params.fromimage)|" \
                 "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
        fi; \
        if test "$(inputs.params.forceuid)" -a "$(inputs.params.forceuid)" -gt 0 >/dev/null 2>&1; then \
            if ! grep -E '^USER[ \t]*[0-9]' "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)" >/dev/null; then \
                echo USER $(inputs.params.forceuid) \
                    >>"$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
            fi; \
        elif test "$(inputs.params.forceuid)"; then \
            if ! grep -E '^USER[ \t]*[0-9]' "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)" >/dev/null; then \
                echo USER 1001 >>"$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
            fi; \
        fi
    image: docker.io/busybox:latest
    name: patch-from
    securityContext:
      privileged: true
    workingDir: /workspace/source
  - command:
    - /kaniko/executor
    - --skip-tls-verify-pull
    - --skip-tls-verify
    - "--build-arg=DO_UPGRADE=true"
    - "--build-arg=SRC_CLONE_PASS=$(inputs.params.clonepass)"
    - "--build-arg=SRC_CLONE_USER=$(inputs.params.cloneuser)"
    - --dockerfile=$(inputs.params.dockerroot)/$(inputs.params.dockerfile)
    - --context=dir:///workspace/source
    - --destination=$(outputs.resources.image.url)
    env:
    - name: DOCKER_CONFIG
      value: /builder/home/.docker
    image: $(inputs.params.builderimage)
    name: build-and-push
    securityContext:
      privileged: true
    workingDir: /workspace/source
EOF

Notons que nous avons ici choisi d’utiliser Kaniko, un projet publié par Google en 2018, permettant l’assemblage d’images de conteneur, depuis un autre conteneur.
Notons que d’autres implémentations existent, et nous pourrons notament citer BuildKit, Img, ou Buildah, fourni par RedHat, tout aussi capable que Kaniko, mais avec l’inconvénient de ne pas encore proposer d’image arm64.

À ce stade, bien que Kaniko ou Buildah prétendent assembler des images sans privilèges particuliers, notons que ce n’est pas vraiment le cas sur Kubernetes, ou il faudra toujours laisser ces conteneurs s’exécuter en tant que root. Pour cela, nous voudrons créer un ServiceAccount, et lui donner les privilèges nécessaires :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Pipeline
metadata:
  name: docker-build
  namespace: ci
spec:
  params:
  - default: Dockerfile
    name: dockerfile
    type: string
  - default: .
    name: dockerroot
    type: string
  - default: ""
    description: Forces FROM in Dockerfile.
    name: fromimage
    type: string
  resources:
  - name: app-git
    type: git
  - name: app-image
    type: image
  tasks:
  - name: build
    params:
    - name: dockerfile
      value: $(params.dockerfile)
    - name: dockerroot
      value: $(params.dockerroot)
    - name: fromimage
      value: $(params.fromimage)
    - name: tlsverify
      value: "false"
    resources:
      inputs:
      - name: source
        resource: app-git
      outputs:
      - name: image
        resource: app-image
    taskRef:
      kind: Task
      name: docker-build-kaniko
EOF

Pipelines et Tasks ont pour vocation à être réutilisés. Ils seront contextualisés, à l’aide de paramètres tels que dépôts git ou registry, que nous définirons de la manière suivante :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: tekton.dev/v1alpha1
kind: PipelineResource
metadata:
  name: registry-exporter-git
  namespace: ci
spec:
  params:
  - name: url
    value: https://gitlab.com/Worteks/docker-registry-exporter
  - name: revision
    value: master
  type: git
---
apiVersion: tekton.dev/v1alpha1
kind: PipelineResource
metadata:
  name: registry-exporter-image
  namespace: ci
spec:
  params:
  - name: url
    value: registry.registry.svc.cluster.local:5000/ci/registry-exporter:master
  type: image
EOF

Enfin, l’exécution d’un job se déclanchera avec la création d’un PipelineRun, tel que le suivant :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: PipelineRun
metadata:
  name: registry-exporter-1
  namespace: ci
spec:
  pipelineRef:
    name: docker-build
  resources:
  - name: app-git
    resourceRef:
      name: registry-exporter-git
  - name: app-image
    resourceRef:
      name: registry-exporter-image
  serviceAccountName: tkn-ci
  timeout: 30m0s
EOF

Nous pourrons suivre l’exécution de notre pipeline :

$ kubectl  get pods -n ci
NAME                                        READY   STATUS            RESTARTS   AGE
registry-exporter-1-build-gc7k8-pod-sp6qh   0/5     PodInitializing   0          19s
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh
error: a container name must be specified for pod registry-exporter-1-build-gc7k8-pod-sp6qh, choose one of: [step-create-dir-image-wql9r step-git-source-source-2jpbq step-patch-from step-build step-image-digest-exporter-kzr5b] or one of the init containers: [working-dir-initializer place-tools]
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
Error from server (BadRequest): container "step-git-source-source-2jpbq" in pod "registry-exporter-1-build-gc7k8-pod-sp6qh" is waiting to start: PodInitializing
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-create-dir-image-wql9r
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
{"level":"info","ts":1610369828.8041682,"caller":"git/git.go:165","msg":"Successfully cloned https://github.com/Worteks/docker-registry-exporter @ 0388c04686d4aaaddd28c747a66dd3f362b35428 (grafted, HEAD, origin/fix-docker-build) in path /workspace/source"}
{"level":"info","ts":1610369828.899402,"caller":"git/git.go:203","msg":"Successfully initialized and updated submodules in path /workspace/source"}
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
{"level":"info","ts":1610369828.8041682,"caller":"git/git.go:165","msg":"Successfully cloned https://github.com/Worteks/docker-registry-exporter @ 0388c04686d4aaaddd28c747a66dd3f362b35428 (grafted, HEAD, origin/fix-docker-build) in path /workspace/source"}
{"level":"info","ts":1610369828.899402,"caller":"git/git.go:203","msg":"Successfully initialized and updated submodules in path /workspace/source"}
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
E0109 13:04:30.159776      14 aws_credentials.go:77] while getting AWS credentials NoCredentialProviders: no valid providers in chain. Deprecated.
For verbose messaging see aws.Config.CredentialsChainVerboseErrors
INFO[0007] Resolved base name python:3.7-alpine to base
INFO[0007] Retrieving image manifest python:3.7-alpine
INFO[0007] Retrieving image python:3.7-alpine
INFO[0009] Retrieving image manifest python:3.7-alpine
INFO[0009] Retrieving image python:3.7-alpine
INFO[0010] Retrieving image manifest python:3.7-alpine
INFO[0010] Retrieving image python:3.7-alpine
INFO[0011] Retrieving image manifest python:3.7-alpine
INFO[0011] Retrieving image python:3.7-alpine
INFO[0012] Built cross stage deps: map[0:[/install]]
INFO[0012] Retrieving image manifest python:3.7-alpine
INFO[0012] Retrieving image python:3.7-alpine
INFO[0014] Retrieving image manifest python:3.7-alpine
INFO[0014] Retrieving image python:3.7-alpine
INFO[0016] Executing 0 build triggers
INFO[0016] Unpacking rootfs as cmd RUN  apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev requires it.
INFO[0019] RUN  apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev
INFO[0019] Taking snapshot of full filesystem...
INFO[0022] cmd: /bin/sh
INFO[0022] args: [-c apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev]
INFO[0022] Running: [/bin/sh -c apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev]
fetch http://dl-cdn.alpinelinux.org/alpine/v3.12/main/aarch64/APKINDEX.tar.gz
fetch http://dl-cdn.alpinelinux.org/alpine/v3.12/community/aarch64/APKINDEX.tar.gz
(1/24) Installing m4 (1.4.18-r1)
(2/24) Installing perl (5.30.3-r0)
(3/24) Installing autoconf (2.69-r2)
(4/24) Installing automake (1.16.2-r0)
(5/24) Installing libgcc (9.3.0-r2)
(6/24) Installing libstdc++ (9.3.0-r2)
(7/24) Installing binutils (2.34-r1)
(8/24) Installing gmp (6.2.0-r0)
(9/24) Installing isl (0.18-r0)
(10/24) Installing libgomp (9.3.0-r2)
(11/24) Installing libatomic (9.3.0-r2)
(12/24) Installing libgphobos (9.3.0-r2)
(13/24) Installing mpfr4 (4.0.2-r4)
(14/24) Installing mpc1 (1.1.0-r1)
(15/24) Installing gcc (9.3.0-r2)
(16/24) Installing musl-dev (1.1.24-r10)
(17/24) Installing libc-dev (0.7.2-r3)
(18/24) Installing g++ (9.3.0-r2)
(19/24) Installing linux-headers (5.4.5-r1)
(20/24) Installing make (4.3-r0)
(21/24) Installing pkgconf (1.7.2-r0)
(22/24) Installing openssl-dev (1.1.1i-r0)
(23/24) Installing zlib-dev (1.2.11-r3)
(24/24) Installing build-dependencies (20210109.130446)
Executing busybox-1.31.1-r19.trigger
OK: 238 MiB in 59 packages
INFO[0029] Taking snapshot of full filesystem...
INFO[0057] RUN mkdir /install
INFO[0057] cmd: /bin/sh
INFO[0057] args: [-c mkdir /install]
INFO[0057] Running: [/bin/sh -c mkdir /install]
INFO[0057] Taking snapshot of full filesystem...
INFO[0065] WORKDIR /install
INFO[0065] cmd: workdir
INFO[0065] Changed working directory to /install
INFO[0065] No files changed in this command, skipping snapshotting.
INFO[0065] COPY requirements.txt /requirements.txt
INFO[0065] Taking snapshot of files...
INFO[0065] RUN pip install --prefix=/install -r /requirements.txt
INFO[0065] cmd: /bin/sh
INFO[0065] args: [-c pip install --prefix=/install -r /requirements.txt]
INFO[0065] Running: [/bin/sh -c pip install --prefix=/install -r /requirements.txt]
Collecting prometheus_client==0.4.2
  Downloading prometheus_client-0.4.2.tar.gz (29 kB)
Collecting Twisted==19.7.0
  Downloading Twisted-19.7.0.tar.bz2 (3.1 MB)
Collecting attrs>=17.4.0
  Downloading attrs-20.3.0-py2.py3-none-any.whl (49 kB)
Collecting Automat>=0.3.0
  Downloading Automat-20.2.0-py2.py3-none-any.whl (31 kB)
Collecting constantly>=15.1
  Downloading constantly-15.1.0-py2.py3-none-any.whl (7.9 kB)
Collecting hyperlink>=17.1.1
  Downloading hyperlink-21.0.0-py2.py3-none-any.whl (74 kB)
Collecting idna>=2.5
  Downloading idna-3.1-py3-none-any.whl (58 kB)
Collecting incremental>=16.10.1
  Using cached incremental-17.5.0-py2.py3-none-any.whl (16 kB)
Collecting PyHamcrest>=1.9.0
  Downloading PyHamcrest-2.0.2-py3-none-any.whl (52 kB)
Collecting zope.interface>=4.4.2
  Downloading zope.interface-5.2.0.tar.gz (227 kB)
Requirement already satisfied: setuptools in /usr/local/lib/python3.7/site-packages (from zope.interface>=4.4.2->Twisted==19.7.0->-r /requirements.txt (line 1)) (51.0.0)
Collecting six
  Downloading six-1.15.0-py2.py3-none-any.whl (10 kB)
Building wheels for collected packages: prometheus-client, Twisted, zope.interface
  Building wheel for prometheus-client (setup.py): started
  Building wheel for prometheus-client (setup.py): finished with status 'done'
  Created wheel for prometheus-client: filename=prometheus_client-0.4.2-py3-none-any.whl size=35285 sha256=f3149f489ce679d5ea7c70a06d2f14b35705b5d2b20ce36f4698eff88e0a1b2e
  Stored in directory: /root/.cache/pip/wheels/4e/be/ec/c91dde5309bc0e660bda4735162575e19e238983dd64c60bc9
  Building wheel for Twisted (setup.py): started
  Building wheel for Twisted (setup.py): finished with status 'done'
  Created wheel for Twisted: filename=Twisted-19.7.0-cp37-cp37m-linux_aarch64.whl size=3034359 sha256=fdacf8565c06b15cae0bb42d01102a0296feb678c4eb870c917c6aca3ae01025
  Stored in directory: /root/.cache/pip/wheels/bc/28/f9/e991f24acf0acd2ed39e7733413e85745ee998f843a311a8f6
  Building wheel for zope.interface (setup.py): started
  Building wheel for zope.interface (setup.py): finished with status 'done'
  Created wheel for zope.interface: filename=zope.interface-5.2.0-cp37-cp37m-linux_aarch64.whl size=195430 sha256=f22cc40da76c4591fd2e38874ba8d4278d809fd6be6ac4d43032c750b5106881
  Stored in directory: /root/.cache/pip/wheels/27/57/14/5b2a6cd8b6869470681f04a8ce56aeb6cba0cd534598730527
Successfully built prometheus-client Twisted zope.interface
Installing collected packages: six, idna, attrs, zope.interface, PyHamcrest, incremental, hyperlink, constantly, Automat, Twisted, prometheus-client
  WARNING: The script automat-visualize is installed in '/install/bin' which is not on PATH.
  Consider adding this directory to PATH or, if you prefer to suppress this warning, use --no-warn-script-location.
  WARNING: The scripts cftp, ckeygen, conch, mailmail, pyhtmlizer, tkconch, trial, twist and twistd are installed in '/install/bin' which is not on PATH.
  Consider adding this directory to PATH or, if you prefer to suppress this warning, use --no-warn-script-location.
Successfully installed Automat-20.2.0 PyHamcrest-2.0.2 Twisted-19.7.0 attrs-20.3.0 constantly-15.1.0 hyperlink-21.0.0 idna-3.1 incremental-17.5.0 prometheus-client-0.4.2 six-1.15.0 zope.interface-5.2.0
INFO[0113] Taking snapshot of full filesystem...
INFO[0120] Saving file install for later use
INFO[0121] Deleting filesystem...
INFO[0123] Retrieving image manifest python:3.7-alpine
INFO[0123] Retrieving image python:3.7-alpine
INFO[0124] Retrieving image manifest python:3.7-alpine
INFO[0124] Retrieving image python:3.7-alpine
INFO[0125] Executing 0 build triggers
INFO[0125] Unpacking rootfs as cmd COPY --from=base /install /usr/local requires it.
INFO[0129] COPY --from=base /install /usr/local
INFO[0130] Taking snapshot of files...
INFO[0133] COPY exporter /exporter
INFO[0133] Taking snapshot of files...
INFO[0133] WORKDIR /exporter
INFO[0133] cmd: workdir
INFO[0133] Changed working directory to /exporter
INFO[0133] No files changed in this command, skipping snapshotting.
INFO[0133] ENTRYPOINT ["python", "/exporter/exporter.py"]
INFO[0133] USER 1001
INFO[0133] cmd: USER

Build de Paquets

Tekton n’est pas limité à l’assemblage d’images Docker. Nous pourrions l’utiliser pour toute sorte de scripts. Prenons l’exemple d’un paquet Debian, pour OpenLDAP LTB. Il nous faut une ressource de type Git, d’ou l’on va télécharger l’arboresence nécessaire à la généreration de nos paquets :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1alpha1
kind: PipelineResource
metadata:
  name: openldap-ltb-deb
  namespace: ci
spec:
  params:
  - name: url
    value: https://github.com/ltb-project/openldap-deb
  - name: revision
    value: master
  type: git
EOF

Il nous faut ensuite une Task, décrivant comment assembler nos paquets, depuis ce dépôt. Une fois les paquets générés, il faudra les envoyer vers un dépôt : nous utiliserons un serveur Nexus, sur lequel nous avons au préalable un dépôt APT de type Hosted. Disposant d’un compte de service permettant l’ajout d’objets à ce dépôt Nexus APT, nous pourrons créer la Task suivante :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Task
metadata:
  name: deb-build-ltb-openldap
  namespace: ci
spec:
  params:
  - default: https://nexus.example.com
    description: Nexus Repository Address
    name: nexusaddress
    type: string
  - default: admin
    description: Nexus Repository Username
    name: nexususer
    type: string
  - default: secret
    description: Nexus Repository Password
    name: nexussecret
    type: string
  - default: apt-ltb
    description: OpenLDAP LTB Nexus Repository Name
    name: nexusrepo
    type: string
  - default: 2.4.56
    description: OpenLDAP Version to Build
    name: ldapversion
    type: string
  resources:
    inputs:
    - name: source
      type: git
  steps:
  - command:
    - /bin/sh
    - -c
    - |
    set -x; \
        export DEBIAN_FRONTEND=noninteractive; \
        MYARCH=`uname -m`; \
        test "$MYARCH" = aarch64 && MYARCH=arm64; \
        apt-get update \
        && apt-get install -y wget tar build-essential autoconf automake autotools-dev debhelper dh-make \
            devscripts fakeroot file gnupg git lintian patch patchutils pbuilder libsodium23 libsodium-dev \
            libltdl7 libltdl-dev libsasl2-2 libsasl2-dev zlib1g zlib1g-dev openssl libssl-dev mime-support \
            mawk libcrack2-dev libwrap0-dev curl \
        && cd debian/paquet-berkeleydb-debian \
        && tar -xvzf db-4.6.21.NC.tar.gz \
        && cp -r db-4.6.21.NC/* berkeleydb-ltb-4.6.21.NC \
        && tar -czf berkeleydb-ltb_4.6.21.NC-4.orig.tar.gz berkeleydb-ltb-4.6.21.NC \
        && cd berkeleydb-ltb-4.6.21.NC/ \
        && dpkg-buildpackage -us -uc \
        && dpkg -i ../berkeleydb-ltb_4.6.21.NC-4-patch4_$MYARCH.deb \
        && cd ../../paquet-openldap-debian \
        && wget ftp://ftp.openldap.org/pub/OpenLDAP/openldap-release/openldap-$(inputs.params.ldapversion).tgz \
        && tar -xvzf openldap-$(inputs.params.ldapversion).tgz \
        && cp -r openldap-$(inputs.params.ldapversion)/* openldap-ltb-$(inputs.params.ldapversion)/ \
        && tar -czf openldap-ltb-$(inputs.params.ldapversion).orig.tar.gz \
            openldap-ltb-$(inputs.params.ldapversion) \
        && cd openldap-ltb-$(inputs.params.ldapversion) \
        && dpkg-buildpackage -us -uc \
        && dpkg -i ../openldap-ltb_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-explockout_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-mdb-utils_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-ppm_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-check-password_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-dbg_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-contrib-overlays_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && cd ../../ \
        && ls -l paquet-* \
        && for f in paquet-berkeleydb-debian/berkeleydb-ltb_4.6.21.NC-4-patch4_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-explockout_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-mdb-utils_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-ppm_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-check-password_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-dbg_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-contrib-overlays_$(inputs.params.ldapversion).1_$MYARCH.deb; \
        do \
            curl -u "$(inputs.params.nexususer):$(inputs.params.nexussecret)" \
                -k -X POST -H "Content-Type: multipart/form-data" --data-binary "@$f" \
                "$(inputs.params.nexusaddress)/repository/$(inputs.params.nexusrepo)/"; \
        done
    image: docker.io/debian:buster
    name: build
    securityContext:
      privileged: true
    workingDir: /workspace/source
EOF

Déclarer un Pipeline, liant la ressource Git à notre Task :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Pipeline
metadata:
  name: build-ltb-openldap
  namespace: ci
spec:
  params:
  - default: 2.4.56
    description: OpenLDAP Version to Build
    name: ldapversion
    type: string
  resources:
  - name: app-git
    type: git
  tasks:
  - name: build
    params:
    - name: ldapversion
      value: $(params.ldapversion)
    resources:
      inputs:
      - name: source
        resource: app-git
    taskRef:
      kind: Task
      name: deb-build-ltb-openldap
EOF

Et lancer un job, en créant le PipelineRun suivant :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: PipelineRun
metadata:
  name: ltb-openldap-1
  namespace: ci
spec:
  pipelineRef:
    name: build-ltb-openldap
  resources:
  - name: app-git
    resourceRef:
      name: openldap-ltb-deb
  serviceAccountName: tkn-ci
  timeout: 2h0m0s
EOF

Nous pourrons suivre l’exécution du job, qui assemblera une suite de paquets, les installera en local, et si tout s’est bien passé : poussera les archives debian générées vers notre dépôt Nexus.

$ kubectl logs -n ci -c step-build ltb-openldap-1-build-7npcv-pod-mp28x
+ export DEBIAN_FRONTEND=noninteractive
+ uname -m
+ MYARCH=aarch64
+ test aarch64 = aarch64
+ MYARCH=arm64
+ apt-get update
Get:1 http://security.debian.org/debian-security buster/updates InRelease [65.4 kB]
Get:2 http://deb.debian.org/debian buster InRelease [121 kB]
Get:3 http://deb.debian.org/debian buster-updates InRelease [51.9 kB]
Get:4 http://security.debian.org/debian-security buster/updates/main arm64 Packages [254 kB]
Get:5 http://deb.debian.org/debian buster/main arm64 Packages [7737 kB]
Get:6 http://deb.debian.org/debian buster-updates/main arm64 Packages [7848 B]
Fetched 8238 kB in 4s (2346 kB/s)
Reading package lists...
+ apt-get install -y wget tar
...
+ curl -u XXX:YYY -k -X POST -H Content-Type: multipart/form-data --data-binary @paquet-openldap-debian/openldap-ltb-dbg_2.4.56.1_arm64.deb https://nexus.example.com/repository/apt-ltb/
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100 3978k    0     0  100 3978k      0   791k  0:00:05  0:00:05 --:--:--     0
+ curl -u XXX:YYY -k -X POST -H Content-Type: multipart/form-data --data-binary @paquet-openldap-debian/openldap-ltb-contrib-overlays_2.4.56.1_arm64.deb https://nexus.example.com/repository/apt-ltb/
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100  333k    0     0  100  333k      0  61846  0:00:05  0:00:05 --:--:--     0

Et depuis notre dépôt Nexus, nous pourrons confirmer que nos paquets sont maintenant disponibles :

Tekton Nexus

De la même façon, nous pourrions exécuter des tests unitaires, scanner notre code ou image, lancer un déploiement utilisant nos derniers montages pour y exécuter des tests d’intégration, … Automatiser les différentes étapes d’une chaine d’intégration et déploiements continue devient un jeu d’enfant. Vous retrouverez une suite d’exemples, sur le dépôt GitHub Catalog, du projet Tekton.

Tekton Triggers

Jusque la, nous avons vu comment exécuter nos jobs, mais dans le contexte d’une chaine d’intégration et déploiements continus, il nous faut maintenant traiter la réception d’évenements.

Tekton Triggers est une composante optionelle, ajoutant de nouveaux types d’objets au cluster, en vue de réceptionner et traiter des notifications http, par exemple pour programmer l’exécution d’un pipeline suite au push d’une modification sur un dépôt git.

Nous déploierons la dernière version depuis GitHub :

$ kubectl apply -f https://storage.googleapis.com/tekton-releases/triggers/previous/v0.10.2/release.yaml
$ kubectl get pods -n tekton-pipelines
NAME                                           READY   STATUS    RESTARTS   AGE
tekton-pipelines-controller-5cdb46974f-fzfdh   1/1     Running   0          25m
tekton-pipelines-webhook-6479d769ff-wxbxr      1/1     Running   0          25m
tekton-triggers-controller-5994f6c94b-fw2dm    1/1     Running   0          1m
tekton-triggers-webhook-68c7866d8-zdttm        1/1     Running   0          1m

Nous pouvons maintenant configurer un premier Event Listener.

L’Event Listener interroge l’API du cluster Kubernetes, il faudra avant tout lui créer un ServiceAccount, auquel on déleguera les privilèges necessaires :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: tkn-triggers-ci
  namespace: ci
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: tekton-triggers
  namespace: ci
rules:
- apiGroups: ["triggers.tekton.dev"]
  resources: ["eventlisteners", "triggerbindings", "triggertemplates", "triggers"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["configmaps", "secrets"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["tekton.dev"]
  resources: ["pipelineruns", "pipelineresources", "taskruns"]
  verbs: ["create"]
- apiGroups: [""]
  resources: ["serviceaccounts"]
  verbs: ["impersonate"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: tekton-triggers
  namespace: ci
subjects:
- kind: ServiceAccount
  name: tkn-triggers-ci
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: tekton-triggers
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: tekton-triggers
rules:
- apiGroups: ["triggers.tekton.dev"]
  resources: ["clustertriggerbindings"]
  verbs: ["get", "list", "watch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: tekton-triggers-ci
subjects:
- kind: ServiceAccount
  name: tkn-triggers-ci
  namespace: ci
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: tekton-triggers
EOF

Notre Event Listener doit traiter des notifications en provenance de GitHub. Nous allons donc créer un TriggerBinding, associant les champs de l’objet JSON envoyé par GitHub, aux variables que l’on souhaite réutiliser dans la programmation de notre job :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: triggers.tekton.dev/v1alpha1
kind: TriggerBinding
metadata:
  name: github-pr-binding
  namespace: ci
spec:
  params:
  - name: gitrevision
    value: $(body.pull_request.head.sha)
  - name: gitrepositoryname
    value: $(body.repository.name)
  - name: gitrepositoryurl
    value: $(body.repository.clone_url)
---
apiVersion: triggers.tekton.dev/v1alpha1
kind: TriggerBinding
metadata:
  name: github-push-binding
  namespace: ci
spec:
  params:
  - name: gitrevision
    value: $(body.after)
  - name: gitrepositoryname
    value: $(body.repository.name)
  - name: gitrepositoryurl
    value: $(body.repository.clone_url)
EOF

Nous allons ensuite créer un TriggerTemplate, décrivant que faire lorsqu’une notification est reçue. Dans notre cas, fonction des variables extraites par notre TriggerBinding, nous voudrons créer un PipelineRun, dont les ressources Git et Image seront deduites de la notification reçue:

$ cat <<EOF | kubectl apply -f-
apiVersion: triggers.tekton.dev/v1alpha1
kind: TriggerTemplate
metadata:
  name: github-pipelinerun-template
  namespace: ci
spec:
  params:
  - name: gitrevision
  - name: gitrepositoryname
  - name: gitrepositoryurl
  resourcetemplates:
  - apiVersion: tekton.dev/v1beta1
    kind: PipelineRun
    metadata:
      generateName: github-job-
    spec:
      pipelineRef:
        name: docker-build
      resources:
      - name: app-git
        resourceSpec:
          type: git
          params:
          - name: revision
            value: $(tt.params.gitrevision)
          - name: url
            value: $(tt.params.gitrepositoryurl)
      - name: app-image
        resourceSpec:
          type: image
          params:
          - name: url
            value: registry.registry.svc.cluster.local:5000/ci/$(tt.params.gitrepositoryname):$(tt.params.gitrevision)
      serviceAccountName: tkn-ci
      timeout: 1h0m0s
EOF

Enfin, nous allons créer un Secret, dans lequel conserver un token que l’on configurera par la suite, dans notre WebHook GitHub, un EventListener décrivant sous quelles conditions notifier notre TriggerBinding, et un Ingress, exposant l’Event Listener :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: Secret
metadata:
  name: github-secret
  namespace: ci
stringData:
  secretToken: changeme
type: Opaque
---
apiVersion: triggers.tekton.dev/v1alpha1
kind: EventListener
metadata:
  name: github-listener
  namespace: ci
spec:
  serviceAccountName: tkn-triggers-ci
  triggers:
  - name: github-pr-listener
    interceptors:
      - github:
          secretRef:
            secretName: github-secret
            secretKey: secretToken
          eventTypes:
          - pull_request
    bindings:
    - ref: github-pr-binding
    template:
      ref: github-pipelinerun-template
  - name: github-push-listener
    interceptors:
      - github:
          secretRef:
            secretName: github-secret
            secretKey: secretToken
          eventTypes:
          - push
    bindings:
    - ref: github-push-binding
    template:
      ref: github-pipelinerun-template
---
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  annotations:
  name: github-eventlistener
  namespace: ci
spec:
  rules:
  - host: git-ci-el.router.example.com
    http:
      paths:
      - backend:
          serviceName: el-github-listener
          servicePort: 8080
EOF

La création d’un EventListener aura demarré un nouveau Pod, en charge de receptionner et traiter les notifications :

# kubectl get pods -n ci
NAME                                               READY   STATUS      RESTARTS   AGE
...
el-github-listener-657bd5b5d8-9rgwx                1/1     Running     0          2m

Confirmer, depuis un navigateur, que l’addresse https://git-ci-el.router.example, définie dans notre Ingress, est bien joignable en dehors du cluster. Rendons-nous ensuite sur GitHub, dans les settings du dépôt de votre choix, section WebHooks :

github webhook 2

Rajouter un webhook :

Webhooc config

L’Event Listener ne semble pas supporter les notifications de type application/x-www-form-urlencoded, il faudra choisir l’option application/json.

Renseigner le Secret fonction de l’accessToken créé précédemment.

Cocher le type d’évenements sur lequel nous souhaitons recevoir une notification, push et pull requests :

Github webhook

Maintenant, nous pouvons pousser un commit sur ce dépôt, pour déclancher un job. Depuis les logs de l’EventListener, confirmer que l’on a bien reçu le message, et verifier qu’un nouveau Pod s’est lance. Nous pourrons suivre les logs d’execution du job :

$ kubectl logs -n ci el-github-listener-657bd5b5d8-9rgwx
{"level":"error","ts":"2021-01-12T08:48:49.089Z","logger":"eventlistener","caller":"sink/sink.go:209","msg":"event type ping is not allowed","knative.dev/controller":"eventlistener","/triggers-eventid":"85m9z","/trigger":"github-push-listener","stacktrace":"github.com/tektoncd/triggers/pkg/sink.Sink.processTrigger\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:209\ngithub.com/tektoncd/triggers/pkg/sink.Sink.HandleEvent.func1\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:129"}
{"level":"error","ts":"2021-01-12T08:48:49.093Z","logger":"eventlistener","caller":"sink/sink.go:209","msg":"event type ping is not allowed","knative.dev/controller":"eventlistener","/triggers-eventid":"85m9z","/trigger":"github-pr-listener","stacktrace":"github.com/tektoncd/triggers/pkg/sink.Sink.processTrigger\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:209\ngithub.com/tektoncd/triggers/pkg/sink.Sink.HandleEvent.func1\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:129"}
{"level":"info","ts":"2021-01-12T09:08:45.303Z","logger":"eventlistener","caller":"sink/sink.go:238","msg":"ResolvedParams : [{Name:gitrevision Value:17bb6ac63b8d504dc9d635cd2b6be396bc9964b3} {Name:gitrepositoryname Value:docker-registry-exporter} {Name:gitrepositoryurl Value:https://github.com/faust64/docker-registry-exporter.git}]","knative.dev/controller":"eventlistener","/triggers-eventid":"25m7f","/trigger":"github-push-listener"}
{"level":"info","ts":"2021-01-12T09:08:45.307Z","logger":"eventlistener","caller":"resources/create.go:95","msg":"Generating resource: kind: &APIResource{Name:pipelineruns,Namespaced:true,Kind:PipelineRun,Verbs:[delete deletecollection get list patch create update watch],ShortNames:[pr prs],SingularName:pipelinerun,Categories:[tekton tekton-pipelines],Group:tekton.dev,Version:v1beta1,StorageVersionHash:RcAKAgPYYoo=,}, name: github-job-","knative.dev/controller":"eventlistener"}
{"level":"info","ts":"2021-01-12T09:08:45.307Z","logger":"eventlistener","caller":"resources/create.go:103","msg":"For event ID \"25m7f\" creating resource tekton.dev/v1beta1, Resource=pipelineruns","knative.dev/controller":"eventlistener"}
$ kubectl get pods -n ci
NAME                                               READY   STATUS      RESTARTS   AGE
...
el-github-listener-657bd5b5d8-9rgwx                1/1     Running     0          12m
github-job-92pjk-build-b66g6-pod-2nvtk             5/5     Running     0          15s
$ kubectl logs -n ci -c step-build -f github-job-92pjk-build-b66g6-pod-2nvtk
E0112 09:09:02.750462      13 aws_credentials.go:77] while getting AWS credentials NoCredentialProviders: no valid providers in chain. Deprecated.
For verbose messaging see aws.Config.CredentialsChainVerboseErrors
INFO[0007] Resolved base name python:3.7-alpine to base
INFO[0007] Retrieving image manifest python:3.7-alpine
...
INFO[0133] WORKDIR /exporter
INFO[0133] cmd: workdir
INFO[0133] Changed working directory to /exporter
INFO[0133] No files changed in this command, skipping snapshotting.
INFO[0133] ENTRYPOINT ["python", "/exporter/exporter.py"]
INFO[0133] USER 1001
INFO[0133] cmd: USER

L’Event Listener recevant une notification de GitHub, a bien créé un PipelineRun :

root@pandore:~/wip-triggers# kubectl get pipelinerun -n ci
NAME                         SUCCEEDED   REASON      STARTTIME   COMPLETIONTIME
docker-registry-exporter-1   True        Succeeded   2d21h       2d21h
github-job-92pjk             True        Succeeded   16m         13m
ltb-openldap-1               True        Succeeded   13h         12h
root@pandore:~/wip-triggers# kubectl get pipelinerun -n ci -o yaml github-job-92pjk
apiVersion: tekton.dev/v1beta1
kind: PipelineRun
...
spec:
  pipelineRef:
    name: docker-build
  resources:
  - name: app-git
    resourceSpec:
      params:
      - name: revision
        value: 17bb6ac63b8d504dc9d635cd2b6be396bc9964b3
      - name: url
        value: https://github.com/faust64/docker-registry-exporter.git
      type: git
  - name: app-image
    resourceSpec:
      params:
      - name: url
        value: registry.registry.svc.cluster.local:5000/ci/docker-registry-exporter:17bb6ac63b8d504dc9d635cd2b6be396bc9964b3
      type: image
  serviceAccountName: tkn-ci
  timeout: 1h0m0s

Comme prévu, le job a bien utilisé le hash reçu par notre notification, pour cloner le dépôt source, et tagguer l’image correspondante.

Nous pourrions par la suite compléter notre Pipeline, intégration continue, publication d’une release si le commit s’est fait sur votre branche master, …

Tekton CLI

Notons que Tekton fourni son propre client, tkn, téléchargeable depuis leur dépôt GitHub.

Celui-ci aura l’avantage de simplifier l’interraction avec vos jobs. Rien de révolutionnaire, son utilisation n’est en aucun cas obligatoire, kubectl peut tout faire, mais propose moins d’automatismes.

Citons par exemple l’execution de Tasks ou Pipelines, sans que l’on ait à rédiger de TaskRun ou PipelineRun. Tkn permet aussi de suivre les logs d’un job, aggregeant la sortie de l’ensemble des conteneurs en question, là ou Kubectl ne suivra qu’un conteneur à la fois.

Tekton Dashboard

Pour l’instant, nous avons manipulé exclusivement en ligne de commande, mais l’écosystème Tekton dispose bien sûr d’une Dashboard.

À nouveau, nous pourrons installer la dernière release, disponible sur GitHub :

$ kubectl apply -f https://github.com/tektoncd/dashboard/releases/download/v0.12.0/tekton-dashboard-release.yaml
$ kubectl get pods -n tekton-pipelines
NAME                                           READY   STATUS    RESTARTS   AGE
tekton-dashboard-56c78f485b-fw4tn              1/1     Running   0          2m
tekton-pipelines-controller-5cdb46974f-fzfdh   1/1     Running   0          50m
tekton-pipelines-webhook-6479d769ff-wxbxr      1/1     Running   0          50m
tekton-triggers-controller-5994f6c94b-fw2dm    1/1     Running   0          26m
tekton-triggers-webhook-68c7866d8-zdttm        1/1     Running   0          26m

Le Pod tekton-dashboard ayant démarré, il nous reste à créer un Ingress, exposant la Dashboard en dehors du SDN Kubernetes :

$ cat <<EOF | kubectl apply -f-
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: tekton-dashboard
  namespace: tekton-pipelines
spec:
  rules:
  - host: tekton.router.example.com
    http:
      paths:
      - backend:
          serviceName: tekton-dashboard
          servicePort: 9097
EOF

Nous pouvons maintenant nous y connecter, depuis un navigateur. Nous y retrouverons nos PipelineRuns :

Pipeline run

Les EventListeners :

Event listener

Nous pourrons consulter les logs d’un job :

Log job

Importer des Tasks ou Pipelines depuis une source externe :

Import Tasks ou Pipeline

Ou lancer un Pipeline, sans passer par la ligne de commande :

image create pipeline

Dans l’ensemble cette Dashboard fait tout ce que l’on peut en attendre, mais il reste à notre charge d’identifier les utilisateurs s’y connectant, et peu probable que l’on puisse facilement restreindre le champ d’action d’un utilisateur une fois celui-ci connecté. Nous pourrions de meme regretter quelques soucis, de longue date, avec les navigateurs Chrome – Firefox et ses dérivés fonctionnent parfaitement.

Conclusion

La suite Tekton simplifie l’implémentation d’une chaine d’intégration et déploiement continues. Si OpenShift pouvait disposer d’un avantage certain dans ce domaine, en proposant les objets de type BuildConfig, Tekton nous offre ici une solution native Kubernetes, tout aussi capable.

Sachant que le projet en est toujours dans ses premières annéés, la roadmap reste conséquente et les fonctionnalitées qu’il reste à implementer ne manquent pas. Depuis décembre 2020, les dernière releases de Tekton Pipelines, Tekton Triggers et Tekton Dashboard permettent enfin de déployer Tekton sur ARM. Le cycle de release est assez soutenu, le projet murit doucement.

L’essentiel est là, fiable, malgrès une relative complexitée à mettre en oeuvre – les adeptes d’OpenShift remarqueront que l’exécution d’un job implique beaucoup de ressources, différentes, tandis qu’une BuildConfig restera, en règle générale, beaucoup plus simple. Cette architecture, plus riche, permet déjà une plus grande modularité.

🔲 ☆

Ceph & Kubernetes : Container Storage Interface

Ceph est une solution de SDS (Software Defined Storage) opensource, qui s’intègre avec divers PAAS / IAAS, tels qu’OpenStack, OpenNebula, ou Kubernetes. Donnant suite à notre article concernant le déploiement d’un cluster Kubernetes sur Raspberry Pi, aujourd’hui nous allons voire comment s’interfacer avec un cluster Ceph, pour y héberger les volumes persistants de nos applications.

Logo Ceph

CSI

Depuis janvier 2019, l’implémentation CSI (Container Storage Interface) de Kubernetes est considérée comme stable et se généralise, au point que les versions récentes de Kubernetes ne permettent souvent plus de monter des volumes tel que nous avions pu le documenter en 2018.

Les éditeurs de solutions SDS sont mis à contribution, et doivent implémenter leurs propres contrôleurs, ceux-ci devant automatiser la création, l’expansion ou la purge, ainsi que les montages et détachement de volumes. Dans le cas de Ceph, nous retrouverons le nécessaire sur GitHub.

Raspberry Pi

Dans le contexte de noeuds Raspberry Pi, nous évoquions la chose dans notre précédent article, il faudra prendre en compte que Raspbian ne livre pas le module kernel rbd, habituellement au coeur de toute interaction avec les volumes de type block Ceph.

Mais notons qu’rbd n’est pas indispensable pour autant. Il existe un client alternatif, moins connu, qui nous permettra de manipuler nos volumes Ceph sur nos Raspberry Pi.

Pour se rattacher à un volume, depuis la ligne de commande, nous pourrions utiliser :

# apt-get install ceph-common rbd-nbd
# scp -p root@ceph-host:/etc/ceph/ceph.conf /etc/ceph/
# scp -p root@ceph-host:/etc/ceph/ceph.client.admin.keyring /etc/ceph/
# rbd-nbd -v
<version ceph>
# rbd -p kube ls
<liste de volumes rbd dans le pool kube>
# rbd-nbd map kube/kubernetes-dynamic-pvc-d3c6c506-3247-11eb-a46b-4249a933eab7
/dev/nbd0
# mount /dev/nbd0 /mnt
# date >/mnt/the_date
# ls -1 /mnt
date
lost+found
# mount /mnt
# rbd-nbd unmap /dev/nbd0

ARM

Nous avons pu voir que Raspbian, en l’absence de module rbd, reste néanmoins capable de monter un volume Ceph. Mais qu’en est-il de CSI ?

C’est un autre contre-temps, les images officielles des contrôleurs Ceph CSI n’étant pas publiées pour ARM. Cependant, la question est à l’étude, on retrouve un premier ticket GitHub sur le projet Rook — ayant donné lieu à un second ouvert chez Ceph — mentionnant entre autres les noms de dépôts DockerHub, servant aux tests de contributeurs. Si ces images ne sont pas fréquemment mises à jour, elles sont pour l’instant relativement récentes, et ont le mérite de fonctionner sur ARM. Par ailleurs, qu’elles soient issues de contributions Rook donne bon espoir qu’elles ne soient plus très loin d’être intégrées aux releases officielles.

Un détail à ne pas négliger : certaines images ne sont pour l’instant pas disponible en 32b, il faudra impérativement flasher vos Raspberry Pi avec l’image Raspbian 64b.

Préparatif Ceph

Dans un premier temps, nous allons créer un pool sur notre cluster Ceph devant accueillir les volumes du cluster Kubernetes.

# ceph -c /etc/ceph/ceph.conf osd pool create kube 32

Afin de ne pas ré-utiliser le keyring de l’admin du cluster, nous allons de même créer un utilisateur Ceph, disposant du minimum de privilèges :

# ceph -c /etc/ceph/ceph.conf auth get-or-create client.kube mon 'allow r' osd 'allow class-read object_prefix rbd_children, allow rwx pool=kube' -o /etc/ceph/ceph.client.kube.keyring

Prendre note de la liste des Monitors, du Cluster ID, et du keyring généré :

# grep -E '^mon host|fsid' /etc/ceph/ceph.conf
fsid = eb53775c-ec88-484f-b5f5-b421b55079d7
mon host = [v2:10.42.253.110:3300,v1:10.42.253.110:6789],[v2:10.42.253.111:3300,v1:10.42.253.111:6789],[v2:10.42.253.112:3300,v1:10.42.253.112:6789]

# cat /etc/ceph/ceph.client.kube.keyring
[client.kube]
    key = AQAKfNJeC/z0FhAAbmBgMu0NdWUw2wfua4Lf9Q==
    caps mon = "allow r"
    caps osd = "allow class-read object_prefix rbd_children, allow rwx pool=kube"

Préparatif Kubernetes

Du côté de Kubernetes, il faudra d’abord créer un Namespace :

$ kubectl create ns rbd-provisioner

Préparons ensuite la configuration décrivant comment s’interfacer à notre cluster Ceph. Celle-ci comprend une ConfigMap, listant les Cluster ID et Monitors du cluster et un Secret qui contiendra la clé du keyring créé précédemment :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: ceph-csi-config
  namespace: rbd-provisioner
data:
  config.json: |-
    [
      {
        "clusterID": "eb53775c-ec88-484f-b5f5-b421b55079d7",
        "monitors": [
          "10.42.253.110",
          "10.42.253.111",
          "10.42.253.112"
        ],
        "cephFS": {
          "subvolumeGroup": "k8srpicsi"
        }
      }
    ]
---
apiVersion: v1
kind: Secret
metadata:
  name: ceph-secret-user
  namespace: rbd-provisioner
stringData:
  userID: kube
  userKey: AQAKfNJeC/z0FhAAbmBgMu0NdWUw2wfua4Lf9Q==
EOF

Provisioner

Ensuite, ayant activé les PodSecurityPolicies au déploiement du cluster, nous devrons créer le nécessaire permettant au provisioner CSI l’accès à une partie de l’arboresence du système de fichiers de nos noeuds Kubernetes :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: policy/v1beta1
kind: PodSecurityPolicy
metadata:
  name: rbd-csi-provisioner-psp
spec:
  allowPrivilegeEscalation: true
  allowedCapabilities:
  - 'SYS_ADMIN'
  fsGroup:
    rule: RunAsAny
  privileged: true
  runAsUser:
    rule: RunAsAny
  seLinux:
    rule: RunAsAny
  supplementalGroups:
    rule: RunAsAny
  volumes:
  - 'configMap'
  - 'emptyDir'
  - 'projected'
  - 'secret'
  - 'downwardAPI'
  - 'hostPath'
  allowedHostPaths:
  - pathPrefix: '/dev'
    readOnly: false
  - pathPrefix: '/sys'
    readOnly: false
  - pathPrefix: '/lib/modules'
    readOnly: true
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: rbd-provisioner
  name: rbd-csi-provisioner-psp
rules:
- apiGroups: ['policy']
  resources: ['podsecuritypolicies']
  verbs: ['use']
  resourceNames: ['rbd-csi-provisioner-psp']
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-provisioner-psp
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: rbd-csi-provisioner-psp
  apiGroup: rbac.authorization.k8s.io
EOF

Par ailleurs, le provisioner dépend de l’API du cluster, devant pouvoir lister ses PersistentVolumeClaims, créer et supprimer les objets PersistentVolume, …

Nous ajouterons donc :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-external-provisioner-runner
rules:
- apiGroups: [""]
  resources: ["nodes"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["secrets"]
  verbs: ["get", "list"]
- apiGroups: [""]
  resources: ["events"]
  verbs: ["list", "watch", "create", "update", "patch"]
- apiGroups: [""]
  resources: ["persistentvolumes"]
  verbs: ["get", "list", "watch", "create", "update", "delete", "patch"]
- apiGroups: [""]
  resources: ["persistentvolumeclaims"]
  verbs: ["get", "list", "watch", "update"]
- apiGroups: [""]
  resources: ["persistentvolumeclaims/status"]
  verbs: ["update", "patch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["storageclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshots"]
  verbs: ["get", "list"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotcontents"]
  verbs: ["create", "get", "list", "watch", "update", "delete"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["volumeattachments"]
  verbs: ["get", "list", "watch", "update", "patch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["volumeattachments/status"]
  verbs: ["patch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["csinodes"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotcontents/status"]
  verbs: ["update"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-provisioner-role
subjects:
- kind: ServiceAccount
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
roleRef:
  kind: ClusterRole
  name: rbd-external-provisioner-runner
  apiGroup: rbac.authorization.k8s.io
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: rbd-provisioner
  name: rbd-external-provisioner-cfg
rules:
- apiGroups: [""]
  resources: ["configmaps"]
  verbs: ["get", "list", "watch", "create", "update", "delete"]
- apiGroups: ["coordination.k8s.io"]
  resources: ["leases"]
  verbs: ["get", "watch", "list", "delete", "update", "create"]
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-provisioner-role-cfg
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: rbd-external-provisioner-cfg
  apiGroup: rbac.authorization.k8s.io

Enfin, déployons le provisioner.

Notons que les images utilisées ici ont été choisiees pour ARM64. Vous retrouverez l’original des configurations distribuées par Ceph, pour x86, sur leur dépôt GitHub.

$ cat <<EOF | kubectl apply -f-
---
kind: Service
apiVersion: v1
metadata:
  name: csi-rbdplugin-provisioner
  namespace: rbd-provisioner
  labels:
    app: csi-metrics
spec:
  selector:
    app: csi-rbdplugin-provisioner
  ports:
  - name: http-metrics
    port: 8080
    protocol: TCP
    targetPort: 8680
---
kind: Deployment
apiVersion: apps/v1
metadata:
  name: csi-rbdplugin-provisioner
  namespace: rbd-provisioner
spec:
  replicas: 3
  selector:
    matchLabels:
      app: csi-rbdplugin-provisioner
  template:
    metadata:
      labels:
        app: csi-rbdplugin-provisioner
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - csi-rbdplugin-provisioner
            topologyKey: "kubernetes.io/hostname"
      nodeSelector:
        kubernetes.io/arch: arm64
      serviceAccount: rbd-csi-provisioner
      containers:
      - name: csi-provisioner
        image: docker.io/jamesorlakin/multiarch-csi-provisioner:2.0.1
        args:
        - "--csi-address=$(ADDRESS)"
        - "--v=5"
        - "--timeout=150s"
        - "--retry-interval-start=500ms"
        - "--leader-election=true"
        - "--feature-gates=Topology=false"
        - "--default-fstype=ext4"
        - "--extra-create-metadata=true"
        env:
        - name: ADDRESS
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-snapshotter
        image: docker.io/jamesorlakin/multiarch-csi-snapshotter:2.1.1
        args:
        - "--csi-address=$(ADDRESS)"
        - "--v=5"
        - "--timeout=150s"
        - "--leader-election=true"
        env:
        - name: ADDRESS
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        securityContext:
          privileged: true
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-attacher
        image: docker.io/jamesorlakin/multiarch-csi-attacher:3.0.0
        args:
        - "--v=5"
        - "--csi-address=$(ADDRESS)"
        - "--leader-election=true"
        - "--retry-interval-start=500ms"
        env:
        - name: ADDRESS
          value: /csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-resizer
        image: docker.io/jamesorlakin/multiarch-csi-resizer:1.0.0
        args:
        - "--csi-address=$(ADDRESS)"
        - "--v=5"
        - "--timeout=150s"
        - "--leader-election"
        - "--retry-interval-start=500ms"
        - "--handle-volume-inuse-error=false"
        env:
        - name: ADDRESS
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-rbdplugin
        securityContext:
          privileged: true
          capabilities:
            add: ["SYS_ADMIN"]
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--nodeid=$(NODE_ID)"
        - "--type=rbd"
        - "--controllerserver=true"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--v=5"
        - "--drivername=rbd.csi.ceph.com"
        - "--pidlimit=-1"
        - "--rbdhardmaxclonedepth=8"
        - "--rbdsoftmaxclonedepth=4"
        env:
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        - name: NODE_ID
          valueFrom:
            fieldRef:
              fieldPath: spec.nodeName
        - name: CSI_ENDPOINT
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        - mountPath: /dev
          name: host-dev
        - mountPath: /sys
          name: host-sys
        - mountPath: /lib/modules
          name: lib-modules
          readOnly: true
        - name: ceph-csi-config
          mountPath: /etc/ceph-csi-config/
        - name: keys-tmp-dir
          mountPath: /tmp/csi/keys
      - name: csi-rbdplugin-controller
        securityContext:
          privileged: true
          capabilities:
            add: ["SYS_ADMIN"]
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--type=controller"
        - "--v=5"
        - "--drivername=rbd.csi.ceph.com"
        - "--drivernamespace=$(DRIVER_NAMESPACE)"
        env:
        - name: DRIVER_NAMESPACE
          valueFrom:
            fieldRef:
              fieldPath: metadata.namespace
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: ceph-csi-config
          mountPath: /etc/ceph-csi-config/
        - name: keys-tmp-dir
          mountPath: /tmp/csi/keys
      - name: liveness-prometheus
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--type=liveness"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--metricsport=8680"
        - "--metricspath=/metrics"
        - "--polltime=60s"
        - "--timeout=3s"
        env:
        - name: CSI_ENDPOINT
          value: unix:///csi/csi-provisioner.sock
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        imagePullPolicy: IfNotPresent
      volumes:
      - name: host-dev
        hostPath:
          path: /dev
      - name: host-sys
        hostPath:
          path: /sys
      - name: lib-modules
        hostPath:
          path: /lib/modules
      - name: socket-dir
        emptyDir: {
          medium: "Memory"
        }
      - name: ceph-csi-config
        configMap:
          name: ceph-csi-config
      - name: keys-tmp-dir
        emptyDir: {
          medium: "Memory"
        }
EOF

Suivre le déploiement des Pods provisioner. Dans cette configuration, trois Pods vont se lancer. Une élection décidera d’un contrôleur primaire, qui prendra alors en charge le provisionnement de nos volumes.

Node Plugin

Dans le même temps, nous devrons déployer le second contrôleur en charge de rattacher nos volumes à nos noeuds.

Toujours dans le cas où les PodSecurityPolicies soient actives sur votre cluster, nous devrons créer le nécessaire permettant au contrôleur CSI de manipuler et d’attacher nos volumes aux noeuds de notre cluster.

$ cat <<EOF | kubectl apply -f-
---
apiVersion: policy/v1beta1
kind: PodSecurityPolicy
metadata:
  name: rbd-csi-nodeplugin-psp
spec:
  allowPrivilegeEscalation: true
  allowedCapabilities:
  - 'SYS_ADMIN'
  fsGroup:
    rule: RunAsAny
  privileged: true
  hostNetwork: true
  hostPID: true
  runAsUser:
    rule: RunAsAny
  seLinux:
    rule: RunAsAny
  supplementalGroups:
    rule: RunAsAny
  volumes:
  - 'configMap'
  - 'emptyDir'
  - 'projected'
  - 'secret'
  - 'downwardAPI'
  - 'hostPath'
  allowedHostPaths:
  - pathPrefix: '/dev'
    readOnly: false
  - pathPrefix: '/run/mount'
    readOnly: false
  - pathPrefix: '/sys'
    readOnly: false
  - pathPrefix: '/lib/modules'
    readOnly: true
  - pathPrefix: '/var/lib/kubelet/pods'
    readOnly: false
  - pathPrefix: '/var/lib/kubelet/plugins/rbd.csi.ceph.com'
    readOnly: false
  - pathPrefix: '/var/lib/kubelet/plugins_registry'
    readOnly: false
  - pathPrefix: '/var/lib/kubelet/plugins'
    readOnly: false
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin-psp
  namespace: rbd-provisioner
rules:
- apiGroups: ['policy']
  resources: ['podsecuritypolicies']
  verbs: ['use']
  resourceNames: ['rbd-csi-nodeplugin-psp']
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin-psp
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: rbd-csi-nodeplugin
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: rbd-csi-nodeplugin-psp
  apiGroup: rbac.authorization.k8s.io
EOF

De plus, ce contrôleur doit pouvoir interroger l’API du cluster, à la recherche de ConfigMaps, Secrets et Nodes. Nous ajouterons alors :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: rbd-csi-nodeplugin
  namespace: rbd-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin
rules:
- apiGroups: [""]
  resources: ["nodes"]
  verbs: ["get"]
- apiGroups: [""]
  resources: ["secrets"]
  verbs: ["get"]
- apiGroups: [""]
  resources: ["configmaps"]
  verbs: ["get"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin
subjects:
- kind: ServiceAccount
  name: rbd-csi-nodeplugin
  namespace: rbd-provisioner
roleRef:
  kind: ClusterRole
  name: rbd-csi-nodeplugin
  apiGroup: rbac.authorization.k8s.io
EOF

Enfin, déployer ce contrôleur :

$ cat <<EOF | kubectl apply -f-
---
kind: DaemonSet
apiVersion: apps/v1
metadata:
  name: csi-rbdplugin
  namespace: rbd-provisioner
spec:
  selector:
    matchLabels:
      app: csi-rbdplugin
  template:
    metadata:
      labels:
        app: csi-rbdplugin
    spec:
      serviceAccount: rbd-csi-nodeplugin
      hostNetwork: true
      hostPID: true
      nodeSelector:
        kubernetes.io/arch: arm64
      dnsPolicy: ClusterFirstWithHostNet
      containers:
      - name: driver-registrar
        securityContext:
          privileged: true
        #image: docker.io/colek42/csi-node-driver-registrar:latest
        image: docker.io/jamesorlakin/multiarch-csi-node-registrar:2.0.0
        args:
        - "--v=5"
        - "--csi-address=/csi/csi.sock"
        - "--kubelet-registration-path=/var/lib/kubelet/plugins/rbd.csi.ceph.com/csi.sock"
        env:
        - name: KUBE_NODE_NAME
          valueFrom:
            fieldRef:
              fieldPath: spec.nodeName
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        - name: registration-dir
          mountPath: /registration
      - name: csi-rbdplugin
        securityContext:
          privileged: true
          capabilities:
            add: ["SYS_ADMIN"]
          allowPrivilegeEscalation: true
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--nodeid=$(NODE_ID)"
        - "--type=rbd"
        - "--nodeserver=true"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--v=5"
        - "--drivername=rbd.csi.ceph.com"
        env:
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        - name: NODE_ID
          valueFrom:
            fieldRef:
              fieldPath: spec.nodeName
        - name: CSI_ENDPOINT
          value: unix:///csi/csi.sock
        imagePullPolicy: "IfNotPresent"
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        - mountPath: /dev
          name: host-dev
        - mountPath: /sys
          name: host-sys
        - mountPath: /run/mount
          name: host-mount
        - mountPath: /lib/modules
          name: lib-modules
          readOnly: true
        - name: ceph-csi-config
          mountPath: /etc/ceph-csi-config/
        - name: plugin-dir
          mountPath: /var/lib/kubelet/plugins
          mountPropagation: "Bidirectional"
        - name: mountpoint-dir
          mountPath: /var/lib/kubelet/pods
          mountPropagation: "Bidirectional"
        - name: keys-tmp-dir
          mountPath: /tmp/csi/keys
      - name: liveness-prometheus
        securityContext:
          privileged: true
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--type=liveness"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--metricsport=8680"
        - "--metricspath=/metrics"
        - "--polltime=60s"
        - "--timeout=3s"
        env:
        - name: CSI_ENDPOINT
          value: unix:///csi/csi.sock
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        imagePullPolicy: "IfNotPresent"
      volumes:
      - name: socket-dir
        hostPath:
          path: /var/lib/kubelet/plugins/rbd.csi.ceph.com
          type: DirectoryOrCreate
      - name: plugin-dir
        hostPath:
          path: /var/lib/kubelet/plugins
          type: Directory
      - name: mountpoint-dir
        hostPath:
          path: /var/lib/kubelet/pods
          type: DirectoryOrCreate
      - name: registration-dir
        hostPath:
          path: /var/lib/kubelet/plugins_registry/
          type: Directory
      - name: host-dev
        hostPath:
          path: /dev
      - name: host-sys
        hostPath:
          path: /sys
      - name: host-mount
        hostPath:
          path: /run/mount
      - name: lib-modules
        hostPath:
          path: /lib/modules
      - name: ceph-csi-config
        configMap:
          name: ceph-csi-config
      - name: keys-tmp-dir
        emptyDir: {
          medium: "Memory"
        }
---
apiVersion: v1
kind: Service
metadata:
  name: csi-metrics-rbdplugin
  namespace: rbd-provisioner
  labels:
    app: csi-metrics
spec:
  ports:
  - name: http-metrics
    port: 8080
    protocol: TCP
    targetPort: 8680
  selector:
    app: csi-rbdplugin
EOF

StorageClass

Nous pourrons conclure avec l’ajout de la StorageClass suivante, faisant le lien entre nos configurations précédentes :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  annotations:
    storageclass.beta.kubernetes.io/is-default-class: "true"
  name: rwo-storage
allowVolumeExpansion: true
parameters:
  clusterID: eb53775c-ec88-484f-b5f5-b421b55079d7
  csi.storage.k8s.io/provisioner-secret-name: ceph-secret-user
  csi.storage.k8s.io/provisioner-secret-namespace: rbd-provisioner
  csi.storage.k8s.io/controller-expand-secret-name: ceph-secret-user
  csi.storage.k8s.io/controller-expand-secret-namespace: rbd-provisioner
  csi.storage.k8s.io/node-stage-secret-name: ceph-secret-user
  csi.storage.k8s.io/node-stage-secret-namespace: rbd-provisioner
  csi.storage.k8s.io/fstype: ext4
  imageFeatures: layering
  imageFormat: "2"
  mapOptions: nbds_max=16
  mounter: rbd-nbd
  pool: kube
  volumeNamePrefix: k8s-rpi-
provisioner: rbd.csi.ceph.com
reclaimPolicy: Delete
volumeBindingMode: Immediate
EOF

Notez que nous passons une option mounter valant rbd-nbd : comme évoqué précédemment, il s’agit de ne pas dépendre du module rbd, absent de la distribution Raspbian.

Tester

Tout est prêt, il ne nous reste plus qu’à tester.

Nous pourrons d’abord créer une PersistentVolumeClaim :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: test-pvc-too
  namespace: default
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 8Gi
EOF

Avant de ne lancer cette commande, depuis un autre terminal, nous pourrons nous rattacher aux logs du provisioner, pour suivre la création de notre volume :

$ kubectl get pods -n rbd-provisioner -w
NAME                                        READY   STATUS              RESTARTS   AGE
csi-rbdplugin-24wk8                         3/3     Running             0          55s
csi-rbdplugin-6kgnk                         3/3     Running             0          51s
csi-rbdplugin-94dnw                         3/3     Running             0          50s
csi-rbdplugin-9l59x                         3/3     Running             0          52s
csi-rbdplugin-c9bv2                         3/3     Running             0          53s
csi-rbdplugin-fl5dx                         3/3     Running             0          50s
csi-rbdplugin-ldqrb                         3/3     Running             0          47s
csi-rbdplugin-m8421                         3/3     Running             0          53s
csi-rbdplugin-n4ckr                         3/3     Running             0          54s
csi-rbdplugin-provisioner-7b59568f8-2n4hd   0/7     ContainerCreating   0          57s
csi-rbdplugin-provisioner-7b59568f8-5xs5q   7/7     Running             0          57s
csi-rbdplugin-provisioner-7b59568f8-h7ks7   0/7     ContainerCreating   0          57s
csi-rbdplugin-sjxkl                         3/3     Running             0          45s
csi-rbdplugin-wzrqm                         3/3     Running             0          49s
csi-rbdplugin-xnskj                         3/3     Running             0          51s
$ kubectl logs -n rbd-provisioner csi-rbdplugin-provisioner-7b59568f8-5xs5q -c csi-provisioner  -f
I0111 09:55:09.400769       1 csi-provisioner.go:121] Version: v2.0.1-0-g4e612cc-dirty
I0111 09:55:09.401039       1 csi-provisioner.go:135] Building kube configs for running in cluster...
I0111 09:55:09.425902       1 connection.go:153] Connecting to unix:///csi/csi-provisioner.sock
W0111 09:55:19.426118       1 connection.go:172] Still connecting to unix:///csi/csi-provisioner.sock
W0111 09:55:29.426155       1 connection.go:172] Still connecting to unix:///csi/csi-provisioner.sock
W0111 09:55:39.426148       1 connection.go:172] Still connecting to unix:///csi/csi-provisioner.sock
I0111 09:55:40.722714       1 common.go:111] Probing CSI driver for readiness
I0111 09:55:40.723054       1 connection.go:182] GRPC call: /csi.v1.Identity/Probe
I0111 09:55:40.723170       1 connection.go:183] GRPC request: {}
I0111 09:55:40.730806       1 connection.go:185] GRPC response: {}
I0111 09:55:40.730985       1 connection.go:186] GRPC error: 
I0111 09:55:40.731014       1 connection.go:182] GRPC call: /csi.v1.Identity/GetPluginInfo
I0111 09:55:40.731030       1 connection.go:183] GRPC request: {}
I0111 09:55:40.733538       1 connection.go:185] GRPC response: {"name":"rbd.csi.ceph.com","vendor_version":"v3.2.1"}
I0111 09:55:40.733699       1 connection.go:186] GRPC error: 
I0111 09:55:40.733728       1 csi-provisioner.go:182] Detected CSI driver rbd.csi.ceph.com
W0111 09:55:40.733766       1 metrics.go:142] metrics endpoint will not be started because `metrics-address` was not specified.
I0111 09:55:40.733790       1 connection.go:182] GRPC call: /csi.v1.Identity/GetPluginCapabilities
I0111 09:55:40.733806       1 connection.go:183] GRPC request: {}
I0111 09:55:40.738163       1 connection.go:185] GRPC response: {"capabilities":[{"Type":{"Service":{"type":1}}},{"Type":{"VolumeExpansion":{"type":1}}},{"Type":{"Service":{"type":2}}}]}
I0111 09:55:40.738676       1 connection.go:186] GRPC error: 
I0111 09:55:40.738816       1 connection.go:182] GRPC call: /csi.v1.Controller/ControllerGetCapabilities
I0111 09:55:40.739012       1 connection.go:183] GRPC request: {}
I0111 09:55:40.741701       1 connection.go:185] GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":5}}},{"Type":{"Rpc":{"type":7}}},{"Type":{"Rpc":{"type":9}}}]}
I0111 09:55:40.742063       1 connection.go:186] GRPC error: 
I0111 09:55:40.743107       1 controller.go:735] Using saving PVs to API server in background
I0111 09:55:40.746567       1 leaderelection.go:243] attempting to acquire leader lease  rbd-provisioner/rbd-csi-ceph-com...
I0111 09:55:40.760038       1 leader_election.go:172] new leader detected, current leader: csi-rbdplugin-provisioner-7b59568f8-xr2g8
I0111 09:56:00.421214       1 leaderelection.go:253] successfully acquired lease rbd-provisioner/rbd-csi-ceph-com
I0111 09:56:00.421229       1 leader_election.go:172] new leader detected, current leader: csi-rbdplugin-provisioner-7b59568f8-5xs5q
I0111 09:56:00.421553       1 leader_election.go:165] became leader, starting
I0111 09:56:00.522001       1 controller.go:820] Starting provisioner controller rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8!
I0111 09:56:00.522051       1 volume_store.go:97] Starting save volume queue
I0111 09:56:00.522170       1 clone_controller.go:66] Starting CloningProtection controller
I0111 09:56:00.522401       1 clone_controller.go:84] Started CloningProtection controller
I0111 09:56:00.623959       1 controller.go:869] Started provisioner controller rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8!

== A ce moment, nous créons le volume décrit précédemment :

I0111 09:56:36.834686       1 controller.go:1317] provision "default/test-pvc-too" class "rwo-storage": started
I0111 09:56:36.835459       1 event.go:282] Event(v1.ObjectReference{Kind:"PersistentVolumeClaim", Namespace:"default", Name:"test-pvc-too", UID:"c06c760d-b718-48a5-b92f-56683049e6d2", APIVersion:"v1", ResourceVersion:"2703309", FieldPath:""}): type: 'Normal' reason: 'Provisioning' External provisioner is provisioning volume for claim "default/test-pvc-too"
I0111 09:56:36.834922       1 controller.go:570] CreateVolumeRequest {Name:pvc-c06c760d-b718-48a5-b92f-56683049e6d2 CapacityRange:required_bytes:8589934592  VolumeCapabilities:[mount: access_mode: ] Parameters:map[clusterID:eb53775c-ec88-484f-b5f5-b421b55079d7 csi.storage.k8s.io/controller-expand-secret-name:ceph-secret-admin csi.storage.k8s.io/controller-expand-secret-namespace:rbd-provisioner csi.storage.k8s.io/fstype:ext4 csi.storage.k8s.io/node-stage-secret-name:ceph-secret-user csi.storage.k8s.io/node-stage-secret-namespace:rbd-provisioner csi.storage.k8s.io/provisioner-secret-name:ceph-secret-admin csi.storage.k8s.io/provisioner-secret-namespace:rbd-provisioner imageFeatures:layering imageFormat:2 mapOptions:nbds_max=16 mounter:rbd-nbd pool:kube volumeNamePrefix:k8s-rpi-] Secrets:map[] VolumeContentSource: AccessibilityRequirements: XXX_NoUnkeyedLiteral:{} XXX_unrecognized:[] XXX_sizecache:0}
I0111 09:56:36.853789       1 connection.go:182] GRPC call: /csi.v1.Controller/CreateVolume
I0111 09:56:36.853869       1 connection.go:183] GRPC request: {"capacity_range":{"required_bytes":8589934592},"name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","parameters":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","volumeNamePrefix":"k8s-rpi-"},"secrets":"***stripped***","volume_capabilities":[{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}}]}

I0111 09:56:41.441551       1 connection.go:185] GRPC response: {"volume":{"capacity_bytes":8589934592,"volume_context":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","imageName":"k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda","journalPool":"kube","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","radosNamespace":"","volumeNamePrefix":"k8s-rpi-"},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda"}}
I0111 09:56:41.441998       1 connection.go:186] GRPC error: 
I0111 09:56:41.442311       1 controller.go:652] create volume rep: {CapacityBytes:8589934592 VolumeId:0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda VolumeContext:map[clusterID:eb53775c-ec88-484f-b5f5-b421b55079d7 csi.storage.k8s.io/pv/name:pvc-c06c760d-b718-48a5-b92f-56683049e6d2 csi.storage.k8s.io/pvc/name:test-pvc-too csi.storage.k8s.io/pvc/namespace:default imageFeatures:layering imageFormat:2 imageName:k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda journalPool:kube mapOptions:nbds_max=16 mounter:rbd-nbd pool:kube radosNamespace: volumeNamePrefix:k8s-rpi-] ContentSource: AccessibleTopology:[] XXX_NoUnkeyedLiteral:{} XXX_unrecognized:[] XXX_sizecache:0}
I0111 09:56:41.442523       1 controller.go:734] successfully created PV pvc-c06c760d-b718-48a5-b92f-56683049e6d2 for PVC test-pvc-too and csi volume name 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
I0111 09:56:41.442582       1 controller.go:750] successfully created PV {GCEPersistentDisk:nil AWSElasticBlockStore:nil HostPath:nil Glusterfs:nil NFS:nil RBD:nil ISCSI:nil Cinder:nil CephFS:nil FC:nil Flocker:nil FlexVolume:nil AzureFile:nil VsphereVolume:nil Quobyte:nil AzureDisk:nil PhotonPersistentDisk:nil PortworxVolume:nil ScaleIO:nil Local:nil StorageOS:nil CSI:&CSIPersistentVolumeSource{Driver:rbd.csi.ceph.com,VolumeHandle:0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda,ReadOnly:false,FSType:ext4,VolumeAttributes:map[string]string{clusterID: eb53775c-ec88-484f-b5f5-b421b55079d7,csi.storage.k8s.io/pv/name: pvc-c06c760d-b718-48a5-b92f-56683049e6d2,csi.storage.k8s.io/pvc/name: test-pvc-too,csi.storage.k8s.io/pvc/namespace: default,imageFeatures: layering,imageFormat: 2,imageName: k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda,journalPool: kube,mapOptions: nbds_max=16,mounter: rbd-nbd,pool: kube,radosNamespace: ,storage.kubernetes.io/csiProvisionerIdentity: 1610358940742-8081-rbd.csi.ceph.com,volumeNamePrefix: k8s-rpi-,},ControllerPublishSecretRef:nil,NodeStageSecretRef:&SecretReference{Name:ceph-secret-user,Namespace:rbd-provisioner,},NodePublishSecretRef:nil,ControllerExpandSecretRef:&SecretReference{Name:ceph-secret-admin,Namespace:rbd-provisioner,},}}
I0111 09:56:41.443201       1 controller.go:1420] provision "default/test-pvc-too" class "rwo-storage": volume "pvc-c06c760d-b718-48a5-b92f-56683049e6d2" provisioned
I0111 09:56:41.443292       1 controller.go:1437] provision "default/test-pvc-too" class "rwo-storage": succeeded
I0111 09:56:41.443313       1 volume_store.go:154] Saving volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
I0111 09:56:41.502958       1 volume_store.go:157] Volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2 saved
I0111 09:56:41.504698       1 event.go:282] Event(v1.ObjectReference{Kind:"PersistentVolumeClaim", Namespace:"default", Name:"test-pvc-too", UID:"c06c760d-b718-48a5-b92f-56683049e6d2", APIVersion:"v1", ResourceVersion:"2703309", FieldPath:""}): type: 'Normal' reason: 'ProvisioningSucceeded' Successfully provisioned volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
E0111 09:56:41.505723       1 controller.go:1443] couldn't create key for object pvc-c06c760d-b718-48a5-b92f-56683049e6d2: object has no meta: object does not implement the Object interfaces
I0111 09:56:41.505847       1 controller.go:1078] Claim processing succeeded, removing PVC c06c760d-b718-48a5-b92f-56683049e6d2 from claims in progress
I0111 09:56:41.505965       1 controller.go:1317] provision "default/test-pvc-too" class "rwo-storage": started
I0111 09:56:41.506001       1 controller.go:1326] provision "default/test-pvc-too" class "rwo-storage": persistentvolume "pvc-c06c760d-b718-48a5-b92f-56683049e6d2" already exists, skipping
I0111 09:56:41.506024       1 controller.go:1080] Stop provisioning, removing PVC c06c760d-b718-48a5-b92f-56683049e6d2 from claims in progress

Nous pouvons alors confirmer que le volume a bien été provisionné :

$ kubectl get pvc
NAME           STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS   AGE
test-pvc-too   Bound    pvc-c06c760d-b718-48a5-b92f-56683049e6d2   8Gi        RWO            rwo-storage    26s

Maintenant, essayons d’étendre ce volume :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: test-pvc-too
  namespace: default
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 16Gi
EOF

A ce stade, la Capacity du PersistentVolumeClaim apparait toujours à 8Gi :

$ kubectl describe pvc test-pvc-too
Name:          test-pvc-too
Namespace:     default
StorageClass:  rwo-storage
Status:        Bound
Volume:        pvc-c06c760d-b718-48a5-b92f-56683049e6d2
Labels:        
Annotations:   pv.kubernetes.io/bind-completed: yes
               pv.kubernetes.io/bound-by-controller: yes
               volume.beta.kubernetes.io/storage-provisioner: rbd.csi.ceph.com
Finalizers:    [kubernetes.io/pvc-protection]
Capacity:      8Gi
Access Modes:  RWO
VolumeMode:    Filesystem
Mounted By:    
Conditions:
  Type                      Status  LastProbeTime                     LastTransitionTime                Reason  Message
  ----                      ------  -----------------                 ------------------                ------  -------
  FileSystemResizePending   True    Mon, 01 Jan 0001 00:00:00 +0000   Mon, 11 Jan 2021 10:05:05 +0000           Waiting for user to (re-)start a pod to finish file system resize of volume on node.
Events:
  Type     Reason                    Age                    From                                                                                             Message
  ----     ------                    ----                   ----                                                                                             -------
  Normal   Provisioning              9m39s                  rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8  External provisioner is provisioning volume for claim "default/test-pvc-too"
  Normal   ExternalProvisioning      9m36s (x2 over 9m39s)  persistentvolume-controller                                                                      waiting for a volume to be created, either by external provisioner "rbd.csi.ceph.com" or manually created by system administrator
  Normal   ProvisioningSucceeded     9m34s                  rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8  Successfully provisioned volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
  Warning  ExternalExpanding         71s                    volume_expand                                                                                    Ignoring the PVC: didn't find a plugin capable of expanding the volume; waiting for an external controller to process this PVC.
  Normal   Resizing                  71s                    external-resizer rbd.csi.ceph.com                                                                External resizer is resizing volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
  Normal   FileSystemResizeRequired  70s                    external-resizer rbd.csi.ceph.com                                                                Require file system resize of volume on node
$ kubectl get events
10m         Normal    FileSystemResizeRequired     persistentvolumeclaim/test-pvc-too   Require file system resize of volume on node
10m         Normal    Resizing                     persistentvolumeclaim/test-pvc-too   External resizer is resizing volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
10m         Warning   ExternalExpanding            persistentvolumeclaim/test-pvc-too   Ignoring the PVC: didn't find a plugin capable of expanding the volume; waiting for an external controller to process this PVC.
18m         Normal    ExternalProvisioning         persistentvolumeclaim/test-pvc-too   waiting for a volume to be created, either by external provisioner "rbd.csi.ceph.com" or manually created by system administrator
18m         Normal    Provisioning                 persistentvolumeclaim/test-pvc-too   External provisioner is provisioning volume for claim "default/test-pvc-too"
18m         Normal    ProvisioningSucceeded        persistentvolumeclaim/test-pvc-too   Successfully provisioned volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
21m         Normal    Provisioning                 persistentvolumeclaim/test-pvc-too   External provisioner is provisioning volume for claim "default/test-pvc-too"

Nous sommes donc en attente que ce volume soit rattaché à un noeud, pour que son système de fichiers soit étendu.

Nous pourrons créer le Pod suivant, pour finaliser l’opération, tout en confirmant que l’on peut bien rattacher nos volumes aux noeuds Kubernetes :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: Pod
metadata:
  name: ceph-test
  namespace: default
spec:
  nodeSelector:
    kubernetes.io/arch: arm64
  containers:
  - name: dummy
    command: [ /bin/sh ]
    args:
    - -c
    - sleep 86400
    image: busybox
    volumeMounts:
    - name: mypvc
      mountPath: /data
  securityContext:
    runAsUser: 1001
  volumes:
  - name: mypvc
    persistentVolumeClaim:
      claimName: test-pvc-too
EOF

Nous pourrons suivre les logs d’attachement du volume, depuis le Pod rbdplugin s’executant sur le noeud où notre conteneur de test a été schedulé :

$ kubectl get pods -o wide | grep ceph-test
ceph-test   1/1     Running   0          8s    10.233.198.3   erato.friends.intra.example.com

$ kubectl get pods -o wide -n rbd-provisioner | grep erato
csi-rbdplugin-ldqrb    3/3     Running   0          24m   10.42.253.46    erato.friends.intra.example.com

$ kubectl logs -n rbd-provisioner csi-rbdplugin-ldqrb -c csi-rbdplugin
...
I0111 10:07:32.267613     537 utils.go:132] ID: 15 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:32.267854     537 utils.go:133] ID: 15 GRPC request: {}
I0111 10:07:32.269571     537 utils.go:138] ID: 15 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:32.296373     537 utils.go:132] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC call: /csi.v1.Node/NodeStageVolume
I0111 10:07:32.298122     537 utils.go:133] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC request: {"secrets":"***stripped***","staging_target_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount","volume_capability":{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}},"volume_context":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","imageName":"k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda","journalPool":"kube","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","radosNamespace":"","storage.kubernetes.io/csiProvisionerIdentity":"1610358940742-8081-rbd.csi.ceph.com","volumeNamePrefix":"k8s-rpi-"},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda"}
I0111 10:07:32.299358     537 rbd_util.go:808] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda setting disableInUseChecks on rbd volume to: false
I0111 10:07:32.375106     537 omap.go:84] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda got omap values: (pool="kube", namespace="", name="csi.volume.4b509ebf-53f3-11eb-a32d-e210cfc3feda"): map[csi.imageid:1004b3115f3d9b csi.imagename:k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda csi.volname:pvc-c06c760d-b718-48a5-b92f-56683049e6d2]
I0111 10:07:34.685087     537 cephcmds.go:59] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda command succeeded: rbd [device list --format=json --device-type nbd]
I0111 10:07:36.260359     537 rbd_attach.go:215] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd: map mon 10.42.253.110,10.42.253.111,10.42.253.112
I0111 10:07:38.881072     537 cephcmds.go:59] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda command succeeded: rbd [--id kube -m 10.42.253.110,10.42.253.111,10.42.253.112 --keyfile=***stripped*** map kube/k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda --device-type nbd --options nbds_max=16]
I0111 10:07:38.881490     537 nodeserver.go:291] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd image: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda/kube was successfully mapped at /dev/nbd0
I0111 10:07:42.568682     537 nodeserver.go:230] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd: successfully mounted volume 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda to stagingTargetPath /var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount/0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
I0111 10:07:42.568974     537 utils.go:138] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC response: {}
I0111 10:07:42.584611     537 utils.go:132] ID: 17 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:42.585122     537 utils.go:133] ID: 17 GRPC request: {}
I0111 10:07:42.585505     537 utils.go:138] ID: 17 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:42.592659     537 utils.go:132] ID: 18 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:42.593737     537 utils.go:133] ID: 18 GRPC request: {}
I0111 10:07:42.594932     537 utils.go:138] ID: 18 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:42.606252     537 utils.go:132] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC call: /csi.v1.Node/NodeExpandVolume
I0111 10:07:42.606900     537 utils.go:133] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC request: {"capacity_range":{"required_bytes":17179869184},"staging_target_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount","volume_capability":{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda","volume_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount"}
I0111 10:07:44.925118     537 cephcmds.go:59] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda command succeeded: rbd [device list --format=json --device-type nbd]
I0111 10:07:45.529426     537 utils.go:138] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC response: {}
I0111 10:07:45.583743     537 utils.go:132] ID: 20 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:45.583850     537 utils.go:133] ID: 20 GRPC request: {}
I0111 10:07:45.584001     537 utils.go:138] ID: 20 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:45.606729     537 utils.go:132] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC call: /csi.v1.Node/NodePublishVolume
I0111 10:07:45.607477     537 utils.go:133] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC request: {"staging_target_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount","target_path":"/var/lib/kubelet/pods/4e062abc-7fd4-4384-9c77-9469dde98fe4/volumes/kubernetes.io~csi/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/mount","volume_capability":{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}},"volume_context":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","imageName":"k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda","journalPool":"kube","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","radosNamespace":"","storage.kubernetes.io/csiProvisionerIdentity":"1610358940742-8081-rbd.csi.ceph.com","volumeNamePrefix":"k8s-rpi-"},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda"}
I0111 10:07:45.608877     537 nodeserver.go:518] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda target /var/lib/kubelet/pods/4e062abc-7fd4-4384-9c77-9469dde98fe4/volumes/kubernetes.io~csi/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/mount
isBlock false
fstype ext4
stagingPath /var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount/0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
readonly false
mountflags [bind _netdev]
I0111 10:07:45.643938     537 nodeserver.go:426] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd: successfully mounted stagingPath /var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount/0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda to targetPath /var/lib/kubelet/pods/4e062abc-7fd4-4384-9c77-9469dde98fe4/volumes/kubernetes.io~csi/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/mount
I0111 10:07:45.644138     537 utils.go:138] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC response: {}

Et enfin confirmer que le volume a bien été agrandi :

$ kubectl exec -it ceph-test -- /bin/sh
/ $ df -h /data
Filesystem                Size      Used Available Use% Mounted on
/dev/nbd0                15.6G     44.0M     15.6G   0% /data
/ $ exit
$ kubectl get pvc
NAME           STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS   AGE
test-pvc-too   Bound    pvc-c06c760d-b718-48a5-b92f-56683049e6d2   16Gi       RWO            rwo-storage    12m
$ kubectl delete pod ceph-test
EOF

Moins critique, mais à contrôler tout de même, vérifions que la suppression d’un volume fonctionne :

$ kubectl describe pv pvc-c06c760d-b718-48a5-b92f-56683049e6d2
Name:            pvc-c06c760d-b718-48a5-b92f-56683049e6d2
Labels:          
Annotations:     pv.kubernetes.io/provisioned-by: rbd.csi.ceph.com
Finalizers:      [kubernetes.io/pv-protection]
StorageClass:    rwo-storage
Status:          Bound
Claim:           default/test-pvc-too
Reclaim Policy:  Delete
Access Modes:    RWO
VolumeMode:      Filesystem
Capacity:        16Gi
Node Affinity:   
Message:         
Source:
    Type:              CSI (a Container Storage Interface (CSI) volume source)
    Driver:            rbd.csi.ceph.com
    FSType:            ext4
    VolumeHandle:      0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
    ReadOnly:          false
    VolumeAttributes:      clusterID=eb53775c-ec88-484f-b5f5-b421b55079d7
                           csi.storage.k8s.io/pv/name=pvc-c06c760d-b718-48a5-b92f-56683049e6d2
                           csi.storage.k8s.io/pvc/name=test-pvc-too
                           csi.storage.k8s.io/pvc/namespace=default
                           imageFeatures=layering
                           imageFormat=2
                           imageName=k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda
                           journalPool=kube
                           mapOptions=nbds_max=16
                           mounter=rbd-nbd
                           pool=kube
                           radosNamespace=
                           storage.kubernetes.io/csiProvisionerIdentity=1610358940742-8081-rbd.csi.ceph.com
                           volumeNamePrefix=k8s-rpi-
Events:                
$ kubectl delete pvc test-pvc-too

Notons l’imageName, qui correspond au nom du volume du point de vue de notre cluster Ceph, avant de supprimer le PersistentVolumeClaim.

Depuis l’un des noeuds du cluster Ceph, nous pourrons confirmer que ce volume est présent, avant suppression du PersistentVolumeClaim, et qu’il n’existe plus ensuite :

[root@mon1 ~]# rbd -p kube ls | grep k8s-rpi
k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda
k8s-rpi-606956de-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-60695852-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-82e2ef87-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-c85d564d-50ea-11eb-9407-4e8ab1a29c3f
k8s-rpi-e10db2bd-526d-11eb-a0b5-0eaaf84a28e4
...
[root@mon1 ~]# rbd -p kube ls | grep k8s-rpi
k8s-rpi-606956de-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-60695852-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-82e2ef87-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-c85d564d-50ea-11eb-9407-4e8ab1a29c3f
k8s-rpi-e10db2bd-526d-11eb-a0b5-0eaaf84a28e4

Une fois la suppression du volume effective sur Kubernetes, nous pouvons confirmer que le volume Ceph correspondant a bien été supprimé.

Création, expansion, suppression, attachement et détachement des volumes du noeud : tout est en ordre.

Registry Docker

Registry Docker

Nous pourrons maintenant passer aux choses sérieuses, de déployer nos premières applications, à commencer par Prometheus, sujet sur lequel nous reviendrons dans un autre article, ou pour patienter, une registry Docker :

$ kubeclt create ns registry
$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: Service
metadata:
  name: registry
  namespace: registry
spec:
  ports:
  - name: registry
    port: 5000
  selector:
    k8s-app: registry
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: registry-pvc
  namespace: registry
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 100Gi
---
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: registry
  namespace: registry
spec:
  replicas: 1
  selector:
    matchLabels:
      name: registry
  template:
    metadata:
      labels:
        name: registry
    spec:
      containers:
      - env:
        - name: REGISTRY_HTTP_ADDR
          value: :5000
        - name: REGISTRY_STORAGE_FILESYSTEM_ROOTDIRECTORY
          value: /var/lib/registry
        image: docker.io/library/registry:2.7.1
        imagePullPolicy: IfNotPresent
        name: registry
        ports:
        - containerPort: 5000
          name: registry
          protocol: TCP
        volumeMounts:
        - mountPath: /var/lib/registry
          name: registry-pvc
      volumes:
      - persitentVolumeClaim:
          claimName: registry-pvc
        name: registry-pvc
EOF

Rappelons alors que nous avions deployé Kubernetes avec, dans l’inventaire Kubespray, la variable suivante :

containerd_config:
  grpc:
    max_recv_message_size: 16777216
    max_send_message_size: 16777216
  debug:
    level: ""
  registries:
    docker.io: "https://registry-1.docker.io"
    katello: "https://katello.vms.intra.example.com:5000"
    "registry.registry.svc.cluster.local:5000": "http://registry.registry.svc.cluster.local:5000"
  max_container_log_line_size: -1
  metrics:
    address: ""
    grpc_histogram: false

Nos noeuds sont donc déjà en mesure d’accéder à cette registry, libre à nous d’y pousser de premières images, … Un point sur lequel nous reviendrons dans un prochain article, consacré à Tekton.

Snapshots

Enfin, notons que depuis Kubernetes 1.17, nous pourrons profiter d’une fonctionnalitée introduite par CSI, et déployer un snapshot controller.

Commencer par créer un ServiceAccount pour lui déléguer les privilèges nécessaire.

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: snapshot-controller
  namespace: rbd-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: snapshot-controller-runner
rules:
- apiGroups: [""]
  resources: ["persistentvolumes"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["persistentvolumeclaims"]
  verbs: ["get", "list", "watch", "update"]
- apiGroups: ["storage.k8s.io"]
  resources: ["storageclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["events"]
  verbs: ["list", "watch", "create", "update", "patch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotcontents"]
  verbs: ["create", "get", "list", "watch", "update", "delete"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshots"]
  verbs: ["get", "list", "watch", "update"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshots/status"]
  verbs: ["update"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: snapshot-controller-role
subjects:
- kind: ServiceAccount
  name: snapshot-controller
  namespace: rbd-provisioner
roleRef:
  kind: ClusterRole
  name: snapshot-controller-runner
  apiGroup: rbac.authorization.k8s.io
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: rbd-provisioner
  name: snapshot-controller-leaderelection
rules:
- apiGroups: ["coordination.k8s.io"]
  resources: ["leases"]
  verbs: ["get", "watch", "list", "delete", "update", "create"]
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: snapshot-controller-leaderelection
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: snapshot-controller
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: snapshot-controller-leaderelection
  apiGroup: rbac.authorization.k8s.io
EOF

Poursuivre en déployant le contrôleur :

$ cat <<EOF | kubectl apply -f-
---
kind: StatefulSet
apiVersion: apps/v1
metadata:
  name: snapshot-controller
  namespace: rbd-provisioner
spec:
  serviceName: snapshot-controller
  replicas: 1
  selector:
    matchLabels:
      app: snapshot-controller
  template:
    metadata:
      labels:
        app: snapshot-controller
    spec:
      serviceAccount: snapshot-controller
      containers:
      - name: snapshot-controller
        image: k8s.gcr.io/sig-storage/snapshot-controller:v3.0.2
        args:
        - "--v=5"
        - "--leader-election=false"
        imagePullPolicy: Always
        securityContext:
          runAsUser: 1001
EOF

Il faudra ensuite créer une VolumeSnapshotClass, semblable à notre StorageClass :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: snapshot.storage.k8s.io/v1beta1
kind: VolumeSnapshotClass
metadata:
  name: csi-rbdplugin-snapclass
driver: rbd.csi.ceph.com
parameters:
  clusterID: eb53775c-ec88-484f-b5f5-b421b55079d7
  snapshotNamePrefix: k8s-rpi-snap-
  csi.storage.k8s.io/snapshotter-secret-name: ceph-secret-admin
  csi.storage.k8s.io/snapshotter-secret-namespace: rbd-provisioner
deletionPolicy: Delete
EOF

Enfin, nous pourrons manipuler nos snapshots Ceph depuis l’API de notre cluster Kubernetes.

Demander la création d’un snapshot d’un volume existant en créant un VolumeSnapshot :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: snapshot.storage.k8s.io/v1beta1
kind: VolumeSnapshot
metadata:
  name: rbd-pvc-snapshot
  namespace: downloads
spec:
  volumeSnapshotClassName: csi-rbdplugin-snapclass
  source:
    persistentVolumeClaimName: medusa-kube
EOF
$ kubectl get volumesnapshot -n downloads
NAME               READYTOUSE   SOURCEPVC     SOURCESNAPSHOTCONTENT   RESTORESIZE   SNAPSHOTCLASS             SNAPSHOTCONTENT                                    CREATIONTIME   AGE
rbd-pvc-snapshot   false        medusa-kube                                         csi-rbdplugin-snapclass   snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225                  31s

Nous pourrons suivre la création du snapshot, en interrogeant les logs de notre contrôleur :

$ kubectl logs -n rbd-provisioner snapshot-controller-0 -f
I0129 13:57:28.404847       1 main.go:66] Version: v3.0.2
I0129 13:57:28.410398       1 main.go:93] Start NewCSISnapshotController with kubeconfig [] resyncPeriod [1m0s]
I0129 13:57:28.412022       1 reflector.go:207] Starting reflector *v1beta1.VolumeSnapshotContent (1m0s) from github.com/kubernetes-csi/external-snapshotter/client/v3/informers/externalversions/factory.go:117
[...]
I0129 14:03:58.732509       1 snapshot_controller_base.go:158] enqueued "downloads/rbd-pvc-snapshot" for sync
I0129 14:03:58.732586       1 snapshot_controller_base.go:202] syncSnapshotByKey[downloads/rbd-pvc-snapshot]
I0129 14:03:58.732611       1 snapshot_controller_base.go:205] snapshotWorker: snapshot namespace [downloads] name [rbd-pvc-snapshot]
I0129 14:03:58.732632       1 snapshot_controller_base.go:328] checkAndUpdateSnapshotClass [rbd-pvc-snapshot]: VolumeSnapshotClassName [csi-rbdplugin-snapclass]
[...]
I0129 14:04:35.033443       1 snapshot_controller_base.go:222] Updating snapshot "downloads/rbd-pvc-snapshot"
I0129 14:04:35.033988       1 snapshot_controller_base.go:358] updateSnapshot "downloads/rbd-pvc-snapshot"
I0129 14:04:35.034056       1 util.go:258] storeObjectUpdate updating snapshot "downloads/rbd-pvc-snapshot" with version 21039253
I0129 14:04:35.034157       1 snapshot_controller.go:180] synchronizing VolumeSnapshot[downloads/rbd-pvc-snapshot]: bound to: "snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225", Completed: true
I0129 14:04:35.034182       1 snapshot_controller.go:182] syncSnapshot [downloads/rbd-pvc-snapshot]: check if we should remove finalizer on snapshot PVC source and remove it if we can
I0129 14:04:35.034228       1 snapshot_controller.go:903] checkandRemovePVCFinalizer for snapshot [rbd-pvc-snapshot]: snapshot status [&v1beta1.VolumeSnapshotStatus{BoundVolumeSnapshotContentName:(*string)(0x40004c1940), CreationTime:(*v1.Time)(0x4000350de0), ReadyToUse:(*bool)(0x4000527b9e), RestoreSize:(*resource.Quantity)(0x4000374c00), Error:(*v1beta1.VolumeSnapshotError)(nil)}]
I0129 14:04:35.034334       1 snapshot_controller.go:858] Checking isPVCBeingUsed for snapshot [downloads/rbd-pvc-snapshot]
I0129 14:04:35.034473       1 snapshot_controller.go:883] isPVCBeingUsed: no snapshot is being created from PVC downloads/medusa-kube
I0129 14:04:35.034515       1 snapshot_controller.go:911] checkandRemovePVCFinalizer[rbd-pvc-snapshot]: Remove Finalizer for PVC medusa-kube as it is not used by snapshots in creation
I0129 14:04:35.059226       1 snapshot_controller.go:851] Removed protection finalizer from persistent volume claim medusa-kube
I0129 14:04:35.059293       1 snapshot_controller.go:191] syncSnapshot[downloads/rbd-pvc-snapshot]: check if we should add invalid label on snapshot
I0129 14:04:35.059312       1 snapshot_controller.go:209] syncSnapshot[downloads/rbd-pvc-snapshot]: validate snapshot to make sure source has been correctly specified
I0129 14:04:35.059329       1 snapshot_controller.go:218] syncSnapshot[downloads/rbd-pvc-snapshot]: check if we should add finalizers on snapshot
I0129 14:04:35.059355       1 snapshot_controller.go:386] syncReadySnapshot[downloads/rbd-pvc-snapshot]: VolumeSnapshotContent "snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225" found
I0129 14:04:39.890672       1 reflector.go:515] github.com/kubernetes-csi/external-snapshotter/client/v3/informers/externalversions/factory.go:117: Watch close - *v1beta1.VolumeSnapshot total 5 items received

Une fois le snapshot finalisé, nous devrions pouvoir confirmer que la colonne READYTOUSE est devenue true :

$ kubectl get volumesnapshot -n downloads
NAME               READYTOUSE   SOURCEPVC     SOURCESNAPSHOTCONTENT   RESTORESIZE   SNAPSHOTCLASS             SNAPSHOTCONTENT                                    CREATIONTIME   AGE
rbd-pvc-snapshot   true         medusa-kube                           8Gi           csi-rbdplugin-snapclass   snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225   14s            46s

Vérifions aussi sur le cluster Ceph, que notre snapshot est bien présent :

$ rbd -p kube ls
k8s-rpi-02f29ddf-5e51-11eb-a107-3a439f3884b7
...
k8s-rpi-e462aa11-5e54-11eb-a107-3a439f3884b7
k8s-rpi-snap-e725bd91-623a-11eb-8935-9e78daa852af

Controverse

La situation n’est pas parfaite, et il faut ici mentionner un problème de taille, commun à toutes les implémentations de CSI.

Lorsqu’un noeud ne répond plus, son status change en NotReady. Après un timeout, si celui-ci ne s’est pas manifesté, Kubernetes doit re-scheduler les Pods impactés sur un autre noeud.

Mais aujourd’hui, la spécification CSI veut que le contrôleur en charge d’attacher un volume a un noeud, lorsqu’il s’attribue un volume, créé un lease, empêchant l’attachement par un autre noeud lorsque notre volume a un accessModes de ReadWriteOnce.

Ceci implique donc que lorsqu’un noeud devient injoignable, l’attacher en question n’est plus en mesure de relacher son lock. Les Pods rattachés à de tels volumes ne seront pas en mesure de démarrer, tant que le noeud souffrant d’un incident ne sera pas revenu.

Nous pourrons reproduire, en débranchant le réseau d’un noeud hébergeant de tels Pods. Une fois que notre nouveau Pod est schedulé sur un noeud sain, nous retrouverons un évènement tel que le suivant :

Events:
  Type     Reason              Age   From                     Message
  ----     ------              ----  ----                     -------
  Normal   Scheduled           13s   default-scheduler        Successfully assigned downloads/sabnzbd-kube-7fdff54694-5v6zb to melpomene.friends.intra.example.com
  Warning  FailedAttachVolume  13s   attachdetach-controller  Multi-Attach error for volume "pvc-33c81bfe-109f-4439-8979-d5e6309f42fe" Volume is already used by pod(s) sabnzbd-kube-7fdff54694-mzst9

Il s’agit là d’une régression, par rapport aux versions plus anciennes de Kubernetes.

Le plus simple, à ce stade, sera de redémarrer le noeud fautif, en espérant que celui-ci rejoigne bien le cluster – ce qui ne sera pas garanti, notament lors d’incidents impactant un disque.

Pour l’instant, l’utilisation de volumes NFS, quoi que rarement recommandé, sera l’une des dernières pouvant fonctionner sans CSI, et ne souffrant donc pas de ce problème.

Si les premières versions de CSI ne permettaient en aucun cas de remonter un volume lors de tels incidents, notons que les dernières releases ont introduit une solution de contournement. En effet, nous retrouverons aujourd’hui ces locks, empêchant l’accès à une PersistentVolumeClaim par d’autres noeuds, en interrogeant les VolumeAttachments du cluster.

# kubectl describe pvc -n downloads sabnzbd-kube
Name:          sabnzbd-kube
Namespace:     downloads
StorageClass:  rwo-storage
Status:        Bound
Volume:        pvc-33c81bfe-109f-4439-8979-d5e6309f42fe
...
# kubectl get volumeattachments
NAME                                                                 ATTACHER         PV                                       NODE                             ATTACHED   AGE
...
csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f rbd.csi.ceph.com pvc-33c81bfe-109f-4439-8979-d5e6309f42fe clio.friends.intra.example.com   true       23m
...
# kubectl describe volumeattachment csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f
Name:         csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f
...
Spec:
  Attacher:   rbd.csi.ceph.com
  Node Name:  clio.friends.intra.example.com
  Source:
    Persistent Volume Name:  pvc-33c81bfe-109f-4439-8979-d5e6309f42fe
...
# kubectl delete volumeattachment csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f
volumeattachment.storage.k8s.io "csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f" deleted
# kubectl get events -n downloads -w
...
0s          Normal    SuccessfulAttachVolume   pod/sabnzbd-kube-7fdff54694-5v6zb    AttachVolume.Attach succeeded for volume "pvc-33c81bfe-109f-4439-8979-d5e6309f42fe"

Après suppression du VolumeAttachment mentionnant le nom de notre PersistentVolume, nous pouvons confirmer que le nouveau Pod démarre finalement.

Et de même, nous pouvons voire que si ce VolumeAttachment n’est pas supprimé, notre Pod témoin refuse de se lancer :

root@pandore:~# kubectl get pods -o wide -n downloads -w
NAME                                  READY  STATUS             RESTARTS  AGE    IP              NODE
backups-kube-64fb9d44cd-dgdws         2/2    Running            0         13m    10.233.198.25   erato.friends.intra.example.com
medusa-kube-7ff5cbfd66-4jrj5          0/2    ContainerCreating  0         6m24s            euterpe.friends.intra.example.com
medusa-kube-7ff5cbfd66-zhr7f          2/2    Terminating        0         15m    10.233.197.116  clio.friends.intra.example.com
newznab-kube-669d69ddc8-8r682         4/4    Running            0         7d15h  10.233.193.25   epimethee.friends.intra.example.com
newznab-mariadb-kube-6c67d6b57-2kt5t  2/2    Running            0         7d16h  10.233.195.40   pyrrha.friends.intra.example.com
sabnzbd-kube-7fdff54694-5v6zb         3/4    Running            0         6m24s  10.233.200.39   melpomene.friends.intra.example.com
sabnzbd-kube-7fdff54694-mzst9         4/4    Terminating        0         15m    10.233.197.115  clio.friends.intra.example.com
transmission-kube-c68dd989-9fk2j      4/4    Running            0         7d17h  10.233.195.36   pyrrha.friends.intra.example.com

Une fois nos applications de nouveau joignables, nous pourrons nous pencher sur notre noeud. Si son reboot n’a pas suffit, peut-être voudra-t-on le redéployer, réutilisant les mêmes noms et IPs. Ou le supprimer complètement du cluster, purgeant Node, Pods, VolumeAttachments, … toutes les ressources ingoignables.

Conclusion

Si les plateformes ARM ont pu souffrir du manque de plusieurs fonctionnalités par le passé, notament CSI, elles se prètent de mieux en mieux au déploiement de clusters Kubernetes. On y retrouve aujourd’hui tous les incontournables : Containerd, Prometheus, Tekton, …

Par ailleurs, l’arrivée des Raspberry 4, disposant de 4 ou 8G de mémoire RAM, en font un choix de prédilection, pour le déploiement d’un cluster Kubernetes.

En combinaison avec Ceph : une recette parfaite pour déployer votre cloud à moindre coût. Bien que l’on puisse regretter les lacunes de CSI.

🔲 ☆

Supervision et Métrologie Kubernetes

Donnant suite à notre article sur l’écosystème Prometheus, et celui sur le déploiement de Kubernetes sur Raspberry Pi, nous documenterons aujourd’hui le déploiement de Prometheus dans Kubernetes, afin de superviser notre cluster. Prometheus est particulièrement adapté au contexte de clusters OpenShift ou Kubernetes, celui-ci pouvant interroger l’API du cluster à la recherche de services à superviser. Logo Kubertnetes

Plusieurs modes de déploiement existent, divers opérateurs, à commencer par le Prometheus Operator, voire des charts Helm, ou s’appuyant sur Kustomize, …

Pour ne dépendre d’aucun framework, et corriger l’absence de support ARM pour une image, nous préférerons déployer les différentes composantes de Prometheus nous même. Ce choix restant arbitraire, les solutions évoquées ci-dessus restent pertinentes.

Déploiement de Prometheus

Vous trouverez les fichiers YAML servant au déploiement sur GitHub.

Dans un premier temps, déployer le serveur Prometheus :

$ git clone https://github.com/Worteks/k8s-prometheus
$ cd prometheus-k8s
$ kubectl create ns prometheus-monitoring
$ kubect apply -n prometheus-monitoring -f prometheus-serviceaccount.yaml
$ kubect apply -f prometheus-clusterrole.yaml
$ sed "s|NAMESPACE_SED|prometheus-monitoring|" prometheus-clusterrolebinding.yaml \
    | kubectl apply -f-
$ sed "s|NAMESPACE_SED|prometheus-monitoring|" prometheus-configmap.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ find prometheus-rules.d/ -type f -name '*.yaml' | cut -d/ -f2 | while read file
    do
        cmname=`echo "$file" | sed 's|\.yaml$||'`
        kubectl create cm prometheus-rule-$cmname --dry-run=client -o yaml \
            --from-file=$file=./prometheus-rules.d/$file \
            | kubectl apply -n prometheus-monitoring -f-
    done
$ kubectl apply -n prometheus-monitoring -f prometheus-statefulset.yaml
$ kubectl apply -n prometheus-monitoring -f prometheus-service.yaml
$ sed "s|ROOT_DOMAIN|demo.local|" prometheus-ingress.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ kubectl get pods -n prometheus-monitoring -w

Ici, nous avons créé un Namespace prometheus-monitoring. Dans ce Namespace, nous créons un ServiceAccount. Nous déclarons ensuite un ClusterRole, permettant d’interroger l’API du cluster à la recherche de noeuds, services, endpoints, … nécessaires à l’intégration de Prometheus dans Kubernetes. Le ClusterRoleBinding délègue les privilèges définis dans notre ClusterRole, au ServiceAccount créé précédemment. Nous déclarons ensuite une ConfigMap, encapsulant la configuration de notre serveur Prometheus. Celle-ci interrogera l’API du cluster Kubernetes, à la recherche de métriques relatives aux noeuds, ou de Services Kubernetes, fonctions de leurs labels. Nous importons alors une suite de règles, dans de nouvelles ConfigMap, définissant les seuils d’alerte, pour chacun des service que Prometheus pourrait superviser. Enfin, nous créons un StatefulSet et un Service. Un conteneur Prometheus se lance.

Une fois que celui-ci a démarré, nous pourrons nous connecter à l’interface Prometheus :

Interface Prometheus

Métrologie Kubernetes

Pour superviser un cluster Kubernetes, il faudra ensuite déployer kube-state-metrics, un exporteur agrégeant des métriques produites par l’interrogation de l’API du cluster Kubernetes, et décrivant sa composition :

$ kubectl apply -n prometheus-monitoring -f kube-state-metrics-serviceaccount.yaml
$ kubectl apply -f kube-state-metrics-clusterrole.yaml
$ sed "s|NAMESPACE_SED|prometheus-monitoring|" kube-state-metrics-clusterrolebinding.yaml \
    | kubectl apply -f-
$ kubectl apply -n prometheus-monitoring -f kube-state-metrics-deployment.yaml
$ kubectl apply -n prometheus-monitoring -f kube-state-metrics-service.yaml
$ kubectl get pods -n prometheus-monitoring -w

Nous pourrons de même déployer le DaemonSet node-exporter, exposant des métrique relatives aux noeuds, membres du cluster :

$ kubectl apply -n prometheus-monitoring -f node-exporter-serviceaccount.yaml
$ kubectl apply -f node-exporter-podsecuritypolicy.yaml
$ kubectl apply -f node-exporter-clusterrole.yaml
$ sed "s|NAMESPACE_SED|prometheus-monitoring|" node-exporter-clusterrolebinding.yaml \
    | kubectl apply -f-
$ kubectl apply -n prometheus-monitoring -f node-exporter-daemonset.yaml
$ kubectl apply -n prometheus-monitoring -f node-exporter-service.yaml

Une fois ces services déployés, de retour sur l’interface Prometheus, nous devrions retrouver leurs métriques :

Prometheus metriques

Supervision

Si l’on veut que des alertes soient émises, fonction des règles que nous avons préalablement chargées en déployant Prometheus, alors nous devrons déployer l’AlertManager. Pour renvoyer vos alertes vers Slack, utiliser :

$ sed "s|SLACK_URL_SED|https://hooks.slack.com/services/XXX/YYY/ZZZZZZZ|" \
    alertmanager-secret-slack.yaml | echo kubectl apply -n prometheus-monitoring -f-
$ kubectl apply -n prometheus-monitoring -f alertmanager-statefulset.yaml
$ kubectl apply -n prometheus-monitoring -f alertmanager-service.yaml
$ sed "s|ROOT_DOMAIN|demo.local|" alertmanager-ingress.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ kubectl apply -n prometheus-monitoring -f alertmanager-exporter-service.yaml

Si l’on avait voulu renvoyer ces notifications vers un relais SMTP, nous aurions pu utiliser :

$ sed -e "s|MAILFROM_SED|alertmanager@demo.local|" \
    -e "s|MAILRELAY_SED|smtp.demo.local|" \
    -e "s|MAILTO_SED|alerts-monitoring@demo.local|" \
    alertmanager-secret-mails.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ kubectl apply -n prometheus-monitoring -f alertmanager-statefulset.yaml
$ kubectl apply -n prometheus-monitoring -f alertmanager-service.yaml
$ kubectl apply -n prometheus-monitoring -f alertmanager-exporter-service.yaml
$ sed "s|ROOT_DOMAIN|demo.local|" alertmanager-ingress.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ kubectl get pods -n prometheus-monitoring -w

Quand ce conteneur aura démarré, nous pourrons nous y connecter :

Alertmanager

Dashboards

Enfin, nous pourrons rajouter un déploiement de Grafana, pour y visualiser les métriques Prometheus :

$ find grafana-dashboards.d/ -type f -name '*.json' | cut -d/ -f2 | while read file; \
    do
        cmname=`echo "$file" | tr [A-Z] [a-z] | sed -e 's|[_-]*||' -e 's|\.json\$||'`
        kubectl create cm grafana-dashboard-$cmname \
            --dry-run=client -o yaml \
            --from-file=$$file=./grafana-dashboards.d/$$file \
            | kubectl apply -n prometheus-monitoring -f-; \
    done
$ sed -e "s|GRAFANA_ADMIN_PASSWORD|secret|" \
    -e "s|ROOT_DOMAIN|demo.local|" \
    grafana-secret.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ sed "s|NAMESPACE_SED|prometheus-monitoring|" grafana-prometheus-configmap.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ kubectl apply -n prometheus-monitoring -f grafana-deployment.yaml
$ kubectl apply -n prometheus-monitoring -f grafana-service.yaml
$ sed "s|ROOT_DOMAIN|demo.local|" grafana-ingress.yaml \
    | kubectl apply -n prometheus-monitoring -f-
$ kubectl get pods -n prometheus-monitoring -w

À nouveau, attendre que le Pod ne se lance pour se connecter à l’interface. Plusieurs dashboards sont déja présentes, chargées depuis le dossier grafana-dashboards.d, et majoritairement reprises des exemples disponibles sur grafana.com :

Dashboard1

Suivant les applications déployées sur votre cluster, certaines dashboards trouveront leur utilité :

Dashboards2

Conclusion

Déployer Prometheus pour superviser un cluster Kubernetes représente un gain non négligeable, en termes de simplicité et maintenabilité, par opposition aux solutions plus traditionnelles comme Icinga, Shinken, Centreon ou Zabbix, et plus fiable que certaines solutions cloud native comme Datadog.

Si l’écosystème Prometheus constitue une excellente solution de supervision, dans le contexte d’un cluster Kubernetes, il s’agit d’un incontournable.

🔲 ☆

Déploiement Kubernetes sur Raspberry Pi

Aujourd’hui, nous procéderons au déploiement d’un cluster Kubernetes sur Raspberry PI.
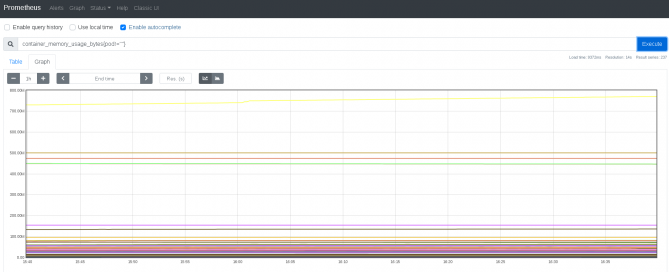
On ne présente plus Kubernetes, solution de conteneurisation open-source, simplifiant le déploiement, la mise à l’échelle, et la gestion en général, d’applications conteneurisées. Ni Raspberry-Pi, ordinateur ARM, de la taille d’une carte de crédit, idéal pour vos projets domotique, IoT, rétro-gaming, …
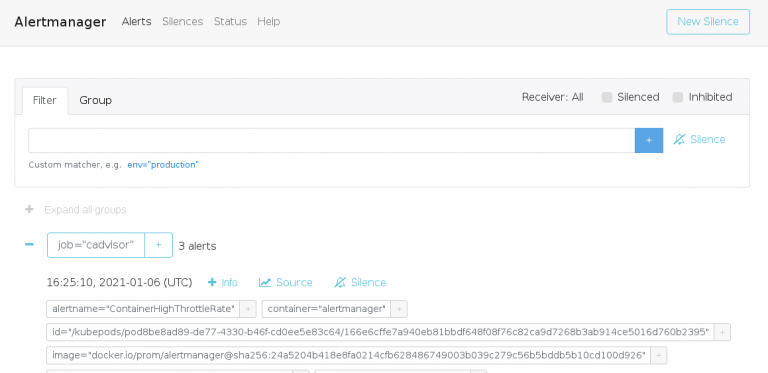
Notre cluster sera composé d’une douzaine de noeuds, et d’un LoadBalancer. Nous le déploierons à l’aide de Kubespray, outil de déploiement faisant partie de l’écosystème Kubernetes, modulaire, fiable, et relativement exhaustif.

Préparatifs Raspbian

Commençons par télécharger Raspbian.

Pour les noeuds master, il est impératif d’utiliser une image 64b, sans quoi Kubespray ne sait pas installer etcd. Nous retrouverons une image beta du projet Raspbian, fournissant une version arm64. Le problème étant que les mainteneurs du projet etcd ne publient pas de version 32b. Notons qu’il reste possible d’installer une version 32b d’etcd, fournie par Debian, quoi que Kubespray ne supporte pas cette combinaison.

Pour nos autres noeuds, nous pourrons utiliser la dernière image officiel Raspbian.

Une fois ces archives téléchargées et extraites, nous pourrons flasher les cartes micro-sd de nos Raspberry Pi :

$ dd if=./2020-08-20-raspios-buster-arm64-lite.img | pv | dd of=/dev/mmcblk0

Cluster-rapsi

Démarrer le Raspberry, avec écran et clavier, afin d’y configurer un mot de passe root :

$ sudo -i
# passwd

Une addresse IP statique :

# cat <<EOF >/etc/network/interfaces
auto eth0
iface eth0 inet static
    address x.y.z.a
    netmask 255.255.255.0
    gateway x.y.z.b
EOF

Serveur DNS :

# cat <<EOF >/etc/resolv.conf
nameserver 10.255.255.255
domain friends.intra.example.com
search friends.intra.example.com
EOF

Désactiver le fichier d’échange swap :

# sed -i 's|CONF_SWAPSIZE=.*|CONF_SWAPSIZE=0|' /etc/dphys-swapfile
# systemctl disable dphys-swapfile

Configurer le serveur SSH :

# sed -i -e 's|#PermitRootLog.*|PermitRootLogin yes|' -e 's|#PasswordAuth|PasswordAuthentication yes|' /etc/ssh/sshd_config
# systemctl enable ssh

Désactiver les services réseaux que nous n’utiliserons pas :

# systemctl disable dhcpcd
# systemctl disable wpa_supplicant
# systemctl disable bluetooth

Configurer le nom de la machine :

# cat <<EOF >/etc/hostname
EOF
# cat <<EOF >/etc/hosts
x.y.z.a <fqdn> <hostname>
127.0.0.1 <fqdn> <hostname>
127.0.0.1 localhost
::1 localhost6 localhost6.localdomain
ff02::1 ip6-allnodes
ff02::2 ip6-allrouters
EOF

Activer les cgroups mémoire :

# sed -i 's|rootwait$|rootwait cgroup_enable=cpuset cgroup_enable=memory|' /boot/cmdline.txt
# cat /boot/cmdline.txt
console=serial0,115200 console=tty1 root=PARTUUID=dcca89ee-02 rootfstype=ext4 elevator=deadline fsck.repair=yes rootwait cgroup_enable=cpuset cgroup_enable=memory

Redémarrer, et vérifier les mots de passe root, IP, gateway, groups mémoire, … puis mettre le système à jour :

# cat /proc/cgroups
#subsys_name hierarchy num_cgroups enabled
...
memory 9 186 1
....
# hostname -s
# hostname -f
# ip a
# ip r
# apt-get update --allow-releaseinfo-change
# apt-get install python-apt cgroupfs-mount ceph-common rbd-nbd
# apt-get upgrade
# apt-get dist-upgrade

LoadBalancer Kubernetes

Raspberry 3 et 4 conviendront parfaitement au déploiement de Kubernetes. En revanche, les modèles plus anciens seront incapables de lancer certaines composantes Kubernetes, faute d’images adaptées à leur ARM v6.

Profitons d’un Raspberry 2b, pour y déployer le LoadBalancer, qui se trouvera devant le service API des masters Kubernetes :

# apt-get install haproxy hatop
# cat <<EOF >/etc/haproxy/haproxy.cfg
global
    log /dev/log local0
    log /dev/log local1 notice
    chroot /var/lib/haproxy
    stats socket /run/haproxy/admin.sock mode 660 level admin expose-fd listeners
    stats timeout 30s
    user haproxy
    group haproxy
    daemon
    ca-base /etc/ssl/certs
    crt-base /etc/ssl/private
    ssl-default-bind-ciphers ECDH+AESGCM:DH+AESGCM:ECDH+AES256:DH+AES256:ECDH+AES128:DH+AES:RSA+AESGCM:RSA+AES:!aNULL:!MD5:!DSS
    ssl-default-bind-options no-sslv3

defaults
    log global
    option dontlognull
    timeout connect 5000
    timeout client 50000
    timeout server 50000
    errorfile 400 /etc/haproxy/errors/400.http
    errorfile 403 /etc/haproxy/errors/403.http
    errorfile 408 /etc/haproxy/errors/408.http
    errorfile 500 /etc/haproxy/errors/500.http
    errorfile 502 /etc/haproxy/errors/502.http
    errorfile 503 /etc/haproxy/errors/503.http
    errorfile 504 /etc/haproxy/errors/504.http

listen kubernetes-apiserver-https
    bind 0.0.0.0:6443
    mode tcp
    option log-health-checks
    timeout client 3h
    timeout server 3h
    server master1 10.42.253.40:6443 check check-ssl verify none inter 10s
    server master2 10.42.253.41:6443 check check-ssl verify none inter 10s
    server master3 10.42.253.42:6443 check check-ssl verify none inter 10s
    balance roundrobin
EOF
# cat <<EOF >/etc/profile.d/haproxy.sh
alias hatop='hatop -s /run/haproxy/admin.sock'
EOF
# systemctl start haproxy
# systemctl enable haproxy
# . /etc/profile.d/haproxy.sh
# hatop

Préparatifs Ansible

Il nous faudra ensuite préparer le noeud Ansible.

Nous pourrions déployer depuis un laptop, ou n’importe quel poste. L’utilisation d’une machine dédié simplifiera les interventions futures sur le cluster, s’assurant que les mêmes versions de kubespray, python, ansible, … soient utilisées, si l’on veut, par exemple, rajouter un noeud.

Commençons par installer les playbooks Kubespray, et Ansible :

$ sudo apt-get install python-pip git ca-certificates
$ git clone https://github.com/kubernetes-sigs/kubespray
$ cd kubespray
$ sudo pip install -r requirements.txt

Nous devrons alors préparer l’inventaire, listant les machines composant notre cluster :

$ mkdir -p inventory/rpi/group_vars/all inventory/rpi/group_vars/all/k8s-cluster
$ cat <<EOF >inventory/rpi/hosts.yaml
all:
  hosts:
    pandore.friends.intra.example.com:
      etcd_member_name: pandore
      node_labels:
        my.topology/rack: rpi-rack1
        my.topology/row: rpi-row2
    hellenes.friends.intra.example.com:
      etcd_member_name: hellenes
      node_labels:
        my.topology/rack: rpi-rack2
        my.topology/row: rpi-row2
    epimethee.friends.intra.example.com:
      etcd_member_name: epimethee
      node_labels:
        my.topology/rack: rpi-rack3
        my.topology/row: rpi-row2
    pyrrha.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack1
        my.topology/row: rpi-row3
        node-role.kubernetes.io/infra: "true"
    calliope.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack2
        my.topology/row: rpi-row3
        node-role.kubernetes.io/infra: "true"
    clio.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack3
        my.topology/row: rpi-row3
        node-role.kubernetes.io/infra: "true"
    erato.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack1
        my.topology/row: rpi-row4
        node-role.kubernetes.io/worker: "true"
    euterpe.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack2
        my.topology/row: rpi-row4
        node-role.kubernetes.io/worker: "true"
    melpomene.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack3
        my.topology/row: rpi-row4
        node-role.kubernetes.io/worker: "true"
    polyhymnia.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack3
        my.topology/row: rpi-row1
        node-role.kubernetes.io/worker: "true"
    terpsichore.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack2
        my.topology/row: rpi-row1
        node-role.kubernetes.io/worker: "true"
    thalia.friends.intra.example.com:
      node_labels:
        my.topology/rack: rpi-rack1
        my.topology/row: rpi-row1
        node-role.kubernetes.io/worker: "true"
  children:
    calico-rr:
      hosts: {}
    etcd:
      hosts:
        pandore.friends.intra.example.com:
        hellenes.friends.intra.example.com:
        epimethee.friends.intra.example.com:
    kube-infra:
      hosts:
        pyrrha.friends.intra.example.com:
        calliope.friends.intra.example.com:
        clio.friends.intra.example.com:
    kube-master:
      hosts:
        pandore.friends.intra.example.com:
        hellenes.friends.intra.example.com:
        epimethee.friends.intra.example.com:
    kube-workers:
      hosts:
        erato.friends.intra.example.com:
        euterpe.friends.intra.example.com:
        melpomene.friends.intra.example.com:
        polyhymnia.friends.intra.example.com:
        terpsichore.friends.intra.example.com:
        thalia.friends.intra.example.com:
    kube-node:
      children:
        kube-master:
        kube-infra:
        kube-workers:
    k8s-cluster:
      children:
        calico-rr:
        kube-node:
EOF

Cet inventaire décrit un cluster composé de 3 noeuds masters+etcd, 3 noeuds “infra”, et 6 noeuds “workers”.

Ensuite, nous voudrons créer un premier fichier de variables globales :

$ cat <<EOF >inventory/rpi/group_vars/all/all.yaml
ansible_user: root
etcd_data_dir: /var/lib/etcd
etcd_kubeadm_enabled: false
bin_dir: /usr/local/bin
apiserver_loadbalancer_domain_name: api-k8s-arm.intra.example.com
loadbalancer_apiserver:
address: 10.42.253.52
port: 6443
loadbalancer_apiserver_localhost: false
loadbalancer_apiserver_port: 6443
upstream_dns_servers:
- 10.255.255.255
no_proxy_exclude_workers: false
cert_management: script
download_container: true
deploy_container_engine: true
EOF

Nous désignons ici le ou les serveurs DNS existants que Kubernetes devra interroger pour la résolution de noms hors clusters. Ainsi que la VIP d’un LoadBalancer, et le nom DNS correspondant, ceux-ci pointant sur l’HAProxy que nous venons de déployer.

Il faudra ensuite créer un fichier de configuration avec les variables relatives au cluster etcd :

$ cat <<EOF >inventory/rpi/group_vars/etcd.yaml
etcd_compaction_retention: 8
etcd_metrics: basic
etcd_memory_limit: 2GB
etcd_quota_backend_bytes: "2147483648"
etcd_peer_client_auth: true
etcd_deployment_type: host
EOF

On rajoute une limite mémoire et un quota de 2GB, pour etcd, qui doit rentrer sur nos masters, disposant de 4GB de mémoire. Si l’on ne veut pas utiliser docker, comme container runtime, alors on devra changer le type déploiement etcd. Par défaut conteneurisé, son déploiement dépend de commandes docker. Le déploiement de type host permettant l’utilisation d’un runtime crio, ou containerd.

Nous devrons alors créer un nouveau de fichier de variables :

cat <<EOF >inventory/rpi/group_vars/k8s-cluster/k8s-cluster.yaml
kube_config_dir: /etc/kubernetes
kube_script_dir: "{{ bin_dir }}/kubernetes-scripts"
kube_manifest_dir: "{{ kube_config_dir }}/manifests"
kube_cert_dir: "{{ kube_config_dir }}/ssl"
kube_token_dir: "{{ kube_config_dir }}/tokens"
kube_api_anonymous_auth: true
kube_version: v1.19.5
local_release_dir: /tmp/releases
retry_stagger: 5
kube_cert_group: kube-cert
kube_log_level: 2
credentials_dir: "{{ inventory_dir }}/credentials"
kube_oidc_auth: false
kube_token_auth: true
kube_network_plugin: flannel
kube_network_plugin_multus: false
kube_service_addresses: 10.233.128.0/18
kube_pods_subnet: 10.233.192.0/18
kube_network_node_prefix: 24
kube_apiserver_ip: "{{ kube_service_addresses|ipaddr('net')|ipaddr(1)|ipaddr('address') }}"
kube_apiserver_port: 6443
kube_apiserver_insecure_port: 0
kube_proxy_mode: ipvs
authorization_modes: ['Node', 'RBAC']
kube_proxy_strict_arp: false
kube_encrypt_secret_data: false
cluster_name: cluster.local
ndots: 2
dns_mode: coredns
enable_nodelocaldns: true
nodelocaldns_ip: 169.254.25.10
nodelocaldns_health_port: 9254
enable_coredns_k8s_external: false
enable_coredns_k8s_endpoint_pod_names: false
resolvconf_mode: none
deploy_netchecker: false
skydns_server: "{{ kube_service_addresses|ipaddr('net')|ipaddr(3)|ipaddr('address') }}"
skydns_server_secondary: "{{ kube_service_addresses|ipaddr('net')|ipaddr(4)|ipaddr('address') }}"
dns_domain: "{{ cluster_name }}"
container_manager: containerd
kata_containers_enabled: false
kubeadm_certificate_key: "{{ lookup('password', credentials_dir + '/kubeadm_certificate_key.creds length=64 chars=hexdigits') | lower }}"
k8s_image_pull_policy: IfNotPresent
kubernetes_audit: false
dynamic_kubelet_configuration: false
default_kubelet_config_dir: "{{ kube_config_dir }}/dynamic_kubelet_dir"
dynamic_kubelet_configuration_dir: "{{ kubelet_config_dir | default(default_kubelet_config_dir) }}"
podsecuritypolicy_enabled: true
kubeconfig_localhost: true
kubectl_localhost: false
system_reserved: true
system_memory_reserved: 128Mi
system_cpu_reserved: 250m
system_master_memory_reserved: 256Mi
system_master_cpu_reserved: 250m
volume_cross_zone_attachment: false
persistent_volumes_enabled: false
event_ttl_duration: 1h0m0s
force_certificate_regeneration: false
minimal_node_memory_mb: 896
kube_proxy_nodeport_addresses: >-

Beaucoup de variables ci-dessus reprennent des défaults. Entre autre changements, notons le plugin réseau, “flannel“, et la définition des “kube_service_addresses” et “kube_pods_subnet” ou le “resolvconf_mode“. Le runtime conteneur : “containerd“. L’activation des PodSecurityPolicy. Les “system_*” vont réserver un peu de CPU et mémoire pour l’OS des noeuds. Le “minimal_node_memory” sera indispensable, lorsque certains noeuds ont moins d’1Gi de mémoire – les RPI 3b+ remontent 924Mi.

Il sera possible de configurer le runtime conteneur du cluster, en créant un fichier tel que le suivant :

$ cat <<EOF >inventory/rpi/group_vars/all/containerd.yaml
containerd_config:
  grpc:
    max_recv_message_size: 16777216
    max_send_message_size: 16777216
  debug:
    level: ""
  registries:
    docker.io: "https://registry-1.docker.io"
    katello: "https://katello.vms.intra.example.com:5000"
    "registry.registry.svc.cluster.local:5000": "http://registry.registry.svc.cluster.local:5000"
  max_container_log_line_size: -1
  metrics:
    address: ""
    grpc_histogram: false
EOF

Kubespray permet le déploiement de diverses applications optionnelles :

$ cat <<EOF >inventory/rpi/group_vars/k8s-cluster/addons.yaml
helm_enabled: false
registry_enabled: false
metrics_server_enabled: true
metrics_server_kubelet_insecure_tls: true
metrics_server_metric_resolution: 60s
metrics_server_kubelet_preferred_address_types: "InternalIP"
local_path_provisioner_enabled: false
local_volume_provisioner_enabled: false
cephfs_provisioner_enabled: false
rbd_provisioner_enabled: false
ingress_nginx_enabled: true
ingress_ambassador_enabled: false
ingress_alb_enabled: false
cert_manager_enabled: false
metallb_enabled: false
EOF

Dans notre cas, nous activerons le metrics server, et l’Ingress Controller Nginx.

Enfin, générer une clé SSH sur le noeud Ansible, et l’installer sur tous les noeuds composant le cluster :

$ ssh-keygen -t rsa -b 4096 -N '' -f ~/.ssh/id_rsa
$ for i in pandore hellenes .... terpsichore thalia
do ssh-copy-id -i ~/.ssh/id_rsa.pub root@$i.friends.intra.example.com; done
...
$ ansible -m ping -i inventory/rpi/hosts.yaml all

Déploiement Kubernetes

Nous pourrons enfin procéder au déploiement :

$ ansible-playbook -i inventory/rpi/hosts.yaml cluster.yml 2>&&1 | tee -a deploy.$(date +%s).log

Si le déploiement échoue, nous pourrons corriger notre inventaire et relancer cette même commande, à moins que l’erreur ne se soit produite lorsqu’ansible lance l’initialisation du cluster Kubernetes (kubeadm init), auquel cas nous devrions d’abord lancer le playbook de reset, pour réinitialiser les noeuds :

$ ansible-playbook -i inventory/rpi/hosts.yaml reset.yml

Si tout se passe bien, le déploiement ne prendra pas plus d’une trentaine de minutes.

...
PLAY RECAP *******************************************
calliope.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
clio.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
epimethee.friends.intra.example.com : ok=440 changed=67 unreachable=0 failed=0 skipped=864 rescued=0 ignored=1
erato.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
euterpe.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
hellenes.friends.intra.example.com : ok=442 changed=68 unreachable=0 failed=0 skipped=862 rescued=0 ignored=1
localhost : ok=1 changed=0 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0
melpomene.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
pandore.friends.intra.example.com : ok=497 changed=86 unreachable=0 failed=0 skipped=924 rescued=0 ignored=1
pyrrha.friends.intra.example.com : ok=308 changed=30 unreachable=0 failed=0 skipped=604 rescued=0 ignored=1
polyhymnia.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
terpsichore.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1
thalia.friends.intra.example.com : ok=285 changed=29 unreachable=0 failed=0 skipped=514 rescued=0 ignored=1


$ kubectl get nodes
NAME                                    STATUS   ROLES    AGE     VERSION
calliope.friends.intra.example.com      Ready    infra    7m14s   v1.19.5
clio.friends.intra.example.com          Ready    infra    7m14s   v1.19.5
epimethee.friends.intra.example.com     Ready    master   9m26s   v1.19.5
erato.friends.intra.example.com         Ready    worker   7m14s   v1.19.5
euterpe.friends.intra.example.com       Ready    worker   7m1s    v1.19.5
hellenes.friends.intra.example.com      Ready    master   9m24s   v1.19.5
melpomene.friends.intra.example.com     Ready    worker   7m1s    v1.19.5
pandore.friends.intra.example.com       Ready    master   9m59s   v1.19.5
pyrrha.friends.intra.example.com        Ready    infra    7m14s   v1.19.5
polyhimnia.friends.intra.example.com    Ready    worker   7m1s    v1.19.5
terpsichore.friends.intra.example.com   Ready    worker   7m13s   v1.19.5
thalia.friends.intra.example.com        Ready    worker   7m      v1.19.5

A ce stade, nous pourrions intégrer le cluster avec une solution de stockage externe – au plus simple, un serveur NFS. Notons en revanche que l’on reste limité par les modules kernels fournis avec Raspbian : pour s’interfacer avec avec un cluster Ceph, il faudra recompiler votre kernel, ou s’intéresser à rbd-ndb. Nous reviendrons sur ce point dans un article ultérieur.

Conclusion

Cluster-raspi2

Le support ARM par Kubespray est relativement récent, mais fonctionne bien, contrairement à ce que l’on peut lire sur quelques articles de blogs, plus anciens. Il faudra en revanche s’assurer qu’au moins vos noeuds disposent de processeurs armv7, et qu’au moins vos master puissent lancer des binaires 64b.

En règle générale, il faudra s’assurer que les applications que l’on compte déployer dans notre cluster offrent bien des images ARM, ce qui n’est pas toujours le cas. Ceci dit, libre à vous d’assembler vous-mêmes vos images.

Contrairement à OpenShift 4, un cluster Kubernetes demande moins de ressources, offre une plus grande portabilitée, tandis que Kubespray n’a rien à envier aux outils de déploiements d’OpenShift que sont openshift-ansible, ou openshift-install.

❌