Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

Open source : comment Sinequa facilite l’accès aux données de la NASA

Si l’an passé, la NASA a déclaré 2023 “l’année de l’open source”, elle a toujours fait de l’accès à ses recherches une priorité. Pour faciliter le partage de ses données, la Direction des missions scientifiques (SMD) de la NASA a lancé la version bêta du moteur Science Discovery Engine, optimisée par la plateforme de Sinequa, un leader du marché de la recherche et de l’analyse de données basées sur l’IA.

Cofondé en 2005 par Jean Ferré et Alexandre Bilger, Sinequa permet aux entreprises de tirer de la valeur de la masse de données dont elles disposent. Sa solution, combinant un moteur de recherche puissant (Enterprise Search) avec des fonctionnalités avancées de traitement du Langage Naturel (NLP) et des algorithmes d’apprentissage automatique, permet d’extraire des informations métiers à partir de données structurées, mais également non structurées. La société a été l’une des premières à inclure les grands modèles de langage (LLM) dans la recherche.

Le Science Discovery Engine de la NASA

Le SDE est un élément clé du programme Open Source Science Initiative (OSSI) de la NASA qui vise à rendre la recherche scientifique financée par des fonds publics transparente, inclusive, accessible et reproductible et de son initiative “Transform to Open Science” (TOPS) dont l’objectif est de créer une culture inclusive de la science ouverte capable de relever les défis du 21e siècle.

En 2019, la communauté scientifique recommandait à la NASA de développer un portail de recherche qui donnerait, à partir d’une seule interface, accès au contenu des cinq domaines scientifiques de la SMD : astrophysique, sciences biologiques et physiques, sciences de la Terre, héliophysique et sciences planétaires.

En 2020, la solution Enterprise Search de Sinequa a été sélectionnée pour aider la NASA à accéder à des informations accumulées depuis plusieurs décennies, ainsi qu’à les exploiter de façon optimale. La collaboration étroite amorcée alors entre l’équipe de Sinequa et les développeurs, chercheurs et data scientists de la NASA a abouti à la création du SDE.

Un ensemble de données hétérogènes

Pour mettre en œuvre ce moteur de recherche, les partenaires ont du relever un défi de taille, outre la quantité des données : leur hétérogénéité et leur complexité, chacun ses 5 domaines opérant avec ses propres normes et terminologies.

Aujourd’hui, les utilisateurs du SDE peuvent extraire des informations enregistrées de plus de 84 000 ensembles de données et plus de 715 000 documents, répartis dans 128 sources d’information différentes, sites internet, référentiels de données et archives documentaires. Egalement intégrée à plus de 44 500 logiciels, modèles et outils scientifiques, la solution de Sequina reconnait plus de 8 900 termes scientifiques différents, un nombre qui devrait augmenter prochainement.

La nouvelle interface utilisateur

La version bêta du SDE a été lancée en décembre 2022. Depuis lors, l’interface n’a cessé d’être améliorée afin d’offrir des résultats de recherche plus pertinents, une nouvelle version a ainsi été mise en ligne en janvier dernier.

Kaylin Bugbee, chef de projet SDE, explique :

“Les scientifiques et les chercheurs passent beaucoup de temps à rechercher et à démêler des données et des informations scientifiques. Les nouvelles mises à jour de l’interface utilisateur de SDE font gagner du temps aux chercheurs en les aidant à rechercher rapidement des données et de la documentation par sujet scientifique ou dans l’ensemble de la collection d’informations. Cette amélioration de l’efficacité de la recherche permet aux scientifiques d’accéder plus rapidement à une science ouverte et exploitable”.

Désormais, des fonctionnalités de filtrage supplémentaires offrent aux utilisateurs la possibilité d’effectuer des recherches spécifiques dans un domaine scientifique donné, tel que la science planétaire ou l’héliophysique, simplifiant ainsi leurs processus de recherche. Parmi les mises à jour figure également un nouvel outil de recherche par acronyme, permettant une meilleure compréhension du contexte des résultats de recherche et du contenu des documents.

La NASA prévoit d’intégrer davantage de données et de contenus au cours des mois à venir, notamment en enrichissant les fonctionnalités de l’interface utilisateur et en poursuivant le développement de l’API du moteur. L’équipe du SDE prévoit de son côté un déploiement complet de l’outil à l’automne 2024.

Jean Ferré, CEO de Sinequa, conclut :

“Le Science Discovery Engine est une infrastructure fantastique qui aide les scientifiques de la NASA, ainsi que les utilisateurs du monde entier, à trouver les informations dont ils ont besoin en quelques secondes seulement, au lieu de plusieurs minutes, voire de longues heures. Nous sommes fiers d’aider la NASA à transformer et à améliorer la productivité dans l’ensemble de son organisation et serons à ses côtés pour associer de nouveaux ensembles de données et de nouvelles sources d’informations qui alimenteront son moteur de connaissances. Pour la science, la technologie et l’innovation, le partage de données scientifiques et ouvertes constitue le seul moyen de prospérer. À cet égard, Sinequa se réjouit de jouer un rôle actif dans cette initiative”.
Open-source-comment-Sinequa-facilite-donnees-NASA
🔲 ☆

L’IA générative au sein des services publics : Gabriel Attal dévoile Albert, un modèle de la DINUM

Ce sont les maisons France Services qui ont expérimenté les premières le LLM Albert. Gabriel Attal, en visite dans l’une d’elles à Sceaux, a annoncé ce mardi 23 avril 2024 le prochain déploiement au sein des services publics de ce modèle d’IA souverain, puisque développé par et pour des agents publics français.

Il y a un an, en mai 2023, le gouvernement annonçait une expérimentation visant à mettre l’IA générative au service des agents et usagers du service public, officialisée en octobre suivant par Stanislas GUERINI, Ministre de la Transformation et de la Fonction publiques.

L’expérimentation de l’IA générative au sein des services publics : un temps de réponse divisé par 2

Le mois de septembre précédent, mille agents de la CNAV (Caisse Nationale d’Assurance Vieillesse), Pôle Emploi ou l’Assurance Maladie ont testé un modèle adapté par la start-up française AlloBrain, du LLM Claude d’Anthropic, pour répondre aux commentaires laissés par les usagers sur le site Services-publics.fr.

Les premiers résultats de l’expérimentation, menée par la DITP et la Direction Interministérielle du Numérique (DINUM), se sont avérés très concluants :

  • Dans les services publics volontaires, 1 réponse sur 2 a été facilitée par l’IA ;
  • Le temps de réponse moyen est passé de 7 jours à 3 jours ;
  • Au bout de 2 mois, 70% des agents ont un ressenti positif de l’utilisation de l’outil et 74% des usagers se sont dits satisfaits de la réponse apportée.

Albert, un modèle souverain open source spécialisé en interne

La DINUM travaille depuis juin  2023 au développement d’Albert, un modèle interne. En octobre dernier, Ulrich Tan, ingénieur polytechnicien, Chef du pôle Datalab du département Etalab de la Direction interministérielle précisait que ce modèle allait reposer sur “des briques technologiques, des intelligences artificielles pré-entraînées et disponibles en open source”, comme Llama ou Falcon,  optimisées grâce au fine-tuning pour les besoins des agents du service public. Les modèles open source de Mistral AI lancés à partir de fin septembre auraient également contribué au développement d’Albert.

Créé par et pour des agents publics, cet outil d’IA générative souverain, libre et ouvert, devait être déployé auprès de conseillers volontaires du réseau France services avant de l’être dans d’autres services publics, ce que vient de confirmer Gabriel Attal :

“Je vous annonce que nous avons développé une intelligence artificielle souveraine, française, qui va révolutionner nos services publics et que nous mettons désormais au service des Français”.

Mentionnant les travaux d’Ulrich Tan et ses collaborateurs au sein du Datalab, il a ajouté :

“Grâce à eux, la France est le premier pays européen à inaugurer une IA 100% souveraine et à la mettre au service de ses services publics”.

Le 7 février dernier, la DINUM a reçu le prix “innovation” lors des Victoires des Acteurs publics, un événement organisé par le média Acteurs Publics sous le haut patronage de la présidence de l’Assemblée nationale, pour le lancement d’Albert.

Albert France Services

Chaque mois, les conseillers des 2700 guichets uniques du réseau France Services doivent répondre à près de 800 000 démarches des Français, parfois très complexes.

La version spécifique du réseau “Albert France services”, grâce à un moteur de réponse en langage naturel, leur facilite l’accès aux informations en leur générant une réponse adaptée à la situation de l’usager qu’il accompagne.

Albert fournit au conseiller une réponse rédigée spécifique à la question posée, mais également :

  • Les sources sur lesquelles il s’est appuyé pour produire la réponse ;
  • Une liste d’autres questions fréquemment posées en lien avec la réponse ;
  • Des liens pratiques (téléservices, simulateurs …) ;
  • Des fiches pratiques issues de service-public.fr.

Le conseiller a ensuite la liberté d’utiliser ou non les réponses suggérées ou de les adapter. Comme le souligne le Premier ministre, le but n’est pas de remplacer les agents publics mais de leur permettre de dégager plus de temps pour les relations humaines :

 “A l’IA les tâches rébarbatives, et aux agents publics, le lien avec nos concitoyens”.

ia-generative-services-publics
🔲 ☆

Meta dévoile les deux premiers modèles de la famille Llama 3

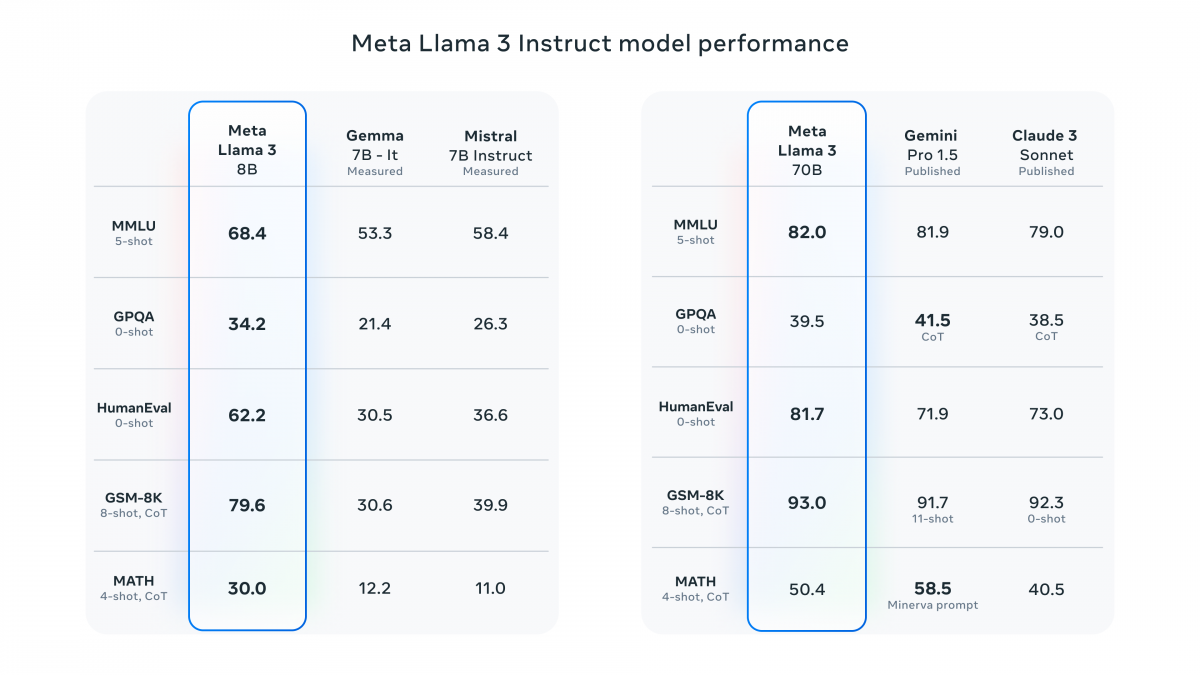
Comme attendu, Meta a partagé hier deux premiers modèles de la famille Llama 3 : Llama 3 7B et Llama 3 70B, qui seront suivis dans les prochains mois par des modèles allant jusqu’à 400 milliards de paramètres. Ces deux modèles open source, d’ores et déjà intégrés dans son assistant Meta AI disponible sur ses réseaux sociaux dans certains pays anglophones, sont présentés par Meta comme les meilleurs modèles existants à leur échelle. 

Selon la société, les améliorations apportées par rapport à Llama 2 ont considérablement réduit les taux de faux refus, perfectionné l’alignement et accru la diversité des réponses. Llama 3 présente en outre des capacités de raisonnement et de génération de code améliorées.

Meta a comparé les performances de ces modèles dans les benchmarks de référence Llama 3 7B avec Gemma de Google, Mistral 7 B de Mistral AI, et Llama 3 70 B avec Gemini Pro 1,5 de Google et Claude 3 Sonnet d’Anthropic.


L’ensemble de données de pré-entrainement de Llama 3 totalise plus de 15 téraoctets de jetons de données publiques, soit 7 fois plus que celui de Llama 2 et comprend quatre fois plus de code. Pour anticiper les futurs cas d’utilisation multilingues, plus de 5 % de ces données ne sont pas anglaises, couvrant plus de 30 langues. Même si elles sont de haute qualité, Meta reconnaît que les performances dans ces langues peuvent varier par rapport à l’anglais.

Des améliorations ont également été apportées au niveau architecture. Llama 3 utilise un tokenizer avec un vocabulaire de 128 000 jetons qui encode le langage beaucoup plus efficacement. Pour optimiser le processus d’inférence des modèles Llama 3, l’approche d’attention des requêtes groupées (Group Query Attention ou GQA) a été mise en œuvre pour les versions de 8B et 70B. Les modèles ont été entraînés sur des séquences de 8192 tokens, avec l’application d’un masque spécifique assurant que l’attention accordée reste confinée aux frontières du document.

Les deux modèles seront bientôt disponibles sur AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM et Snowflake.

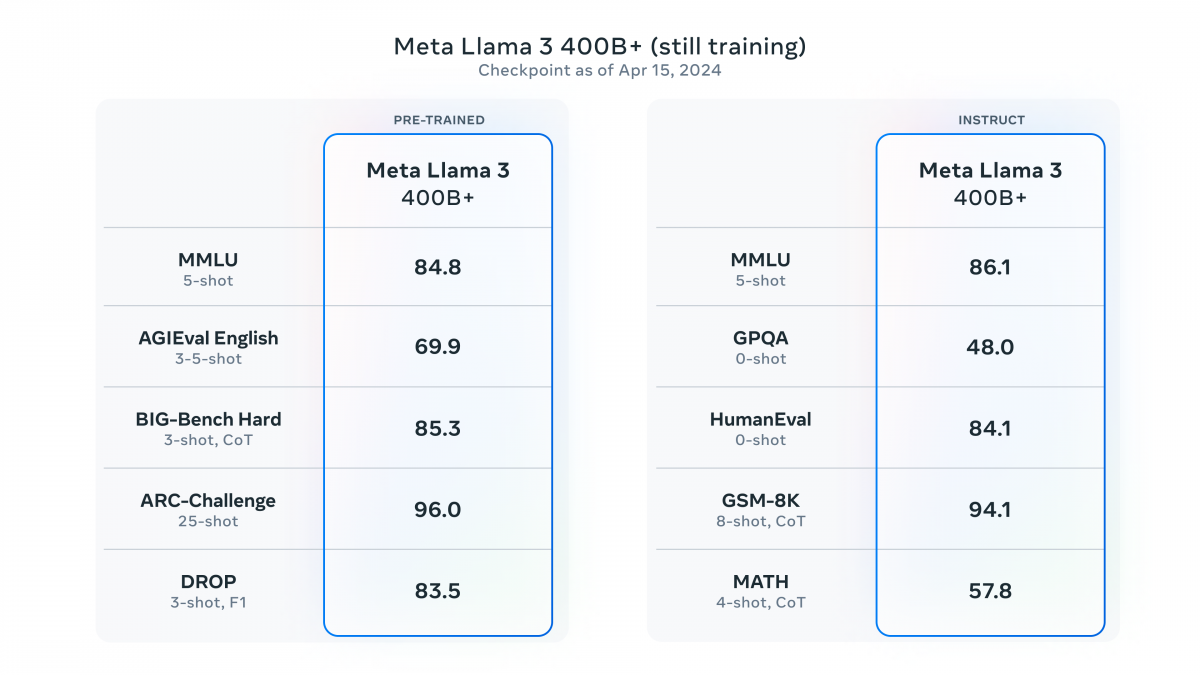
Meta annonce pour les prochains mois plusieurs modèles multimodaux, avec une prise en charge de plusieurs langues, une fenêtre contextuelle plus longue, ainsi que des capacités globales plus robustes. Il donne un aperçu de Llama 3 400B, le plus grand modèle de la famille dont il poursuit l’entraînement.

Les poids de Llama 3 et le générateur de jetons sont téléchargeables sur GitHub.

Meta dévoile les deux premiers modèles de la famille Llama 3
🔲 ☆

Mistral AI annonce un nouveau modèle open source

C’est sur X que Mistral AI a choisi d’annoncer Mixtral 8x22B mercredi dernier à l’aide d’un lien magnet Torrent. La jeune licorne n’a pas publié de communiqué de presse ni consacré un blog sur son site à ce dernier modèle, donc on ne sait pour l’instant que peu de choses sur ce nouveau modèle open source mais de premiers benchmarks arrivent sur Hugging Face.

Mistral AI a publié Mixtral 8x7B en décembre dernier, on peut présumer que Mixtral 8x22B en est une version plus performante.

Ces 2 modèles Mixtral 8x sont basés sur une architecture à mélange clairsemé d’experts (SMoE) publiés sous licence Apache 2.0.

En tant que modèle de décodeur exclusivement, Mixtral 8x7B utilise un bloc de rétroaction pour choisir parmi huit groupes distincts de paramètres. À chaque couche et pour chaque jeton, un réseau de routeurs sélectionne deux de ces groupes, appelés “experts”, pour traiter le jeton et combine leur sortie de manière additive.

Cette approche augmente le nombre total de paramètres du modèle tout en contrôlant le coût et la latence. Mixtral 8xB dispose de 46,7 milliards de paramètres au total, mais n’utilise que 12,9 milliards de paramètres par jeton, traitant ainsi les entrées et générant les sorties à la même vitesse et au même coût qu’un modèle 12,9B. Le modèle est pré-entraîné sur des données extraites du Web ouvert, permettant la formation simultanée d’experts et de routeurs.

L’approche a été la même pour Mixtral 8x22B dont le nombre de paramètres peut monter jusqu’à 176 milliards et la fenêtre contextuelle de 65 000 jetons.

Alors que certains voyaient dans le partenariat de distribution que Mistral AI a signé avec Microsoft un abandon de l’open source, la start-up leur prouve qu’il n’en est rien, comme elle l’avait assuré face aux critiques.

Mistral AI annonce un nouveau modèle open source
🔲 ☆

xAI publie son IA générative Grok-1 en open source

Elon Musk avait annoncé la semaine dernière que Grok, le chatbot IA développé par sa startup xAI, serait désormais open source. C’est chose faite : les poids du modèle de fondation qui l’alimente, Grok-1, ainsi que son architecture ont été publiés hier sur GitHub. Il est également possible de retrouver les poids du modèle depuis ce matin via un fichier torrent sur X.

En juillet dernier, Elon Musk annonçait le lancement de xAI, qui avait été enregistrée au Nevada le mois de mars précédent. Onze experts en IA, travaillant auparavant chez DeepMind, OpenAI, Google Research, Microsoft Research, Tesla et l’Université de Toronto, étaient venus complétés son équipe, basée en Californie.

Elon Musk affirmait que Grok était la meilleure IA générative existant alors, soulignant que “Grok a accès en temps réel aux infos via X, ce qui lui donne un avantage majeur sur les autres modèles”. Le chatbot est disponible depuis fin 2023 pour les abonnés X Premium+, sensé leur répondre avec humour et sans filtre.

Sur son blog, XAI explique que la version de Grok publiée en open-source, est un modèle de mélange d’experts (MoE) de 314 milliards de paramètres formé à partir de zéro. Il s’agit du point de contrôle du modèle de fondation brut de la phase de pré-formation Grok-1, qui s’est terminée en octobre 2023, ce qui signifie que le modèle n’est pas affiné pour une application spécifique, telle que le dialogue.

Il a été publié sous licence Apache 2.0, les développeurs peuvent donc le modifier et le redistribuer à leur gré.

Pourquoi le choix de l’open source ?

Lorsqu’Elon Musk a cofondé OpenAI en 2015 avec notamment Sam Altman, c’était en tant qu’organisation à but non lucratif visant à développer des intelligences artificielles générales bénéfiques à l’humanité. Sa charte stipule : “Nous tenterons de construire directement des AGI sûres et bénéfiques, mais considérerons également notre mission comme remplie si notre travail aide les autres à atteindre ce résultat”.

Elon Musk, qui l’a quitté en 2018, a déposé plainte début mars contre OpenAI et Sam Altman pour non-respect de l’accord initial à l’origine de la création de l’association, GPT-4 étant un modèle fermé. Elon Musk s’est alors vu reprocher une certaine ambivalence et hypocrisie du fait que Grok l’était aussi. Le 11 mars dernier, il a donc annoncé l’ouverture du modèle.

xAI publie son IA générative Grok-1 en open source
🔲 ☆

Confiance.ai ouvre ses outils et présente ses perspectives au delà du programme

Le 7 mars dernier, lors du Confiance.ai Day 2024, le collectif a annoncé l’ouverture aux communautés scientifiques et industrielles de la méthodologie mise au point ainsi que des composants open source associés. Alors que le programme doit s’achever cette année, les partenaires ont décidé de se concentrer sur l’approfondissement, la pérennisation et l’industrialisation des résultats obtenus. Ils ont également l’intention de créer une fondation afin de fédérer un ensemble d’acteurs à l’échelle internationale autour d’une feuille de route commune.

Confiance.ai, le plus gros programme de recherche technologique du plan #AIforHumanity, est une initiative majeure qui vise à renforcer le leadership technologique des entreprises françaises dans le domaine de l’IA industrielle. Lancé en 2021 dans le cadre de la Stratégie nationale pour l’intelligence artificielle financée par France 2030, il s’est concentré sur le développement d’une méthodologie de bout en bout et d’une série de composants technologiques open source pour intégrer des IA de confiance dans des systèmes industriels critiques, accessibles sur https://bok.confiance.ai/.

La méthodologie développée offre un guide complet, permettant aux industriels de caractériser et de qualifier la confiance des systèmes intelligents dirigés par les données, et ce, dans n’importe quel secteur d’activité.

Ses 126 composants ont été regroupés en neuf ensembles fonctionnels correspondant à des processus d’ingénierie bien précis : ingénierie de bout en bout, gestion du cycle de vie de la donnée, gestion du cycle de vie des modèles et des composants, évaluation des composants d’IA, déploiement des composants IA, gestion des systèmes d’IA en opération, robustesse, explicabilité et quantification de l’incertitude.

Des secteurs clés tels que l’automobile, l’aéronautique, l’énergie et la défense ont déjà bénéficié des avancées de Confiance.ai. Des entreprises du collectif ont mis en œuvre ces nouvelles méthodologies : elles ont permis à Air Liquide d’améliorer la précision des modèles d’IA pour la gestion de l’inventaire, à Thales de valider et de monitorer les performances des algorithmes de détection d’objets, et à Renault Group de vérifier la qualité des soudures sur ses véhicules.

Confiance.ai, moteur du développement de l’écosystème mondial de l’IA de confiance

Précurseur dans le domaine de l’IA de confiance, en plus de son impact sur l’industrie française, Confiance.ai joue un rôle moteur dans la construction d’un écosystème mondial de l’IA de confiance, en établissant des partenariats avec des initiatives similaires à l’étranger. Il a notamment signé un MoU (Memorandum of Understanding) avec le programme Confiance IA au Québec et en Allemagne avec VDE, l’une des plus importantes organisations technologiques d’Europe.

Juliette Mattioli, Présidente du comité de pilotage de Confiance.ai et Expert sénior en Intelligence Artificielle chez Thales, commente :

“Nous nous sommes attaqués à une problématique particulièrement complexe et ambitieuse. Les résultats obtenus sont en ligne avec nos objectifs et remarquables à plusieurs égards. Tout d’abord, sur le plan humain, nous sommes parvenus à faire collaborer un écosystème hybride composé d’industriels, de scientifiques, de data scientists, d’ingénieurs, etc. Nous avons également relevé un grand nombre de défis scientifiques et technologiques – plus que nous l’avions imaginé – et nous avons été moteur dans de nombreuses d’initiatives au niveau international. Une véritable communauté mondiale autour de l’IA de confiance est en train d’émerger”. 

De nouveaux projets en ligne de mire

Alors que le programme Confiance.ai se terminera fin 2024, les partenaires se projettent déjà vers l’avenir. Leurs ambitions se concentrent sur trois axes principaux : approfondir, pérenniser et industrialiser.

Fabien Mangeant, Président du comité de direction de Confiance.ai et Directeur Scientifique Digital d’Air Liquide, explique :

“Il reste encore de nombreux défis scientifiques et technologiques à relever pour que la France maintienne son avance dans le domaine et nous sommes en train de les répertorier. Les sujets du transfert et de la valorisation de nos travaux sont des chantiers prioritaires, tout comme la résolution de nouveaux verrous scientifiques et technologiques”.

Les partenaires du programme ont identifié plusieurs problématiques pour lesquelles il serait opportun de lancer de nouveaux projets de recherche et technologie (R&T), notamment l’IA hybride, les IA génératives telles que le LLM, et la cybersécurité des IA intégrées aux systèmes critiques. Ces nouveaux projets R&T enrichiront les méthodes existantes en les adaptant à de nouveaux domaines d’application.

Un autre objectif majeur est la pérennisation et la diffusion de la méthodologie développée. Cela passe par son ouverture et par le lancement d’une initiative de fondation visant à rassembler des acteurs du monde entier autour d’une feuille de route commune. Cette fondation contribuera à maintenir ce “bien commun numérique” opérationnel et à le faire évoluer grâce aux retours d’expérience et aux propositions d’amélioration. De plus, la formation, notamment à travers le Mastère Spécialisé sur l’IA de Confiance co-conçu avec CentraleSupélec, jouera un rôle essentiel dans l’élévation de la maturité de cette méthodologie.

Enfin, la troisième ambition est l’industrialisation des résultats du programme afin de les rendre utilisables à grande échelle par les ingénieries des entreprises. Cette démarche vise à créer et à mettre à disposition des outils de compétitivité adaptés aux spécificités de chaque entreprise en matière de typologie, de données et de cas d’usage.

Confiance.ai-outils-et-perspectives-au-dela-du-programme
🔲 ☆

Hugging Face se lance dans un projet de robotique open source

Le marché des robots humanoïdes devrait atteindre 8 milliards de dollars d’ici 2030, ce qui explique l’intérêt dans ce secteur des grandes firmes ou de start-ups comme OpenAI qui s’est associé en mars 2023 avec 1X Technologies pour développer NEO, un robot humanoïde alimenté par l’IA. Selon un post de Remi Cadene sur X, Hugging Face se lancerait lui aussi dans un projet robotique, mais open source. 

Passée au rang de licorne après une levée de fonds de 235 millions de dollars en août dernier, Hugging Face, start-up créée à Paris en 2016 mais également basée à New York, se positionne comme une alternative open source à OpenAI. Elle a présenté HuggingChat, comme une alternative open source à ChatGPT et ses Hugging Face Assistants, gratuits et eux aussi open source, lancés il y a un mois, rivalisent avec les GPT du Store d’Open AI. 

Ce qu’appuie Remi Cadene dans son post sur X :

“Après 3 ans @tesla et Optimus, je suis ravi d’annoncer que j’ai rejoint Hugging Face pour lancer un ambitieux projet de robotique ouverte ! (open comme dans open-source, pas comme dans Open AI) A la recherche d’ingénieurs pour construire de vrais robots à Paris.”  

After 3 years @tesla and Optimus, I am thrilled to announce that I joined Hugging Face to start an ambitious open robotics project! (open as in open-source, not as in Open AI) Looking for engineers to build real robots in Paris 🇫🇷 https://t.co/cFuNL4PVI4 🤖🤗 pic.twitter.com/7IkunPXOpX

— Remi Cadene (@RemiCadene) March 7, 2024

Sur son site, on peut lire :

“Je construis des robots de nouvelle génération chez Hugging Face. Auparavant, j’étais chercheur scientifique chez Tesla sur Autopilot et Optimus. Sur le plan académique, j’ai fait des études postdoctorales à l’Université Brown et mon doctorat à la Sorbonne”.

Si Hugging Face n’a pas confirmé pour l’instant, le lien publié renvoie vers une offre d’emploi d’ingénieur en robotique incarnée à Paris. La start-up y stipule :

“Chez Hugging Face, nous pensons que le ML ne doit pas nécessairement se limiter aux ordinateurs et aux serveurs, et c’est pourquoi nous élargissons notre équipe avec une nouvelle opportunité pour un ingénieur en robotique axé sur l’apprentissage automatique/l’IA. 

Dans ce rôle, vous serez responsable de la conception, de la construction et de la maintenance de systèmes robotiques open source et à faible coût qui intègrent les technologies d’IA, en particulier dans l’apprentissage profond et l’IA incarnée. Vous collaborerez en étroite collaboration avec les ingénieurs ML, les chercheurs et les équipes de produits pour développer des solutions innovantes qui repoussent les limites de ce qui est possible en robotique et en IA”.

Hugging-Face-projet-robotique-open-source

🔲 ☆

IA générative : le MICS lance CroissantLLM, un modèle open source bilingue français-anglais

Les équipes de recherche du laboratoire MICS de CentraleSupélec ont développé avec Illuin Technology un nouveau modèle de langage (LLM) appelé CroissantLLM. Totalement ouvert, comptant 1,3 milliard de paramètres, il fonctionne efficacement sur du matériel local grand public y compris sur les ordinateurs personnels et smartphones d’entrée de gamme. Le modèle, qui est disponible sur la plateforme Hugging Face, sera présenté ce 7 mars dans le cadre de l’événement “Les Ateliers de l’IA”, à Paris La Défense et en distanciel.

CroissantLLM est présenté comme un modèle de langage souverain, ouvert, éthique, frugal, étant le fruit d’une collaboration entre académie et industrie, comme Céline Hudelot, professeure, Directrice du laboratoire MICS, l’explique :

“Ce travail est le fruit d’une collaboration étroite entre académie et industrie, illustrant l’importance de la synergie dans l’avancée de la recherche en IA. CroissantLLM résulte en effet des travaux menés par CentraleSupélec en collaboration avec plusieurs partenaires académiques de renom tels que Sorbonne Université, INESC-ID, Instituto Superior Técnico, Carnegie Mellon University et Institut DATAIA. Elle a aussi pu voir le jour grâce au soutien précieux de partenaires industriels : ILLUIN Technology ainsi que Unbabel, Diabolocom, et EqualAI”.

Le modèle a été développé par une équipe de recherche française qui s’est appuyée sur le supercalculateur Jean Zay au sein du GENCI. Plutôt que de l’entraîner sur des corpus à dominante anglaise comme l’ont été les modèles les plus récents, l’équipe a choisi de le faire sur une quantité égale de données en français et en anglais, ce qui lui permet d’intégrer et de maîtriser les spécificités de la langue et de la culture françaises.

Dans ce but, l’équipe a collecté plus de 303 milliards de tokens de données françaises ainsi que 36 milliards de tokens de données de traduction français-anglais, toutes publiques. L’ensemble d’entraînement compte 3 000 milliards de données de jetons après suréchantillonnage, soit plus que celui de Llama 2.

CroissantLLM, basé sur l’architecture Llama, compte 1,3 milliard de paramètres, une taille qui permet une exécution rapide sur des serveurs GPU bas de gamme et une vitesse décente sur des appareils mobiles ou des processeurs. Le modèle est ainsi accessible à un large éventail d’utilisateurs, que ce soit pour des applications industrielles spécifiques, des traductions ou le chat.

Les évaluations du modèle

Pour évaluer les performances du modèle en français, les chercheurs ont introduit FrenchBench, qui se compose de diverses tâches de classification et de génération. Ils l’ont par ailleurs également évalué sur des benchmarks anglais.

Les évaluations montrent que CroissantLLM offre des performances compétitives tant en anglais qu’en français. Sur les benchmarks de classification français, CroissantLLM surpasse largement les modèles de tailles similaires entraînés principalement sur des données monolingues anglais ou français, ainsi que les modèles multilingues. Il devance des modèles jusqu’à 3 fois plus grands sur la plupart des tâches (Bloom 3B).

Pour CroissantLLM Chat, les chercheurs ont affiné CroissantLLM sur des données de chat, notamment sur des interactions avec ChatGPT, afin de développer ses compétences de conversation dans les deux langues.

Un modèle transparent et éthique

L’équipe de recherche a veillé au respect des règles fixées par le récent AI Act afin de faire de CroissantLLM un modèle éthique.

Manuel Faysse, l’un des membres de l’équipe de recherche, explique dans un blog sur Hugging Face :

“L’initiative CroissantLLM a été conçue dès le départ dans un souci de transparence. Nous validons 81 % des critères de transparence du cadre FMTI, bien au-delà des scores des initiatives les plus ouvertes, en publiant les données, les modèles, la procédure de formation et tout le code utilisé pour conserver les données et entraîner le modèle”. 

Les modèles, ensembles de données, codes de formation, critères d’évaluation et données sont entièrement open source :

Références de l’article : blog Manuel Faysse

IA générative le MICS lance CroissantLLM, un modèle open source bilingue français-anglais

🔲 ☆

Elon Musk porte plainte contre OpenAI et son cofondateur Sam Altman

En 2015, Elon Musk, Sam Altman et Greg Brockman lançaient OpenAI, une association à but non lucratif dont l’objectif était de promouvoir et développer une intelligence artificielle bénéficiant à l’humanité. Elon Musk, qui l’a quittée en 2018, a déposé plainte la semaine dernière contre OpenAI et ses cofondateurs pour non-respect de l’accord initial à l’origine de la création de l’association.

A l’origine, OpenAI était une organisation à but non lucratif qui s’était donné pour mission principale de veiller à ce que l’intelligence artificielle générale (AGI ou IAG) profite à tous. Il est écrit dans sa charte : “Nous tenterons de construire directement des AGI sûres et bénéfiques, mais considérerons également notre mission comme remplie si notre travail aide les autres à atteindre ce résultat”.

En 2019, peu après le départ d’Elon Musk et le développement de GPT-2, elle s’est restructurée et a créé OpenAI LP, pour pouvoir lever des fonds afin de poursuivre ses travaux et motiver les chercheurs. Les bénéfices d’OpenAI LP devaient être plafonnés et tout excédent versé à l’association non-lucrative OpenAI.

La même année, OpenAI a signé un partenariat exclusif avec Microsoft, qui lui a fourni un milliard de dollars et un accès à sa plateforme cloud Azure.

Les raisons exactes du départ d’Elon Musk n’ont pas été explicitement divulguées, mais il a été rapporté que sa décision était motivée par des conflits d’intérêts potentiels liés à ses autres entreprises, notamment Tesla et SpaceX, qui pouvaient avoir des projets ou des intérêts concurrents avec OpenAI. Des divergences d’opinion quant à la gestion de l’organisation ont également été évoquées.

Récemment, le très médiatique entrepreneur a annoncé la pose du 1er implant de sa société Neuralink sur un humain et le lancement de Grok, la première IA générative de sa start-up xAI. Elon Musk a déposé le nom de cette dernière société le 9 mars l’an passé, alors qu’il était l’un des principaux détracteurs de l’IA, la qualifiant de menace pour l’humanité, et a été l’un des signataires de la lettre ouverte “Pause Giant AI Experiments” publiée le 29 mars suivant. Celle-ci appelait tous les laboratoires d’IA à suspendre immédiatement et pendant au moins 6 mois l’entraînement de systèmes d’IA plus puissants que GPT-4.

Pourquoi une plainte aujourd’hui ?

OpenAI commercialise GPT-4 tout comme Elon Musk prévoit de le faire pour Grok qui sera disponible pour tous les abonnés X Premium+.

Selon ce dernier, GPT-4 se rapproche de l’IAG : l’investissement de Microsoft de l’an passé n’est donc pas compatible avec la mission initiale de l’association, le fait qu’il ne soit pas open source non plus. Il estime qu’OpenAI est devenue une machine à profit et détourne le bénéfice de l’IA au profit de Microsoft, et ce, au détriment de l’humanité.

Il a donc décidé de déposer plainte pour rupture de contrat, manquement à l’obligation fiduciaire et pratiques commerciales déloyales. Il y vise spécifiquement Sam Altman, mentionnant la signature d’une lettre d’intention en 2019, “pour acquérir pour 51 millions de dollars de puces à une start-up dans laquelle M. Altman a beaucoup investi”. Elon Musk fait ici référence à la société Rain AI, basée à San Francisco.

Les deux hommes qui ont pris l’habitude de communiquer via les médias et réseaux sociaux ne semblent pas près de se réconcilier. Selon OpenAI, sa collaboration avec Microsoft est avant tout un moyen de soutenir son objectif de créer une intelligence artificielle bénéfique pour l’humanité.

Que la plainte soit traitée ou non, quelles que soient les motivations réelles d’Elon Musk, elle met en lumière le risque de mainmise des grandes entreprises technologiques sur le marché de l’IA générative. D’ailleurs, Microsoft et OpenAI font partie des sociétés dont les partenariats sont examinés par la Federal Trade Commission (FTC) aux Etats-Unis, La Commission européenne et l‘Autorité de la concurrence en France.

NDLR : Cet article mentionne IA générative et IA générale. L’intelligence artificielle générative est de plus en plus mentionnée sous l’acronyme IAG, pouvant prêter à confusion avec l’intelligence artificielle générale, pour laquelle cet acronyme est traditionnellement employé. Il convient de rappeler que les deux sont distinctes. L’IA générative représente une classe d’IA destinée à générer du contenu (texte, image, vidéo..), par opposition à l’IA prédictive. Le concept d’IA générale désigne quant à lui une intelligence artificielle non spécialisée, multimodale, et dont le niveau pourrait être comparable à celui de l’intelligence humaine.

Elon Musk porte plainte contre OpenAI et son cofondateur Sam Altman

🔲 ☆

GitHub Accelerator : Lancement de l’appel à candidatures pour la Cohorte 2024

GitHub, la plateforme de développement collaboratif et de partage de code, a ouvert les candidatures pour sa deuxième cohorte du programme GitHub Accelerator, qui vise à aider les développeurs à travailler sur l’IA open source. Le programme, qui durera 10 semaines, offrira aux participants, notamment aux start-ups en phase d’amorçage, un financement de 40 000 $, un mentorat d’experts et de partenaires, ainsi qu’un accès à des ressources et des opportunités exclusives. Les candidats ont jusqu’au 5 mars prochain pour déposer leur projet.

L’initiative GitHub Accelerator a pour objectif de créer des carrières et des entreprises viables dans l’open source, en reconnaissant la valeur et l’impact des projets qui innovent et résolvent des problèmes réels. Après une première cohorte réussie, qui a couvert divers domaines tels que le web, le mobile, le design, la mode, l’éducation, la biologie…, la seconde se concentrera sur les nouvelles frontières et technologies de l’IA.

Stormy Peters, vice-présidente des communautés chez GitHub, déclare :

“La création d’une entreprise d’IA prospère à l’air libre comporte son lot de défis. En plus des obstacles liés au temps et au financement que nous connaissons déjà dans l’open source, les dépenses accrues et les considérations éthiques, sécuritaires et juridiques sont décourageantes. Nous considérons ces défis comme un risque pour l’innovation mondiale et nous espérons y contribuer.

Cette cohorte d’accélérateurs se concentrera sur le financement des personnes et des projets qui construisent des solutions basées sur l’IA sous une licence open source pour améliorer le monde qui les entoure”.

Dix projets seront sélectionnés, évalués sur la base de critères tels que la qualité, la pertinence, la diversité et la viabilité, qu’ils soient ou non hébergés sur GitHub. Un nombre croissant d’utilisateurs actifs sera un plus.

Les détails du programme

Le programme GitHub Accelerator débutera le 22 avril et comprendra un mélange de sessions individuelles, de sessions de groupe, de travaux de projet et de mentorat. Les participants recevront également :

  • 40 000 $ par projet en financement non dilutif.
  • 5 à 10 heures par semaine d’instruction en direct, d’ateliers et de devoirs.
  • Des heures de bureau avec l’équipe GitHub pour des revues de sécurité.
  • Des séances de questions-réponses avec des sponsors d’entreprise GitHub, des membres de la communauté et des leaders de GitHub.
  • Une introduction et au moins une heure de bureau avec M12, le fonds de capital-risque de Microsoft.
  • Un accès gratuit aux produits GitHub pertinents, y compris une année complète de GitHub Copilot.
  • Les projets éligibles recevront des crédits gratuits d’infrastructure Azure AI, y compris un accès privilégié à des clusters de machines virtuelles GPU haut de gamme et un support personnalisé de mise sur le marché.
  • Un canal Slack partagé avec la cohorte pour collaborer et se soutenir mutuellement.

Les projets sélectionnés seront présentés lors d’un événement virtuel organisé par GitHub à la fin du programme, où ils pourront montrer leurs progrès, leurs défis et leurs ambitions. Le programme GitHub Accelerator espère ainsi contribuer à faire avancer l’IA open source, en mettant en lumière les talents et les idées qui la font vivre.

GitHub Accelerator Lancement de l'appel à candidatures pour la Cohorte 2024

🔲 ☆

LLaMandement, le LLM open source du gouvernement français

Esther Mac Namara, Déléguée à la transformation numérique de la DGFIP, a annoncé récemment la publication de LlaMandement, un LLM développé par la DGIFP pour générer des résumés neutres des amendements parlementaires, soulageant ainsi les agents publics qui doivent analyser et traiter un nombre croissant d’amendements.

Les LLMs, grâce à leur capacité à effectuer des tâches complexes de traitement du langage, ont ouvert de nouveaux horizons pour l’innovation au sein de l’administration française. Celle-ci s’en est rapidement emparée et 1000 agents de la CNAV (Caisse Nationale d’Assurance Vieillesse), Pôle Emploi ou l’Assurance Maladie ont testé avec succès l’an passé un modèle adapté par la start-up française AlloBrain, du LLM Claude, d’Anthropic. En novembre dernier, le département Etalab de la direction interministérielle du numérique (DINUM), en charge de la coordination de la stratégie de l’État en matière de données, présentait son outil d’IA générative Albert.

La Délégation à la Transformation Numérique (DTNUM), qui joue un rôle essentiel dans la modernisation des services publics en France, a ciblé le traitement des amendements pour un projet impliquant des LLMs. LLaMandement vise ainsi à automatiser la distribution des amendements entre différentes expertises ministérielles, à rechercher des réponses précédentes à des situations similaires et à formuler une synthèse claire, précise et neutre d’un amendement.

L’examen d’un projet de loi implique un débat et un vote sur les amendements (modifications du texte proposées par le Parlement ou le Gouvernement), un processus dans lequel les agents administratifs jouent un rôle central. Ils doivent analyser et traiter un nombre croissant d’amendements, jusqu’à des milliers pour un projet de loi, ce qui limite la durée maximale de leur gestion, affectant ainsi l’efficacité, la précision et la fiabilité des analyses nécessaires à l’élaboration des lois.

Depuis 2020, les agents administratifs peuvent travailler de manière plus efficace grâce au Système de Gestion Digitale Interministérielle des Amendements Législatifs (SIGNALE) qui facilite la rédaction de notes de synthèse et la création de tableaux pour la préparation des réunions interministérielles concernant les textes législatifs.

Le LLM LLaMandement

Le modèle LLaMandement est le fruit des travaux des datascientists et des spécialistes de la loi de la DGFIP, la DILA (Direction de l’Information Légale et Administrative) et la DINUM.

Basé sur le modèle open source LLaMA 2 de Meta, il a été adapté au domaine législatif grâce à la technique de l’adaptation de rang faible (LORA) et été entraîné sur un ensemble de données composé de plus de 15 000 paires d’amendements et de résumés issus de la plateforme SIGNALE.

Les qualités éthiques des résumés automatiques ont été évaluées sur le jeu de données Bias in Open-ended Language Generation, le modèle LLaMandementa obtenu des scores très satisfaisants.

Il a également atteint un niveau de performance proche de celui des rédacteurs humains, tout en étant plus rapide et plus économe en ressources. Il a démontré sa capacité à traiter et à synthétiser des textes législatifs complexes et variés, provenant de différents ministères, à améliorer l’efficacité opérationnelle des agents tout en garantissant des résumés neutres et précis, essentiels pour le processus législatif.

Pour que d’autres s’appuient sur ses travaux, les chercheurs publient :

Références de l’article :

“LLaMandement : Large Language Models for Summarization of French Legislative Proposals” arXiv, 29 janvier, https://doi.org/10.48550/arXiv.2401.16182

Auteurs : Joseph Gesnouin 1, Yannis Tannier 1, Christophe Gomes Da Silva 1, Hatim Tapory 1, Camille Brier 1, Hugo Simon 1, Raphaël Rozenberg 1, Hermann Woehrel 1, Mehdi El Yakaabi 1, Thomas Binder 1, Guillaume Marie 1, Emilie Caron1, Mathile Nogueira 1, Thomas Fontas 1, Laure Puydebois 1, Marie Theophile 1, Stéphane Morandi 1, Maël Petit 1, David Creissac 1, Pauline Ennouchy 1, Elise Valetoux 1, Céline Visade 2, Severine Balloux 2, Emmanuel Cortes 2, Pierre-Etienne Devineau 3, Ulrich Tan 3, Esther Mac Namara 1, Su Yang 1

1 : French Ministry of Economics and Finance – Directorate General of Public Finances
2 : General Secretariat of the French Government – Legal and Administrative Information Directorate
3 : French Interministerial Digital Department

LLaMandement, le LLM open source du gouvernement français

🔲 ☆

Comment Hugging Face reste à la pointe de l’innovation

Hugging Face ne cesse d’innover : fin janvier, l’entreprise a non seulement annoncé de nouveaux LLM open-source en tant qu’agents LangChain, un partenariat stratégique avec Google Cloud, l’optimisation de StarCoder mais également  Hugging Chat Assistants, une boutique de chatbots personnalisés sur Hugging Chat à l’instar de GPT Store, mais contrairement à ce dernier, ceux de Hugging Face sont gratuits et open source.

Passée au rang de licorne après une levée de fonds de 235 millions de dollars en août dernier, Hugging Face, start-up créée à Paris en 2016, continue de jouer un rôle fondamental dans l’accélération de la recherche en IA grâce à son approche open source.

Dans son article de blog le 24 janvier dernier, Hugging Face expliquait comment construire et évaluer des agents de raisonnement à usage général basés sur les grands modèles de langage (LLM) open source comme Mixtral-8x7B , en utilisant la classe ChatModel de LangChain et l’approche ReAct.

L’article du 30 janvier suivant présentait les résultats de l’optimisation de son modèle de génération de code développé en collaboration avec Service Now, StarCoder (15B) sur Intel Xeon de 4e génération, en utilisant la quantification 8 bits et 4 bits et la génération assistée. En combinant la quantification 8 bits et la génération assistée, le modèle StarCoder atteint une accélération d’inférence de plus de 7 fois par rapport au modèle de référence, sans perte de qualité.

Entre temps, Hugging Face annonçait un partenariat stratégique avec Google Cloud, afin de rendre l’IA plus accessible et plus performante pour les entreprises, en s’appuyant sur les modèles ouverts et les technologies open source.

Le partenariat vise à combiner les avantages de la plateforme ouverte de Hugging Face, qui permet aux scientifiques des données, aux ingénieurs en ML et aux développeurs d’accéder aux derniers modèles de la communauté, et de les utiliser sur la plateforme de leur choix à ceux de la plateforme Vertex AI de Google Cloud qui permet de déployer des modèles d’IA ainsi que d’assurer leur maintenance.

Il facilite ainsi l’intégration des modèles ouverts de Hugging Face dans Vertex AI et GKE (Google Kubernetes Engine) et permet aux clients de Google Cloud d’exploiter les modèles de Hugging Face et les fonctionnalités avancées de Google Cloud, comme Vertex AI et les TPU, pour développer et déployer des applications d’IA plus efficacement.

Les deux entreprises ont également annoncé qu’elles allaient collaborer sur les plans de la science ouverte, de l’open source, du cloud et du matériel, pour rendre les dernières innovations en intelligence artificielle plus accessibles à la communauté.

Hugging Face Assistants, l’alternative open source et gratuite à GPT Store

Le 2 février dernier, Hugging Face présentait Hugging Chat Assistants, qui permet de créer des chatbots après avoir créé un compte Hugging Face (gratuit), sa boutique fonctionne comme le GPT Store déployé en janvier dernier par Open AI.

Alors que celui-ci permet aux abonnés de ChatGPT Plus, Enterprise et de la nouvelle offre ChatGPT Team de créer leurs assistants à partir de ChatGPT, ceux de Hugging Face le seront à partir du chatbot open source Hugging Chat.

Pour le personnaliser, les utilisateurs peuvent s’appuyer sur les modèles open source Mixtral 8x7B et mistral 7B Instruct de Mistral AI, Llama-2 70B et CodeLlama 70B Instruct de Meta, Hermes 2 – Mixtral 8x7B – DPO , formé par Nous Research sur le LLM Mixtral 8x7B MoE et OpenChat 3.5.

Selon Julien Chaumond, cofondateur et CTO de Hugging Face, en à peine 3 jours, 4 000 assistants avaient été créés et 1 500 utilisateurs  avaient discuté avec son  propre clone  “Clone of HF CTO”.

Il ajoute que suite aux premiers retours de la communauté, Hugging Face envisage d’introduire les éléments suivants :

  • Possibilité de modifier vos assistants via l’API, permettant ainsi d’envoyer des informations actualisées à vos assistants à tout moment.
  • Intégration de RAG (et de la fonctionnalité de recherche sur le Web) à l’Assistant, enrichissant ainsi ses capacités de recherche et de réponse.
  • Fonctionnalité pour générer votre assistant de vignettes via l’IA, offrant une manière intuitive et automatisée de créer des représentations visuelles pour vos assistants.
  • Proposition de modifications sur les assistants d’autres utilisateurs, favorisant ainsi la collaboration et l’amélioration collective des assistants.
  • Ajout régulier de nouveaux modèles à HuggingChat et aux Assistants, garantissant une variété et une qualité constantes des modèles disponibles pour les utilisateurs.


Comment-Hugging-Face-pointe-innovation

🔲 ☆

Comment Ai2 démocratise la recherche sur les LLM avec OLMo (Open Language Model)

L’Allen Institute for Artificial Intelligence (Ai2), organisation à but non lucratif, a été créé en 2014 par Paul Allen, co-fondateur de Microsoft dans le but de participer activement au développement de l’intelligence artificielle pour le bien commun. Il franchit un pas décisif dans cette direction avec la publication du LLM OLMo. Alors que certains modèles open source incluent les codes et les poids, Ai2 rend le modèle OLMo véritablement ouvert en fournissant non seulement les codes et les poids, mais aussi le code d’entraînement, les données d’entraînement et les boîtes à outils associées, le tout sous licence Apache 2.0.

Avec la publication du modèle de pointe OLMo et du cadre qui l’accompagne, l’objectif d’Ai2 est de favoriser l’innovation et la collaboration sur les modèles de langage, tout en sensibilisant aux enjeux éthiques et sociétaux qu’ils soulèvent.

Hanna Hajishirzi, Cheffe de projet OLMo, Directrice principale de la recherche en NLP à AI2 et professeure à l’Allen School de l’UW, explique:

“De nombreux modèles de langage sont aujourd’hui publiés avec une transparence limitée. Sans avoir accès aux données d’entraînement, les chercheurs ne peuvent pas comprendre scientifiquement le fonctionnement d’un modèle. C’est l’équivalent de la découverte de médicaments sans essais cliniques ou de l’étude du système solaire sans télescope. Grâce à notre nouveau cadre, les chercheurs seront enfin en mesure d’étudier la science des LLM, ce qui est essentiel pour construire la prochaine génération d’IA sûre et digne de confiance”.

OLMo est le fruit d’une collaboration avec le Kempner Institute for the Study of Natural and Artificial Intelligence de l’Université Harvard et des partenaires tels qu’AMD, CSC, la Paul G. Allen School of Computer Science & Engineering de l’Université de Washington et Databricks.

Les modèles OLMo 7B et 1B ont été développés sur le supercalculateur LUMI du CSC (Centre de technologie de l’information pour la science), alimenté par des processeurs AMD EPYC™ et des accélérateurs AMD Instinct™ et ont été entraînés grâce à la plateforme MosaicML de Datbricks.

Le cadre comprend une suite d’outils de développement d’IA entièrement ouverts, notamment :

  • Données de pré-entraînement complètes : le modèle est construit sur l’ensemble Dolma d’AI2 qui comprend un corpus ouvert de trois billions de jetons pour le pré-entraînement du modèle de langage, y compris le code qui produit les données d’apprentissage.
  • Le cadre OLMo comprend des pondérations de modèle complètes pour quatre variantes de modèle à l’échelle 7B, chacune entraînée à au moins 2T tokens. Le code d’inférence, les métriques d’entraînement et les journaux d’entraînement sont tous fournis.
  • Evaluation : Ai2 a publié la suite d’évaluation utilisée dans le développement, avec plus de 500 points de contrôle par modèle, toutes les 1000 étapes du processus de formation et le code d’évaluation sous l’égide du projet Catwalk.

Eric Horvitz, directeur scientifique de Microsoft et membre fondateur du conseil consultatif scientifique d’AI2, déclare :

“Je suis enthousiaste à l’idée de mettre OLMo entre les mains des chercheurs en IA. La nouvelle offre s’inscrit dans la tradition d’Allen AI de fournir des modèles, des outils et des données ouverts de valeur, qui ont stimulé de nombreuses avancées dans le domaine de l’IA dans la communauté mondiale”.

Avec OLMo, les chercheurs et développeurs en IA feront l’expérience de :

  • Plus de précision : Grâce à une connaissance complète des données d’entraînement qui sous-tendent le modèle, les chercheurs seront en mesure de travailler plus rapidement et n’auront plus besoin de dépendre d’hypothèses qualitatives sur la façon dont le modèle fonctionne, mais pourront le tester scientifiquement.
  • Moins de carbone : À l’heure actuelle, une séance d’entraînement équivaut aux émissions de neuf foyers américains pendant un an, selon l’EPA, l’agence américaine de protection de l’environnement. En offrant un accès complet à l’écosystème de formation et d’évaluation, Ai2 diminue considérablement les répétitions dans le processus de développement, ce qui est crucial pour la réduction des émissions de carbone dans le domaine de l’intelligence artificielle.
  • Des résultats durables : Le fait de garder les modèles et leurs ensembles de données ouverts et non derrière les API permet aux chercheurs d’apprendre et de s’appuyer sur des modèles et des travaux antérieurs.

Ai2 prévoit d’ajouter prochainement différentes tailles de modèles, modalités, ensembles de données et capacités à la famille OLMo.

Noah Smith, chef de projet OLMo, directeur principal de la recherche en NLP à AI2 et professeur à l’Allen School de l’UW, conclut :

“Avec OLMo, ouvert signifie en fait « ouvert » et tous les membres de la communauté de recherche en IA auront accès à tous les aspects de la création de modèles, y compris le code d’entraînement, les méthodes d’évaluation, les données, etc…L’IA était autrefois un domaine ouvert centré sur une communauté de recherche active, mais à mesure que les modèles se sont développés, sont devenus plus chers et ont commencé à se transformer en produits commerciaux, le travail sur l’IA a commencé à se dérouler derrière des portes closes. Avec OLMo, nous espérons aller à l’encontre de cette tendance et donner à la communauté des chercheurs les moyens de se réunir pour mieux comprendre et s’engager avec les modèles de langage de manière scientifique, ce qui conduira à une technologie d’IA plus responsable qui profite à tous”.

Le modèle OLMo et son framework sont accessibles en téléchargement direct sur Hugging Face et GitHub.

Comment-Ai2-democratise-recherche-LLM-avec-OLMo

🔲 ☆

Probabl : vers une science des données souveraine et open source

Fondée en septembre 2023, issue d’un projet confié à Inria par le secrétariat général pour l’investissement dans le cadre de France 2030, la start-up Probabl propose des solutions et des services basés sur la bibliothèque open-source d’apprentissage statistique en Python “scikit-learn”, l’une des plus utilisées dans le monde avec PyTorch et TensorFlow,“afin de pérenniser son existence et d’assurer son rayonnement”.

La mission P16 confiée à Inria et soutenue par de nombreux industriels dont Airbus, Axa, Berger-Levrault, Criteo, Dassault Systèmes, Docaposte, Hugging Face, Naval Group, OpenValue et Valeo, vise à développer et pérenniser des outils open source pour la science des données, l’IA et le ML, en étendant l’infrastructure logicielle de scikit-learn. Elle se concrétise à travers deux initiatives : l’une dirigée par Inria pour les aspects de R&D, et l’autre menée par sa spin-off Probabl pour la dimension industrielle.

La start-up est dirigée par Yann Lechelle, un entrepreneur chevronné de la French Tech et ancien directeur général de Scaleway. Il est entouré d’une équipe d’experts comprenant notamment Camille Troillard, Gaël Varoquaux (Directeur de Recherche à Inria) et Olivier Grisel, l’un des porteurs du projet scikit-learn avec Loïc Estève, Alexandre Gramfort,  Bertrand Thirion, Gaël Varoquaux, de membres du consortium scikit-learn tels que François Goupil, Guillaume Lemaitre et Jérémie Du Boisberranger, ainsi que par Fabien Gandon, Directeur de Recherche à Inria.

Une gouvernance et un actionnariat adaptés à sa raison d’être

Pour assurer sa mission ambitieuse, Probabl a mis en place un modèle d’actionnariat équilibré, reflétant son engagement en faveur de la souveraineté industrielle et numérique. Trois collèges d’actionnaires se partagent les parts de l’entreprise : un collège public représentant l’Etat via le dispositif French Tech Souveraineté, un collège privé comprenant des investisseurs tels que le fonds Costanoa Ventures spécialisé dans les solutions open source, et enfin un collège de collaborateurs individuels. Cette structure garantit une  représentation équitable de chaque partie prenante mais également une gouvernance équilibrée avec deux sièges par collège et un siège pour un membre indépendant, occupé par la chercheuse et entrepreneuse Stéphan-Eloïse Gras.

Une vision orientée vers l’innovation et la durabilité

Probabl s’est donné pour mission de renforcer la résilience de la France et de l’Europe tout en réduisant leur dépendance technologique “grâce à une technologie open source qu’elles ont vu naître”. Ciblant le marché global de la science des données au delà de scikit-learn, estimé à près de 700 milliards d’euros d’ici 2030, l’entreprise entend jouer un rôle clé dans la transformation numérique de la société et dans l’adoption d’un IA industrielle efficiente et conforme à l’AI Act européen, dans le respect des normes éthiques et juridiques les plus strictes.

Parmi ses projets, des offres liées à la formation, au support, la certification, l’hébergement et la fourniture de services gérés, aux services professionnels…

levee-de-fonds-probabl

❌