Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierFlux principal

155/2. Qu’est-ce que l’argent ? Dollar, Dette, Bitcoin… Le système monétaire peut-il tenir ? - LYN ALDEN (#VF)

12 septembre 2025 à 08:15

2/2 - Comprendre le fonctionnement de la monnaie, sa place dans le monde actuel et les risques de rupture.


Qu’est-ce que l’argent, au fond ?

Dans cet épisode, on explore les structures profondes de notre système financier avec la macro-stratégiste Lyn Alden. On parle de la monnaie comme registre, du lien entre finance et énergie, de l’illusion de la croissance infinie, et des conséquences cachées de la dette et de l’effet de levier.


Episode enregistré le 30/06/2025


---

Retrouvez tous les épisodes et les résumés sur www.sismique.fr

Sismique est un podcast indépendant créé et animé par Julien Devaureix.

👉 Suivez Sismique sur : Twitter, Instagram, FacebookLinkedin

👉 Rejoignez le serveur DISCORD SISMIQUE

👉 Abonnez-vous à la newsletter

👉 SOUTENEZ le projet !

Patreon: https://www.patreon.com/sismiquepodcast

Tipeee : https://fr.tipeee.com/sismiquepodcast

Paypal : https://www.paypal.com/paypalme/juliendevaureix


Hébergé par Acast. Visitez acast.com/privacy pour plus d'informations.

💾

swift-justhtml

19 décembre 2025 à 00:57

swift-justhtml

First there was Emil Stenström's JustHTML in Python, then my justjshtml in JavaScript, then Anil Madhavapeddy's html5rw in OCaml, and now Kyle Howells has built a vibespiled dependency-free HTML5 parser for Swift using the same coding agent tricks against the html5lib-tests test suite.

Kyle ran some benchmarks to compare the different implementations:

  • Rust (html5ever) total parse time: 303 ms
  • Swift total parse time: 1313 ms
  • JavaScript total parse time: 1035 ms
  • Python total parse time: 4189 ms

Tags: html5, ai, generative-ai, llms, ai-assisted-programming, vibe-coding, swift

JustHTML is a fascinating example of vibe engineering in action

14 décembre 2025 à 16:59

I recently came across JustHTML, a new Python library for parsing HTML released by Emil Stenström. It's a very interesting piece of software, both as a useful library and as a case study in sophisticated AI-assisted programming.

First impressions of JustHTML

I didn't initially know that JustHTML had been written with AI assistance at all. The README caught my eye due to some attractive characteristics:

  • It's pure Python. I like libraries that are pure Python (no C extensions or similar) because it makes them easy to use in less conventional Python environments, including Pyodide.
  • "Passes all 9,200+ tests in the official html5lib-tests suite (used by browser vendors)" - this instantly caught my attention! HTML5 is a big, complicated but meticulously written specification.
  • 100% test coverage. That's not something you see every day.
  • CSS selector queries as a feature. I built a Python library for this many years ago and I'm always interested in seeing new implementations of that pattern.
  • html5lib has been inconsistently maintained over the last few years, leaving me interested in potential alternatives.
  • It's only 3,000 lines of implementation code (and another ~11,000 of tests.)

I was out and about without a laptop so I decided to put JustHTML through its paces on my phone. I prompted Claude Code for web on my phone and had it build this Pyodide-powered HTML tool for trying it out:

Screenshot of a web app interface titled "Playground Mode" with buttons labeled "CSS Selector Query" (purple, selected), "Pretty Print HTML", "Tree Structure", "Stream Events", "Extract Text", and "To Markdown" (all gray). Below is a text field labeled "CSS Selector:" containing "p" and a green "Run Query" button. An "Output" section with dark background shows 3 matches in a green badge and displays HTML code

This was enough for me to convince myself that the core functionality worked as advertised. It's a neat piece of code!

Turns out it was almost all built by LLMs

At this point I went looking for some more background information on the library and found Emil's blog entry about it: How I wrote JustHTML using coding agents:

Writing a full HTML5 parser is not a short one-shot problem. I have been working on this project for a couple of months on off-hours.

Tooling: I used plain VS Code with Github Copilot in Agent mode. I enabled automatic approval of all commands, and then added a blacklist of commands that I always wanted to approve manually. I wrote an agent instruction that told it to keep working, and don't stop to ask questions. Worked well!

Emil used several different models - an advantage of working in VS Code Agent mode rather than a provider-locked coding agent like Claude Code or Codex CLI. Claude Sonnet 3.7, Gemini 3 Pro and Claude Opus all get a mention.

Vibe engineering, not vibe coding

What's most interesting about Emil's 17 step account covering those several months of work is how much software engineering was involved, independent of typing out the actual code.

I wrote about vibe engineering a while ago as an alternative to vibe coding.

Vibe coding is when you have an LLM knock out code without any semblance of code review - great for prototypes and toy projects, definitely not an approach to use for serious libraries or production code.

I proposed "vibe engineering" as the grown up version of vibe coding, where expert programmers use coding agents in a professional and responsible way to produce high quality, reliable results.

You should absolutely read Emil's account in full. A few highlights:

  1. He hooked in the 9,200 test html5lib-tests conformance suite almost from the start. There's no better way to construct a new HTML5 parser than using the test suite that the browsers themselves use.
  2. He picked the core API design himself - a TagHandler base class with handle_start() etc. methods - and told the model to implement that.
  3. He added a comparative benchmark to track performance compared to existing libraries like html5lib, then experimented with a Rust optimization based on those initial numbers.
  4. He threw the original code away and started from scratch as a rough port of Servo's excellent html5ever Rust library.
  5. He built a custom profiler and new benchmark and let Gemini 3 Pro loose on it, finally achieving micro-optimizations to beat the existing Pure Python libraries.
  6. He used coverage to identify and remove unnecessary code.
  7. He had his agent build a custom fuzzer to generate vast numbers of invalid HTML documents and harden the parser against them.

This represents a lot of sophisticated development practices, tapping into Emil's deep experience as a software engineer. As described, this feels to me more like a lead architect role than a hands-on coder.

It perfectly fits what I was thinking about when I described vibe engineering.

Setting the coding agent up with the html5lib-tests suite is also a great example of designing an agentic loop.

"The agent did the typing"

Emil concluded his article like this:

JustHTML is about 3,000 lines of Python with 8,500+ tests passing. I couldn't have written it this quickly without the agent.

But "quickly" doesn't mean "without thinking." I spent a lot of time reviewing code, making design decisions, and steering the agent in the right direction. The agent did the typing; I did the thinking.

That's probably the right division of labor.

I couldn't agree more. Coding agents replace the part of my job that involves typing the code into a computer. I find what's left to be a much more valuable use of my time.

Tags: html, python, ai, generative-ai, llms, ai-assisted-programming, vibe-coding, coding-agents

#105 - Réseau Alumni & Certification Qualiopi : une stratégie gagnante ? Avec Laura Lizé - Datalumni

24 octobre 2024 à 14:00

Envie de dynamiser votre réseau alumni tout en garantissant la conformité avec la certification Qualiopi ?


On vous explique les secrets d'une stratégie gagnante dans ce nouvel épisode de Formation Innovation, issu d'un webinaire Edusign.


Avec Laura Lizé, fondatrice et CEO de Datalumni.

💾

Tribune libre #2 Comment écrire le métier de Conseiller.ère d’Éducation Populaire et de Jeunesse en 2024 ?

7 mai 2024 à 08:00

Retrouver une dignité de corps, faire face à l’urgence du temps présent

Par Ronan David 1

Le corps des Conseillers d’éducation populaire et de jeunesse a une histoire, un souffle… ! Il tire sa légitimité d’un corps plus ancien encore, celui des instructeurs spécialisés, souhaité par Jean Guéhenno au sortir de la Seconde Guerre afin d’éviter le retour dans la barbarie que fût la Seconde Guerre mondiale et avec elle, le déferlement de haine qui conduisit notamment à l’extermination des juifs d’Europe. Ni corps de gestionnaire assis, de bureaucrate ou de contrôleur zélé ni corps d’agent de développement, d’animateur de réseaux ou de manager de projets, c’est la création d’un corps d’instructeurs spécialisés qu’avait voulu Jean Guéhenno pour « apprendre aux jeunes gens, non pas seulement à lire mais à bien lire, c’est-à-dire à discerner le mensonge de la vérité, à dire d’abord non à tout papier imprimé qui leur est jeté sous les yeux ». Avec ce corps, Guéhenno ambitionnait de pouvoir « interdire, disait-il, à force de culture et de raison, ce qu’on a justement appelé “le viol des foules” par tous les mécanismes des propagandes ».

On ne peut comprendre aujourd’hui les derniers soubresauts qui agitent encore parfois quelques services « Jeunesse et Sports » si l’on ne comprend pas que notre corps n’est pas simplement un ensemble institué de textes, d’instructions et de règlements mais qu’il est aussi habité, « hanté » par un souffle, par une éthique de résistance que Jean Guéhenno avait bien voulu lui donner. Lui, le combattant de la Grande Guerre, jamais « guéri » et toujours hanté par la boucherie des tranchées où il avait vu mourir ses jeunes amis, lui, le résistant des « années noires » hanté par le déshonneur de la servitude, avait voulu créer dans la fugace direction de la culture et des mouvements de jeunesse, un projet d’éducation critique du peuple où se noueraient ensemble culture et raison au service de la formation d’esprits libres.

Aujourd’hui, le corps des conseilleurs d’éducation populaire et de jeunesse n’est plus que l’ombre de ces instructeurs spécialisés errant dans les abîmes d’un travail mortifère de gestionnaire de tableaux et de dispositifs, de contrôleur d’ACM et de producteur de « power-points », d’administrateur subventions et d’employé de plateformes. Sa langue n’est pas littéraire ou politique mais technique et bureaucratique, il ne s’exprime quasiment plus dans un langage sensible et humain à même d’accompagner à la compréhension du monde qui nous entoure mais avec une foule d’acronymes obscurs mâtinée d’un vocabulaire managérial abscons qui façonnent dès lors un jargon incompréhensible et vide.

Pire, pris dans les rets d’un pouvoir autoritaire et répressif, le corps des CEPJ s’est trouvé humilié par l’obligation faite de gérer le dispositif répressif et autoritaire du « Service National Universel » devenu dispositif « d’émancipation » par un travestissement du langage typiquement orwellien dans lequel « la guerre est devenue la paix », « l’ordre et la rectitude – l’émancipation ».

Aujourd’hui que la guerre fait rage au cœur même de l’Europe, que la dénazification est le symbole même de la barbarie, que les routes se sont à nouveau chargées des pas lourds des enfants de Marioupol, d’Odessa, de Tchernihiv et que l’ensemble des pays d’Europe se préparent à la guerre, il nous appartient, à nous aussi, Conseillers d’Éducation populaire et de Jeunesse, de prendre notre part « au monde », de renouer avec les exigences d’une pensée « révoltée » et d’une éducation populaire qui n’aurait plus qu’une seule tâche à laquelle œuvrer, celle « d’empêcher, comme le suggérait Albert Camus, que le monde ne se défasse ».

Ce projet est exigeant, complexe, difficile et sollicite davantage l’intelligence critique que le zèle ou la paresse bureaucratique. Il a le mérite de donner du souffle, de faire se lever le vent de la révolte et de l’engagement contre la morgue du pouvoir, de l’institué et de cette vie marchandisée qui ne cesse de sentir la mort. Ce n’est pas au passé des instructeurs que nous devons revenir mais nous nourrir de leurs lumières, de leurs éclairs pour tenter de faire advenir un monde redevenu fréquentable, un monde « commun ». Ce monde ne pourra advenir sans une rupture radicale avec les illusions, fantasmes, habitudes, servitudes qui sont aujourd’hui les nôtres et contre lesquels un travail d’éducation populaire mérite d’être mené. Ce travail ne pourra être réalisé que dès que notre corps, professionnel tout autant qu’individuel, cessera de se penser comme un corps d’exécution, d’administration pour renouer avec l’idée d’un corps de création, cessera de se penser comme un gestionnaire, un opérateur, un contrôleur, pour renouer avec la philosophie du métier d’artisan ou du créateur. Il s’agira en somme de passer du corps de fonctionnaire inerte, administré et « computerisé » au corps vivant, au corps d’amour pris dans les contradictions du monde mais luttant sans cesse contre la violence de celui-ci.

Notre tâche commence, à n’en pas douter, par regarder en face le dispositif inique du Service National Universel. Dans un monde profondément en crise, la tâche des conseillers d’éducation populaire ne peut être la préparation des jeunes consciences à la guerre et à la « réaction » face aux crises et désastres que le monde traverse, pas plus qu’il ne peut s’agir de chercher à instiller un « engagement » pour la « nation » ou la « patrie » qui s’imposerait aux jeunes comme une obligation extérieure n’ayant pas eu à démontrer sa légitimité et sa « raison » d’être. Impossible encore de familiariser à nouveau une génération entière aux uniformes et aux drapeaux, de transformer un corps vivant, poétique, sensible en un corps redressé, de former, enfin, des personnalités « adaptées » à l’état du monde.

S’il est encore temps pour nous de faire vivre notre héritage, une seule tâche nous incombe désormais, permettre à ces jeunes femmes et ces jeunes hommes de demeurer des individus libres et leur permettre de résister à ce qui, à un moment quelconque, les entraînerait à commettre les pires atrocités.

  1. Ronan David est conseiller d’éducation populaire et de jeunesse et docteur en sociologie. Il est par ailleurs membre du collectif Illusio qui s’attache à décrypter les processus de domination, débusquer les idéologies, et mettre à jour les phénomènes de réification qui traversent et structurent un monde en crise. ↩

Si vous avez aimé cet article, n’hésitez pas à vous abonner pour être averti des prochains par mail (“Je m’abonne” en bas à droite sur la page d’accueil). Vous pouvez également me suivre sur LinkedIn.

Pour citer cet article :

Tribune libre #2 Comment écrire le métier de Conseiller.ère d’Éducation Populaire et de Jeunesse en 2024 ? Retrouver une dignité de corps, faire face à l’urgence du temps présent. Ronan David, André Decamp, Regards sur le travail social, 7 mai 2024. https://andredecamp.fr/2024/05/07/tribune-libre-2-comment-ecrire-le-metier-de-conseiller-ere-deducation-populaire-et-de-jeunesse-en-2024

Faire dialoguer les pratiques entre pays

10 juin 2024 à 11:36

Faire dialoguer les pratiques entre pays

Plongée au cœur de l'expédition apprenante rwandaise

Article rédigé par Mathilde Bras et Maxime Lubrano et publié le 10 juin 2024

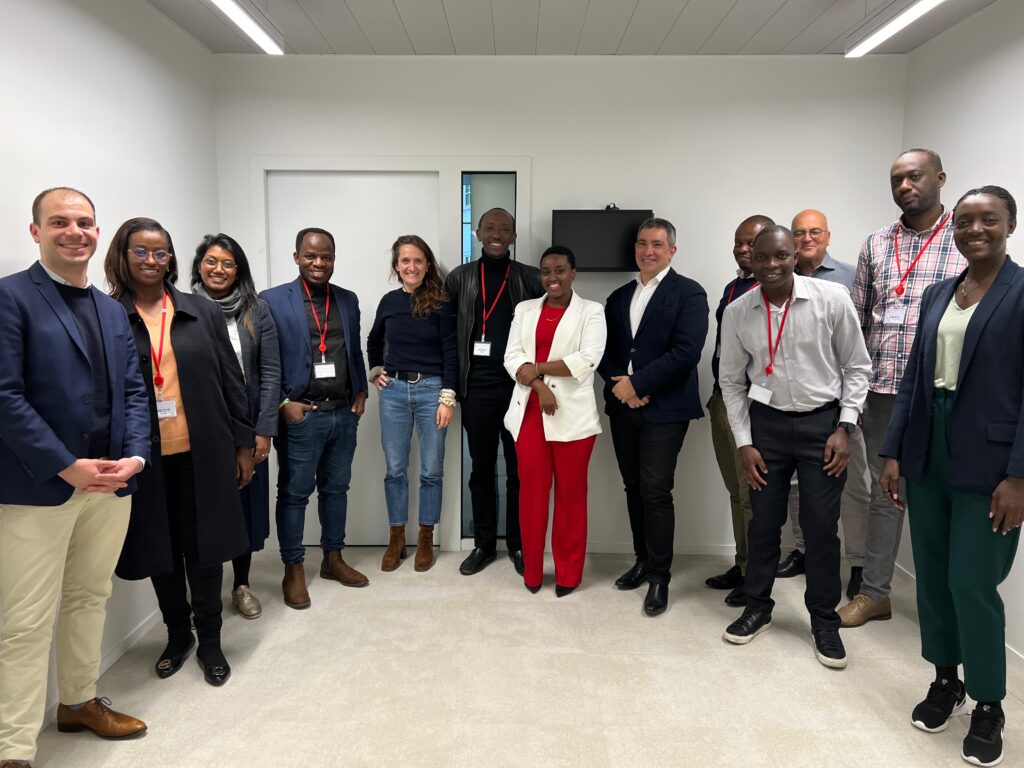
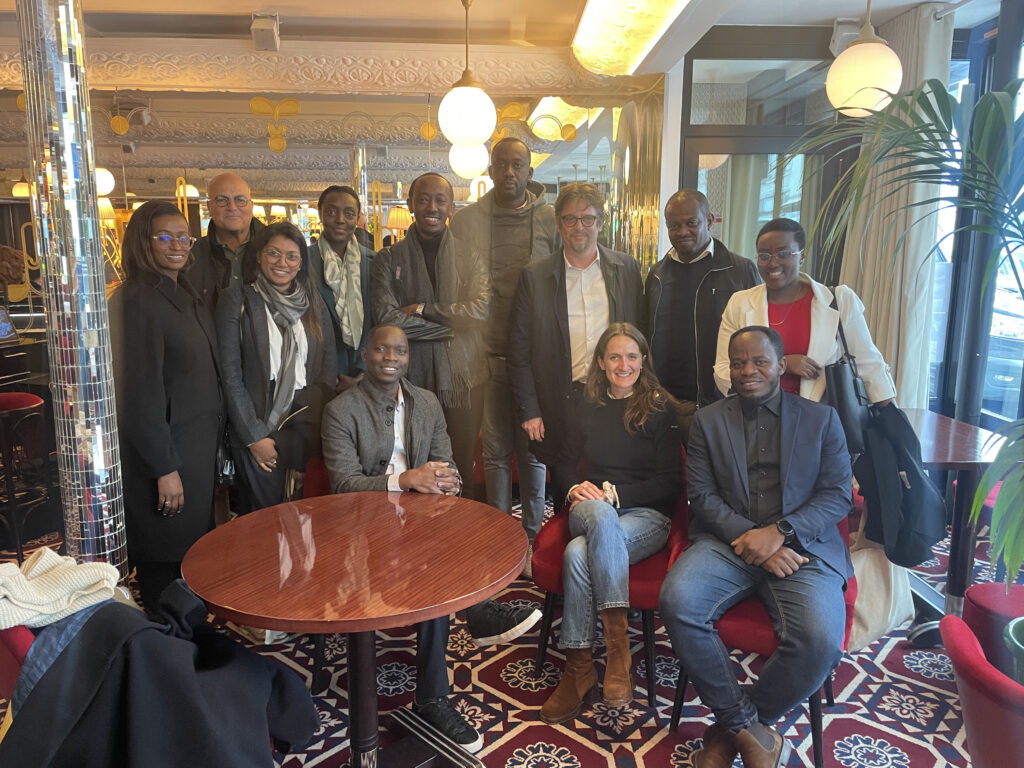
Du 25 au 29 mars 2024, une délégation rwandaise a été accueillie à Paris pour une expédition apprenante inédite.

Au programme : 5 jours pour s’immerger dans les méthodes et projets de transformation numérique publique en France et échanger entre pairs afin d’identifier de futurs chantiers.

A mi-parcours d’un projet visant à accompagner le réseau des Chief Digital Officers (CDO) du Rwanda, animé par la Rwanda Information Society Authority (RISA), cette expédition apprenante a offert aux CDO la possibilité de se “décentrer” du quotidien et de se projeter vers la suite de leur parcours de transformation numérique.

Embarquez avec nous pour découvrir le programme proposé et les principaux enseignements de cette semaine !

Pour Numéricité, accompagner des équipes revient avant tout à leur transmettre les clés de compréhension et les bonnes pratiques pour mettre en œuvre leurs projets de transformation numérique. Avec nos clients, nous proposons ainsi des formats adaptés à leurs besoins : parcours de formations, gages de montée en compétences et d’autonomisation des équipes, événements de co-construction (hackathons, open labs), ou encore expéditions apprenantes, sources d’inspiration et de reconnaissance entre pairs.

Dans un projet au long cours, organiser une expédition apprenante à mi-parcours est un moment clé pour :

  • Se décentrer du quotidien et proposer de nouvelles perspectives aux CDOs sur les axes prioritaires du projet

    Le projet FEXTE s’articule autour de 5 priorités thématiques : la gouvernance, les process, outils et méthodologies, la gestion du changement, la gestion des talents, et les relations avec l’écosystème. Depuis septembre 2023, nous travaillons avec les CDOs de manière alternée : des sessions de travail à distance qui démarrent souvent par un retour d’expérience français puis un approfondissement des réflexions pour concevoir le cadre d’implémentation au Rwanda ; et des missions sur le terrain à Kigali, permettant d’être au plus proche du contexte local et se projeter.

    L’expédition apprenante en France est donc un format complémentaire, qui permet d’incarner davantage les retours d’expérience, notamment via des rencontres avec des praticiens et praticiennes de l’administration française, et des visites “in situ” dans les institutions.

  • Alterner temps d’échanges et moments réflexifs

    Une expédition apprenante est souvent un moment intense. Au total, la délégation rwandaise a suivi les présentations de 15 intervenants de 8 administrations différentes. Une diversité de représentants et de praticiens des administrations françaises, porteurs d’initiatives clés pour la transformation numérique publique.

    En concevant le programme de la semaine, nous avons choisi d’alterner des moments d’échange sur les thématiques de travail du projet FEXTE avec les experts français et des temps de discussion “internes” à la délégation, afin de relier les retours d’expérience avec leurs défis communs. La composition de la délégation a été pensée en ce sens : les CDO du Ministère de l’Environnement et de la Gestion des urgences, du Ministère du Commerce et de l’Industrie, du Ministère de la Justice et du Ministère des Affaires étrangères, un représentant de RISA et un représentant du Ministère des Technologies de l’Information et de Communication et de l’Innovation.

Nous remercions chaleureusement les intervenants qui ont fait de cette semaine une réussite :

Direction interministérielle du numérique
Philippe Vrignaud, directeur du département relation agents – usagers, fondateur de Démarches Simplifiées

Service d’information du gouvernement
Michaël Nathan, Directeur
Missak Kéloglanian, Chief Digital Officer, Conseiller Sécurité Numérique et Chef du Département Ecosystème numérique
Jean Delpech, Adjoint en charge du numérique
Maxime Beaugrand, Responsable de projet

Ministère de l’Europe et des Affaires étrangères
Henri Verdier, Ambassadeur pour les affaires numériques

Ministère de l’Economie, des Finances et de la Souveraineté industrielle et numérique
Bénédicte Roullier, cheffe du pôle transformation numérique des TPE/PME, Responsable de l’initiative France Num, Direction générale des entreprises

Ministère de la Justice
Xavier Albouy, directeur du numérique

Agence nationale de la cohésion des territoires
Alexis Boudard, directeur de l’Incubateur des Territoires
Léa Gislais, Directrice adjointe du Programme Société numérique
Vincent Viers, développeur de Données et Territoires

PIX
Benjamin Marteau, directeur
Marie Bancal, directrice des partenariats, du développement et du juridique
Elsa Dufayard, Responsable des secteurs organismes de formation et international
Angélina Magne, chargée de partenariats et de développement international

Remerciements :
Pierre-Louis Rolle, ancien conseiller du ministre chargé du Numérique, ancien directeur stratégie et innovation à l’Agence nationale de la cohésion des territoires
Romain Talès, Digital Transformation Specialist à Numéricité, ancien chef du département data au sein d’Etalab

À Numéricité, nous sommes fiers de porter la vision du numérique public à la française, cette Digital French Touch, dont les valeurs résident dans l’usage d’un numérique ouvert et responsable, vecteur de transparence et d’efficacité pour l’action publique. Au fil de nos missions à l’international et des visites d’études que nous organisons, nous attachons une importance particulière à relayer ces valeurs, pratiques, méthodes et communs.

L’expédition apprenante à destination de la délégation rwandaise a été conçue pour créer des synergies entre les principes clefs de la Digital French Touch et les priorités du Rwanda.

En France, l’ouverture – ou l’open – est à la fois un mode d’action et un objectif dans la transformation numérique de l’action publique. Améliorer l’accès à l’information sur les démarches administratives, via la création du portail service-public.fr en 2000, rendre disponibles les données collectées et produites par l’administration, via la création de la plateforme interministérielle data.gouv.fr en 2011, ou encore ouvrir l’administration à des talents numériques issus de extérieurs, via la mise en place du programme Entrepreneurs d’intérêt général en 2017. Ces quelques initiatives illustrent l’approche choisie par l’administration française : en “faisant plateforme” avec l’extérieur, en permettant la réutilisation de ressources, le numérique contribue à l’amélioration de la qualité et l’efficacité de l’action publique.


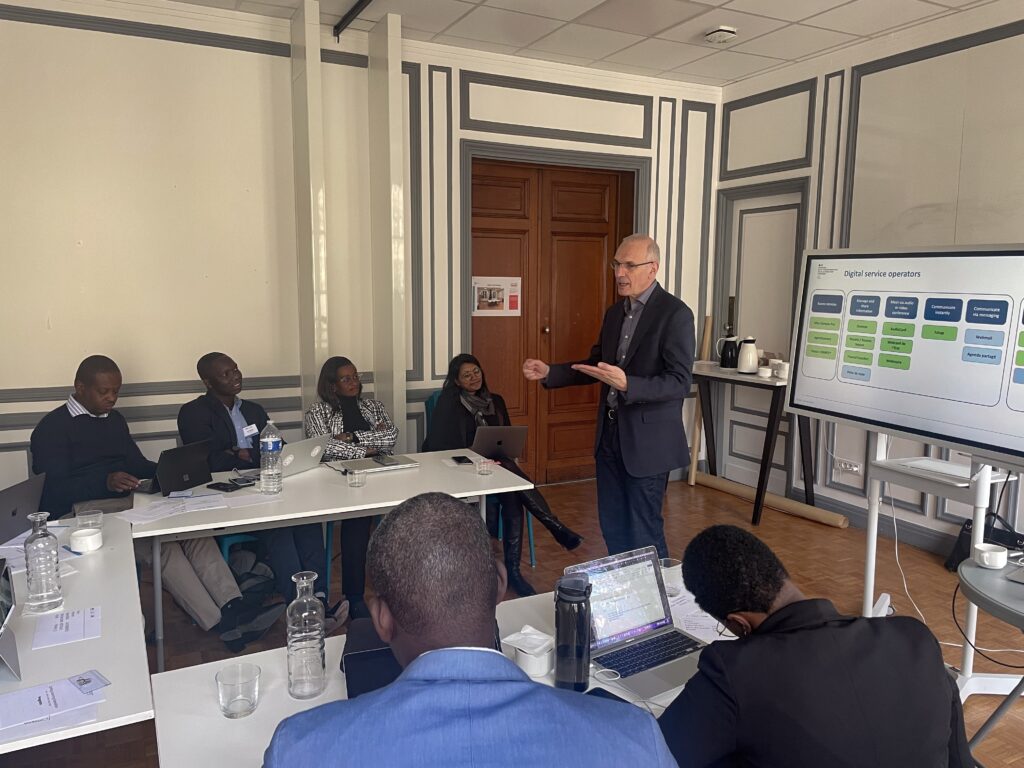
Intervention de Philippe Vrignaud devant la délégation rwandaise - Mars 2024

Sur la donnée, cette approche a été accélérée par l’adoption de la loi pour une République numérique en 2016 : principe d’open data data by design, réutilisation gratuite des données publiques, facilitation de la circulation de la donnée entre administrations, principe du “dites-le-nous une fois”, évitant ainsi aux usagers la complétion de données déjà détenues par l’administration, ouverture des logiciels développés (ou financés) par l’administration, transparence des algorithmes. L’ouverture et la circulation des données réduisent la charge administrative pour les citoyens, renforcent la collaboration entre institutions, contribuent à la proactivité de l’administration auprès des usagers.

Sur les codes sources, le développement de briques logicielles communes pour la transformation connaît aujourd’hui une nouvelle impulsion. Au sein de la Direction interministérielle du numérique (DINUM), le pôle opérateur coordonne la mise en place d’une suite numérique consolidée – depuis démarches-simplifées à FranceConnect, en passant par des outils de messagerie, d’agenda, de partage de documents – qui s’attachent mettre l’open source au cœur. Cette approche de mutualisation est particulièrement prometteuse. Lire les dernières actualités sur la suite numérique collaborative.

Enseignements de l’expédition apprenante avec le Rwanda – L’open
Plusieurs bonnes pratiques ont été relevées par la délégation :

  • L’importance de la qualité des données et leur mise à disposition en vue de leur réutilisation par d’autres administrations ou des personnes externes
  • L’ouverture et la circulation des données brutes produites par des acteurs publics complémentaires à l’approche de production statistique
  • La nécessité d’installer une gouvernance interministérielle pour développer une politique de la donnée 360 (open data, API, IA) au service de l’amélioration de l’action publique
  • La mutualisation de briques logicielles selon le mode “volontaire” : par exemple, un ministère peut choisir d’instancier un logiciel commun à toutes les administrations tout comme ne pas utiliser une autre solution de la suite, tant que l’information existe sur ce qui est mis à disposition ! 

En 2014, la France est le premier pays à créer par décret une fonction d’administrateur général des données (AGD), traditionnellement incarnée par le Directeur interministériel du numérique (DINUM).

  • L’AGD doit assurer l’accélération de l’ouverture, de la circulation et de l’exploitation des données publiques au profit des politiques publiques. Cette fonction est venu compléter l’action et le réseau d’Etalab pour mettre en œuvre la transformation des politiques publiques de la donnée.
  • En 2021, l’équivalent ministériel de l’AGD est créé, via une circulaire définissant les missions des administrateurs ministériels des données, des algorithmes et des codes sources (AMDAC). Les AMDAC (qui peuvent être les directeurs du numérique dans les ministères, mais pas toujours), ont pour fonction la mise en œuvre et le suivi des stratégies ministérielles pour l’ouverture des données, algorithmes et codes sources. Ils coconstruisent et mettent en œuvre leur feuille de route ministérielle en ce sens, toutes disponibles en accès libre sur numerique.gouv.fr.
  • Une comitologie est mise en place : le Ministre de la Transformation et de la Fonction publiques assure le suivi stratégique, et chaque mois, les AMDAC se réunissent avec l’AGD. Des projets conjoints peuvent être menés en parallèle.

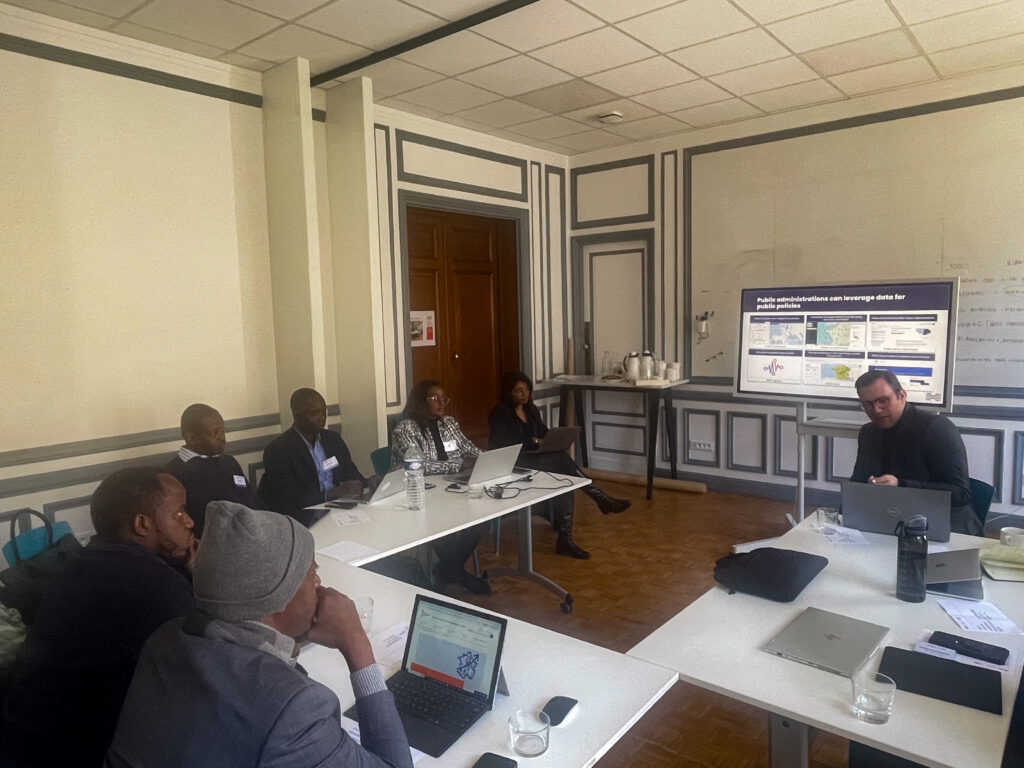
Intervention de Romain Talès devant la délégation rwandaise - Mars 2024

La gouvernance du réseau des AMDAC est une approche parmi d’autres de modes de pilotage de la transformation numérique. Il est important de pouvoir ajuster les mécanismes de gouvernance en fonction des acteurs concernés et des décisions à prendre. Un spectre large de dispositifs de gouvernance existent en France. Parmi les initiatives présentées lors de l’expédition apprenante :

  • L’approche partenariale public-privé-communs, consistant à mettre ouvrir les codes sources des logiciels développés sur des financements publics, à créer une communauté d’utilisateurs et de développeurs et à réemployer au maximum l’existant. Par exemple, le gouvernement, comme de nombreux incubateurs ministériels, est présent sur GitHub : https://github.com/GouvernementFR. Dans cette dynamique de numérique d’intérêt général, il existe également l’Accélérateur d’initiatives citoyennes (AIC), lancé en 2021 par la DINUM afin de renforcer les coopérations entre l’Etat et les initiatives citoyennes porteuses de communs numérique.

Enseignements de l’expédition apprenante avec le Rwanda – La gouvernance
Plusieurs bonnes pratiques ont été relevées par la délégation :

  • L’avantage de bénéficier d’une organisation interministérielle pour collaborer avec les CDO sectoriels et placer la transformation numérique à un niveau de décision élevé au sein du gouvernement
  • L’open-source et les communs numériques pour
    • Développer des infrastructures de services numériques offre plusieurs avantages, tels que l’efficacité des investissements, la garantie de la souveraineté numérique et l’attraction de talents
    • Favoriser l’innovation ouverte et collaborative, essentielle pour l’adaptation rapide aux nouvelles technologies et aux besoins évolutifs des citoyens
    • Animer des communautés de pratiques, essentielles pour le partage de connaissances et de meilleures pratiques, la résolution de problèmes communs et le soutien mutuel dans les initiatives de transformation numérique

De nombreux chantiers liées aux politiques d’inclusion numérique ont été lancées depuis plus de 10 ans. Aujourd’hui, la Stratégie nationale pour un numérique inclusif est structurante pour les acteurs publics.

La délégation a découvert les initiatives phares, qui couvrent l’ensemble des champs de l’inclusion (de la connectivité aux usages) : le Plan France Très Haut Débit, le programme France Mobile, les programmes de médiation numérique, l’accompagnement des collectivités territoriales, par exemple avec la création des conseillers numériques. La progression de l’inclusion numérique est suivie par une nouvelle métrique développée par l’ANCT : la distance numérique. Celle-ci englobe l’accès aux équipements, la diversité des usages, les compétences formelles, la facilité.

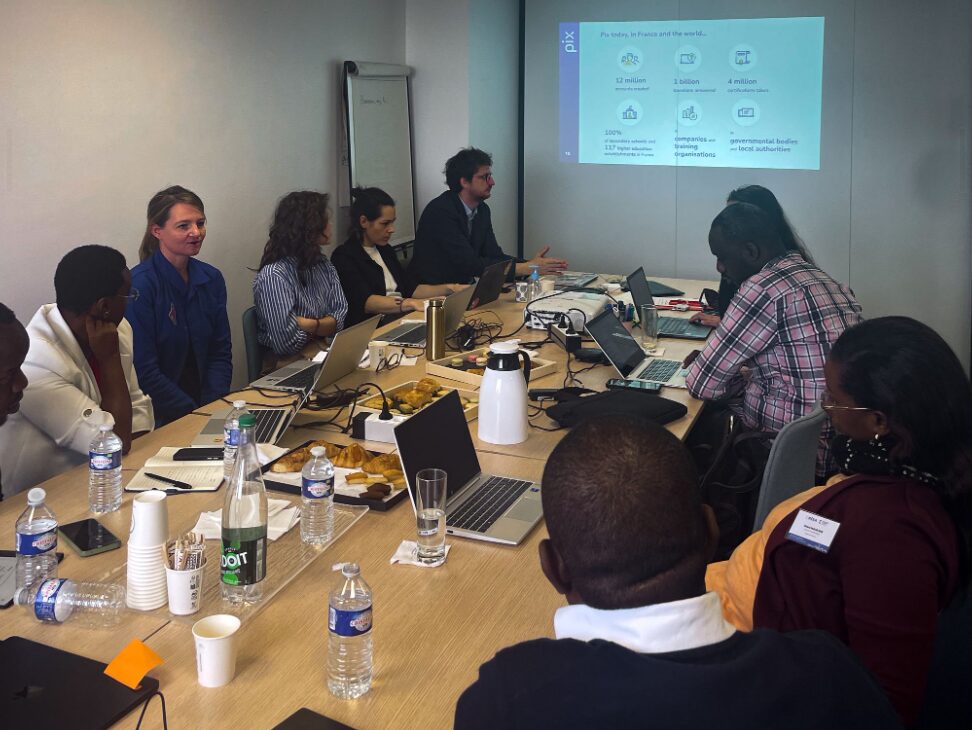
Les équipes de l’ANCT et de PIX devant la délégation rwandaise - mars 2024
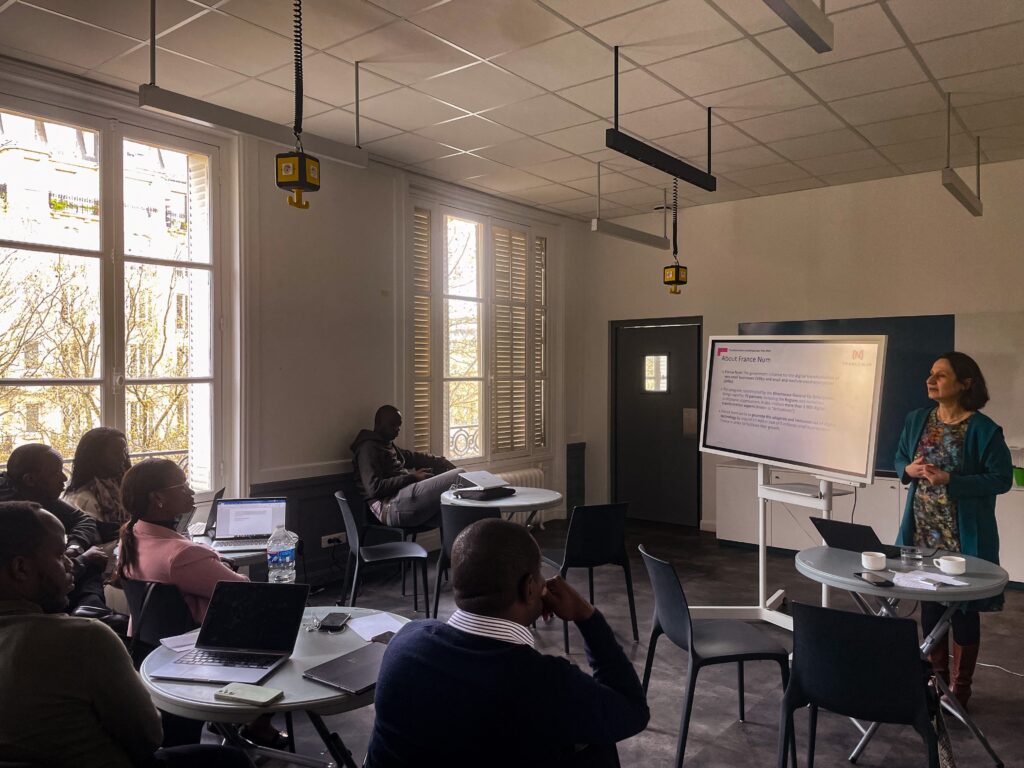
Intervention de Bénédicte Roullier devant la délégation rwandaise - mars 2024

Pour ce qui est de la formation, l’équipe de Pix a présenté l’histoire du service, le modèle de mise en œuvre et les caractéristiques clés. Pix est une startup d’État devenue un service autonome, avec un modèle de financement hybride. L’équipe s’appuie sur le cadre européen des compétences numériques pour construire des modules pédagogiques, dispensés de l’école primaire à l’université. A l’occasion de la présentation de Pix, la délégation a partagé leurs préoccupations sur la façon de s’attaquer à l’alphabétisation numérique pour les populations ayant des problèmes d’alphabétisation ou des questions de diversité linguistique.

La méthode startup d’Etat a été explorée par la délégation à travers la présentation de deux initiatives portées par l’Agence nationale de la cohésion des territoires (ANCT) : Aidants Connect et Données et Territoires. Cette méthode permet d’apporter une réponse à un problème de politique publique par le développement d’un service numérique à impact, conçu à partir des besoins exprimés par les utilisateurs (citoyens ou agents publics).

Aidants Connect est un service basé sur les principes d’authentification de FranceConnect permettant aux aidants de soutenir les utilisateurs dans la réalisation de leurs démarches administratives.

Données et Territoires est un service proposé par l’ANCT à destination des agents, des services et des collectivités territoriales afin de les accompagner dans toutes les étapes de la création à l’utilisation des données.

Ces deux exemples de produits, centrés sur l’exploitation de la donnée au service des besoins des utilisateurs, montrent combien les bases de données standardisées et ouvertes permettent d’opérer des politiques publiques ou d’outiller les agents, gages de confiance et d’efficacité.

Enseignements de l’expédition apprenante avec le Rwanda – La méthode produit des start-up d’État
Plusieurs bonnes pratiques ont été relevées par la délégation :

  • L’importance de maintenir un lien constant avec les utilisateurs finaux lors du développement de services numériques
  • La nécessité de faciliter l’expérience utilisateur en proposant un univers graphique cohérent
  • L’utilité du modèle start-up d’État pour dynamiser des projets numériques au service des politiques publiques

Afin de proposer aux usagers des interfaces numériques standardisées et un univers de marque État uniformisé, la France s’est doté d’un système de design : le DSFR (Système de Design de l’Etat).

  • Elaboré par le Service d’information du gouvernement (SIG), le DSFR permet d’assurer la cohérence des produits numériques publics avec la stratégie de marque de l’État. Des composants sont mis à disposition des designers et développeurs de services (blocs fonctionnels, typographies, modèles, références colorimétriques, boutons, fil d’Ariane, etc.). Ils sont prêts à l’emploi, accessibles et standardisés. Le DSFR est ouvert, une documentation est mise à disposition, et les utilisateurs peuvent émettre des besoins en évolution ou ajouts de composants.
  • La force du DSFR réside dans son adaptabilité, en ce qu’il est « agnostique » en termes de langages web et de programmation. Il vient outiller les équipes de services numériques pour mieux construire leurs produits et mettre en œuvre les normes d’éco-conception et d’accessibilité.

Les membres de la délégation en compagnie de Michaël Nathan et Missak Kéloglanian - mars 2024

La transformation numérique n’est pas synonyme de la mise en œuvre des nouvelles technologies. Comme le précise la Fing suite à la création du groupe de travail Nos Systèmes, il est essentiel d’opéter une rétroingénierie des solutions techniques émergentes avant de les déployer. Ils préconisent d’ailleurs d’opter pour une rétroingénierie sociale, méthode permettant de comprendre et d’améliorer les systèmes techniques en interagissant avec eux : l’idée est de rendre les systèmes techniques socialement responsables et transparents sans nécessairement dévoiler tous leurs secrets.

Enseignements de l’expédition apprenante avec le Rwanda – Ne pas tomber dans le techno-solutionnisme

Xavier Albouy, Directeur du numérique au Ministère de la Justice, a insisté sur un point : lorsqu’une innovation est présentée comme un virage incontournable à prendre, le rôle d’un directeur du numérique est de remettre l’usage, la valeur, au centre, et de considérer la technologie comme un moyen et non une fin.

Intervention de Xavier Albouy devant la délégation rwandaise - mars 2024

Pour autant, la recherche de l’état de l’art dans l’usage d’innovations technologiques majeures est importante. Par exemple, la France expérimente et met en œuvre diverses initiatives liées à l’intelligence artificielle :

  • “Pour une intelligence artificielle française” (PIAF), portée dès 2018 par le Lab’IA d’Etalab et visant à construire le premier jeu de données ouvert de questions-réponses francophone ;
  • Albert, nouvel outil d’IA générative lancé en 2023 à destination des agents de l’administration et porté par le Datalab d’Etalab ;

Dans le sillon de l’approche public-privé-communs, l’État a également lancé en juillet 2023 une communauté : AllIAnce. Sous l’égide de la DINUM, AllIAnce rassemble des ministères, des administrations publiques, des opérateurs de services publics, des start-up et entreprises privées, des organismes de recherche et des établissements d’enseignement supérieur. L’objectif : répondre à des problématiques concrètes rencontrées par les administrations sur le terrain en réunissant toutes les expertises permettant à l’État de s’approprier tout le potentiel des technologies d’IA.

Cette communauté assure la gouvernance en expérimentant régulièrement des solutions avant de les passer à l’échelle. A l’instar des DNUM ministériels, la communauté joue le rôle d’éclaireur et permet à la France de se positionner techniquement, juridiquement et éthiquement sur les innovations technologiques et de créer des produits souverains et libres. In fine, cela revient interroger la technique pour en dévoiler le potentiel en vue de répondre aux besoins des agents et des administrés.

À la fin de la semaine d’expédition apprenante, trois mots-clés ont marqué les discussions entre les membres de la délégation rwandaise : open-source, souveraineté et user-centric. En privilégiant le dialogue entre praticiens et en intégrant les meilleures pratiques de la Digital French Touch, cette expédition a offert une vision complète et pragmatique des opportunités et des défis de la transformation numérique.

Les différents enseignements ont mis en lumière l’importance d’une approche ouverte et collaborative, de la transparence des systèmes techniques, et d’une gouvernance adaptée et placée à un haut niveau stratégique. Ces éléments ont permis aux membres de la délégation rwandaise de redéfinir leur perspective sur les différents aspects du projet FEXTE.

L’expédition apprenante a ainsi apporté des orientations supplémentaires pour formuler des besoins et idées pour la suite du programme. L’échange avec Henri Verdier, Ambassadeur pour les affaires numériques a été très enthousiasmant pour les CDOs, qui ont perçu qu’il était possible – et souhaitable – d’associer des principes de transformation numérique et des projets concrets à impact.

Les membres de la délégation en compagnie de Henri Verdier, Ambassadeur français pour les affaires numériques - mars 2024

À l’instar de cette expédition apprenante, accompagner à la transformation numérique, c’est aussi garantir la montée en compétences et l’autonomisation des équipes.

Partant de cette conviction, nous avons fait le choix de concevoir une diversité de formats et modules de formation que nous pouvons proposer clé en main ou intégrer dans des missions spécifiques.

Découvrez notre offre sur la page dédiée aux formations

This Week in Matrix 2024-06-07

Par : MTRNord
7 juin 2024 à 21:00

Matrix Live S09E30 — The Account Migrator

The Foundation is hard at work to let you move your Matrix account around. Tadzik walks us through a pragmatic solution to several problems we have.

Today's Matrix Live: https://youtube.com/watch?v=fuOfN4q5mmE

Foundation

Policy and Regulations blog series

Denise [away] says

we're starting a policy and regulation blog series over on the Foundation's blog. Over the next few months I'll be covering various pieces of legislation that are already in place, as well as incoming regulation, and what it all means for Matrix.

https://matrix.org/blog/2024/06/regulatory-update/

Dept of elections 🗳️

Josh Simmons (he/they) says

The votes have been counted! Introducing the first elected Governing Board of the Matrix.org Foundation 🎉

Thanks to everyone who ran and everyone who voted, and congratulations to those who have been elected!

This is a huge milestone for Matrix, and now we can tackle the challenges we face with greater community involvement: https://matrix.org/blog/2024/06/election-results/

Dept of Clients 📱

Kazv (website)

nannanko announces

kazv v0.3.0 has been released.

Added

Fixed

Internal changes

FluffyChat (website)

Krille-chan reports

🥳 FluffyChat v1.21.0 has been released 🥳

The new FluffyChat has several performance improvements, including a fix which should speed up the whole app if you have a lot of megolm sessions.

Also FluffyChat v1.21.0 includes a new search and gallery feature for chats. You can now search for specific messages or browse the shared photos in a conversation.

Also please note that the default network request timeout has been changed. Before FluffyChat ran into a timeout if the server needed more than 30 seconds to send the initial sync. This was probably too optimistic so the timeout has now been set to 30 minutes. This should allow much more users with very large accounts to log in. Feel free to share your feedback.

All Changes

  • feat: Enable download images on iOS, not only share images (krille-chan)
  • feat: Search feature (krille-chan)
  • build: Update record package (krille-chan)
  • build: Use correct pubspec.yaml format for hosted dependency (krille-chan)
  • build: Use matrix sdk main branch (krille-chan)
  • chore: Change default timeout to 30 min (krille-chan)
  • chore: Go back to pub.dev matrix sdk (Krille)
  • chore: Hotfix create missing objectbox (Krille)
  • chore: Increase default network request timeout (Krille)
  • chore: Make bottomnavbar labels always visible (krille-chan)
  • chore: Nicer message animation (krille-chan)
  • chore: Only load last event sender if necessary (Krille)
  • chore: Set a maxsize for textfields (Krille)
  • chore: upgrade flutter to 3.22.0 (lauren n. liberda)
  • chore: upgrade flutter to 3.22.1 (lauren n. liberda)
  • ci: run flutter gen-l10n on code_tests (lauren n. liberda)
  • design: Improve design of Voice Messages and add 1.25 as speed (Krille)
  • fastlane: i18n ru (Yurt Page)
  • fastlane: improve full_description.txt (Yurt Page)
  • fix: Broken localization with empty strings in it (krille-chan)
  • fix: FakeMatrixApi check (krille-chan)
  • fix: mxc reactions not rendered correctly (krille-chan)
  • fix: Stickers from gboard have black background (Krille)
  • fix: voip code breaking from 0.28 (td)
  • refactor: Delete database file on failed app start (krille-chan)
  • refactor: Display better command hints (Krille)
  • refactor: Improve performance of chat list (krille-chan)
  • refactor: Precache theme and directchatmatrixid to improve performance in chat list item (krille-chan)
  • refactor: Update to Matrix Dart SDK 0.29.9 (Krille)
  • Translated using Weblate (Croatian) (Milo Ivir)
  • Translated using Weblate (Czech) (Jozef Mlich)
  • Translated using Weblate (Georgian) (Nicholas Winterhalter)
  • Translated using Weblate (German) (Gian Klug)
  • Translated using Weblate (Korean) (kdh8219)
  • Translated using Weblate (Latvian) (Edgars Andersons)
  • Translated using Weblate (Norwegian Bokmål) (sunniva)
  • Translated using Weblate (Turkish) (Oğuz Ersen)

Element X iOS (website)

A total rewrite of Element-iOS using the Matrix Rust SDK underneath and targeting devices running iOS 16+.

Mauro Romito announces

  • QR Code login works is completed we are just waiting for matrix server to fully support native OIDC login, before rolling out the feature
  • Message queue work is also almost completed, now messages will be automatically queued for resending when internet connection comes back, without the need of taking any manual action
  • We are also working on storing and restoring composer drafts for each room, so no need to worry about losing anything that has not been sent yet if you browse another room or close your app
  • Great news also for element call integration, we are implementing native call notifications (with ringing), and a call log for DMs. Also starting a call will also be displayed as an event in the timeline.

Element X Android (website)

Android Matrix messenger application using the Matrix Rust SDK and Jetpack Compose.

ganfra reports

  • Release 0.4.14 is available here https://github.com/element-hq/element-x-android/releases/tag/v0.4.14. Will be on the store soon.
  • We have added a quick implementation of sharing, so you can now send text and media from other applications.
  • QR Code login works is completed we are just waiting for matrix server to fully support native OIDC login, before rolling out the feature
  • Message queue work has been started, messages will be automatically queued for resending when internet connection comes back, without the need of taking any manual action.
  • Great news also for element call integration, we are implementing native call notifications (with ringing). Also starting a call will also be displayed as an event in the timeline.

Dept of Encryption 🔐

Complement Crypto (website)

Kegan reports

Way back in December I TWIM'd I was working on a new project called complement-crypto which aims to write an extenstive, exhaustive set of end-to-end E2EE tests for Matrix clients. The aim of this work is to ensure encryption in Matrix Rust SDK in particular is robust to all kinds of failure modes: from connectivity blips over federation, server restarts and corrupted data, to actively malicious homeservers. Work has progressed significantly in the intervening 6 months:

  • The test suite runs in both Rust SDK and JS SDK CI pipelines to detect regressions. This required a lot of work enabling conditional compilation (so you don't need to run JS code in rust SDK) and improving test reliability to a sufficient standard that it can be relied upon.
  • It now has full federation support, spinning up sliding sync proxies for both homeservers if needed.
  • It has a comprehensive RPC client process to test ungraceful shutdowns (e.g what happens if your client gets SIGKILL'd?)
  • When things do go wrong, you have powerful debugging tools thanks to using mitmproxy for all communications, in addition to client log files and container logs. The use of mitmproxy is not only useful for debugging, but is also used as a test synchronisation primitive to reduce flakiness (e.g do X when you see the HTTP response to Y), as an assertion tool (e.g ensure the client has uploaded one-time keys by looking for the request), and as an adversarial tool (e.g modify the response returned to the client).

The overall architecture looks like:

     Host        |       dockerd           
                 |                          +-----------+      
                 |                     .--> | ss proxy1 | <------.
 +----------+    |    +-----------+    |    +-----+-----+        V
 | Go tests | <--|--> | mitmproxy | <--+--> | hs1 |          +----------+
 +----------+    |    +-----------+    |    +-----+          | postgres |
                 |                     +--> | hs2 |          +----------+
                 |                     |    +-----+-----+        ^
                 |                     `--> | ss proxy2 | <------`
                 |                          +-----------+      
Debugging a test run in `mitmweb`

Debugging a test run in mitmweb

In terms of the impact this project has had:

There's still more work to be done, including:

  • finishing off the test hitlist,
  • supporting device verification tests,
  • adding adversarial tests (e.g malicious homeserver tests),
  • adding targets beyond rust/JS SDK (matrix-bot-sdk, mautrix, and others). A perfect client can still receive UTDs if the sending client didn't encrypt correctly, and the sender may be on a different codebase.

This has been just one part of our work reducing UTD errors. Another significant part has been aggressively analysing bug reports in the wild to identify common failure modes. To that end, please report any 'unable to decrypt' messages you see and include log files with your report. Please also try to get the sender to submit a bug report. I may reach out to you if I need additional information. These bug reports not only guide our priorities, but have also helped us identify obscure failure modes which we cannot reproduce via complement-crypto.

Dept of SDKs and Frameworks 🧰

Rory&::LibMatrix (.NET 8 matrix bot/client library/SDK)

Emma [it/its] announces

Some minor changes, this week's update will be mostly project/management updates!

Call for help! (Update)

It's been decided to split the event rewrite up into multiple phases/parts. The original vision of the changes turned out to be far too optimistic, and we've run into some language-related challenges trying to implement them. We'll still try to implement those changes, but this might depend on compile-time source generation or similar endeavours.

If this sounds like a fun challenge to you, or want to discuss and shape the semantics of these changes, feel free to join in!

Changes (Projects & Policies)

Some policy changes, and some new projects have been started within the LibMatrix source tree:

  • New workflow: Use of feature branches

Keeping up to date with LibMatrix is hard, because the chance of updating to a partially finished commit is too high. To address this, we're moving to a "main branch is stable" model, with partial implementations on deciated branches so developers can keep up and prepare for those changes.

  • New subproject: Writing of full documentation

We want to improve the developer experience by offering documentation of features right in your editor, without having to reference the backing source. This should enable users who are less familiar with Matrix' internal structures to still be able to implement their deepest wishes.

  • New subproject: Workspace and structural cleanup

The LibMatrix source tree became a mess as the project grew. We want to restructure it to be maintainable, and also far more friendly to those who might want to contribute. If this sounds like something you'd like to help with or would love to offer feedback on, please do feel free to reach out at #libmatrix:rory.gay!

  • Splitting up of subproject: Event handling rewrite

Due to the large amount of complexity and work, we've decided to first start rewriting the inner implementations of events. This should massively improve the end user experience, as custom event content is no longer lost if edited, as well as no longer having to worry about desyncs between actual event content and what you might see in an editor! Next to this, you will likely see performance improvements when dealing with accessing the contents of events! Longer-term changes still include static typing of event collections, especially around single content type collections such as fetching a room's member list, which should also see a large performance uplift when fetching!

Changes (Main release)

  • All dependencies have been updated. End users should not notice any differences as this is a maintenance task, but this does potentially enable some new usecases and squashes some bugs and security risks originating from outdated dependencies.

And, as always:

  • The code is available at cgit.rory.gay!
    • All contributions are more than welcome, be it documentation, code, anything! Perhaps, example usecases, bots, ...?
  • Discussion, suggestions and ideas are welcome in #libmatrix:rory.gay (Space: #mru-space:rory.gay)
  • Got a cool project that you're working on and want to share, using LibMatrix? Be sure to let us know, we'd love to hear all about it!

Libkazv (website)

nannanko announces

libkazv v0.5.0 has been released.

Added

Internal changes

Dept of Built on Matrix 🏗️

Acter

ben announces

It's been a while since our last blog post of updates in Acter and, oh boy, a lot has happened. Just to scratch the surface here, we have:

  • Totally redesigned the Invite flows, including easier "all from spaces" and using super invites to allow external invitations
  • Upgraded the registration wizard to include a default registration token and recommendation to link an email address for better recovery options
  • A new flow for observing and managing the join rules of spaces and chats
  • we took a fresh look at the chat and cleaned up the design, including some nice new messages at the start of the chat
  • you can not only bookmark chats, but also spaces now, to keep things more organized
  • we added a few more labs: chat read markers & end-to-end-encryption-backup
  • and we are seeing the finishing line for the task lists features to leave the labs section

More details and video screens on today's blog post.

We have also expanded our team, in particular on the community growth side, and are about to open another position for a product designer ... if that's you or someone you know, stay tuned!

Matrix in the News 📰

Comments on Canonical JSON in Matrix

Matthew reports

Neilalexander has written an interesting analysis of Canonical JSON and how to improve it at https://neilalexander.dev/2024/06/05/canonical-json

Matrix Federation Stats

Slavi says

collected by MatrixRooms.info - an MRS instance by etke.cc

As of today, 9397 Matrix federateable servers have been discovered by matrixrooms.info, 2860 (30.4%) of them are publishing their rooms directory over federation. The published directories contain 160776 rooms.

Stats timeline is available on MatrixRooms.info/stats

How to add your server | How to remove your server

Dept of Ping 🏓

Here we reveal, rank, and applaud the homeservers with the lowest ping, as measured by pingbot, a maubot that you can host on your own server.

#ping:maunium.net

Join #ping:maunium.net to experience the fun live, and to find out how to add YOUR server to the game.

RankHostnameMedian MS
1doctoruwu.uk207.5
24d2.org208
3awawawawawawawawawawawawawawawawawawawawawawawawawawawawawawaw.gay215
4girlboss.ceo222.5
5uwu.sulian.eu258.5
6nerdhouse.io271
7aguiarvieira.pt289
8maunium.net307.5
9matrix.jayryn.de343
10productionservers.net354

#ping-no-synapse:maunium.net

Join #ping-no-synapse:maunium.net to experience the fun live, and to find out how to add YOUR server to the game.

RankHostnameMedian MS
1conduwuit.daedric.net78
2doctoruwu.uk88
3matrix.jayryn.de91
4girlboss.ceo111
5awawawawawawawawawawawawawawawawawawawawawawawawawawawawawawaw.gay119
6nerdhouse.io140
7craftingcomrades.net170
8matrix.its-tps.fr190.5
9aguiarvieira.pt218
10spritsail.io219

That's all I know

See you next week, and be sure to stop by #twim:matrix.org with your updates!

To learn more about how to prepare an entry for TWIM check out the TWIM guide.

Policy and regulation update 2024: Matrix and the GDPR

6 juin 2024 à 09:00

If you have been following the matrix.org blog for some time, you will know that we’ve never been ones to shy away from complex topics like public policy and its impacts on Matrix. With this blog post series, our aim is to introduce a more regular cadence to our regulatory updates and to be more transparent about where we are focusing our efforts in this area.

Each blog post in the series will focus on a given theme or piece of law, as well as its relevant jurisdiction. We will start this series by taking a deep dive into EU regulation, starting with the General Data Protection Regulation (GDPR). Future blog posts in the series will cover the digital services package (DMA and DSA), the incoming CRA and the highly controversial CSAM regulation. These will be followed by a series dedicated to the UK, particularly UK applications of European law such as the GDPR and ePrivacy directive, as well as the Online Safety Act and the IPA amendment bill. Finally, we will conclude the series by looking across the pond and diving into the Cloud Act, as well as KOSA and other existing proposals.

The big one

Over the last decade the most impactful - in terms of grassroots led change, not necessarily enforcement - piece of legislation was probably the GDPR. Although its initial enforcement date (May 2018) was a couple of years before I joined Element and the Matrix.org Foundation, I know that preparing for GDPR was a huge effort that led to a lot of deep thinking about the ins and outs of Matrix.

These have been certainly years of learning, iterating and evolving our approach to this fascinating piece of law, and just like 6 years ago, we keep receiving questions and feedback about how the GDPR applies to the Matrix protocol and how server administrators can remain compliant.

We maintain the view that the GDPR was not built for a decentralised digital world, after all we are (for now!) the exception, not the rule. This does not mean, however, that we don’t make every effort possible to comply with the spirit and the letter of the law. Most organisations using the Matrix protocol will be running strictly closed federations or single servers in closed federation, which they fully control (or appoint others to support them with that control). Compliance is a lot more straightforward in this sense, so for now we will focus on those using Matrix to interact with open federation.

The most difficult part of GDPR compliance for Matrix has always been article 17, right to erasure, or ‘right to be forgotten’ as it is usually known. Our view has always been that this is a relative right, which needs to take into account available technology and other applicable laws in order to be enacted. For example, if an employee leaves a company and asks for all of their data to be erased, in practice not all of that data will actually be erased, due to constraints put in place by other legal instruments (i.e. tax and fraud prevention regulations, employment law, etc.).

Considering this relativity, we looked at what other ubiquitous product offerings already exist in the decentralised space, and how they address erasure. Using email as an analogy was a no-brainer in this regard: one understands that deleting an email account will delete everything from their inbox and sent folders, whilst also understanding that is impossible and not expectable to have the same data deleted from the recipients’ inbox (or the inboxes of those that might have had the same message forwarded to them).

Use of technology is always associated with constant give and take and risk based decisions. Whilst we make every effort to minimise risks for the people using the Matrix protocol, the reality is that one of the main purposes of the protocol is integrity of communications and decentralisation of communications data. This is directly at odds with absolute deletion of communications.

So how do we come to terms with this conflict? Following the email analogy, we address right to erasure from two different standpoints: account data and communications data. As part of the protocol, everyone is able to automatically delete their accounts and select an option to delete all of their data. First, this deletes all ‘external’ data associated with the account, such as e-mail addresses, phone numbers, IP addresses and device identifiers - effectively pseudonymising this data, aside from Matrix IDs which we will address later on. This measure follows recital 28 of the GDPR, which mentions pseudonymisation as a risk reducing measure for data subjects, which helps controllers and processors meet their data protection obligations.

Now, the thornier issue of communications data. How can we apply erasure whilst maintaining the integrity of the service for remaining users? Keeping on with the email analogy, if someone deletes their sent email from their own account, you would still expect an existing thread with multiple users to work and be visible. You just would not expect the same message to leave the original account to new individuals.

That is precisely how the issue is addressed in Matrix - upon deletion of an account, and request for deletion of messages, a flag is applied to the original messages which prevents it from ever being displayed to any new people. This, of course, requires cooperation from the other server administrators who might also have copies of the same message in their server instance. We make this decision by referring to recital 66 of the GDPR, which requires controllers take reasonable steps, taking into account available technology, to inform other controllers of the data subject’s request to have their data erased.

One issue still remains unresolved - Matrix IDs (MXIDs) are always associated with state events (data sent by a user to modify the attributes of a given room - eg its name, its members, its avatar), which means those IDs could still leak over federation. That is a particular concern when one uses their legal name as their MXID. The solution for this is to replace the MXID with a pseudonym, maintaining the integrity of communications and fully removing any last remains of identifiable information in the system.

The Synapse team has also made a lot of progress on message retention policies and media retention, both huge strides to continuously improve the privacy of Matrix users, whilst also helping server administrators comply with their legal obligations.

Things have definitely progressed in the portability space, and chat export is now implemented in multiple Matrix clients, having been first implemented on Element Web in October 2021, in version 1.9.2. We look forward to seeing what the next year brings us in terms of privacy improvements.

For the next post in this series we will continue discussing the EU policy landscape, although from a different perspective. We will be going through the digital services package (which includes the DSA and DMA) and what does it all mean for Matrix now that we have reached implementation stage.

As always, we remain open to your feedback and thoughts. If there is anything you would like to hear more about or have a suggestion for a future blog in this series please feel free to reach out to dpo@matrix.org via email, DM to @gpdr:matrix.org or chat to us in the Office of the Matrix.org Foundation room.

The Personal AI Greenfield

Par : Doc Searls
11 juin 2024 à 15:52

What forms of pAI—personal AI—are Apple, Mozilla, Google, Meta, Microsoft and the rest not doing?

Let’s look at those first two because they’re at the top of the news LIFO buffer.

Apple Intelligence (“coming in beta this fall*“), announced yesterday, will help you with writing and creating images while giving you less lame answers from Siri. (Which they should re-name. Siri is Apple’s Clippy.) It “can draw on larger server-based models, running on Apple silicon, to handle more complex requests for you while protecting your privacy.” The “larger models” will be white-labeled ChatGPT, plus Apple’s own small language models (SLMs).

Mozilla, which got $400+ million a year from Google (for search in the Firefox browser) starting in 2020, announce on June 3 that they will be Building open, private AI with the Mozilla Builders Accelerator. Jive:

This program is designed to empower independent AI and machine learning engineers with the resources and support they need to thrive. It aims to cultivate a more innovative AI ecosystem, and it’s one of Mozilla’s key initiatives to make AI meaningfully impactful — alongside efforts like Mozilla.ai, the Responsible AI Challenge and the Rise25 Awards.

The Mozilla Builders Accelerator’s inaugural theme is local AI, which involves running AI models and applications directly on personal devices like laptops, smartphones, or edge devices rather than depending on cloud-based services…

We chose Local AI as the theme for the Accelerator’s first cohort because it aligns with our core values of privacy, user empowerment, and open source innovation. This method offers several benefits including:

  • Privacy: Data stays on the local device, minimizing exposure to potential breaches and misuse.
  • Agency: Users have greater control over their AI tools and data.
  • Cost-effectiveness: Reduces reliance on expensive cloud infrastructure, lowering costs for developers and users.
  • Reliability: Local processing ensures continuous operation even without internet connectivity.

Looks to me like both of these are Big AI writ small. It’s “local,” not personal. It’s made to serve your needs with what BigAI offers through APIs. It is still essentially AIaaS (AI as a Service), rather than truly personal AI (pAI): personalized more than personal.

That’s also what I see when I read between the lines at Mozilla’s AI job openings. Take platform engineer. This person will (among other things), “assist in managing and orchestrating workloads across multiple cloud providers.” That’s fine. I’m sure true pAIs will do that too. But most of pAI will be more personal than that. It will deal with the mundanities of your everyday life. Not with coughing up answers that can only come from AIaaSes.

The problem with personalizing AI giant offerings is that they are large language models (LLM) trained on everything that can be crawled on the Internet, plus who knows what else. Not on your truly personal stuff. This is why “prompt engineering” worthy of the noun is ” not for anybody:

Prompt engineering is crucial for deploying LLMs but is poorly understood mathematically. We formalize LLM systems as a class of discrete stochastic dynamical systems to explore prompt engineering through the lens of control theory. We investigate the reachable set of output token sequences $R_y(\mathbf x_0)$ for which there exists a control input sequence $\mathbf u$ for each $\mathbf y \in R_y(\mathbf x_0)$ that steers the LLM to output $\mathbf y$ from initial state sequence $\mathbf x_0$. We offer analytic analysis on the limitations on the controllability of self-attention in terms of reachable set, where we prove an upper bound on the reachable set of outputs $R_y(\mathbf x_0)$ as a function of the singular values of the parameter matrices. We present complementary empirical analysis on the controllability of a panel of LLMs, including Falcon-7b, Llama-7b, and Falcon-40b. Our results demonstrate a lower bound on the reachable set of outputs $R_y(\mathbf x_0)$ w.r.t. initial state sequences $\mathbf x_0$ sampled from the Wikitext dataset. We find that the correct next Wikitext token following sequence $\mathbf x_0$ is reachable over 97% of the time with prompts of $k\leq 10$ tokens. We also establish that the top 75 most likely next tokens, as estimated by the LLM itself, are reachable at least 85% of the time with prompts of $k\leq 10$ tokens. Intriguingly, short prompt sequences can dramatically alter the likelihood of specific outputs, even making the least likely tokens become the most likely ones. This control-centric analysis of LLMs demonstrates the significant and poorly understood role of input sequences in steering output probabilities, offering a foundational perspective for enhancing language model system capabilities.

But all that stuff applies mostly when we’re prompting a big LLM system.

What about using AI in our own lives, where the data that matters most are in our calendars, contacts, financial and health records, our travels, our correspondence (email, chat, whatever)? And how about all the location data we might get from our cars, phone apps, and phone companies? These should be much easier for a pAI to gather, examine, and help us do useful things. Caring about much less data also means a pAI will be less likely to give wrong (hallucinated) answers.

Today the mental frame almost everybody uses for AI is the Big kind, ingesting everything they can get their crawlers on, and munching all of it in giant compute farms. Those systems are great for lots of stuff, but they still don’t deal with personal data listed in the last paragraph.

Not yet, anyway.

Look at it this way. For each of us, there are three data pools:

  1. The entire Net, which is what gets crawled by all the giant LLM operators, plus whatever else they can get their claws on.
  2. One’s personal life, some of which is digitized in useful form (contacts, calendar, mail, stuff in folders inside PCs and attached drives).
  3. Personal data that is in the hands of giants, but is rightfully ours. These include our driving record and driving practices (,recorded by our late model cars and snitched to insurance companies and others), our location data (kept and shared by car and phone carriers to the likes of Google and the feds), our TV viewing habits, (gathered by Google, Amazon, Roku, Apple, etc.).

The pAI greenfield is with the last two.

Tell us who is working on what there, preferably with open source, and not sitting on walled garden silicon.

[Later… ] Since readers told me I had small language models (SLMs) wrong in one of the paragraphs above, and I’m not sure I had them right, I rewrote them out of the piece. I invite readers to post comments to further correct and expand on the subject of pAIs and what they can do.

http://scripting.com/2024/06/13.html#a123437

13 juin 2024 à 14:34
I'm working on a server app to read blogroll source in OPML, and build a database of other blogrolls that are linked to feeds in the original blogroll, accessed via the feed or html source. It was a lucky thing when I designed the format for subscription lists back in the 00s that it included the htmlUrl attribute, it makes the HTML easier to find (though the channel-level link element in the feed could play the same role). Anyway, of course I'm using a SQL database for all this, and when I was thinking about it initially I thought "no big deal" it's a variant of a SQL table I've now done a dozen times. But it was a big deal, because I've yet to come up with a way to factor this so that I have a library that knows how to make the kind of table that keeps coming up all the time, to bury the complexity and make creating a new one much simpler. Same thing with CSS and JavaScript. I know the justification for CSS is that it makes scaling from phones to desktops possible, but that would be equally possible if you provided a good object with properties that can be configured at runtime. That's how we do it on servers with a config.json file. Then you could do a much better job of factoring browser-based apps. Imagine how much smoother everything would be if these structures could be factored. This probably doesn't make sense to too many people, maybe it won't even make sense to me in a couple of years, when hopefully I've moved on to a better way of doing these things. I would love to have the time to take a crack at doing the factoring anyway, I'm sure it's possible, just not obvious how to do it. In the meantime I think there are now enough blogrolls out there to build something interesting out of them, which is why I'm taking my break from The Next Product to do this.

Restitution de la démarche pilote de co-construction intergénérationnelle “Aujourd’hui, demain, quel monde en partage ?” (23/04/24)

Par : Edouard
24 avril 2024 à 08:52

Restitution – au sein de l’Association des Maires de France, avec la participation de Madame la ministre Catherine VAUTRIN et de nombreux élus -, des résultats de notre démarche pilote de co-construction intergénérationnelle « Aujourd’hui, demain, quel monde en partage ? » menée en partenariat avec la Caisse des Dépôts, le Fonds Bayard et l’Unaf. 

Cet événement a été aussi l’occasion d’annoncer le lancement d’un dispositif de soutien à la création de lien intergénérationnel dans les #territoires et dans les organisations !

Pour s’informer, télécharger le Livre Blanc, et rejoindre le mouvement de co-construction intergénérationnelle qui revitalise les territoires et les organisations, rendez-vous sur notre page web dédiée : https://intergenerationnel.vulnerabilites-societe.fr

Cet événement a aussi permis des interventions et des échanges passionnants sur la thématique de l’intergénérationnel avec la participation de : 

Catherine VAUTRIN, Ministre du Travail, de la Santé et des Solidarités,

Jean LEONETTI, ancien ministre, Maire d’Antibes Juan-les-Pins, 

Jean-Christophe FROMANTIN, Maire de Neuilly-sur-Seine et vice-Président du Conseil départemental des Hauts-de-Seine,

Olivier RICHEFOU, Président du Conseil départemental de la Mayenne,

Anne TERLEZ, vice-Présidente du Conseil départemental de l’Eure, Maire adjointe de Louviers,

Véronique LEVIEUX, Maire adjointe de la ville de Paris en charge des séniors et de l’intergénérationnel,

Marylène MILLET, Maire de Saint-Genis-Laval, coprésidente de la commission des Affaires sociales de l’Association des Maires de France.

Guillemette LENEVEU, Directrice générale de l’Unaf.

L’article Restitution de la démarche pilote de co-construction intergénérationnelle “Aujourd’hui, demain, quel monde en partage ?” (23/04/24) est apparu en premier sur Vulnérabilités et Société.

#2 · Ugo Bardi · L'effondrement comme modèle systémique universel ?

Par : Vidéos
26 avril 2021 à 17:38

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique.

📇 Ugo Bardi est chercheur et professeur de chimie à l’Université de Florence et membre du Club de Rome. Il s'intéresse notamment à la déplétion des ressources minérales, à la modélisation de la dynamique des systèmes et à la science climatique. Dans son ouvrage, The Seneca Effect (2017), il applique la théorie des systèmes au monde réel et décrit l’effondrement d'un point de vue multidisciplinaire. Il est également l’auteur de Before the Collapse (2019) et The Empty Sea (2021).

🌱 À propos Transition systémique
ℹ️ Découvrir le programme
📆 S'inscrire et participer aux prochains rendez-vous
👥 Rejoindre le groupe LinkedIn

🎶 Crédits musicaux
Titre : Kalon
Auteur : Extenz
Source : https://soundcloud.com/extenz
Licence : https://creativecommons.org/licenses/by/3.0/deed.fr
Téléchargement (5MB) : https://auboutdufil.com/?id=526

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

💾

📺 Cette vidéo est une rediffusion du webinaire du 22 avril 2021 proposé par Transition systémique, un programme expérimental initié par l'ADEME pour accompagner la transformation écologique des territoires par l'approche systémique. 📇 Ugo Bar...

L’open-data, vecteur de transformation et d’innovation

4 mars 2024 à 16:26

Pour Numéricité, l’open est vecteur de transformation et d’innovation. La donnée est un actif à haute valeur stratégique. Elle permet de partager et d’interpréter de l’information. Fluidifier la circulation des données et encourager leur ouverture, c’est engager les organisations, publiques comme privées, dans l’adoption d’une culture de la donnée. C’est aussi un gage d’une meilleure transparence et efficacité de l’action publique, dans une logique de gouvernement ouvert. Enfin, c’est faciliter le développement de l’économie numérique en permettant des innovations privées appuyées sur des données publiques ouvertes.

C’est pourquoi les entreprises et les administrations publiques se transforment afin de mieux valoriser ces données et investissent dans la construction et la mise en place d’une stratégie data au service de leur stratégie globale.

Retour sur nos missions phares, traduction concrète de notre offre Transfo-soft !

Afin de faciliter la vie des usagers, citoyens comme entreprises, notre pôle Intelligence juridique et conformité a appuyé l’ouverture des données, comme celles produites par France Chaleur Urbaine ou MaCantine.

Moderniser les SI est un prérequis pour faciliter la circulation de la donnée. Pour cela, nous proposons une expertise d’audit nous permettant de formuler des recommandations d’actions concrètes. L’objectif est d’engager la transformation par les métiers, en améliorant leur process internes ou leur organisation produit par exemple.

Numéricité, c’est une équipe d’hommes et de femmes motivés par l’usage d’un numérique ouvert et responsable pour opérer des transformations. Loin d’être promoteur d’un solutionnisme technologique, nous nous faisons chantres de l’open, facteur de transparence et d’efficacité et d’innovation.

La France a une longue histoire d’amour avec l’open-data, et a forgé une vision particulière, notamment sous l’impulsion d’Etalab. Au travers de nos missions, nous sommes fiers de promouvoir ce numérique public français, cette “Digital French Touch”. Nous dessinons déjà la suite d’Etalab grâce aux anciens de la mission ayant rejoint Numéricité et notre réseau de partenaires, et ne cessons d’interroger l’open au regard des nouvelles dimensions technologiques et réglementaires afin de l’entretenir.

Découvrez nos missions phares de sensibilisation à la culture de la donnée et de transmission de la logique d’État-plateforme.

Nous avons accompagné de nombreux acteurs, territoires et gouvernements dans la concertation, la construction et la priorisation de leurs stratégies data. Un seul impératif : mettre l’humain, que ce soit les métiers, les acteurs économiques et/ou les usagers au cœur de la réflexion.

Pour embarquer ces différents collectifs, qu’ils soient spécialistes ou non de la data, nous disposons d’un large éventail de formats : open-lab, ateliers, entretiens, expérimentations, cas d’usage, datadays, hackathons. Il s’agit là d’une première brique de notre approche produit des stratégies data, visant ensuite à s’interroger sur les données à mobiliser, la gouvernance à constituer, les compétences à renforcer, avant de réaliser des expérimentations à petite échelle pour confirmer les orientations.

Voici quelques exemples emblématiques :

Co-construire une stratégie data et rédiger une feuille de route actionnable et appropriable pour Bruxelles, en se faisant facilitateur d’ateliers de travail thématiques.

Mobiliser le potentiel des datas pour améliorer les mobilités à l’échelle régionale lors d’un hackathon au cours duquel les participants pouvaient répondre aux quatre défis pensés en lien avec la stratégie open data d’Île-de-France Mobilités.

Aligner les différentes parties prenantes du Groupe Vyv sur une position ambitieuse autour de l’ouverture des données assurantielles, qui permette de mettre l’usager au centre de l’utilisation de ces données, en organisant une série d’open-lab.

Accompagner la rédaction de la feuille de route de la Direction du Numérique et de la Modernisation de Nouvelle-Calédonie, en organisant en partenariat avec Atlas Management une série d’ateliers, en proposant un parangonnage des exemples internationaux et en coachant des prototypes (POC) data appuyés sur la donnée.

Feed Time

Par : Doc Searls
4 avril 2024 à 21:25
I asked ChatGPT to give me “people eating blogs” and got this after it suggested some details.

Two things worth blogging about that happened this morning.

One was getting down and dirty trying to make DALL-E 3 work. That turned into giving up trying to find DALL-E (in any version) on the open Web and biting the $20/month bullet for a Pro account with ChatGPT, which for some reason maintains its DALL-E 3 Web page while having “Try in ChatGPT↗︎” on that page link to the ChatGPT home page rather than a DALL-E one. I gather that the free version of DALL-E is now the one you get at Microsoft’s Copilot | Designer, while the direct form of DALL-E is what you get when you prompt ChatGPT (now 4.0 for Pro customers… or so I gather) to give you an image that credits nothing to DALL-E.

The other thing was getting some great help from Dave Winer in putting the new Feedroll category of my Feedland feeds placed on this blog, in a way similar stylistically to old-fashioned blogrolls (such as the one here). You’ll find it in the right column of this blog now. One cool difference from blogrolls is that the feedroll is live. Very cool. I’m gradually expanding it.

Meanwhile, after failing to get ChatGPT or Copilot | Designer to give me the image I needed on another topic (which I’ll visit here later) I prompted them to give me an image that might speak to a feedroll of blogs. ChatGPT gave me the one above, not in response to “people eating blogs” (my first attempt), but instead to “People eating phone, mobile and computer screens of type.” Microsoft | Designer gave me these:

Redraw your own inconclusions.

Danswer – Posez des questions à vos documents directement dans Slack et compagnie

Par : Korben
27 mars 2024 à 09:00

Je pense qu’après tous les articles que j’ai écrit au sujet de l’IA, vous commencez à connaitre le concept de RAG (retrieval augmented generation), vous savez qu’il est possible de donner à bouffer à une IA, tout un tas de documents pour ensuite discuter avec celle-ci en utilisant le contenu comme base de connaissance.

Cela permet de poser des questions en langage naturel sur la documentation fournie. Y’a plein d’outils qui permettent de faire ça, et dernièrement, je vous ai présenté PDFToChat ou Reor qui font ça.

Et aujourd’hui, j’aimerais vous faire découvrir une solution open source de recherche unifiée nommée Danswer. Cet outil intègre plusieurs fonctionnalités essentielles, dont la recherche de documents et les réponses basées sur l’IA à partir des requêtes en langage naturel. Il se connecte également à tous les outils de travail courants, tels que Google Drive, Confluence, Github, Notion, Slack et bien d’autres. Il offre aussi une prise en charge de la discussion comme un ChatGPT qui aurait accès à vos ressources de connaissances privées. Vous pouvez même créer des assistants IA personnalisables avec différents prompts et jeux de données.

Cela permet de couvrir tout un tas de cas d’usages tels quel : accélération du support client et réduction des délais d’escalade, amélioration de l’efficacité de l’ingénierie grâce à une documentation et des historiques de code faciles à trouver, préparation des équipes de vente pour des appels plus efficaces, suivi des demandes et priorités des clients pour les équipes produit, et facilitation de la résolution autonome des problèmes liés aux services informatiques, à l’intégration et aux ressources humaines. #BurnoLeMaireLoveZeCapitalizme

Voici ce que ça donne une fois installé :

Vous pouvez même le connecter au modèle de langage LLM de votre choix (en local ou non) pour une solution entièrement cloisonnée. Il se déploie facilement avec une seule commande Docker Compose et peut être hébergé n’importe où. Vous pouvez également l’exécuter avec Kubernetes.

Pour l’installer rien de plus simple, il vous faut d’abord cloner le dépôt de Danswer :

git clone https://github.com/danswer-ai/danswer.git

ensuite, placez vous dans le dossier contenant le fichier de description du docker compose :

cd danswer/deployment/docker_compose

Puis y’a plus qu’à lancer le bousin :

docker compose -f docker-compose.dev.yml -p danswer-stack up -d --pull always --force-recreate

Ça peut prendre un quart d’heure, voire plus, selon votre connexion puisque Danswer a besoin de télécharger des modèles pour fonctionner.

Ensuite, y’a plus qu’à lancer un navigateur vers http://localhost:3000.

Ensuite pour apprendre à l’utiliser et le customiser, toute la documentation est là.

Merci à Lorenper

#DrahiLeaks : AMI, la société qui encaissait d’étonnantes commissions sur les contrats entre Altice et ses fournisseurs

25 mars 2024 à 15:50
Certains fournisseurs d’Altice ont versé des commissions, jusqu’à 10% des factures, à une filiale du groupe en échange de prestations dont on n’a pas trouvé trace. Le système a été interrompu en 2018 à la demande du service juridique du groupe. 

❌
❌