❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

W’ise : l’offre Worteks qu’il est sage d’avoir pour son organisation

Une offre, sept domaines, plus de 100 technologies

W’ise, pour Worteks Intégration Support et Expertise, c’est notre façon de nommer ce que l’on fait depuis des années : intégrer des solutions Open Source éprouvées, les opérer en production, les maintenir dans le temps, et être là quand vous en avez besoin.

Découvrir l’offre W’ise

Sept domaines, des outils qui existent vraiment, des retours d’expérience réels.

Représentation des services de W'ise dans un nuages de logos des technologies couvertes

Cybersécurité, IAM / Auth / PKI / SIEM / Zero Trust

La cybersécurité est la principale préoccupation des RSSI depuis plusieurs années. Dans les faits, une proportion écrasante des incidents sérieux commence par la même chose : un compte compromis, un accès mal configuré, un droit qui n’aurait pas dû exister.

La vraie fondation, c’est l’IAM (Identity and Access Management). Pas le Zero Trust des discours marketing mais le Zero Trust en production !

Ce que l’on déploie :

  • LemonLDAP::NG, serveur WebSSO dont nous sommes contributeurs et mainteneurs. SAML 2.0, OpenID Connect, OAuth 2.0, CAS, Kerberos. Utilisé dans de nombreux ministères, des OIV (Opérateurs d’Importance Vitale), chez des grands comptes. La solution a fait ses preuves depuis de nombreuses années en production et gère l’authentification de plusieurs centaines de millions d’utilisateurs dans le monde.
  • Keycloak, quand les besoins d’intégration applicative le justifient, notamment pour les environnements multi-tenants ou les écosystèmes de microservices.
  • TOTP, WebAuthn/FIDO2, YubiKey, certificats. Des méthode de MFA sérieuses, pas de code par mail ou SMS qui sont des solutions désormais dépréciées.
  • PKI Open Source, EJBCA, Dogtag/FreeIPA, gestion des certificats internes, chaîne de confiance maîtrisée.
  • FranceConnect / ProConnect / eIDAS, intégrations opérationnelles pour le secteur public et ses partenaires.
  • Wazuh, IDS, détection comportementale, conformité (ISO 27001, NIS2, HDS), corrélation d’évènements.
  • Suricata / pfSense / OPNsense, IDS/IPS réseau et firewall Open Source en production.

Ce que nous avons fait : Migration IAM d’une administration centrale opérant plusieurs dizaines de milliers de comptes depuis un SSO vétuste vers LemonLDAP::NG, avec maintien de la production, intégration des applications métier legacy, et MFA déployé sur l’ensemble du parc sans interruption de service.

Virtualisation et VDI, Migration depuis VMware / IaaS / VDI

VMware post-Broadcom a rendu un grand service à l’Open Source : il a transformé une préférence philosophique en impératif budgétaire. Des DSI qui n’auraient jamais envisagé une migration se retrouvent à la planifier en urgence. Nous sommes là pour ça !

Ce que l’on déploie :

  • Proxmox VE, hyperviseur KVM/LXC, interface claire, clustering, migration live, sauvegarde intégrée avec PBS. C’est probablement le point d’atterrissage le plus direct depuis VMware pour les environnements de taille intermédiaire.
  • XCP-ng / XenServer, alternative sérieuse sur les parcs importants, notamment quand Citrix Hypervisor était en place.
  • oVirt, pour les environnements qui ont besoin de la gestion entreprise et du suivi de cycle de vie structuré.
  • OpenStack, pour les besoins de cloud privé à grande échelle, multi-tenant, API-compatible AWS/Azure.
  • Ceph, stockage distribué, résilient, sans SAN propriétaire.
  • VDI / publication d’applications, via des stacks intégrées autour d’Apache Guacamole, oVirt, et des automatismes AWX. Publication d’applications Linux et Windows, authentification forte intégrée via notre IAM. Le coût d’exploitation n’a rien à voir avec une licence Citrix.
  • Kyber, pour les besoins de déport d’affichage avec une autre philosophie que le VDI classique.

Ce que nous avons fait : Migration de clusters VMware vSphere (vCenter, vSAN) vers la ou les solutions pour des collectivités et des structures industrielles, avec plan de migration par vague, maintien de la production, et réduction des coûts d’infrastructure dans des proportions qui ont convaincu des directions financières pourtant peu sensibles à l’Open Source par principe. Tout en mettant en avant, en toute transparence, les coûts liés à la montée en compétences des équipes en interne et aux contraintes d’un projet.

Supervision et Logs, SIEM / Observabilité / Télémétrie

Une infrastructure qui n’est pas supervisée, c’est une infrastructure qui tombe sans prévenir. Une infrastructure supervisée avec des tableaux de bord qui clignotent sans seuils cohérents, c’est presque pareil.

L’observabilité, c’est savoir ce qui se passe, pourquoi, et être averti avant que les utilisateurs ne le soient.

Ce que l’on déploie :

  • Zabbix, supervision infrastructure, réseau, applicatif. Solide, scalable, peut-être pas très ergonomique mais efficace et éprouvé.
  • Prometheus + Grafana, métriques en temps réel, dashboards, alerting. Le standard, de fait, des environnements conteneurisés.
  • OpenTelemetry, collecte unifiée de métriques, traces et logs. Plus besoin d’utiliser trois agents différents.
  • Jaeger, pour voir ce qu’il se passe aux cœurs des applications.
  • Loki, agrégation de logs, requêtes simples, intégration native dans la stack Grafana.
  • OpenSearch / ELK, pour les besoins d’indexation et de recherche full-text sur les logs, avec Kibana ou OpenSearch Dashboards.
  • Wazuh, SIEM Open Source, corrélation d’évènements, détection d’intrusion, conformité réglementaire. Ici, il fait le pont entre supervision, sécurité et SOC.

Ce que nous avons fait : Mise en place d’une plateforme d’observabilité unifiée pour un opérateur critique, couvrant plusieurs centaines de nœuds, avec alerting gradué, escalade d’astreinte automatisée, et intégration SIEM pour la remontée des évènements de sécurité vers le SOC.

Collaboratif, W’Sweet / Visio / PeerTube

W’Sweet, c’est notre réponse concrète à la question qu’on entend souvent : “Microsoft 365, c’est bien, mais on aimerait ne plus en dépendre. C’est vraiment faisable ?”

Oui. C’est faisable. On le fait.

Ce que l’on intègre :

  • BlueMind, messagerie collaborative française, compatible Outlook en protocole natif (MAPI), pas un connecteur susceptible de ne plus fonctionner à chaque mise à jour. Agendas partagés, contacts, mobilité ActiveSync, webmail. Utilisé dans des environnements exigeants y compris dans le secteur public.
  • Nextcloud, partage de fichiers, édition collaborative (Collabora Online ou OnlyOffice intégré), gestion des tâches, flux d’approbation. Vos données restent sur votre infrastructure.
  • Matrix / Element, messagerie instantanée décentralisée, chiffrée de bout en bout, fédérable entre organisations. La vraie alternative à Teams pour la communication interne et inter-organisationnelle.
  • BigBlueButton visioconférence Open Source, déployée sur vos serveurs. Sans limite d’utilisateurs liée à une licence, sans données qui transitent chez un tiers.
  • Jitsi Meet, solution de visio plus légère, déployable rapidement pour des besoins moins formels.
  • PeerTube, hébergement et diffusion de vidéos interne ou public, fédéré, sans YouTube. Pour les formations, les webinaires, la communication institutionnelle…
  • La Suite, les outils de travail collaboratif soutenus par l’Etat, que nous savons déployer et intégrer à votre SI.

Ce que nous avons fait : Déploiement de W’Sweet pour des collectivités et des structures publiques qui sortaient de Microsoft 365 dans le cadre d’une démarche de souveraineté numérique, avec migration des données, formation des utilisateurs, et maintien de la compatibilité avec les partenaires externes restés sur Exchange/Outlook.

Audit, Sécurité / Rationalisation de SI / Conformité

Avant d’intégrer quoi que ce soit, il faut parfois comprendre dans quel état se trouve ce qu’on a. Et c’est souvent plus instructif qu’on ne le croit !

Ce que l’on fait :

  • Audit de sécurité, revue de configuration IAM, analyse des droits et des accès, audit de l’exposition réseau, revue des politiques de mot de passe et MFA, identification des comptes dormants et des privilèges excessifs.
  • Audit d’infrastructure, état des hyperviseurs, des sauvegardes, de la supervision, de la documentation. On dit ce qu’on trouve, y compris ce qui ne fait pas plaisir.
  • Audit de conformité, RGPD, NIS2, HDS, ISO 27001. Avec des livrables directement utilisables et des préconisations cohérentes et qu’il est possible de mettre en oeuvre.
  • Rationalisation de SI, identification des doublons fonctionnels, des licences inutilisées, des briques obsolètes. Nous connaissons des scoiétés qui payaient trois outils différents pour faire la même chose et dont aucun n’était performant.
  • Étude de migration, faisabilité, plan de migration, coût réel (pas optimiste), risques. Que ce soit depuis VMware, Citrix, Microsoft 365, ou un annuaire AD difficilement administré et rarement mis à jour.

Ce que nous avons fait : Audit de rationalisation pour une administration régionale avec cartographie des applications, identification des redondances, plan de migration sur 18 mois, et économies réalisées supérieures au coût de la mission dès la première année.

Conteneurs et CI/CD, Kubernetes / Talos / Tekton / ArgoCD

Les conteneurs ont gagné. Kubernetes est devenu le plan de contrôle de facto pour les workloads modernes. La question n’est plus “est-ce qu’on y passe ?” mais “comment on le fait proprement, sans dette technique dès le premier jour ?”.

Ce que l’on déploie :

  • Kubernetes, déploiement On-Premise ou sur cloud souverain, configuration réseau (Cilium, Calico), stockage persistant (Rook-Ceph, Longhorn), gestion des namespaces et des droits.
  • Talos Linux, OS minimaliste, immuable, conçu pour Kubernetes. Pas de SSH, pas de shell. La surface d’attaque est radicalement réduite. C’est le choix qu’on fait quand la sécurité compte vraiment.
  • Tekton, pipelines CI/CD natifs Kubernetes. Pas de solutions anciennes comme Jenkins par exemple qui sont difficiles à maintenir.
  • ArgoCD, GitOps, déploiement déclaratif, réconciliation continue. Ce qui est dans Git est ce qui tourne en production. Pas d’écart, pas de dérive.
  • Harbor, registry de conteneurs privé, avec scan de vulnérabilités intégré, politique de signature d’images.
  • Helm / Kustomize, templating et gestion des configurations, parce qu’un cluster sans gestion propre des manifests, c’est un cluster qui devient ingérable en six mois.

Ce que nous avons fait : Mise en place d’une plateforme Kubernetes On-Premise pour une structure publique, avec pipeline CI/CD complet depuis le commit jusqu’à la production, GitOps via ArgoCD, et OS Talos sur l’ensemble des nœuds. Zéro accès SSH sur les nœuds de production.

IA et HPC, LLM souverains / RAG / Calcul distribué

L’IA est utile. Ce n’est pas le problème. Le problème, c’est que la manière dont elle est proposée aujourd’hui revient à envoyer vos données confidentielles à un tiers, sous juridiction étrangère, sans que vous sachiez vraiment ce qui en est fait.

On propose autre chose : de l’IA sur votre infrastructure, avec vos données, sous votre contrôle.

Ce que l’on déploie :

  • Ollama , serveur local de LLM, déploiement simple de modèles Open Source (Mistral, Llama, Qwen, Gemma, CodeLlama…) sur vos serveurs. On-Premise ou cloud souverain.
  • Open WebUI, interface utilisateur propre pour interagir avec vos modèles. Les utilisateurs ont une expérience comparable à ChatGPT, mais les données ne sortent pas.
  • RAG (Retrieval Augmented Generation), interrogez votre base documentaire interne avec un LLM : vos wikis, vos notes, vos contrats, votre base de connaissances. Les réponses sont ancrées dans vos documents, les données restent chez vous.
  • Intégration Nextcloud, assistant IA intégré à votre espace collaboratif, résumé de documents, rédaction assistée, sans flux sortant vers OpenAI.
  • Transcription locale, vos réunions et visioconférences transcrites sur vos serveurs avec Whisper. Vos échanges confidentiels restent confidentiels.
  • Slurm, ordonnanceur de ressources pour le calcul distribué et le HPC. Quand vos workloads IA ou scientifiques dépassent le cadre d’un seul serveur GPU, on sait gérer les clusters de calcul.
  • vLLM, inférence haute performance pour les modèles en production à fort trafic.

Ce que nous avons fait : Déploiement d’une plateforme RAG pour un organisme public sur infrastructure souveraine, avec indexation de plusieurs milliers de documents internes, interface utilisateur déployée pour les agents, et zéro donnée sortante. Les agents posent des questions sur leurs procédures internes et obtiennent des réponses sourcées, sans que rien ne quitte leur réseau.

Ce qui ne change pas d’un domaine à l’autre

Quelle que soit la brique W’ise que l’on déploie, quelques constantes :

On contribue aux logiciels qu’on intègre. Sur LemonLDAP::NG , LSC, FusionIAM et d’autres, nous ne sommes pas des intégrateurs qui installent un logiciel qu’ils ont découvert hier. On connaît le code, on le fait évoluer, et quand il y a un bug, il est corrigé à la source.

Vos données, vos formats, vos logiciels. Le jour où vous voulez changer de prestataire, vos systèmes continuent de tourner. Vos données sont dans des formats ouverts. Vos logiciels ne sont pas sous licence donc vous n’êtes dépendants de personne. C’est la définition pratique de la souveraineté.

On dit ce qu’on ne sait pas faire. On ne vend pas tout à tout le monde. Si un de nos partenaires répond mieux à votre besoin, on vous le dit.

La documentation fait partie du livrable. Une infrastructure non documentée est une infrastructure qui appartient à son intégrateur, pas à son exploitant.

Si un ou plusieurs de ces domaines correspondent à un chantier que vous avez devant vous, nous sommes disponibles pour en parler !

Contactez-nous

🔲 ☆

Comprendre la faille Nginx qui impacte le Handler LemonLDAP::NG

L’annonce de la faille de sécurité a été publiée officiellement le 20 avril dernier, en même temps que les versions correctives de LemonLDAP::NG : 2.22.3, 2.21.4 et 2.16.8.

Un bug Nginx dans la gestion de l’en-tête HTTP Host a de graves conséquences pour LemonLDAP::NG qui se base sur cette information pour calculer les droits d’accès d’un utilisateur. Ainsi une requête malveillante plaçant une valeur de l’en-tête Host différente de l’URL demandée peut permettre d’hériter des droits d’une application pour accéder à une autre.

Nous expliquons dans cet article le fonctionnement exact de cette faille de sécurité et comment s’en protéger.

Host moi d’un doute

En HTTP, la notion de host correspond au nom DNS du site web que nous cherchons à contacter. Connaître l’IP du serveur qui héberge (host en anglais) ce site n’est pas suffisant car, dans la majeure partie des cas, le serveur contient différents sites, et pour savoir lequel afficher, il fait confiance au host envoyé par le client (généralement le navigateur internet de l’utilisateur). C’est également vrai dans le cas d’un mandataire inverse (reverse proxy) qui peut transmettre cette information au serveur qu’il protège, afin que ce dernier sache également quel site il doit présenter.

Le standard HTTP indique que le client doit envoyer l’information dans l’en-tête Host, pour des questions de compatibilité avec HTTP/1.0 :

A client MUST send a Host header field in an HTTP/1.1 request even if the request-target is in the absolute-form, since this allows the Host information to be forwarded through ancient HTTP/1.0 proxies that might not have implemented Host.

La RFC 9112 précise par contre que cet en-tête Host ne doit pas être utilisé tel quel par le serveur et doit être remplacé par le nom d’hôte de la cible :

When a proxy receives a request with an absolute-form of request-target, the proxy MUST ignore the received Host header field (if any) and instead replace it with the host information of the request-target. A proxy that forwards such a request MUST generate a new Host field value based on the received request-target rather than forward the received Host field value. When an origin server receives a request with an absolute-form of request-target, the origin server MUST ignore the received Host header field (if any) and instead use the host information of the request-target. Note that if the request-target does not have an authority component, an empty Host header field will be sent in this case.

Il se trouve que Nginx ne suivait pas cette recommandation, et que, dans les versions antérieures à 1.29.5, l’en-tête Host envoyé par le client n’était pas vérifié ni remplacé.

Pour des sites internets classiques, cela ne porte pas à conséquence. Mais pour LemonLDAP::NG, qui s’appuie sur le nom d’hôte envoyé pour appliquer les droits d’accès via son Handler, cela ouvre une faille critique : on peut accéder à une application B en indiquant qu’on demande l’application A, LemonLDAP::NG applique alors les droits d’accès liés à l’application A alors que les requêtes vont sur l’application B.

Exemple de requête avec curl :

curl -v \
  --cookie "lemonldap=xxx" \
  --header 'Host: appli-a.example.com' \
  --request-target 'https://appli-b.example.com/' \
  https://appli-b.example.com/

Cela ne concerne pas les applications connectées à LemonLDAP::NG via les protocoles CAS, SAML ou OpenID Connect, uniquement les applications protégées par le Handler. Malheureusement c’est le cas par défaut du Manager (interface d’administration) qui pourrait donc être accessible à des utilisateurs non privilégiés.

Pour résumer, les installations de LemonLDAP::NG qui sont concernées par cette faille sont celles qui vérifient toutes les affirmations suivantes :

  • Version de LemonLDAP::NG installée avant la sortie des versions correctives (2.22.3, 2.21.4 et 2.16.8) et dont les configurations n’ont pas été corrigées (voir plus loin dans notre article),
  • Utilisation du serveur web Nginx avec une version inférieure à 1.29.5,
  • Protection d’une application avec un Handler, y compris le Manager (sauf si son mode de protection a été changé pour ne plus utiliser le Handler),
  • Pas d’utilisation d’autres logiciels en coupure entre les clients et le serveur LemonLDAP::NG, comme par exemple HAProxy.

Au pied de l’alerte

La gravité de la situation a amené l’équipe de développement de LemonLDAP::NG à alerter l’équipe Nginx, les distributions fournissant officiellement des paquets (Debian, EPEL), et l’ANSSI.

Le bug n’étant pas situé dans le code source de LemonLDAP::NG, la meilleure solution aurait été la diffusion d’une mise à jour de sécurité de toutes les installations Nginx mais la communauté Nginx n’a pas considéré le problème comme assez important pour déclencher ce dispositif.

L’autre solution était la modification des différents fichiers de configuration des hôtes virtuels Nginx afin de ne plus utiliser l’en-tête Host mais passer directement le nom d’hôte correspondant à l’hôte virtuel au Handler LemonLDAP::NG.

Ces modifications ont été faites dans les fichiers fournis dans les paquets, et les versions 2.22.3, 2.21.4 et 2.16.8 de LemonLDAP::NG ont été publiées. Mais mettre à jour son installation ne suffit pas : puisqu’il s’agit de fichiers de configuration, ils ne sont pas écrasés ou modifiés par la mise à jour des paquets. Les administrateurs systèmes doivent appliquer les corrections eux-mêmes.

Protection rapprochée

Il n’est pas très compliqué d’appliquer les modifications nécessaires, mais il faut s’assurer de changer l’ensemble des fichiers de configuration des hôtes virtuels liés à LemonLDAP::NG (Portail, Manager, toutes les applications protégées par le Handler).

Deux cas se présentent :

  • Les configurations définissant le paramètre HOST, qu’il faut dans ce cas remplacer par HTTP_HOST en l’associant à la valeur $host
  • Les configurations ne définissant pas le paramètre HOST, il faut alors ajouter la définition de HTTP_HOST, toujours en l’associant à la valeur $host

Ainsi la configuration suivante :

fastcgi_param HOST $http_host;
# or if using uwsgi server:
#uwsgi_param HOST $http_host;

Deviendra :

fastcgi_param HTTP_HOST $host;
# or if using uwsgi server:
#uwsgi_param HTTP_HOST $host;

Et les configurations qui ne définissaient pas HTTP_HOST devront le faire.

Nous préconisons également de passer en revue les configurations “proxy” afin qu’elles forcent la valeur de l’en-tête Host tranmsmise aux applications protégées.

Remplacer :

proxy_set_header Host $http_host;

Par :

proxy_set_header Host $host;

Besoin d’un coup de main ?

Cet article vous aura fourni toutes les informations pour vérifier que votre installation de LemonLDAP::NG était sécurisée, et pour effectuer les corrections de configurations si elles étaient nécessaires.

Bien entendu, nous sommes à votre disposition pour vous aider à faire le diagnostic de vos serveurs et mettre en place les bonnes configurations, n’hésitez pas à nous contacter !

🔲 ☆

Sympa - Le couteau suisse des listes de diffusion

Description

Sympa est un puissant gestionnaire de listes de diffusion. On le rencontre fréquemment dans des universités, des entreprises ou encore des associations.

Mais une liste de diffusion, c’est quoi en fait ?

Une liste de diffusion est un système permettant d’envoyer simultanément un même message à un groupe de destinataires inscrits. Gérée par un logiciel installé sur un serveur, elle automatise l’envoi de courriels à tous les abonnés, sans que l’expéditeur n’ait besoin de gérer manuellement les adresses individuelles.

Et donc Sympa ?

Le nom Sympa est un acronyme qui signifie SYstème de MultiPostage Automatique. Sa première version remonte à bientôt une trentaine d’années, en 1997. La dernière version en date, la 6.2.78, a été publiée le 28 Mars 2026.

Sympa automatise la gestion des listes de diffusion en prenant en charge les abonnements et désinscriptions, la modération, les archives, la gestion des retours d’erreurs sur des courriels… Et bien évidemment, c’est un Logiciel Libre (sous licence GPL version 3), nous n’en parlerions pas ici sinon.

Sympa offre une gestion fine des droits associés aux listes de diffusion. Ainsi, en fonction de la configuration d’une liste, on définit qui peut :

  • envoyer des messages ou modérer les messages envoyés
  • s’abonner ou se désabonner
  • consulter les archives
  • etc…

Pour chaque liste, on aura des abonnés, des modérateurs et des administrateurs qui ont des droits distincts.

La porte d’entrée principale pour les utilisateurs est, bien évidemment, l’envoi de courriel. D’ailleurs, la grande majorité des utilisateurs n’aura même pas conscience d’utiliser un gestionnaire de listes de diffusion.

Il est toutefois possible d’accéder à Sympa à travers une interface web. Les utilisateurs pourront régler leurs paramètres ou consulter les archives. Les administrateurs et modérateurs pourront y gérer leurs listes. Il existe également une interface en ligne de commande pour les administrateurs disposant d’un accès SSH à la machine. On peut également piloter Sympa à travers une interface SOAP, ainsi que par l’envoi de courriels.

L’authentification sur l’interface web peut être locale, basée sur un annuaire LDAP, en SSO, ou une combinaison de ces différentes méthodes.

Sympa gère aussi bien des listes avec des abonnés statiques que des listes avec des abonnés dynamiques, c’est-à-dire des abonnés définis à partir de sources de données externes, telles qu’un annuaire LDAP, une base de données, des inclusions de listes, des fichiers plats locaux ou distants, ou une combinaison de tout cela. Nous détaillerons un peu plus loin…

En bref, Sympa, c’est le couteau suisse de la liste de diffusion, il sait tout faire, au prix, parfois, d’une certaine complexité de la configuration…

Logo Sympa

Les listes

Selon les circonstances, liste de diffusion complètement ouverte pour les discussions autour d’un Logiciel Libre, liste où tout le monde peut poster mais restreinte aux seuls abonnés pour signaler les problèmes de sécurité autour de ce même Logiciel Libre ou encore liste entièrement cachée pour discuter en toute quiétude de votre prochain plan pour conquérir le monde, les permissions de Sympa permettant de régir une liste sont pléthores :

  • qui peut s’inscrire / se désinscrire à la liste ?
  • qui peut ajouter / supprimer / inviter des abonnés ?
  • qui peut poster sur la liste et est-elle modérée ?
  • qui peut voir la liste des abonnés ?
  • qui peut connaitre l’existence de la liste ?
  • qui peut voir les infos de la liste ?
  • les propriétaires ou modérateurs sont-ils visibles dans les infos de la liste ?
  • qui peut créer des listes, avec ou sans validation du listmaster ?

Ces modèles de listes et de droits peuvent être étendus et personnalisés, mais les possibilités incluses permettent déjà de faire pas mal de choses pour des cas d’usage simples ou modérément simples.

Les types d’utilisateurs

Pour bien comprendre, détaillons les différents types d’utilisateurs :

  • Les abonnés : ceux qui reçoivent les messages envoyés à la liste.
  • Les modérateurs : ceux qui modèrent les messages envoyés à la liste, si la liste est modérée.
  • Les propriétaires : ceux à qui appartient la liste. Ils ont deux niveaux de droit, soit privilégié, soit normal. Ce niveau de droits déterminera les différentes actions possibles sur la liste, en termes de configuration ou de gestion des abonnés.
  • Les listmasters : les administrateurs d’un domaine. Ils ont tous les droits sur toutes les listes d’un domaine. Dans le cas d’une instance de Sympa multi-domaines, les listmasters sont distincts par domaine.

Pour plus de détails : Sympa Administration Manual - Roles and privileges

Les modèles types de listes

Sympa fournit des modèles types de configuration de liste (discussion publique, discussion privée, lettre d’information, etc…). Si cela n’était pas suffisant, il est possible de personnaliser ou créer de nouveaux modèles.

Lors de la création d’une nouvelle liste de diffusion, on peut choisir parmi les modèles de liste disponibles, ce qui définira les différentes autorisations ou restrictions pour cette liste, selon des scénarios pré-établis. Par exemple, une liste configurée pour être une lettre d’information ne pourra émettre des courriels à ses abonnés qu’en provenance d’un modérateur. Le détail des adresses des abonnés sera caché pour tous, sauf les modérateurs et administrateurs de la liste.

Sympa Administration Manual - Typical list profile

Les autorisations des listes

Les différentes autorisations sont définies dans des scénarios. On peut, eux aussi, les personnaliser ou en ajouter. Toutefois, ceux qui sont fournis en standard constituent déjà une base solide.

Sympa Administration Manual - Authorization scenarios

Liste statique

Les listes statiques ont des abonnés fixes, ajoutés ou supprimés unitairement. C’est le fonctionnement classique d’un gestionnaire de listes de diffusion.

Liste dynamique

Une des grandes forces de Sympa, qui va alléger notablement la gestion pour les administrateurs et propriétaires de listes, est la possibilité de générer automatiquement les abonnés d’une liste. C’est ce qu’on appelle les listes dynamiques, dont les abonnés sont déterminés à partir de sources de données externes.

Il existe plusieurs types de sources de données dynamiques que nous allons détailler. À noter qu’une même liste peut en combiner plusieurs si nécessaire, ainsi que des utilisateurs inscrits de la même façon que sur une liste statique.

Inclusion de liste

On peut inclure des listes dans d’autres listes.

Attention : il n’est pas recommandé d’abonner directement une liste à une autre liste, il faut passer par une inclusion. Ceci afin d’éviter, entre autres, les doublons pour les abonnés de plusieurs des listes incluses.

Inclusion de fichier plat (local ou distant)

On peut inclure des abonnés depuis un fichier plat, local ou distant. Ces fichiers devront être générés automatiquement ou manuellement selon un format spécifique.

Inclusion par requête LDAP

On peut inclure des abonnés depuis une requête LDAP. Par exemple : tous les membres d’un groupe ou des filtres plus complexes.

Inclusion par requête SQL

De même que pour une requête sur un annuaire LDAP, on peut inclure des abonnés en passant une requête SQL simple ou plus complexe sur une base de données.

Exclusion d’un abonné d’une liste dynamique

Il est possible d’exclure un ou des abonnés d’une liste dynamique. Il suffit de les désabonner de la liste en question.

Modèles d’inclusion

Pour faciliter la création de sources de données externes, on peut déclarer des modèles d’inclusion. Ces modèles utilisent (ou pas) des paramètres. Il suffit alors d’utiliser ce modèle lors de la configuration d’une liste et, le cas échéant, fournir des valeurs pour les paramètres attendus.

Sympa Administration Manual - Data inclusion file

Inclusion de propriétaires ou modérateurs

La déclaration de propriétaires ou de modérateurs de liste de manière dynamique est également possible. Dans ce cas, l’utilisation d’un modèle d’inclusion est obligatoire.

Pour plus de détails sur les sources externes de données :

Sympa Administration Manual - Data sources

Sympa Administration Manual - Data sources setup

Les autres fonctionnalités fréquemment utilisées

Archives

Pour chaque liste, on peut configurer :

  • la présence d’un archivage des courriels reçus
  • les modalités d’accès aux archives : archive publique ou autorisée seulement pour les abonnés
  • la durée de rétention des archives

Sympa Administration Manual - Archives

Authentification sur l’interface web

Sympa peut utiliser sa base SQL pour gérer l’authentification des utilisateurs sur l’interface web. Il peut aussi utiliser un annuaire LDAP externe et il supporte également le SSO.

Il peut utiliser nativement le protocole CAS, mais aussi les protocoles SAML ou OpenID Connect par le biais des modules mod_auth_mellon et mod_auth_oidc. Une combinaison de toutes ces méthodes d’authentification est également possible.

Sympa Administration Manual - auth.conf

Catégorisation des listes

Afin de faciliter la vue utilisateur sur la page d’accueil de l’interface web de Sympa, on peut classer les listes par catégorie et même par sous-catégorie.

Sympa Administration Manual - topics.conf

Gestion des courriels de retour (bounces)

Sympa dispose de différentes méthodes pour tracer les adresses de courriels qui reviennent en erreur (VERP / MDN). Il les traite de manière automatique, sans nécessiter d’intervention humaine, ce qui constitue un vrai bénéfice pour les listmasters et les propriétaires de liste.

Il existe ainsi une option qui permet d’activer la vérification des adresses de courriel dès l’inscription, afin de détecter, le plus tôt possible, les fautes de frappe.

La désinscription automatique d’une adresse invalide ou en erreur peut être également programmée au-delà d’un certain nombre de retours. Lorsqu’un courriel est retourné, un compteur est incrémenté, en fonction du type d’erreur (temporaire ou permanente), de la fréquence de l’évènement par rapport à la volumétrie de la liste.

  • Lorsque ce compteur dépasse un 1er seuil (paramétrable), une action (paramétrable) est effectuée. Par exemple, courriel au propriétaire.
  • Lorsque ce compteur dépasse un 2nd seuil (paramétrable), une action (paramétrable) est effectuée. Par exemple, désinscription de l’abonné.

Sympa Administration Manual - Bounce management

Cacher (une partie de) la complexité aux utilisateurs

Tous ces réglages contribuent à faire de Sympa une interface de configuration des listes pouvant être déroutante. Afin de cacher une partie de cette complexité, la liste des réglages accessibles à différents niveaux de privilèges est configurable. Ainsi, un listmaster aura toujours accès à toutes les configurations tandis qu’un propriétaire de liste, privilégié ou normal, n’aura pas les mêmes accès.

Sympa Administration Manual - edit_list.conf

Rappel des abonnements

Il est fréquent que les abonnés oublient qu’ils sont inscrits à une liste de diffusion. Les listes peuvent être configurées pour leur envoyer, à une périodicité ajustable, un courriel de rappel, contenant par défaut un lien vers les informations de la liste et un lien de désabonnement.

Les fonctionnalités plus exotiques

Toutes les fonctionnalités que nous avons parcourues ci-dessus vous seront probablement utiles à un moment ou un autre. Mais Sympa a une multitude d’autres fonctionnalités. Toutes ne vous serviront pas nécessairement et la liste n’est pas exhaustive, mais il est toujours bon d’en avoir, a minima, connaissance.

Famille de listes

Les familles permettent de faciliter l’instanciation de listes, en fournissant une configuration type et en permettant d’ajouter des paramètres supplémentaires.

Sympa Administration Manual - List families

Listes automatiques

Les listes automatiques sont une variation autour d’une famille de liste. Une liste pourra être instanciée de manière complètement automatique.

Sympa Administration Manual - Automatic list creation

Personnalisation des messages

Il est possible de personnaliser le contenu des courriels envoyés par une liste de diffusion. Cette fonctionnalité est utile, par exemple, pour une lettre d’information, qui pourra comporter le nom ou prénom de l’abonné dans l’entête ou le pied de page.

Sympa Administration Manual - Message personalization

Partage de documents

Il existe également une fonction de partage de documents. Là encore, pour chaque liste, on peut configurer :

  • L’activation ou non de la fonctionnalité
  • Les droits de lecture et écriture sur ces dossiers et documents.
  • Le quota d’espace disque alloué.

Cette fonctionnalité ne remplace pas un outil dédié au partage de fichiers, mais peut être utile dans des cas simples.

Sympa Administration Manual - shared_feature

Gestion du spam

Si un antispam est présent en amont, il est possible de configurer Sympa pour reconnaitre le statut spam/ham d’un courriel et de prendre des décisions, en conséquence, quand à la distribution du courriel. Par défaut, la logique x-spam-status est utilisée, mais il y a d’autres options.

Sympa Administration Manual - spam_status

Antivirus

Si aucun antivirus n’est présent en amont de Sympa, on peut le configurer pour invoquer un logiciel externe lors de la réception d’un courriel.

Sympa Administration Manual - antivirus_path

DKIM / ARC

Si le relai de courriels sortants ne le gère pas directement, il est possible de configurer Sympa pour ajouter aux courriels sortants une signature DKIM et/ou ARC.

Sympa Administration Manual - DKIM and ARC: Setup Sympa

DMARC

De même, on peut configurer Sympa pour ré-écrire l’expéditeur d’un courriel, afin de ne pas déclencher d’erreur DMARC.

Sympa Administration Manual - DMARC protection

Multi-domaine

Le déploiement le plus courant est de laisser Sympa gérer un seul domaine ou sous-domaine tel que listes.example.org, mais il est également possible de gérer plusieurs domaines dans une seule instance. Les configurations des différents domaines seront héritées du domaine principal, mais pourront bien évidemment être surchargées.

Installation

Tout cela vous aura peut être donné l’eau à la bouche et l’envie d’expérimenter par vous-même. Sympa est disponible sous forme de paquets dans les distributions courantes. Pour ne citer que deux grandes familles, on le trouvera dans :

  • Debian, le mainteneur du paquet étant un des développeurs, Stefan Hornburg.
  • Fedora et EPEL (et donc pour toutes les distributions RHEL et dérivées), où votre serviteur a repris, il y a quelques années, la maintenance du paquet à la suite d’un autre développeur, Soji Ikeda, avec pour objectif de le parfaire et de l’intégrer à la distribution.
🔲 ☆

La vie du composant Open Source après son intégration - 2/3

Cet article a pour objectif de lister les différents points à ne pas négliger quand on commence un projet intégrant des composants Open Source.

Toutes les parties de cet article sont accessibles ci-dessous :

Après avoir défini les critères de choix des composants, nous allons étudier les éléments techniques permettant d’effectuer un choix éclairé.

Les versions

Généralement, un composant Open Source est utilisé dans sa dernière version, mais ce n’est pas toujours le cas. Il est parfois nécessaire d’opter pour une version antérieure.

Du fait du nombre limité de contributeurs, il est rare que plusieurs versions d’un composant soient maintenues. Il faut s’en assurer quand on fait son choix et comprendre que l’impact d’une montée de version peut être important.

La plupart des projets utilisent la notation “Semantic Versioning”, avec des versions utilisant la notation X.Y.Z :

  • X représente les versions majeures, qui ne sont pas compatibles entre elles. L’introduction de modifications dans l’API est souvent la raison de ce changement de version.
  • Y représente les versions mineures, qui restent compatibles. L’introduction de nouvelles fonctions ne cause pas de modification de l’API, la nouvelle version reste utilisable sans changement du code qui s’appuie sur le composant.
  • Z représente les correctifs apportés au composant, sans changement de l’API.

Ce type de notation n’est pas universel. Une autre logique relativement récente consiste à livrer de nouvelles versions incrémentales fréquemment. Les utilisateurs doivent alors prendre en charge les ruptures techniques à chaque changement de version. On pourrait par exemple citer les navigateurs Chrome ou Firefox qui ont un cycle de release particulièrement court (environ une par semaine). Dans tous les cas, une veille technologique est indispensable. Des outils de suivi existent, tel Dependabot qui permet de savoir au jour le jour quel composant a changé de version.

Un autre aspect important concerne l’environnement dans lequel s’exécute le projet. Il est parfois nécessaire de maintenir un projet utilisant de vieilles versions d’un langage (par exemple Java 8) ou d’une version d’OS. En pratique, il suffit souvent de vérifier le bon fonctionnement dans les différentes versions d’un environnement. L’impact est clair : cela interdit souvent l’utilisation des dernières fonctionnalités. Néanmoins il faut être conscient que l’abandon d’une version impacte une quantité non négligeable d’utilisateurs.

Le problème est que la fréquence des releases tend à s’accroître, augmentant ainsi la charge de travail. Il n’est pas à exclure que cela devienne une difficulté de plus en plus importante, dans la mesure où un projet s’appuie sur des librairies, utilisées dans un framework logiciel qui s’appuie à son tour sur un container applicatif, lui-même exécuté dans une plateforme logicielle, dans une machine virtuelle ! Par exemple, Log4J utilisé dans une application Spring, tournant sur Tomcat, dans Docker, sur VMWare…

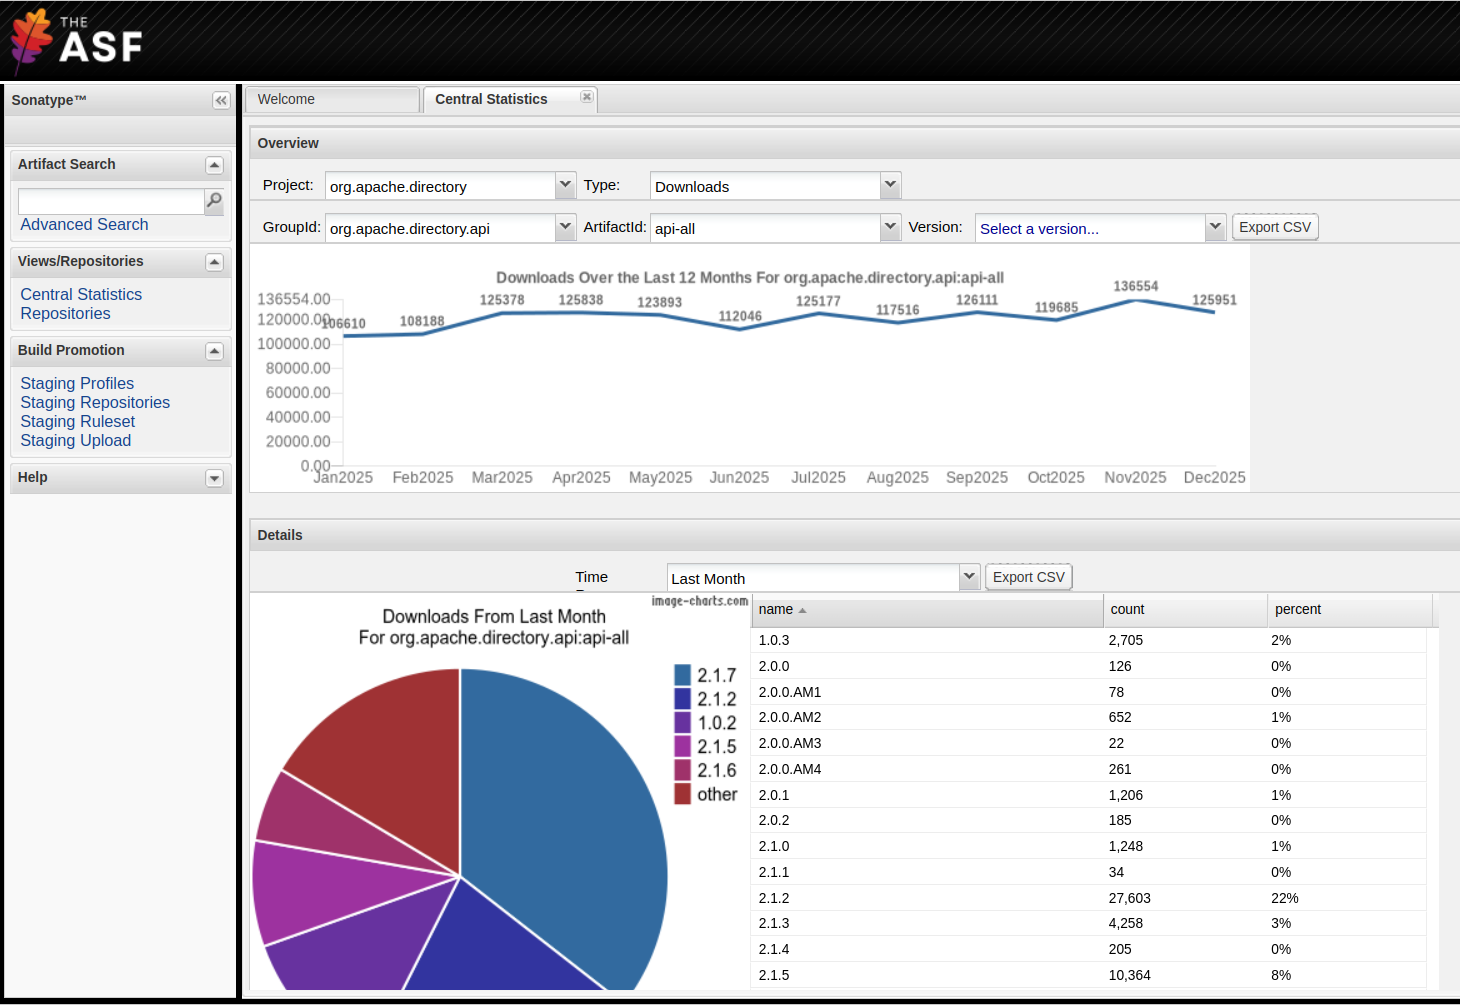
Pour illustrer ce propos, cette image représente les versions de l’API Apache LDAP téléchargées au mois de décembre 2025 : plus de 39 versions différentes, certaines datant de 12 ans (!!!) sont toujours utilisées…

Téléchargements Apache LDAP API

Les évolutions

On devra donc prendre en compte les évolutions de l’environnement d’exécution qui sont liées à plusieurs facteurs :

  • Les versions de l’OS,
  • Les versions de containers,
  • Les évolutions du ou des langages utilisés,
  • Les évolutions des librairies utilisées.

À cela s’ajoute les potentiels conflits de versions : il n’est pas rare que plusieurs composants intègrent eux-mêmes des librairies dont les versions sont incompatibles. C’est ce qu’on appelle classiquement le “dependency hell”.

En Java, cela peut se résoudre par l’utilisation d’une plateforme de service comme OSGi, qui permet d’isoler les composants entre eux. Il existe d’autres solutions, par exemple en JS où un composant va charger tout le code dont il dépend pour former un bloc de code autonome, au prix d’une croissance du code…

Dans tous les cas, il convient d’avoir en tête que cette gestion incombe au projet et que cela peut rapidement devenir complexe.

Les dépendances transitives

Pour aller plus loin, il est important de tenir compte des dépendances transitives, c’est à dire des dépendances utilisées par les composants choisis. C’est évidement récursif et il n’est pas rare d’avoir plusieurs niveaux de profondeur (ici, 9) :

[INFO] org.apache.directory.server:apacheds-installers:pom:2.0.0.AM28-SNAPSHOT
[INFO] +- org.apache.directory.server:apacheds-service:jar:2.0.0.AM28-SNAPSHOT:compile
…
[INFO] |  +- org.apache.directory.server:apacheds-service-builder:jar:2.0.0.AM28-SNAPSHOT:compile
…
[INFO] |  |  +- org.apache.directory.server:apacheds-http-integration:jar:2.0.0.AM28-SNAPSHOT:compile
[INFO] |  |  |  +- org.apache.directory.server:apacheds-http-directory-bridge:jar:2.0.0.AM28-SNAPSHOT:compile
[INFO] |  |  |  \- org.eclipse.jetty:jetty-webapp:jar:9.4.56.v20240826:compile
[INFO] |  |  |     +- org.eclipse.jetty:jetty-xml:jar:9.4.56.v20240826:compile
[INFO] |  |  |     |  \- org.eclipse.jetty:jetty-util:jar:9.4.56.v20240826:compile
[INFO] |  |  |     \- org.eclipse.jetty:jetty-servlet:jar:9.4.56.v20240826:compile
[INFO] |  |  |        +- org.eclipse.jetty:jetty-security:jar:9.4.56.v20240826:compile
[INFO] |  |  |        |  \- org.eclipse.jetty:jetty-server:jar:9.4.56.v20240826:compile
[INFO] |  |  |        |     +- javax.servlet:javax.servlet-api:jar:3.1.0:compile
[INFO] |  |  |        |     +- org.eclipse.jetty:jetty-http:jar:9.4.56.v20240826:compile
[INFO] |  |  |        |     \- org.eclipse.jetty:jetty-io:jar:9.4.56.v20240826:compile
…

Il faudra vérifier toutes les dépendances transitives, leur licence, leur version, leur signature. Ne pas négliger non plus qu’un repository peut également avoir été attaqué ou certaines dépendances avoir été modifiées…[4]

Les SBOMs, une solution ?

Le SBOM (Software Bill Of Material, ou Nomenclature Logicielle) est la liste officielle des dépendances. Il permet de contrôler les licences, de lister les dépendances transitives, de donner la version de chaque composant, de vérifier les signatures et éventuellement d’identifier les CVE associées aux versions utilisées. Il peut (et devrait !) être généré automatiquement. Il existe des outils qui génèrent le SBOM en différents formats, par exemple :

  • Pour CycloneDX[5], qui fonctionne pour C/C++, Node.js, Python, Go, Ruby, Java, .NET, PHP, Javascript.
  • Pour SPDX[6], qui fonctionne pour Java, Python et Go.

Ils génèrent une liste des dépendances, leur version, leur licence…

L’importance de cette nomenclature n’est pas à négliger. Un “Executive order”[7] a stipulé qu’un logiciel ne peut être utilisé par une entité publique aux USA si un SBOM n’est pas fourni. Par ailleurs, en Europe, le Cyber Resilient Act (CRA) en a fait un prérequis et le SBOM doit être livré en même temps que la documentation.

Il s’agit donc d’un élément de confiance à fournir, qui ne règle certainement pas tout, mais permet de s’assurer que l’utilisateur dispose de la liste des composants embarqués, ce qui simplifie le travail des utilisateurs.

Les licences

Dans le cadre du développement d’un produit, il faut définir la licence d’utilisation. Il n’est pas toujours possible de choisir celle que l’on souhaite adopter pour son produit. Dans certains cas, l’utilisation de composants Open Source impose le choix de la licence à utiliser.

Comme indiqué plus haut, la catégorie de licence à laquelle appartiennent les composants utilisés peut imposer le choix. C’est le cas de la licence GPL, qui est dite “contaminante”. Si vous choisissez une licence permissive, vous devrez en faire mention dans votre code et cette mention devra être accessible aux utilisateurs. Prenez votre iPhone, par exemple, allez sur Réglage -> Général -> Mentions légales et certifications -> Mentions légales, vous y trouverez la liste de toutes les licences de chaque composant utilisé. Et il y en a beaucoup ;-)

Quels sont les risques à ne pas respecter les licences, ou à en choisir une qui ne soit pas adaptée ? En réalité, tout dépend de la provenance du composant utilisé. Si celui-ci est maintenu par une société disposant d’un service juridique solide, cela peut s’avérer coûteux. En pratique, les deux risques principaux sont surtout l’obligation de publier l’intégralité de ses sources, si on a choisi un composant GPL par exemple, et l’obligation de basculer sur un autre composant dans un délai assez court. Dans tous les cas, ce n’est ni agréable, ni simple. Autant faire le bon choix dès le départ.

Le support

Partant du principe que le choix du composant a été effectué en tenant compte des différents points exposés précédemment, la suite logique est de se préoccuper de la vie de ce composant. Qui dit logiciel dit bugs, évolutions, améliorations… et l’obligation d’en tenir compte. On cherche ici à comprendre quels sont les besoins en support, qui en est responsable et les modalités de maintenance du composant choisi.

Quoi ?

La première étape est d’identifier les besoins. Cela passe par la qualification du composant sur les points suivants :

  • Sa criticité dans la solution construite.
  • La façon dont on a détourné les anomalies ou les manques fonctionnels lors de l’intégration.
  • Le niveau de performance obtenu et attendu dans un futur proche ou moins proche.
  • La présence ou non de système de supervision, de gestion d’alertes, de logs.

Il faut aussi tenir compte de la façon dont on l’utilise, selon qu’il est intégré au produit, ou hébergé (solution PaaS ou SaaS). Chacun de ses points doit être géré en amont et tout au long de la vie du produit.

Qui ?

Une fois que l’on sait ce qu’on attend d’un composant et ce qu’implique son usage, se pose la question de la responsabilité de son intégration et de sa maintenance en condition opérationnelle.

Il est possible de devenir un membre actif de la communauté, bénéficiant ainsi d’un levier important sur l’évolution du composant. C’est une des raisons pour lesquelles les éditeurs de logiciels recrutent des membres de communautés actives. Le cas de Red Hat est assez significatif, mais ce ne sont pas les seuls. Le bémol étant que la communauté est généralement diverse et que des agendas différents peuvent entrer en conflit.

On peut aussi s’appuyer sur la communauté pour obtenir un support. Rien n’est garanti, mais cela fonctionne étonnamment bien. L’être humain est doué d’empathie et, à condition de demander poliment, on obtient généralement les réponses à ses questions. Reste à voir dans quel délai…

Enfin, on peut aussi avoir recours à des experts externes (consultants, sociétés spécialisées dans le logiciel libre). La principale difficulté est la disponibilité de ces experts, leur coût et leurs compétences réelles. On peut également passer un contrat de service, charge au contractant de faire sienne cette recherche de compétences disponibles.

Comment ?

Une fois identifiée la ou les ressources pouvant répondre au besoin de support à court, moyen ou long terme, reste à définir un cadre de travail.

Dans le cas où le projet internalise ces ressources, il faudra prévoir des formations et/ou des embauches. Et sur une durée longue. L’acquisition de compétences internes est une solution solide.

L’alternative immédiate est le recours à des ressources externes. Il faut s’assurer de la compétence des intervenants, de la surface couverte par le prestataire et du coût induit. Cette solution a l’avantage de ne pas nécessiter une présence permanente : on peut y faire appel ponctuellement en fonction des besoins.

Il est également possible de ne pas internaliser le composant, mais de le ‘louer’, c’est la solution PaaS. L’avantage c’est qu’on s’adresse à une entité dont c’est le cœur d’activité, elle a donc un bon niveau de connaissance et de maîtrise du composant. C’est une solution absolument classique dès qu’on parle d’hébergement de sites web ou de bases de données. L’inconvénient est son coût, à quoi s’ajoute le risque de Vendor Lock-in : changer d’hébergeur n’est jamais simple. On l’a constaté lors du récent changement tarifaire chez VMware, la migration vers des solutions moins coûteuses (Proxmox par exemple) ne s’est pas faite sans peine…

Enfin la dernière possibilité est d’estimer que le composant est fiable, qu’une fois qu’il est intégré il n’y a pas lieu de s’en préoccuper et que, dans le pire des cas, on trouvera toujours une solution. Cela peut sembler inconséquent, mais c’est une pratique assez courante quand il s’agit de composants non critiques ou relativement simples. Les outils de test (Junit ou autre), de log (Log4J), les petites briques simples (il y en a des milliers dans le monde JS) sont fréquemment gérés de cette façon. Les risques sont de deux ordres :

  • L’abandon du composant, qui n’évolue plus, faute de développeur,
  • La faille de sécurité (CVE) qu’il faut corriger en urgence.

Sur ce second point, on a tous en mémoire les mésaventures de Log4J. Vous pouvez regarder la présentation qui a été faite en 2022 à ce sujet[8] et l’histoire de la correction du bug par celui qui était en charge du projet Log4j2[9].

Forker ou pas ?

Il y a de multiples raisons pour vouloir forker un composant. Il y a également de multiples raisons de ne pas le faire ;-)

Quand est-il intelligent de forker un composant ? Voici quelques raisons pertinentes :

  • Quand la gouvernance du projet est inadaptée : exemple avec BDFL qui devient un Dictateur tout court, communauté fermée, projet focalisé sur un agenda commercial, projet en état de mort cérébrale, etc.
  • Quand le projet change de “propriétaire” et que le nouveau ne respecte plus l’esprit initial du projet, ou risque de ne plus le respecter. Ça a été le cas de Hudson (remplacé par Jenkins après son rachat par Oracle), MySQL (remplacé par MariaDB après son rachat par SUN), OpenOffice (devenu Libre Office après son abandon par Oracle). Les exemples sont nombreux.
  • Quand le projet n’est simplement plus maintenu. L’exemple le plus notable est le serveur Web NCSA qui a donné naissance à Apache httpd.

Mais il y a également autant de cas où forker est simplement une perte de temps ou une dilution de l’effort commun.

L’exemple de OpenSSL

L’histoire de OpenSSL est intéressante. Le projet a commencé comme un fork d’un autre projet (SSLEay, projet démarré en 1995, mais pour lequel les efforts de développement avaient cessés en 1998).

Jusqu’en 2014, OpenSSL a suivi une vie assez paisible, jusqu’à la survenue de la faille de sécurité HeartBleed, qui a été une des plus importantes de par son ubiquité. Cela a donné lieu à la création de forks pour diverses mauvaises raisons :

  • Fork LibreSSL par des équipes de OpenBDS, suite à un audit du code. Plutôt que de décider de contribuer, ils ont préféré forker. En une semaine, 90 000 lignes de code ont été supprimées du projet initial… Le succès de ce fork reste à démontrer.
  • Fork BoringSSL par Google. Pas de release, pas de communauté. Mais au moins Google a la main dessus pour son propre usage.
  • Fork AWS-LC par Amazon. Au moins, il y a des releases…
  • Fork QuicTLS, par Akaimai et Microsoft : l’objectif est d’intégrer la couche transport QUIC au dessus de OpenSSL 3.3. Une volonté d’intégrer la fondation Apache a été exprimée.

Au final, l’épisode malheureux a permis la création d’une fondation dédiée (OpenSSL Foundation), l’embauche de 14 salariés et la mise en place d’un budget de développement significatif.

LTS ou pas ?

Autre problème : la maintenance des composants à longue durée de vie ? Le serveur Apache httpd n’existe que dans 2 versions majeures, la 1.X et la 2.X. Aujourd’hui, seule la version 2.4 est supportée. D’autres projets proposent des versions appelées LTS (Long Time Support) avec un engagement de maintenance sur une durée garantie. Cela signifie que les bugs découverts sur les dernières versions seront éventuellement back-portés vers les anciennes versions si nécessaire et qu’une correction des anomalies est assurée.

On doit se poser la question d’opter pour de telles versions LTS, plutôt que pour des versions intermédiaires à rotation rapide. Le cas de Java est assez typique :

  • des LTS toutes les 4 versions,
  • un support (gratuit) de la version sur 5 ans,
  • des versions intermédiaires qui ne sont supportées que jusqu’à la sortie de la nouvelle version.

En ce sens, opter pour une LTS semble raisonnable, on utilisera les versions intermédiaires comme un moyen d’anticiper les migrations ultérieures à moindre coût.

C’est également le cas d’Ubuntu qui a une politique de release de LTS et de versions intermédiaires.

Retrouver de l’information

Il faut aussi mentionner qu’il ne suffit pas d’utiliser un composant Open Source, il faut également disposer de sources d’informations fiables. Et ce n’est pas simple.

  • Les versions évoluent vite et il faut constamment se tenir au courant des modifications apportées. En espérant que les projets fournissent un Change Log adapté et des outils de migration, ce qui n’est pas toujours le cas…
  • Les sociétés qui supportent des projets Open Source se font racheter et il devient difficile de trouver les informations originelles.
  • Internet est vivant et il arrive que les liens sur les documentations ou sources que l’on conservait précieusement soient cassés (parfois parce que le nom de domaine n’est plus renouvelé). Il n’y a plus qu’à espérer qu’InternetArchives a conservé une copie (généralement partielle) des pages.
  • Le contenu peut également disparaître. Toutes les entités gérant des projets Open Source ne proposent pas de récupérer les versions historiques.

Tout cela sans compter les IA qui aujourd’hui rendent difficilement accessibles la documentation ou les échanges sur les anciennes versions, puisque entraînées sur les dernières versions, couplé au fait que les moteurs de recherche ont aujourd’hui tendance à pousser en avant la production de ces IA.

Open Source is One Person

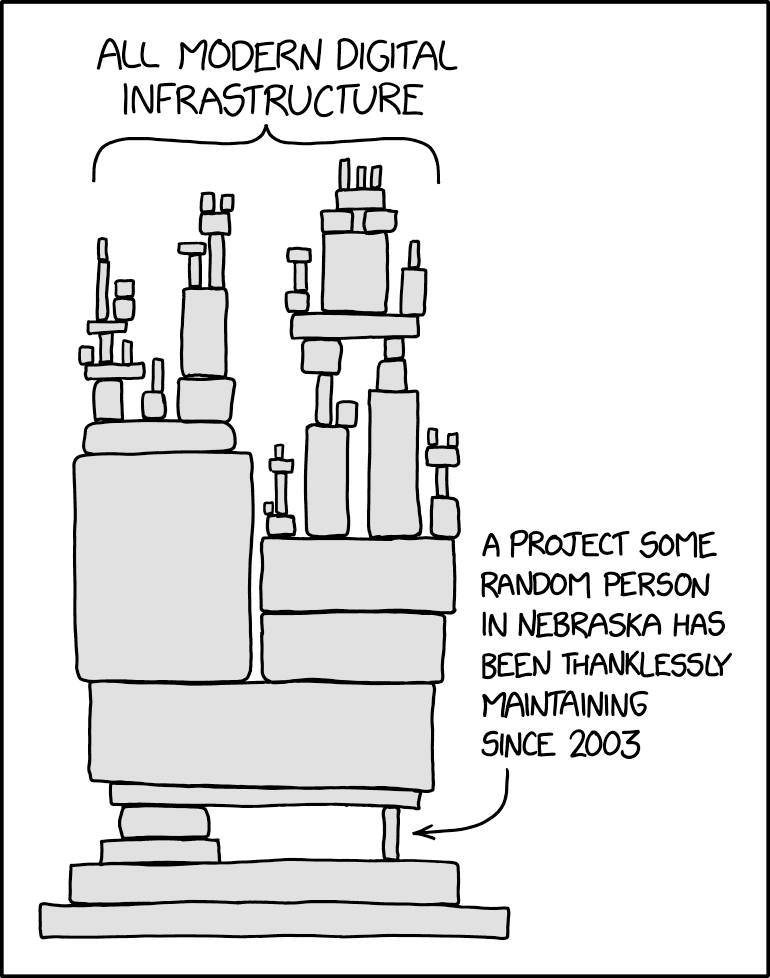
Pour finir, il faut quand même pointer le fait qu’un composant Open Source n’est généralement pas développé ni maintenu par une structure pléthorique. Ceci est parfaitement résumé par le dessin suivant :

https://xkcd.com/2347/

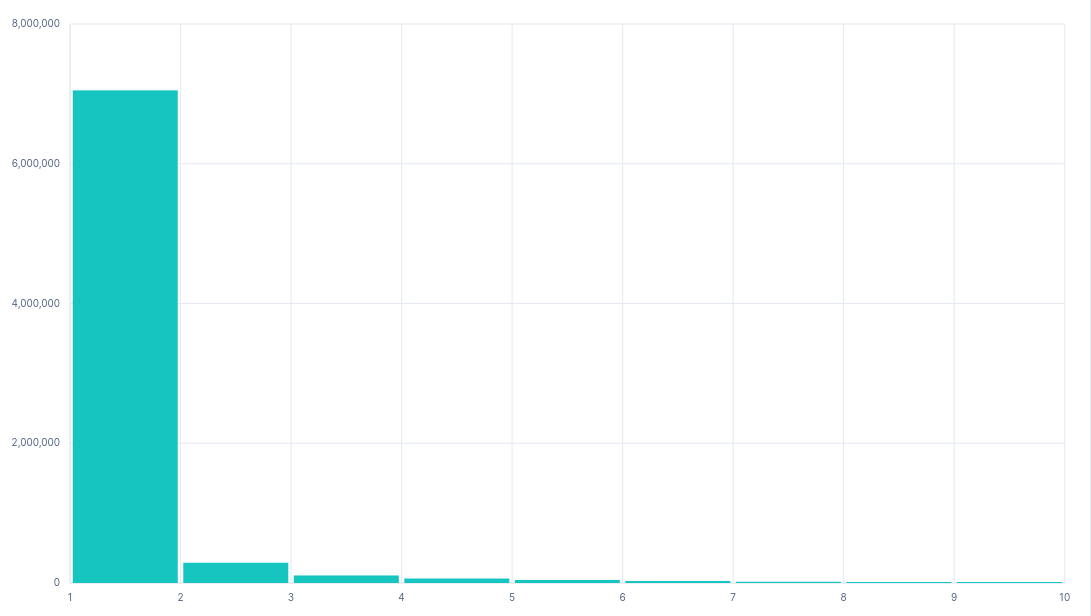
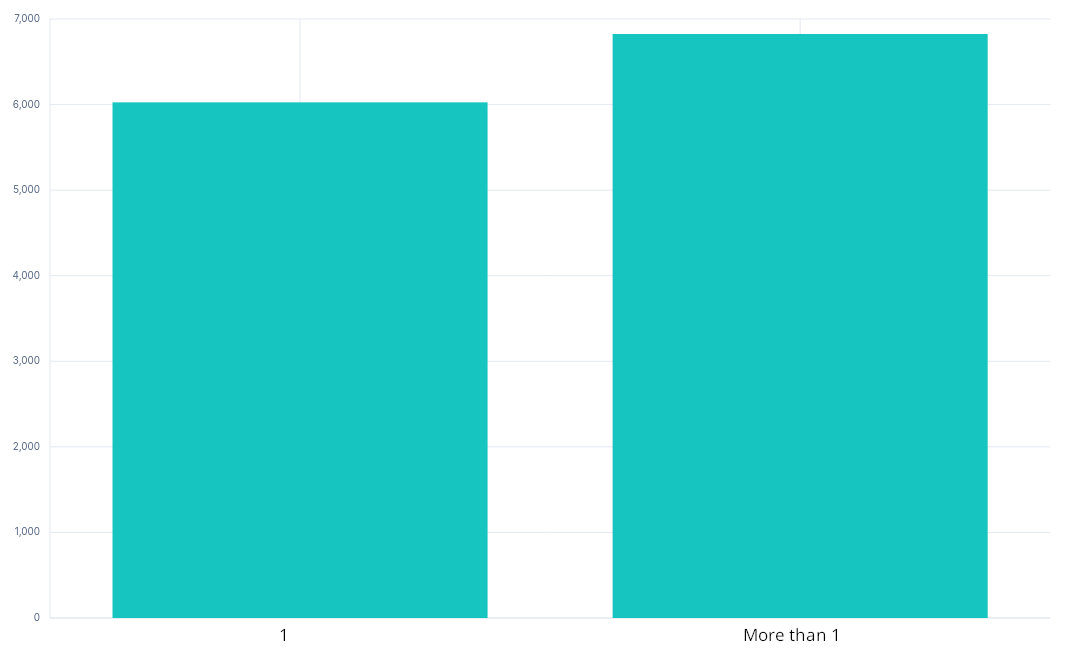
Le projet ecosyste.ms[10] recense un grand nombre de projets Open Source et ses conclusions sont sans appel : sur 11,6 millions de projets analysés, 7 millions sont gérés par une seule personne :

Nombre de mainteneurs par projet

Et si on analyse les projets avec plus de 1 million de téléchargements par mois, près de la moitié n’ont qu’un seul mainteneur :

Nombre de mainteneurs par projet téléchargés plus de 1M de fois par mois

Le résumé est donné sur la page “Open Source is one person”[11].

Exemple : Apache Log4j2

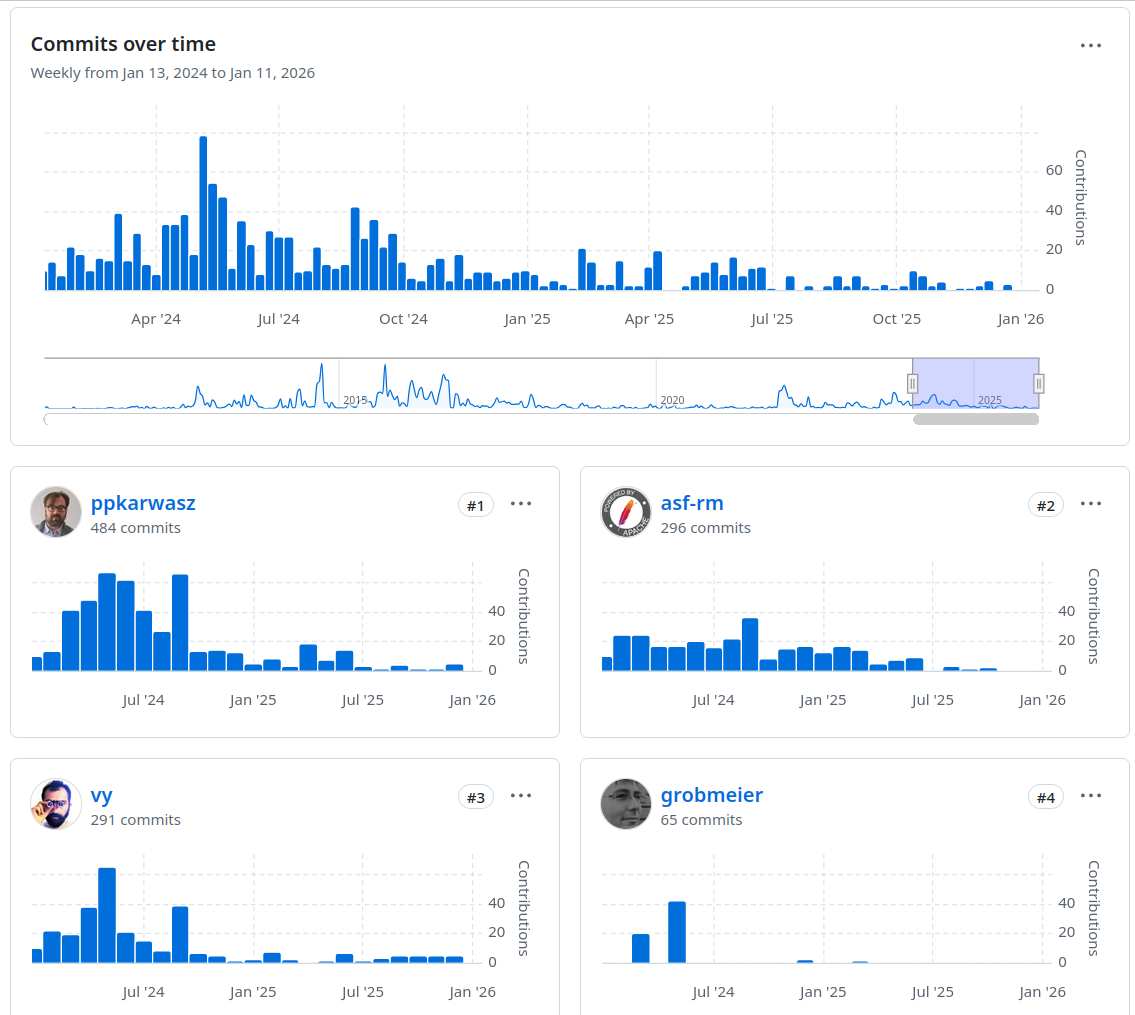
Prenons un premier exemple, le projet Apache Log4j2. Sur les deux dernières années :

  • Il y a eu 1 313 commits,
  • Dont 354 par des outils (Dependabot, ASF CI release Manager), soit 27% des commits,
  • Le développeur le plus actif a effectué 484 modifications, soit 50% du total
  • Le second développeur a effectué 291 modifications, soit 30% du total
  • Le troisième développeur a effectué 65 modifications, soit 7% du total.
  • Les trois premiers développeurs sont donc responsables de près de 88% des modifications
  • Les 34 développeurs ayant participés au projet ont collectivement produit 119 modifications, 3,5 chacun en moyenne…

Apache Log4j2

Exemple : Apache Tomcat

Apache Tomcat est certainement un des composants Open Source de la fondation Apache le plus utilisé. On pourrait se dire qu’il est maintenu par une grosse équipe :

  • Il y a environ 100 contributeurs sur les 20 dernières années,
  • Cela représente environ 25 000 commits,
  • Le premier développeur, Mark Thomas, représente plus de 75% de ces modifications,
  • Le second développeur, Rémy Maucherat, a contribué à hauteur de 10% des modifications,
  • Le troisième développeur, Filip Hanik, a contribué à 4% des modifications,
  • Ces trois développeurs sont donc responsables de 91% des contributions de ces 20 dernières années !

Exemple : LibXML2

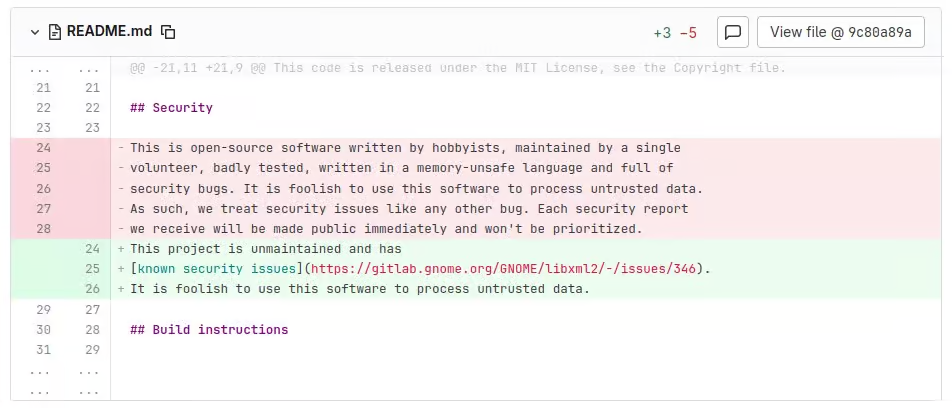
LibXML2 est une (petite) librairie en C utilisée pour parser des documents XML. Elle est largement utilisée par des milliers de packages sous Linux. À la fin de l’année 2025, son unique mainteneur, Nick Wellnhofer, a décidé de se retirer du projet. Son dernier commit est le suivant :

Dernier commit de LibXML2

On peut légitimement s’inquiéter de cette situation[12].

Open Source et développement - Partie 3 : Questions ouvertes : bugs, IA, souveraineté et autres

Bibliographie

[4] Hundred of NPM packages compromised
[5] CycloneDX
[6] SPDX
[7] Executive Order 14028
[8] Log4shell, c’est la faute à la fondation Apache ?
[9] L’histoire inédite de Log4j et Log4Shell
[10] Open source intelligence for your project
[11] Open Source is one person
[12] Libxml2 Becomes Officially Unmaintained After Maintainer Steps Down

🔲 ☆

Questions ouvertes : bugs, IA, souveraineté et autres - 3/3

Cet article a pour objectif de lister les différents points à ne pas négliger quand on commence un projet intégrant des composants Open Source.

Toutes les parties de cet article sont accessibles ci-dessous :

Une fois ce panorama (partiel) présenté, certaines questions restent en suspens. Ce dernier chapitre va essayer de les lister, sans prétendre à l’exhaustivité.

Quid de la longévité ?

Ayant recherché un composant récemment pour un besoin client, voici le dernier message posté sur la page du projet[13] :

“This repository is now archived. Thank you all for your excellent contributions. May it continue to live in all your wonderful forks.” OPENLDAP Exporter

C’est juste un exemple, et fort heureusement il a été forké 65 fois, mais cela ouvre d’autres questions :

  • Quel fork utiliser ?
  • Quelle garanties a-t-on que le fork que l’on choisira survivra ?
  • Le problème ne va-t-il pas se reproduire ?

Encore une fois, dans le monde Open Source, l’utilisateur est le responsable de ses choix. Ceux-ci doivent être pesés.

La gestion des CVEs

Les CVE sont des failles de sécurité identifiées. Elles couvrent l’ensemble des logiciels depuis 1999. Ce système d’alerte est géré par The MITRE Corporation. Aujourd’hui, il s’agit de la référence conservant toutes les failles connues et elle est alimentée en continue. Le 15 avril 2025, le contrat qui liait cette organisation et le gouvernement américain a été rompu par ce dernier à la veille de la date d’expiration contractuelle[14]. Vu l’urgence, une extension de 11 mois a été mise en place, mais rien n’est prévu sur ce qui se passera en avril 2026… On peut légitimement se poser la question de savoir pourquoi l’industrie ne finance pas ce service essentiel.

En Europe, un service équivalent (EUVD, European Union Vulnerability Database[15]) a été mis en place et délégué à l’ENISA[16].

Que faire en cas de bug ?

Donc vous avez trouvé un bug dans un des composants que vous utilisez. Quelle est la démarche à suivre ? Il n’y a pas de procédure toute faite.

La première démarche est de vérifier que ce bug n’a pas été corrigé dans une version plus récente. Si ce n’est pas le cas, peut-être qu’un ticket d’anomalie a déjà été rempli ? Sinon, le plus simple est de créer un nouveau ticket. Mais encore faut-il que le projet propose un mécanisme qui le permette. Si le projet est sous GitHub, par exemple, vous pouvez certainement remplir un rapport d’anomalie (mais attention, tous les projets sous GitHub ne le permettent pas). Si le projet dispose d’un système de gestion des anomalies (JIRA, Redmine, Mantis, Bugzilla, etc), c’est sans doute votre point d’entrée. Une autre solution pourrait être de poster un message sur la liste de diffusion du projet, à condition qu’il y en ait une… Comme on le voit, il n’y a pas de mécanisme standardisé pour signaler une anomalie, chaque projet les gère à son gré et il faut en tenir compte.

En espérant qu’une correction sera proposée ! Et si ce n’est pas le cas, mais qu’on est à même d’apporter cette correction, la question suivante est de savoir comment la gérer : faut-il forker le projet en attendant une éventuelle release ?

Dans tous les cas, les utilisateurs sont fortement encouragés à remonter les anomalies et idéalement à proposer des patchs sous toutes formes possibles.

Et l’IA ?

Un nouveau venu est en train de bouleverser la façon dont on développait : l’IA. Depuis un ou deux ans, les progrès des solutions basées sur des LLM permettent de générer du code qui n’est pas totalement inutilisable. On prétend même que ces IA vont remplacer les développeurs, qui ne seront plus que des prompteurs avec une productivité 10 fois supérieure…

On peut rêver. En attendant, cela pose quand même un certain nombre de questions :

  • Quel est la qualité du code proposé par ces IAs ?
  • Quid de la licence ?
  • Qu’en est-il des tests associés ?
  • Les rapports d’anomalies générés par des IAs sont-ils pertinent ?
  • Quel sera le coût de ces solutions à long terme ?

Aujourd’hui, de nombreux mainteneurs de projets Open Source se plaignent d’être inondés de propositions de correction de piètre qualité générées par des IA. Le temps passé à relire les propositions, à les tester et à les corriger n’est pas forcément en rapport avec le gain obtenu. Sans compter les faux positifs à éliminer.

De plus, on peut se poser la question du coût d’usage de ces outils. S’ils sont aujourd’hui quasi gratuits, ils risquent de devenir payants quand les sociétés qui ont investit des dizaines de milliards de dollars dans ces solutions demanderont un retour sur investissement.

Certains sites se protègent (difficilement) contre ces robots en tentant de leur interdire l’accès aux sources. En effet, ces requêtes incessantes consomment de la bande passante et du temps CPU, ce qui se traduit en frais d’hébergement en forte augmentation. Le second problème est qu’on risque d’aboutir à une “moyennisation” des solutions proposées, puisque l’alimentation de ces outils se fait par la récupération des sources sur internet. A partir du moment où les IA se mettent à produire du code qui sera intégré dans les bases, elles vont se nourrir de ce qu’elles ont elles-même produit. Il ne faut pas oublier qu’il s’agit d’outil de génération probabilistique.

Sans vouloir dépeindre un tableau apocalyptique, il est important de questionner la portée de ces outils et d’en faire un usage raisonné.

Qui finance ?

La grande question… Puisqu’il s’agit d’Open Source, le modèle économique est compliqué à identifier. Aujourd’hui on peut considérer que les contributions sont financées de différentes façons :

  • Par de grosses sociétés comme Google, IBM, Microsoft, qui ont une politique Open Source assez poussée.
  • Par des fondations qui assurent non pas le financement des développements, mais au moins l’infrastructure nécessaire à sa mise à disposition. C’est le cas des fondations Apache ou Eclipse, etc.
  • Par des organisations gouvernementales qui couvrent tout ou partie des développements (NGI, NLNET…).
  • De nombreuses PMI/PME qui soit utilisent des composants et les maintiennent, soit développent ces composants en les mettant à disposition, soit ont une politique de contribution.
  • Par des initiatives publiques ou privées (Bug Bounties, GitHub sponsoring…).
  • Mais également par beaucoup de personnes travaillant sur leur temps personnel.

Parlons de souveraineté

L’Open Source n’a pas de frontière mais… savez-vous que les USA peuvent interdire l’accès à GitHub à certains pays, comme l’Iran ? Cela a été le cas jusqu’en 2021.

Il peut être utile de se poser la question de la disponibilité de certains composants en terme de souveraineté. Pendant de nombreuses années, toute partie de code qui relevait de la cryptographie relevait de mesures d’autorisation d’exportation de la part du gouvernement américain. Rien n’interdit de penser que des règles plus strictes pourraient être imposées.

L’Open Source offre plus de souplesse que le code privatif, mais il convient de rester prudent. Les demandes récurrentes de la mise en place de backdoors par les administrations sont autant d’éléments inquiétants, par exemple.

Sans aller jusqu’à la paranoïa, il semblerait utile que les administrations s’approprient l’Open Source, non seulement en tant qu’utilisatrices, mais également en tant qu’actrices au sein de projets d’importance vitale. Voilà un autre débat, qui ne sera pas ouvert ici et ce long post de blog se clôturera sur ce point en suspens !

Bibliographie

[13] OpenLDAP exporter
[14] CVE program averts swift end after CISA executes 11-month contract extension
[15] European Union Vulnerability Database
[16] ENISA

🔲 ☆

Comment choisir votre composant Open Source - 1/3

Cet article a pour objectif de lister les différents points à ne pas négliger quand on commence un projet intégrant des composants Open Source.

On va tout d’abord présenter l’impact économique de l’Open Source et de son emploi. On s’attachera ensuite à définir les critères de choix des composants, puis les contraintes associées. On terminera par quelques exemples du monde réel pour mettre en exergue les points d’achoppement et la difficulté de s’appuyer sur ces composants.

Toutes les parties de cet article sont accessibles ci-dessous :

Commençons par définir les besoins et les contraintes au niveau technique et économique, mais aussi juridique et organisationnel.

Rapide balayage historique

Le mouvement Open Source n’est pas récent. Il fut un temps où la notion de “propriété intellectuelle” n’existait tout simplement pas. Il faut attendre le 18ème siècle pour que soit instauré le droit d’auteur. Le partage était néanmoins limité par la difficulté de se procurer des supports à moindre coût. Les copistes du Moyen-Age étaient un parfait exemple de système de partage de connaissances, certes limité à un domaine assez restreint…

Dans le domaine de l’informatique, le partage de code et de spécifications se pratique très vite. Les RFC (“Request for Comments”) sont publiées à partir de 1969. Toutefois, le partage de code a existé depuis au moins1955, quand les membres du groupe SHARE mettaient à disposition de tous les modifications logicielles du code tournant sur des serveurs IBM.

Le mouvement “Open Source” se développe fortement dans les années 1980 et 1990. On parlait alors de “free software”. Mais pour supprimer l’ambiguïté du mot “free”, le terme Open Source a été validé qu’en 1998.

À cette même période, voient le jour des projets comme GNU et Linux et des fondations comme The ASF, qui deviennent rapidement des acteurs incontournables de l’Open Source. Considérés comme un “cancer” par certains gros éditeurs, ils vont effectivement métastaser l’écosystème, au point qu’il est difficile aujourd’hui d’imaginer un développement informatique ne comportant pas de composants Open Source. Et cela sans tuer les sociétés qui les utilisent ;-)

L’OSS en 2026

On peut donc considérer qu’en 2026, l’Open Source (OSS) est partout. Dans l’étude “The Value of Open Source Software”[1], on peut lire :

…recent studies have come to similar conclusions showing that open source software (OSS) – software whose source code is publicly available for inspection, use, and modification and is often created in a decentralized manner and distributed for free – appears in 96% of codebases (Synopsys 2023), and that some commercial software consists of up to 99.9% freely available OSS (Musseau et al., 2022)

La quasi totalité du logiciel produit s’appuie donc sur des composants Open Source. Il est illusoire d’imaginer un retour en arrière.

Quelle est la valeur de l’OSS et comment la mesurer ?

Se pose la question de la valorisation de l’Open Source et de son coût. Tout d’abord, on peut évaluer son coût de “remplacement”, à savoir combien coûterait le développement des composants Open Source si chaque acteur économique les utilisant devait les réécrire, ou les acheter. Sur quelle base cette valorisation est-elle effectuée ? Un produit commercial a une valeur théorique qui correspond à un prix de vente multiplié par une quantité vendue. Dans le cas de l’Open Source, le prix de vente peut être considéré comme nul (même s’il est toujours possible de vendre un logiciel Open Source, si on trouve un acheteur…). On calcule alors la valeur de remplacement à partir :

  • du coût du logiciel s’il devait être réécrit,
  • du nombre d’entreprises l’utilisant,
  • Ou de l’achat d’un logiciel propriétaire équivalent, avec le coût du support récurant.

L’étude “The Value of Open Source Software” citée plus haut donne cette évaluation :

  • Le coût de remplacement s’élèverait à 8,8T$, soit environ le PIB du Japon et de l’Inde combinés.
  • Le coût d’écriture unitaire représenterait 4,15G$.
  • Les acteurs économiques dépenseraient 3,5 fois plus en logiciels si l’Open Source n’existait pas.

Un petit exemple

Apache Directory Studio est un logiciel assez largement utilisé dans le monde LDAP.

Il comporte environ 260 000 lignes de code (sans compter les sauts de ligne ou les commentaires, ce qui en double le nombre), soit 10 millions de dollars (selon le modèle COCOMO - Constructive Cost Model -). Le remplacement de ce logiciel Open Source représenterait un effort total de 2,7 ans pour une équipe de 26 développeurs.

En réalité, Apache Directory Studio a été développé à 98% par 3 personnes. Le projet a démarré il y a 20 ans même si l’essentiel du travail s’est concentré sur 7 années.

Il est donc clair que les contraintes du monde professionnel ne s’appliquent pas à l’Open Source, en général. Néanmoins cela donne une idée de ce que peut représenter le coût du développement d’un logiciel Open Source.

Les choix techniques

Bien choisir un composant est essentiel, puisqu’on ne va pas le réécrire. Il est primordial de déterminer les critères de sélection. Ils se répartissent en deux catégories :

  • Les critères mesurables
    • L’adéquation au besoin
    • La compétence interne sur le composant choisi
    • Les performances attendues du composant
    • L’intégration avec les autres composants
    • Les limitations du composant
    • La facilité à administrer et à monitorer le composant
  • Les critères non mesurables
    • La maintenance du projet d’où est issu le composant
    • La possibilité d’y apporter des corrections
    • La qualité de la documentation
    • Le support des failles de sécurité

Cette liste n’est pas exhaustive, mais représente tout de même un ensemble de points pertinents permettant de comparer les composants disponibles et de faire un choix.

Les critères mesurables

De toute évidence, le composant doit répondre à votre besoin technique et fonctionnel. C’est la première étape. Pour valider cette adéquation, il convient de conduire des tests et de réaliser des études de cas ainsi qu’une évaluation fonctionnelle.

Cela suppose que les personnes en charge de cette étude aient la compétence requise pour la mener à bien ou aient recours à des compétences extérieures, ce qui engendre un coût supplémentaire.

La notion de performance est importante, elle sera un des facteurs de dimensionnement de la plateforme sur laquelle tournera le logiciel. Il faut tenir compte des effets de saturation, où les performances peuvent diminuer de façon non linéaire.

L’intégration est à mettre en regard des technologies déjà utilisées et maîtrisées (langage, OS, etc). De même les APIs doivent être étudiées avec soin pour s’assurer qu’elles sont adaptées au besoin.

Un composant Open Source a des limitations, de même qu’un composant privatif. S’il est possible de demander des corrections et des évolutions à une société commerciale, c’est beaucoup plus compliqué pour un projet Open Source, dont le développement est généralement assuré par des volontaires.

Enfin une fois le composant intégré, il faudra le maintenir : montées de versions, analyse des problèmes, corrections des anomalies, sans compter la formation des utilisateurs.

Tout ces critères mesurables vont représenter un coût à internaliser, qu’il ne faut pas négliger lors du choix.

Les critères non mesurables

Ils regroupent les facteurs qu’il n’est pas possible d’évaluer techniquement.

Quand on choisit un composant Open Source, on choisit une communauté : celle qui développe et maintient le produit. Cette communauté n’a aucune obligation autre que celles qu’elle s’impose. Il faut en être conscient, accepter ce risque et l’intégrer dans son plan produit. Un composant Open Source développé au sein d’une fondation comme The ASF ou Eclipse Foundation offre tout de même une garantie plus poussée de pérennité et de qualité sur le long terme, du fait des contraintes imposées aux projets. Par exemple, en ce qui concerne The ASF, on peut citer ces règles :

  • Un projet ne peut rejoindre la fondation que s’il a atteint un niveau de maturité suffisant.
  • Il doit passer par une phase d’incubation sous la supervision d’au moins trois membres de la fondation.
  • Il ne peut sortir de l’incubation tant qu’une release n’a été fournie.
  • Un projet doit disposer d’au moins trois participants actifs de trois sociétés différentes, ce qui interdit la main-mise d’une seule entreprise sur ce projet.
  • Des revues trimestrielles sont à fournir au Board par le responsable de chaque projet.
  • Enfin un projet inactif sera reversé dans l’Attic.

Il est également possible de corriger par soi-même une anomalie critique ou bloquante, ou de développer une fonctionnalité manquante, puisqu’il s’agit d’Open Source. Reste à savoir dans quelle mesure ces corrections ou ajouts vont être intégrés dans les futures versions. Le risque étant d’avoir à maintenir un “fork”.

Un autre aspect qui est souvent reproché aux composants Open Source est la qualité de la documentation. Les projets Open Source n’ont pas nécessairement les moyens de disposer de rédacteurs techniques en charge de la documentation, et c’est généralement du “best effort”. Il n’est pas rare d’avoir des composants dont la seule documentation est le code source, et l’API exposée. Internet reste souvent un moyen d’obtenir l’information manquante, en s’appuyant sur la communauté des utilisateurs.

Enfin il faut tenir compte de la capacité d’une communauté Open Source à prendre en compte les failles de sécurité critiques. L’information est généralement fournie trop tard, lorsqu’elle est déjà publique. En effet, il y a rarement une politique d’alerte privée permettant d’informer les utilisateurs principaux avant la divulgation de la faille corrigée, ce qui est plutôt logique étant donné qu’un projet Open Source ne connaît pas ses utilisateurs (sauf cas d’espèce). Si un processus documenté de gestion des CVE (Common Vulnerabilities and Exposures) existe déjà, c’est un plus. The ASF dispose d’un tel processus[2], par exemple.

Au final, il est compliqué d’associer un coût à ces critères, mais il est nécessaire à tout le moins de les intégrer en terme de gestion du risque.

Les choix organisationnels

Les éléments qui doivent être pris en compte lors du choix d’un composant Open Source sont également directement liés à des choix organisationnels :

  • Disponibilité des ressources internes,
  • Disponibilité de support,
  • Vitalité du projet,
  • État de la communauté,
  • Type de communauté.

Le composant sélectionné doit être pris en main par les équipes internes. Il leur faut l’intégrer, en comprendre le fonctionnement, le tester, valider les performances par rapport aux besoins, gérer les alarmes, le monitorer… En un mot, se l’approprier.

Il est possible d’employer des consultants externes connaissant le composant, encore faut-il les trouver ! Plus le composant est connu, plus il est facile de trouver une ressource externe.

On peut également se poser la question du support : les composants les plus connus sont généralement supportés par de nombreuses entreprises. Reste à qualifier leur niveau de compétence…

Un aspect à ne pas négliger est l’état de la communauté autour du projet. Y-a-t-il une liste de diffusion sur laquelle envoyer les questions que l’on se pose ? Est-elle active ? Les releases sont-elles fréquentes ? Les anomalies remontées sont-elles prises en charge rapidement et efficacement ? Plus généralement, combien y-a-t-il de participants actifs ? Github permet par exemple de vérifier l’activité sur une période de temps afin de se rendre compte si le projet est toujours activement maintenu et développé, pour autant qu’il soit hébergé sur cette plateforme.

Quand aux contributeurs, il faut également se poser la question de leur implication et du cadre de leurs contributions. S’ils sont salariés par des entreprises qui financent leurs travaux, la question de savoir s’ils continueront en cas de changement de cadre professionnel se pose. L’âge des contributeurs est également un facteur à prendre en considération : personne n’est éternel (et chacun va prendre sa retraite à un moment donné…) !

Enfin le type de communauté donne une idée de la direction que peut prendre un projet. Il existe plusieurs modes de fonctionnement, du ‘‘one man show’’ en passant par le BDFL (Benevolent Dictator For Life) jusqu’à un système totalement décentralisé sans direction formelle, où les décisions se prennent collégialement. En pratique, on se trouve souvent confronté à de très petites communautés, ou bien à des communautés adossées à des entreprises commerciales.

Les choix économiques

À ne pas négliger ! Sauf à disposer d’une équipe “couteau suisse” capable de prendre en charge la totalité des composants choisis, il sera sans doute nécessaire d’avoir recours à des experts sur quelques composants essentiels. Et ce n’est pas gratuit !

L’alternative est de souscrire à un contrat de support, ce qui se pratique fréquemment. On entre alors dans un modèle proche de celui d’un éditeur logiciel dont on a acheté un produit, le prix du produit en moins. En réalité, c’est ainsi que se financent de nombreux éditeurs Open Source.

Si votre composant est amené à être exécuté dans le cloud, ou si vous recourez à un service PaaS, il y aura des coûts induits, qui peuvent être conséquents. De nombreux éditeurs logiciels Open Source ont modifié leur modèle de licence pour interdire l’utilisation de leurs produits par des fournisseurs PaaS pour des raisons évidentes. L’impact est alors majeur pour les utilisateurs. Par exemple, une base de données comme MongoDB ne peut pas être utilisée dans sa version Open Source en mode “as a service”. Les coûts peuvent vite se monter à plusieurs dizaines de milliers d’euros par mois pour des volumétries importantes, si on a recours à des solutions basées sur ce produit.

Globalement, les services de type PaaS ne sont pas gratuits et nécessitent une évaluation de l’impact financier lié à ce choix.

Les choix juridiques

Un dernier aspect à prendre en compte, qui n’est pas le moins important, est le type de licence du composant. Toutes les licences Open Source ne se valent pas, certaines sont permissives, d’autres non. Il est primordial d’en comprendre les tenants et aboutissants avant d’opter pour une solution. Il y a trois grandes catégories de licences :

  • “copyleft”, ou “contaminantes” : GPL et dérivées. Ce type de licence impose que les versions dérivées sont soumises aux règles de la licence d’origine.
  • “Permissives” : AL, MIT, BSD… Ce type de licence autorise l’utilisation des composants sans imposer de règles autre que celle de tracer la paternité du code (en l’occurrence, rendre accessible le texte de la licence dans le produit final).
  • “Asymétriques” : Il s’agit de licences autorisant l’utilisation du composant dans un certain cadre, tout en limitant son usage en dehors de ce cadre. C’est, par exemple, une autorisation d’utiliser le composant pour le propre usage d’une entreprise, mais une interdiction d’en permettre l’usage pour les clients de cette même entreprise.

Il existe plusieurs dizaines d’autres licences. Il est nécessaire d’en faire le recensement et d’en étudier les contraintes juridiques avant d’intégrer les composants associés. A ce titre, il peut être judicieux de recourir aux conseils d’un juriste.

Enfin, il faut tenir compte des dépendances transitives ! Un composant Open Source n’arrive jamais seul, il est la plupart du temps lui même consommateur d’autres composants Open Source. Il convient de faire l’étude de chacune de ces dépendances pour faire son choix en connaissance de cause.

Le document produit par The Linux Foundation[3] donne une idée assez précise de ce qu’il convient de prendre en compte lors d’une étude de “compliance” d’un composant.

Lire la suite : Open Source et développement - Partie 2 : Versions, licences, évolutions et maintenance, la vie du composant Open Source après son intégration

Bibliographie

[1] The Value of Open Source Software
[2] ASF Project Security for Committers
[3] Open Source Compliance

🔲 ☆

OVN IPsec avec Kayobe et FreeIPA

OpenStack 2025.1 : Le Guide Ultime pour OVN IPsec avec Kayobe et FreeIPA

La sécurité “Zero Trust” n’est plus une option pour les clouds privés modernes. Si vous déployez OpenStack après 2025.1, vous utilisez sûrement OVN (Open Virtual Network) pour le SDN (Software Defined Network). Mais par défaut, le trafic entre vos hyperviseurs circule en clair.

Dans ce guide, nous allons implémenter le chiffrement IPsec pour les tunnels Geneve (Generic Network Virtualization Encapsulation). Nous allons construire une chaîne automatisée robuste :

  1. FreeIPA fournit et renouvelle les certificats automatiquement.
  2. Certmonger surveille ces certificats sur l’OS de l’hôte.
  3. Kayobe orchestre la configuration en injectant les clés dans les conteneurs Kolla.

L’Architecture : Le défi du Conteneur

C’est là que réside la complexité. Dans un déploiement Kolla/Kayobe :

  • La PKI (Certificats) doit être gérée par l’OS hôte (pour que Certmonger fonctionne).
  • Le service OVS tourne dans un conteneur isolé (openvswitch_vswitchd).
  • Le chiffrement IPsec est effectué par le Kernel Linux de l’hôte.

Nous devons donc générer les clés sur l’hôte, les monter dans le conteneur, et piloter la configuration depuis l’extérieur.

1. Prérequis Réseau : la MTU

C’est non-négociable. L’encapsulation (Geneve) + le chiffrement (ESP) ajoutent environ 100 à 130 octets d’overhead. Pour que vos VMs aient une vie normale (MTU 1500), le réseau physique (“Underlay”) doit être en Jumbo Frames.

Dans kayobe/inventory/group_vars/all/network :

network_interfaces:
  - device: eth1
    mtu: 9000
    description: "Tunnel Interface"

Dans kayobe/kolla/globals.yml :

network_mtu: 9000
kolla_enable_neutron_mtu: "yes"
neutron_tenant_network_mtu: 1500

2. Préparation Kolla : Monter les Volumes

Puisque OVS est enfermé dans un conteneur, il ne voit pas vos certificats par défaut. Il faut “monter” le dossier des clés.

Créez le fichier kayobe/kolla/config/openvswitch.yml :

# On monte le dossier des clés de l'hôte vers le conteneur en lecture seule
openvswitch_vswitchd_extra_volumes:
  - "/etc/openvswitch/keys:/etc/openvswitch/keys:ro"

3. Le Hook Ansible : Automatisation PKI & Firewall

Ce playbook va transformer chaque nœud en client FreeIPA, ouvrir le pare-feu et préparer les certificats.

Fichier : etc/kayobe/ansible/hooks/setup-host-pki.yml

---
- name: Configure Host PKI and Firewall for OVN IPsec
  hosts: overcloud
  become: true
  vars:
    ovs_keys_dir: /etc/openvswitch/keys
    ipa_domain: "internal.corp.net"
    # Astuce: utilisez kayobe-vault pour ce mot de passe
    ipa_join_password: ""

  tasks:
    # --- Étape A : Firewall (Crucial !) ---
    - name: Allow IPsec protocols (IKE, NAT-T, ESP)
      firewalld:
        service: ipsec
        permanent: yes
        state: enabled
        immediate: yes
      when: ansible_os_family == 'RedHat'

    # --- Étape B : Installation FreeIPA ---
    - name: Install IPA client and tools
      package:
        name:
          - ipa-client
          - firewalld
        state: present

    - name: Register node to FreeIPA
      command: >
        ipa-client-install --unattended
        --domain=
        --realm=
        --principal=admin
        --password=
        --mkhomedir
      args:
        creates: /etc/ipa/default.conf

    # --- Étape C : Certificats via Certmonger ---
    - name: Ensure keys directory exists
      file:
        path: ""
        state: directory
        owner: root # Sur l'hôte, root gère ça. Dans le conteneur, ce sera monté.
        mode: '0755'

    - name: Request Certificates using Certmonger
      # Cette commande génère les clés et configure le renouvellement auto
      # Le -C redémarre le conteneur si le certif change
      command: >
        ipa-getcert request
        -f /system.pem
        -k /system-privkey.pem
        -N CN=
        -D 
        -K host/@
        -C "docker restart openvswitch_vswitchd"
      args:
        creates: "/system.pem"

    - name: Copy IPA CA cert to OVS keys dir
      copy:
        src: /etc/ipa/ca.crt
        dest: "/ca-cert.pem"
        remote_src: yes

4. Le Hook de Configuration OVS (Post-Deploy)

Une fois que Kolla a déployé les conteneurs, nous devons dire à OVS d’utiliser ces clés. Ce hook intervient après le démarrage des services.

Fichier : etc/kayobe/ansible/hooks/configure-ovs-container.yml

---
- name: Configure OVS Container for IPsec
  hosts: overcloud
  become: true
  tasks:
    - name: Wait for Open vSwitch container
      command: docker inspect -f '.State.Running' openvswitch_vswitchd
      register: ovs_status
      until: ovs_status.stdout == "true"
      retries: 20
      delay: 5
      ignore_errors: true

    - name: Set OVS SSL config inside container
      # On utilise docker exec car ovs-vsctl n'est pas sur l'hôte
      command: >
        docker exec openvswitch_vswitchd ovs-vsctl set Open_vSwitch .
        other_config:certificate=/etc/openvswitch/keys/system.pem
        other_config:private_key=/etc/openvswitch/keys/system-privkey.pem
        other_config:ca_cert=/etc/openvswitch/keys/ca-cert.pem
      when: ovs_status.stdout == "true"

(Note : Si vous utilisez podman, remplacez docker par podman)

5. Intégration dans Kayobe

Modifiez etc/kayobe/hooks.yml pour insérer ces étapes au bon moment du cycle de vie.

# 1. Préparer l'hôte et les certs AVANT que Kolla ne touche à tout
pre_overcloud_host_configure:
  - ansible/hooks/setup-host-pki.yml

# 2. Configurer OVS une fois que les conteneurs sont lancés
post_overcloud_service_deploy:
  - ansible/hooks/configure-ovs-container.yml

6. L’Interrupteur Général

Tout est prêt, les certificats sont là, OVS les connaît. Il ne reste plus qu’à activer le chiffrement globalement dans la base OVN Northbound.

Fichier : etc/kayobe/ansible/hooks/enable-ovn-global.yml (à lancer manuellement ou en post-deploy final)

- name: Enable IPsec Globally in OVN NB
  hosts: controllers[0]
  become: true
  tasks:
    - name: Enable IPsec
      command: docker exec ovn_nb_db ovn-nbctl set NB_Global . ipsec=true
      ignore_errors: yes # Ignore si déjà activé

Le Test de Vérité

Une fois le déploiement terminé :

  1. Connectez-vous sur un Compute Node.
  2. Interrogez le démon OVS (dans le conteneur) :
    docker exec openvswitch_vswitchd ovs-appctl -t ovs-monitor-ipsec tunnels/show
    
  3. Vérifiez le kernel de l’hôte :
    ip xfrm state
    

Si vous voyez des clés rfc4106(gcm(aes)), félicitations. Votre cloud OpenStack est chiffré, “Zero Trust”, et vos certificats se renouvelleront tout seuls sans casser la prod.

🔲 ☆

Autonomie stratégique numérique - 2/2

Vos résolutions 2026 pour l’autonomie stratégique numérique : comment Worteks peut vous accompagner

L’analyse de l’état actuel des systèmes d’exploitation Open Source en entreprise révèle une maturité technique indéniable et des avantages structurels majeurs. La transparence, la sécurité renforcée, la flexibilité, la maîtrise des coûts et la souveraineté numérique plaident en faveur d’une adoption réfléchie. Dans un précédent article, nous vous expliquions que 2026 est l’année idéale pour franchir le pas en lien avec :

  • La situation géopolitique mondiale
  • Le contexte réglementaire qui favorise l’Open Source.
  • La maturité de l’écosystème technique.
  • Les retours d’expérience qui sont nombreux et positifs.

De son côté, Worteks dispose de toute l’expertise pour vous accompagner dans votre projet. L’approche la plus intelligente consiste à évaluer stratégiquement vos besoins, à vous faire accompagner par nos experts et à privilégier une intégration progressive de l’Open Source, en tirant parti de ses atouts pour construire des infrastructures résilientes, sécurisées et maîtrisées.

En ce début 2026, la question n’est donc plus “Pourquoi migrer vers Linux et l’Open Source ?” mais bien “Quelles parties de mon infrastructure puis-je faire basculer en premier et comment Worteks peut-il m’accompagner dans cette transformation ?” Audit de votre infrastructure et feuille de route personnalisée, contactez Worteks dès aujourd’hui et libérez le potentiel de vos infrastructures.

L’Écosystème complet : tout ce dont vous avez besoin

L’écosystème Open Source d’entreprise est désormais mature, complet et prêt pour tous vos besoins, comme nous l’avons expliqué dans notre article « Vos résolutions 2026 pour l’autonomie stratégique numérique : vers des infrastructures toujours plus ouvertes ! ». Petit rappel des possibilités :

  • Infrastructure de virtualisation : Proxmox VE , oVirt, XCP-ng pour la virtualisation traditionnelle. OpenStack pour le cloud privé. KuberVirt pour l’hybridation VM/conteneurs.
  • Conteneurisation et orchestration : Docker, Podman pour les conteneurs. Kubernetes, OpenShift pour l’orchestration à grande échelle.
  • Stockage : Ceph (stockage distribué objet/bloc/fichier), GlusterFS (stockage distribué), ZFS (système de fichiers avancé avec snapshots et déduplication).
  • Réseau et sécurité : pfSense/OPNsense (pare-feu/routeur), Snort/Suricata (IDS/IPS), OpenVPN/WireGuard (VPN), Wazuh (CVE/logs).
  • Monitoring et observabilité : Prometheus/Grafana (métriques et dashboards), ELK Stack ou Graylog (centralisation de logs), Zabbix/Nagios (monitoring infrastructure).
  • Authentification et SSO : OpenLDAP (annuaire), FreeIPA (gestion d’identité intégrée), LemonLDAP::NG (Web Access Manager et SSO), Keycloak (Identity Provider moderne).
  • Collaboration : BlueMind ou Carbonio (messagerie), Nextcloud (partage et collaboration), Mattermost, Jitsi Meet (communication), GitLab (DevOps).

Worteks maîtrise l’ensemble de cet écosystème et sait composer la solution optimale pour votre contexte quels que soient la taille de votre organisation, votre secteur d’activité, vos contraintes réglementaires, votre budget et vos compétences en interne.

Votre feuille de route 2026

Faire de 2026 l’année de votre indépendance technologique nécessite une approche méthodique et progressive. Voici une proposition de stratégie éprouvée chez nos clients que Worteks recommande.

Roadmap

Approche Progressive

Infrastructure backend

Commencez par l’invisible : migration des serveurs d’infrastructure (DNS, DHCP, proxy), serveurs de fichiers Samba, serveurs web, bases de données.

Avantages : zéro impact utilisateur, gains économiques immédiats.

Worteks vous accompagne avec : audit de l’existant, architecture cible, migration supervisée, formation des équipes techniques, transfert de compétences.

Services Utilisateurs

Déploiement de messagerie Open Source (BlueMind, Carbonio), migration vers Nextcloud pour le partage, mise en place d’authentification centralisée avec OpenLDAP/FreeIPA et gestion des accès web avec LemonLDAP::NG pour le SSO.

Worteks vous accompagne avec : architecture SSO complète, intégration de toutes vos applications, formation des équipes support, documentation personnalisée.

Postes de Travail

Lancement avec des groupes volontaires, profils techniques et utilisateurs bureautique. Distributions comme Ubuntu LTS ou Linux Mint, avec LibreOffice et OnlyOffice. Formation intensive et support rapproché.

Worteks vous accompagne avec : configuration optimale des postes, image système personnalisée, scripts de déploiement, formation utilisateurs, hotline dédiée.

Généralisation

Extension progressive par services, approche hybride assumée avec maintien de postes propriétaires pour applications vraiment critiques, utilisation de VDI (Kyber/Guacamole) pour accès transparent aux applications depuis les postes Linux. Worteks vous accompagne avec : infrastructure VDI complète, optimisation des performances, monitoring et supervision, support continu.

server

Gestion du changement avec l’humain au cœur

L’aspect humain est crucial pour une migration réussie :

  • Communication transparente : expliquer les raisons stratégiques (souveraineté, sécurité, économies), valoriser les bénéfices utilisateurs (performances, stabilité, ergonomie moderne).
  • Formations et ateliers multi-niveaux :
    • Administrateurs système : formation approfondie sur Linux, scripting, sécurité.
    • Support technique : formation intermédiaire, résolution de problèmes courants.
    • Utilisateurs finaux : sessions pratiques courtes, focus sur les outils quotidiens.
    • Identification de champions internes : utilisateurs enthousiastes servant de relais.
  • Support renforcé : période de double support post-migration, documentation accessible (wiki interne, guides visuels, tutoriels vidéo), recueil actif des retours utilisateurs et améliorations continues.

formation

L’expertise pédagogique de Worteks se traduit par des formations adaptées à chaque public, du débutant à l’expert, avec supports de cours complets, labs pratiques et certification des compétences acquises.

Worteks, votre partenaire pour 2026

Worteks accompagne depuis des années les entreprises dans leur transition vers l’Open Source. Notre approche se distingue par :

  • Une expertise technique reconnue
    • Contribution active aux projets Open Source majeurs (OpenLDAP, LemonLDAP::NG, Samba) ;
    • Certification et reconnaissance par les éditeurs et communautés ;
    • Veille technologique permanente et maîtrise des dernières innovations ;
    • Retours d’expérience concrets de centaines de projets réussis.
  • Une méthodologie éprouvée
    • Audit initial complet : infrastructure, applications, compétences, contraintes ;
    • Architecture sur mesure : adaptée à vos besoins réels, pas de solution générique ;
    • Migration progressive : sans rupture de service, avec rollback possible ;
    • Formation intensive : transfert de compétences réel vers vos équipes ;
    • Support continu : accompagnement long terme, hotline, maintenance.

Au-delà de la migration initiale, Worteks reste votre partenaire stratégique pour :

  • Support technique réactif
  • Évolutions et optimisations continues
  • Formations complémentaires
  • Audits de sécurité réguliers
  • Veille sur les nouvelles technologies

partenaire

Notre ancrage français et européen nous positionne idéalement pour accompagner les entreprises dans leurs enjeux de souveraineté numérique. Nous privilégions les solutions développées en Europe (BlueMind, LemonLDAP::NG, Nextcloud) quand elles existent, garantissant conformité réglementaire et indépendance.

🔲 ☆

Autonomie stratégique numérique - 1/2

Vos résolutions 2026 pour l’autonomie stratégique numérique : vers des infrastructures toujours plus ouvertes !

Le paysage technologique des entreprises connaît une transformation profonde. Il s’éloigne des systèmes propriétaires et envisage de manière pérenne un tournant vers des solutions ouvertes et maîtrisées. Ce mouvement, autrefois perçu comme une niche réservée aux pionniers, est désormais une réalité pour des organisations de tous types. Il est impulsé par une conjonction de facteurs stratégiques, économiques, réglementaires, sécuritaires et technologiques qui font de l’adoption de l’Open Source non plus seulement une alternative, mais avant tout une démarche qui offre des avantages structurels souvent supérieurs aux écosystèmes propriétaires traditionnels.

Et si 2026 était l’année où votre entreprise prenait enfin le contrôle de son infrastructure technologique ?

Souveraineté numérique et contexte géopolitique

Le gouvernement Trump 2 affiche une politique agressive visant à déréguler au plus vite le numérique, au niveau européen notamment. En témoignent les sanctions prises récemment à l’encontre des juges de la CPI ou l’interdiction de visa pour Thierry Breton, ancien commissaire européen au marché intérieur. Les géants étasuniens du numérique (Google, Amazon, Facebook, Apple, Microsoft…) obéissent aux autorités américaines et appliquent ces demandes de sanctions.

Ces sanctions sont la conséquence directe de la politique de la Commission Européenne qui vise à réduire la dépendance vis-à-vis des “gatekeepers” technologiques et à promouvoir la transparence. L’Union Européenne s’est dotée, pour cela, de directives et règlements comme le RGPD (Règlement Général sur la Protection des Données), le Digital Services Act (DSA), le Digital Markets Act (DMA), le Cyber Resilience Act (CRA), la directive NIS2, le Data Act et l’IA Act.

Ces réglementations incitent fortement à privilégier l’Open Source, dont le code est auditable par nature. En effet, certains systèmes propriétaires intègrent souvent des mécanismes de télémétrie qui envoient des données vers des serveurs centralisés hors de l’Union Européenne, soulevant des défis juridiques complexes. L’intégration de l’Open Source s’inscrit donc dans un cadre réglementaire et stratégique en constante évolution, où la recherche d’une meilleure sécurité et d’une souveraineté numérique accrue conduit les organisations à réévaluer leurs choix technologiques. Ce virage s’appuie sur la richesse et la diversité des solutions Open Source disponibles, chacune offrant des atouts indéniables. L’Open Source offre ainsi aux organisations la maîtrise totale de leurs infrastructures et de leurs données ce qui garantit qu’aucune information sensible ne peut être transférée sans consentement explicite.

Drapeaux européens

De nombreux pays européens ont inscrit l’Open Source comme priorité stratégique :

  • France : doctrine “Cloud au centre”, programme “Tech.gouv”, soutien à des projets comme Software Heritage ;
  • Allemagne : stratégie “Digitale Souveränität”, projet Sovereign Workplace développant un environnement de travail souverain basé sur Linux ;
  • Commission Européenne : stratégie Open Source officielle depuis 2020, obligation d’évaluer les solutions Open Source en priorité, financement via EU-FOSSA et NGI ;
  • Pays-Bas, Suède, Italie, Espagne : politiques “Open Source first” pour l’administration.

Ce consensus politique signale un changement de paradigme durable et une reconnaissance de l’Open Source comme voie privilégiée pour la souveraineté numérique européenne. 2026 sera l’année où ces initiatives prendront leur pleine ampleur, avec des appels d’offres publics favorisant massivement l’Open Source et des exigences accrues de transparence.

Le panorama des solutions Open Source

Les systèmes d’exploitation

Les distributions Linux

Elles se sont imposées comme le moteur principal de la transformation numérique. Avec des variantes éprouvées comme Red Hat Enterprise Linux (RHEL), Ubuntu Server LTS, Debian ou encore Rocky Linux et AlmaLinux, Linux offre une flexibilité et une adaptabilité sans précédent. Chaque distribution propose un équilibre entre stabilité, innovation et support professionnel. Sa vaste communauté et son écosystème logiciel pléthorique en font une plateforme de choix pour les applications métier, le cloud computing, le big data et l’intelligence artificielle. Le noyau Linux bénéficie de contributions exceptionnelles de milliers de développeurs issus en partie de nombreuses entreprises, garantissant ainsi une diversité de perspectives et une qualité de révision sans équivalent dans le monde propriétaire.

Quelques distributions Linux

OpenBSD

OpenBSD est mondialement reconnu pour son approche intransigeante de la sécurité. Sa philosophie de “sécurité par défaut”, combinée à un processus d’audit de code continu et à des innovations pionnières en matière de protection, en font un choix privilégié pour les infrastructures critiques : pare-feu, routeurs, serveurs VPN. Contrairement aux systèmes propriétaires dont le fonctionnement interne reste opaque, l’ouverture totale du code source d’OpenBSD permet une vérification constante et une confiance inégalée, réduisant drastiquement la surface d’attaque.

Autres Systèmes BSD

Au-delà d’OpenBSD, FreeBSD et NetBSD proposent des alternatives robustes pour des besoins spécifiques. FreeBSD est particulièrement réputé pour ses performances réseau exceptionnelles (utilisé par Netflix, WhatsApp, Sony PlayStation), sa gestion avancée du stockage avec ZFS et sa stabilité légendaire. NetBSD se distingue par son incroyable portabilité, fonctionnant sur une multitude d’architectures matérielles, un atout dans les environnements industriels hétérogènes ou les systèmes embarqués.

Systèmes BSD

Les architecture système et sécurité

Les systèmes Unix et leurs dérivés se distinguent par un modèle de permissions granulaire et robuste, offrant un contrôle précis sur l’accès aux ressources. Des mécanismes avancés comme SELinux et AppArmor sur Linux ajoutent des couches supplémentaires de contrôles d’accès obligatoires, permettant une isolation renforcée des applications et limitant considérablement l’impact d’une compromission.

Cette architecture de sécurité multi-couches contraste avec les systèmes propriétaires qui peuvent souffrir de complexités diverses et de services système s’exécutant avec les privilèges les plus élevés par défaut.

Le modèle Open Source démontre une réactivité supérieure dans la gestion des vulnérabilités. La transparence du code permet à une vaste communauté internationale de chercheurs d’identifier rapidement les failles. Les correctifs sont souvent disponibles avant même que les vulnérabilités ne soient largement exploitées. Les distributions Linux de qualité entreprise affichent des temps de résolution des vulnérabilités critiques considérablement plus courts que les systèmes propriétaires. De plus, des fonctionnalités comme le livepatch permettent d’appliquer des mises à jour critiques du noyau sans redémarrage, un avantage majeur pour la continuité des activités.

L’expertise de Worteks en matière de durcissement des systèmes (hardening) et d’audits de sécurité permet d’accompagner les organisations dans la mise en œuvre de configurations sécurisées dès le déploiement, réduisant drastiquement les risques.

L’Open Source, catalyseur de l’écosystème DevOps

Le cœur de l’écosystème DevOps moderne bat au rythme exclusif de Linux et des systèmes Open Source. La quasi-totalité des outils de CI/CD et d’automatisation trouve leur support optimal sur ces plateformes. Qu’il s’agisse d’Ansible, Puppet, Docker, Kubernetes, Git, Prometheus, Grafana ou de la stack ELK, l’environnement Linux offre une maturité technique et une intégration native qui simplifient considérablement le déploiement et la gestion des infrastructures complexes.

DevOps

L’Infrastructure as Code (IaC), paradigme fondamental qui consiste à gérer l’infrastructure via du code versionné, s’épanouit naturellement dans l’écosystème Open Source. Des outils comme Terraform, Pulumi ou CloudFormation facilitent la définition déclarative des infrastructures, permettant des déploiements automatisés, cohérents et rapides à grande échelle.

Worteks accompagne ses clients dans l’adoption de ces pratiques DevOps, avec des formations personnalisées (centre de formation Qualiopi) et un accompagnement sur mesure pour transformer les équipes IT traditionnelles en équipes agiles et efficaces.

Alternatives Open Source pour les services essentiels

Il est possible d’adresser chaque pan de l’infrastructure via des solutions Open Source :

Annuaire et authentification

OpenLDAP s’impose comme la solution d’annuaire Open Source de référence, offrant une gestion centralisée des identités robuste et éprouvée depuis des décennies. Compatible avec les protocoles standards, OpenLDAP permet de structurer l’organisation des utilisateurs, groupes et ressources de manière hiérarchique et efficace. Pour les besoins plus avancés, FreeIPA et Keycloak fournissent des solutions d’authentification centralisées et de SSO modernes.

Worteks possède une expertise reconnue dans l’architecture et le déploiement d’annuaires OpenLDAP haute disponibilité, avec réplication multi-provider, optimisation des performances et intégration avec les écosystèmes existants. Nous accompagnons régulièrement des migrations depuis Active Directory vers des solutions 100% Open Source.

Gestion des accès web (SSO)

LemonLDAP::NG (LLNG) mérite une attention particulière comme solution française de Single Sign-On. Cette plateforme mature et complète permet de sécuriser l’accès aux applications web avec une authentification centralisée, incluant le support de multiples facteurs d’authentification (MFA), SAML, OpenID Connect, CAS et OAuth2. LLNG offre une alternative souveraine et performante aux solutions commerciales, avec une flexibilité remarquable pour gérer des politiques d’accès complexes et des règles de sécurité granulaires. En tant que contributeur actif au projet LemonLDAP::NG, Worteks dispose d’une expertise unique pour déployer des architectures SSO complexes, couvrant des centaines d’applications hétérogènes avec des règles d’accès sophistiquées. Nos équipes maîtrisent parfaitement l’intégration avec les applications modernes (API REST, microservices) comme legacy.

LLNG

Partage de fichiers et services réseau

Samba offre une compatibilité totale avec les protocoles propriétaires (SMB/CIFS) tout en apportant des fonctionnalités avancées, incluant l’intégration avec OpenLDAP, le chiffrement natif et des performances réseau optimisées.

Messagerie et collaboration

BlueMind (solution française souveraine), Carbonio et SOGo proposent des alternatives complètes avec compatibilité Exchange, calendriers partagés et synchronisation mobile native.

Partage documentaire

Nextcloud s’est imposé comme la plateforme collaborative européenne de référence, offrant partage de fichiers, calendrier, contacts et édition collaborative via Collabora Online ou OnlyOffice.

Cas d’usage réels et adoption sectorielle

Au niveau de la défense et de la sécurité nationale, de nombreux pays européens ont développé des distributions Linux durcies, comme Clip OS en France (ANSSI) ou NeutrINO en Allemagne. Ces systèmes soulignent la confiance placée dans la sécurité intrinsèque de l’Open Source, là où le caractère fermé des solutions propriétaires soulève des doutes légitimes. Dans l’industrie, l’Open Source est le pilier des architectures modernes. Les usines Smart Factory s’appuient sur des systèmes Linux de bout en bout. Des ERP majeurs comme SAP HANA ont fait le choix stratégique de ne fonctionner que sur Linux, en raison des exigences de performance et mise à l’échelle.

Worteks intervient auprès d’entreprises de tous secteurs :

  • secteur privé, industries
  • administration publique
  • santé
  • finance
  • éducation Cette diversité nous permet d’apporter des retours d’expérience concrets et des solutions éprouvées, adaptées à chaque contexte métier.

Stratégies pour les applications propriétaires

Pour certaines applications propriétaires qui ne fonctionnent que sur des systèmes spécifiques, plusieurs solutions existent.

Virtualisation d’entreprise

L’écosystème Open Source offre des plateformes de virtualisation matures et performantes qui ont bénéficié d’un coup de projecteur depuis le rachat de VMWare par Broadcom.

  • Proxmox VE : solution complète intégrant KVM pour la virtualisation et LXC pour les conteneurs, avec interface web intuitive, haute disponibilité native et gestion centralisée. Particulièrement adaptée aux PME et infrastructures distribuées.
  • oVirt : plateforme de gestion de virtualisation KVM d’entreprise, sponsorisée par Red Hat, offrant des fonctionnalités avancées de centre de données (live migration, haute disponibilité, gestion centralisée de milliers de machines virtuelles).
  • XCP-ng : fork communautaire libre de Xen, éliminant les limitations artificielles, avec Xen Orchestra comme interface de gestion moderne. Solution robuste pour les environnements exigeants nécessitant une isolation stricte.
  • OpenStack : plateforme cloud complète pour infrastructures à grande échelle, permettant de créer des clouds privés ou publics avec gestion automatisée de milliers de machines virtuelles et de ressources réseau/stockage.
  • KubeVirt : extension de Kubernetes permettant d’exécuter des machines virtuelles aux côtés des conteneurs, idéale pour les organisations adoptant une approche cloud-native tout en conservant des workloads legacy.

Worteks a déployé et gère des infrastructures de virtualisation pour des centaines de clients, du petit cluster Proxmox à des clouds privés OpenStack de plusieurs milliers de cœurs. Notre expertise couvre toute la chaîne :

  • architecture,
  • déploiement,
  • migration,
  • formation et support.

Dev

Infrastructures de bureau virtuel (VDI)

Des solutions comme Apache Guacamole (Open Source, accès via navigateur) ou Kyber permettent de centraliser les applications sur des serveurs dédiés et d’y accéder à distance depuis des clients légers. Kyber, en particulier, offre une solution VDI Open Source performante qui facilite l’accès aux applications Windows depuis des postes Linux, réduisant drastiquement le nombre de licences nécessaires tout en maintenant l’expérience utilisateur.

L’approche VDI avec Kyber ou Guacamole représente souvent la solution idéale pour les entreprises souhaitant migrer progressivement : les utilisateurs bénéficient d’un poste Linux performant et sécurisé pour leur travail quotidien, tout en conservant un accès transparent aux quelques applications propriétaires critiques via VDI.

Conclusion

Ce panorama des logiciels Open Source montre qu’ils balayent le spectre d’utilisation des solutions propriétaires tout en constituant des alternatives plus performante, sécurisée et souveraine que ces dernières. Dans notre article suivant « Vos résolutions 2026 pour l’autonomie stratégique numérique : comment Worteks peut vous accompagner », nous vous expliquons comment Worteks peut vous accompagner dans votre migration vers des solutions 100% Open Source.

🔲 ☆

Proxmox VE

Proxmox VE : Une alternative crédible à VMware, mais pas universelle

L’annonce du changement de politique tarifaire de VMware par Broadcom a créé un véritable séisme dans l’écosystème de la virtualisation d’entreprise. Face à des augmentations parfois dramatiques des coûts de licensing, nombreuses sont les organisations qui explorent des alternatives. Proxmox VE s’impose naturellement dans cette réflexion, porté par une communauté active et une approche Open Source séduisante. Cependant, cette migration mérite une analyse technique approfondie pour éviter les écueils d’une transition mal préparée.

Le contexte post-Broadcom : comprendre l’exode VMware

Depuis le rachat de VMware, les nouvelles grilles tarifaires ont bouleversé l’équation économique de nombreuses infrastructures. Les licences par socket disparaissent au profit d’un modèle par cœur CPU, accompagné de bundles imposés qui incluent des fonctionnalités parfois non utilisées. Cette évolution pousse légitimement les DSI à réévaluer leurs choix technologiques. Nous avons déjà réalisé une série d’articles à ce sujet, n’hésitez pas à aller les consulter.

Proxmox VE apparaît alors comme un candidat naturel : hyperviseur basé sur KVM/QEMU, distribution Debian, interface web unifiée et modèle économique transparent. Mais attention aux raccourcis : remplacer VMware par Proxmox ne se résume pas à une simple substitution technique.

Architecture VMware vs Proxmox : correspondances et divergences

Le modèle VMware traditionnel

L’architecture VMware classique s’articule autour de vCenter Server pour la gestion centralisée, d’ESXi comme hyperviseur, et s’appuie sur un stockage partagé (SAN/NAS) avec des fonctionnalités avancées comme vMotion, DRS, et HA. Cette architecture convient particulièrement aux environnements nécessitant une haute disponibilité avec des SLA stricts. Ce modèle est le cas typique des déploiements VMware et correspond à une grande partie des infrastructures à migrer.

L’approche Proxmox

Proxmox VE propose une architecture plus distribuée où chaque nœud intègre à la fois l’hyperviseur (KVM) et les capacités de gestion via une API REST. Le clustering s’appuie sur Corosync, et le stockage peut être géré de manière native via Ceph, ZFS, ou des backends externes.

  • Correspondance directe : infrastructures de 3 à 16 nœuds avec besoins de virtualisation classique, environnements de développement/test, infrastructures départementales.
  • Limites architecturales : grandes fermes de virtualisation (>100 hôtes), environnements multi-tenants complexes, intégrations poussées avec des écosystèmes propriétaires.

Migration technique : méthodologie et limite

Prérequis et planification

La migration nécessite une analyse préalable rigoureuse :

  • Audit de l’existant VMware
  • Inventaire des VMs et leurs dépendances
  • Analyse des performances (CPU, RAM, stockage, réseau)
  • Cartographie des fonctionnalités utilisées (vMotion, DRS, snapshots)
  • Évaluation des intégrations (backup, monitoring, orchestration)

Processus de migration

La phase de migration est assez simple, reposant essentiellement sur de la conversion de machines virtuelles. Les technologies se ressemblant fortement, il est facile de proposer un modèle type :

  • Phase 1 : Reconstruction des services
    • Reconfiguration du réseau (VLAN, bridges)
    • Mise en place du clustering Proxmox
    • Configuration du stockage (Ceph, ZFS, ou stockage externe)
  • Phase 2 : Conversion des VMs , Proxmox propose plusieurs méthodes :
    • Conversion directe via qm importovf pour les exports OVF
    • Migration à chaud possible avec des outils comme virt-v2v
    • Import des disques VMDK vers formats qcow2 ou raw

Il est possible de créer un cluster minimal et de basculer les hyperviseurs d’une solution à une autre pour éviter de devoir dupliquer le nombre de serveurs physiques. Attention : un point de vigilence important concerne la partie stockage local, où un certain nombre de déploiements ESX sont sur des cartes SD ou flash simples.

Points de vigilance techniques

Il y a plusieurs points de vigilance pour identifier la faisabilité d’une migration VMware vers Proxmox :

  • Stockage : L’absence d’équivalent direct à VMFS nécessite de repenser l’architecture de stockage. Ceph étant intégré, cela offre une solution élégante. Pour les profils les plus expérimentés, il est conseillé de séparer le stockage et la virtualisation en gérant le cluster Ceph autrement.
  • Réseau : Proxmox gère nativement les VLAN et bridges, mais des configurations réseau complexes (NSX) nécessitent une refonte.
  • Haute disponibilité : Le système HA de Proxmox, bien que fonctionnel, reste plus basique que DRS/vSphere HA pour des environnements critiques.

L’équation économique : au-delà de la gratuité apparente

Coûts directs Proxmox

Si Proxmox VE Community est gratuit, les environnements de production nécessitent généralement un support commercial :

  • Les tarifs Proxmox évoluent régulièrement. Il convient de vérifier les prix actuels sur le site officiel pour une évaluation précise.
  • Proxmox Backup Server nécessite également une souscription pour les environnements de production.

Coûts indirects souvent oubliés

Il est important de noter que certains coûts restent souvent peu estimés ou négligés, ils sont à prendre en compte dans le ROI avec l’économie faite sur les souscriptions VMware :

  • Formation et montée en compétences sur :
    • KVM
    • LXC
    • Ceph
    • clustering Linux
  • Mise en place d’outils périphériques : L’écosystème VMware (vRealize, NSX) n’a pas d’équivalent direct, nécessitant des solutions tierces.
  • Souscription à des contrats de support et d’expertise : Il est recommandé de passer par un intégrateur en plus du support Proxmox pour le déploiement.

Cas d’usage adaptés et limites de Proxmox

Le paysage des solutions de virtualisation Open Source est varié et complexe, comme nous l’avons décrit dans notre série d’articles sur le sujet.

Proxmox excelle pour :

  • PME avec infrastructures simples à moyennes (5-50 VMs)
  • Environnements de développement/test
  • Organisations avec expertise Linux forte
  • Besoins de conteneurisation (LXC natif)
  • Budgets contraints avec tolérance aux risques

D’autres alternatives sont préférables pour :

  • Grandes infrastructures (>100 hôtes) : OpenStack ou oVirt
  • Environnements critiques 24/7 : XCP-ng, KubeVirt, OpenStack ou oVirt
  • Intégrations complexes : KubeVirt ou OpenStack
  • Organisations sans expertise Linux : oVirt ou XCP-ng
  • Besoins cloud hybride : OpenStack

Recommandations pour une migration réussie

Approche pilote

Il est préférable de prendre en main l’outil avant de réaliser la conversion de toute votre infrastructure. Commencer par un sous-ensemble non critique permet de valider l’approche :

  1. Migration d’un cluster de développement
  2. Formation des équipes sur 6 mois
  3. Validation des processus de sauvegarde/restauration
  4. Extension progressive aux environnements de production

Critères de décision

La décision doit être motivée par un besoin et non par une mode ou un effet de foule. Voici certains éléments à prendre en compte :

  • Complexité : Plus l’infrastructure VMware est sophistiquée, plus la migration sera complexe
  • Compétences : L’expertise Linux/KVM interne conditionne largement le succès
  • Budget : Au-delà des licences, intégrer formation, outils et période de transition
  • Évolutivité : Anticiper les besoins futurs (croissance, cloud hybride)

Conclusion : pragmatisme avant tout

Proxmox VE représente une alternative sérieuse et économiquement attractive pour de nombreux cas d’usage. Son architecture moderne, basée sur des standards ouverts, offre une flexibilité appréciable. Cependant, cette migration ne doit pas être motivée uniquement par les considérations économiques immédiates. Le succès d’une transition repose sur une analyse technique rigoureuse, une planification méthodique et une évaluation réaliste des compétences disponibles. Pour les organisations disposant de l’expertise technique appropriée et d’infrastructures correspondant au modèle Proxmox, cette migration peut effectivement représenter une opportunité de modernisation et d’optimisation des coûts.

L’écosystème Open Source offre aujourd’hui plusieurs alternatives crédibles : oVirt, KubeVirt pour les environnements hybrides, XCP-ng pour une approche Xen, ou OpenStack pour les infrastructures orientées IaC ou IaaS. Chaque solution répond à des besoins spécifiques et mérite une évaluation dans le contexte de migration post-VMware. L’engouement autour de Proxmox est légitime, mais doit être tempéré par une approche technique pragmatique : il ne s’agit pas simplement de remplacer VMware, mais de construire l’infrastructure de virtualisation la plus adaptée aux besoins réels et à l’évolution future de l’organisation.

🔲 ☆

Comment créer un cluster maître-maître PostgreSQL en natif

Un peu de contexte

PostgreSQL est un système de gestion de base de données relationnelle et objet. Le projet était initialement nommé POSTGRES en référence à la base de données Ingres. Il a démarré en 1985. En 1995, les premières fonctionnalités SQL ont été ajoutées. Le projet sera renommé PostgreSQL l’année suivante.

Logo PostgreSQL

PostgreSQL est un logiciel open source avec sa propre licence PostgreSQL dont le code est hébergé sur le site de PostgreSQL. La dernière version majeure publiée est la version 16. Les versions 12, 13, 14 et 15 sont encore maintenues.

La communauté francophone est très active et compte parmi ses participants l’association PostgreSQLFr. Cette association assure notamment la coordination de la traduction de la documentation et l’hébergement d’un forum qui permet d’échanger à propos de PostgreSQL. Elle fait aussi partie des organisateurs de PGDay France, le rendez-vous annuel de la communauté PostgreSQL.

Chez Worteks nous utilisons PostgreSQL comme base de données de plusieurs applications, en particulier NextCloud et LemonLDAP::NG. Ces applications étant souvent déployées en haute-disponibilité, nous sommes en veille constante sur les possibilités techniques de fonctionnement en cluster de cette base de données.

Dans ce billet de blog, nous allons montrer comment mettre en place un cluster bi-directionnel natif dans PostgreSQL 16. Nous allons utiliser la réplication logique pour créer une configuration maître-maître. L’objectif est d’avoir deux serveurs capables d’accepter des commandes d’écriture.

La version PostgreSQL 16 est sortie le 14 septembre 2023 et sera maintenue jusqu’au 9 octobre 2028. Elle contient de nombreuses améliorations, en particulier concernant la réplication logique qui nous intéresse ici.

La documentation PostgreSQL définit la réplication logique comme “[…] une méthode permettant de répliquer des données au niveau objet ainsi que les modifications apportées à ces objets, ceci basé sur leur identité de réplication (habituellement la clé primaire)”. Elle se différencie de la réplication physique car elle ne copie pas “octet par octet” les données du serveur mais peut juste copier une table ou même une colonne.

La réplication logique par défaut nécessite un serveur éditeur (publisher) et un serveur abonné (subscriber). L’abonné récupère les données publiées par l’éditeur et construit ainsi ses données. La réplication logique est disponible en natif depuis PostgreSQL 10.

Les améliorations citées ci-dessus permettent aujourd’hui de configurer la réplication logique des serveurs dans les deux sens et ainsi d’obtenir deux serveurs maîtres.

Mise en place du cluster PostgreSQL

À la fin de ce tutoriel, nous aurons deux serveurs en cluster avec PostgreSQL installé ainsi qu’un serveur applicatif qui sert à interroger le cluster. Cette troisième machine représentera l’application qui interagit avec la base de données (LemonLDAP, Nextcloud, la station spatiale internationale, etc…). Les adresses IP sont les suivants:

  • Serveur PostgreSQL 1 - premier maître : 192.168.2.24 ;
  • Serveur PostgreSQL 2 - deuxième maître : 192.168.2.65 ;
  • Serveur applicatif: 192.168.2.54

PostgreSQL cluster maitre-maitre

L’installation se fera dans des machines Rocky Linux 8 nouvelles. Toutefois, il suffit d’adapter les commandes pour une distribution de la famille Debian.

L’utilisateur par défaut sera le super-utilisateur root. Lorsqu’il faudra changer d’utilisateur, les instructions l’expliciteront.

Nous allons installer et activer la version 16 de PostgreSQL sur chacun des serveurs :

dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-8-x86_64/pgdg-redhat-repo-latest.noarch.rpm
dnf -qy module disable postgresql
dnf install postgresql16-server -y
/usr/pgsql-16/bin/postgresql-16-setup initdb
systemctl enable postgresql-16
systemctl start postgresql-16

La première commande ajoute les dépôts PostgreSQL. Ces dépôts donnent accès aux versions plus récents de PostgreSQL. La deuxième désactive les modules par défaut de la distribution. Les quatre dernières commandes installent et configurent PostgreSQL. PostgreSQL est activé par défaut, c’est-à-dire qu’il sera actif dès le démarrage du système.

Il faut éditer le fichier de configuration pour permettre l’accès à distance et la réplication logique.

vim /var/lib/pgsql/16/data/postgresql.conf
#--------------------------------------------#
listen_addresses = '*'
wal_level = logical
max_worker_processes = 10

Les valeurs de max_worker_processes, max_replication_slots, max_wal_senders sont à adapter selon le contexte (nombre de cores, utilisation du serveur dédié à PostgreSQL, etc…). Pour plus de détails, il faudra consulter la documentation PostgreSQL .

Il faut aussi éditer le fichier d’accès pour autoriser les connexions distantes :

vim /var/lib/pgsql/16/data/pg_hba.conf
#--------------------------------------------#
# [....]
host    database_test   pgreplication   192.168.2.24/32         scram-sha-256
host    database_test   pgreplication   192.168.2.44/32         scram-sha-256
host    database_test   user_distant    192.168.2.54/24         scram-sha-256

Puis, redémarrer PostgreSQL pour prendre en compte les changements :

systemctl restart postgresql-16.service

Il ne faut pas oublier d’ouvrir le pare-feu et l’écoute sur les ports :

firewall-cmd --permanent --add-service=postgresql
firewall-cmd --reload

Ensuite, il faut configurer les utilisateurs locaux de PostgreSQL. Pour accéder à PostgreSQL en local, nous utilisons la commande suivante :

su - postgres -c psql

Pour ce tutoriel, nous allons créer la base de données database_test et un utilisateur pgreplication pour la réplication. Nous créerons également un utilisateur user_distant pour générer les données fictives et vérifier la réplication.

-- Pour des questions de sécurité
ALTER USER postgres WITH ENCRYPTED PASSWORD 'postgres1';
-- L’utilisateur qui permettra de faire la réplication
CREATE ROLE pgreplication LOGIN REPLICATION PASSWORD 'pgrepuser1';
GRANT ALL ON ALL TABLES IN SCHEMA public TO pgreplication;
-- L'utilisateur pour user_distant
CREATE USER user_distant WITH ENCRYPTED PASSWORD 'user1';
CREATE DATABASE database_test OWNER user_distant;
GRANT ALL PRIVILEGES ON DATABASE database_test TO user_distant;
GRANT ALL PRIVILEGES ON DATABASE database_test TO pgreplication;
\q

Nous allons maintenant créer des données sur le serveur PostgreSQL 1. Nous commencerons par la table test et quelques valeurs. Il est important d’utiliser une clé primaire (PRIMARY KEY) par table. C’est un point à ne pas oublier si ce tutoriel est appliqué à des base de données déjà existantes. La méthode de la réplication logique ne marchera pas sur des tables sans clé primaire :

\c database_test
-- Créer la table.
CREATE TABLE table_test (
    id integer PRIMARY KEY GENERATED BY DEFAULT AS IDENTITY,
    title varchar(40) NOT NULL,
    name  varchar(40) NOT NULL);
-- Peupler la table.
INSERT INTO table_test VALUES    
    ('001', 'El ultimo lector', 'Toscana'),
    ('002', 'Le Comte de Monte-Cristo', 'Dumas'),
    ('003', 'Ulysse', 'Joyce');
-- Création de la publication de la table
CREATE PUBLICATION publication_test1 FOR ALL TABLES;

Pour le serveur PostgreSQL 2, nous allons d’abord l’abonner au serveur PostgreSQL 1. Une fois cette abonnement validé, nous ferons l’abonnement dans le sens inverse pour avoir la configuration bi-directionnelle.

Les pré-requis qui permettent de s’abonner à une table ou base de données sont les schémas. Ici nous utilisons une base vide, la marche à suivre pour copier les schémas d’une base de données déjà existante est expliquée dans la section Extra. Dans notre cas, nous créons la table dans le deuxième serveur puis nous nous y abonnons.

\c database_test
-- Peupler la table.
CREATE TABLE table_test (
    id integer PRIMARY KEY GENERATED BY DEFAULT AS IDENTITY,
    title varchar(40) NOT NULL,
    name  varchar(40) NOT NULL);
-- Premier abonné
CREATE SUBSCRIPTION subscription_au_serveur1
    CONNECTION 'host=192.168.2.24 port=5432 user=pgreplication dbname=database_test password=pgrepuser1'
    PUBLICATION publication_test1
    WITH (copy_data=true, origin=none);
-- Subscription de l'abonné
CREATE PUBLICATION publication_test2 FOR ALL TABLES;

L’abonné se connecte à la base de données distante avec l’utilisateur pgreplication. Ensuite, il écrit les modifications via le propriétaire de la subscription. Le propriétaire est par défaut l’utilisateur qui a créé la subscription. Il faut s’assurer que cet utilisateur ait des droits suffisants, notamment le privilège pg_create_subscription. Par défaut, il s’agit de l’utilisateur postgres.

PostgreSQL cluster maitre-maitre

Le secret de la réplication logique bi-directionnelle est dans l’avant dernière ligne : WITH (copy_data=true, origin=none);. Cette ligne contient les paramètres de la subscription.

L’option copy_data=true défini si le serveur importera les données existantes dans l’éditeur lors de la première connexion. Pour ce premier abonnement, nous souhaitons peupler la table. Toutefois, lors de l’abonnement du serveur PostgreSQL 1 vers PostgreSQL 2, nous le désactiverons.

Finalement, le paramètre origin=none indique à l’éditeur de ne pousser que les changements qui n’ont pas d’origine. Le valeur par défaut est any, dans ce cas l’éditeur pousse tous les changements, quelque soit l’origine. Dans le cas d’une réplication bi-directionnelle cette option produit une boucle nommée transactional loopback. En d’autres termes, les modifications poussées par l’éditeur seront répercutés vers lui, créant ainsi une boucle infinie et donc une erreur.

La réplication peut être vérifiée en cherchant les entrées créées dans le PostgreSQL 1 sur le serveur PostgreSQL 2.

SELECT * FROM table_test;
id |          title           |  name   
----+--------------------------+---------
 1 | El ultimo lector         | Toscana
 2 | Le Comte de Monte-Cristo | Dumas
 3 | Ulysse                   | Joyce
(3 rows)

Pour finir, nous nous abonnons depuis le serveur PostgreSQL 1 au serveur PostgreSQL 2 :

\c database_test
-- Deuxième abonné
CREATE SUBSCRIPTION subscription_au_serveur2
    CONNECTION 'host=192.168.2.44 port=5432 user=pgreplication dbname=database_test password=pgrepuser1'
    PUBLICATION publication_test2
    WITH (copy_data=false, origin=none);

Vérification de la réplication entre les deux serveurs

La vérification la plus simple et directe est de suivre les différentes modifications dans les tables, par exemple via un SELECT * FROM table_test;. Les logs de PostgreSQL permettent aussi de savoir si la réplication existe.

Il existe des étapes intermédiaires qui permettent de déboguer en cas de problèmes. Les étapes de la réplication logique sont :

  • L’envoi des WAL de l’éditeur
  • La réception côté abonné puis leur application

Pour vérifier au niveau de l’éditeur, le process walsender doit exister:

ps aux | grep walsender

Il est aussi possible de vérifier la réplication depuis psql:

su - postgres -c psql
\x
SELECT * FROM pg_stat_replication;

Pour l’abonné, la vérification de la réception se fait via les process du système d’exploitation soit via psql :

ps aux | grep 'logical replication'
su - postgres -c psql
\x
SELECT * FROM pg_stat_subscription;

Limites de la méthode

La réplication logique bi-directionnelle est une méthode très intéressante et assez utile. Toutefois, cela n’est pas toujours la méthode adéquate ou optimale.

Il est important de savoir que la méthode à besoin d’une supervision ou au minimum d’un checkup régulier. En effet, lorsqu’un des abonnés rencontre une erreur, la réplication s’arrête. Dans ce cas, il faudra regarder les logs. Ces conflits sont abordés dans la documentation sous la section 31.5.Conflits. Par exemple, lorsque la clé primaire est dupliquée en local et à distance :

024-04-24 12:14:59.993 CEST [4973] ERROR:  duplicate key value violates unique constraint "table_test_pkey"
2024-04-24 12:14:59.993 CEST [4973] DETAIL:  Key (id)=(1) already exists.
2024-04-24 12:14:59.993 CEST [4973] CONTEXT:  processing remote data for replication origin "pg_16399" during message type "INSERT" for replication target relation "public.table_test" in transaction 816, finished at 0/1A09DB0
2024-04-24 12:14:59.994 CEST [2731] LOG:  background worker "logical replication worker" (PID 4973) exited with exit code 1

Cela peut se produire régulièrement si la clé primaire est incrémentale, par exemple si les deux serveurs sont sollicités en même temps.

Il faut donc envisager les erreurs et les prévenir. Il faut aussi pouvoir les repérer quand elles arrivent et les corriger avant que ce ne soit trop tard.

Conclusion

PostgreSQL continue de s’améliorer. Par exemple, en dix ans, la latence à été divisée par deux !. Toutefois, de grands pouvoirs impliquent de grandes complexités ! PostgreSQL n’est pas le logiciel le plus simple à prendre en main lors de sa première utilisation. Mais grâce à la liberté des outils Open Source nous pouvons partager nos connaissances, comme ce tutoriel, pour que vous puissiez créer votre cluster le plus facilement possible. Chez Worteks nous utilisons PostgreSQL et nous souhaitons que vous puissiez l’utiliser aussi.

N’oubliez pas de consulter la documentation qui est très complète en français !

Merci pour votre lecture.

Extra

Pour ce tutoriel, nous avons pris le cas le plus simple : une architecture pensée dès le début en mode cluster maître-maître. En effet, il est toujours plus simple de partir de zéro plutôt que de s’adapter à l’existant. Malheureusement, ce n’est pas toujours possible.

Dans le cas où la base de données existe déjà mais pas en mode cluster, la deuxième base de données doit être initialisée avec le schéma de la première base. Pour ce faire, nous devons dumper la base et l’ajouter dans le deuxième serveur. Voici un exemple d’application :

pg_dumpall --schema-only --dbname 'host=localhost dbname=database_test user=user_distant' > db_structures.out
scp  db_structures.out rocky@192.168.2.65:

Ensuite, nous devons importer ce fichier dans la deuxième base de données :

mv [path/to/file]/db_structures.out /var/lib/pgsql/
chown postgres:postgres /var/lib/pgsql/db_structures.out
su - postgres -c 'psql < db_structures.out 2> /tmp/errors.log'
# Verifier s'il y a eu des erreurs lors de la création du schema
cat /tmp/errors.log
# Seulement l'erreur suivant devrait apparaître
ERROR:  role "postgres" already exists

Sources

☑️ ☆

Mettre en place l’architecture GlobalScale afin de fluidifier votre NextCloud

Introduction

La formule standard de NextCloud est utile pour bien des usages. Cependant, lorsque la volumétrie des utilisateurs évolue et que l’on arrive à des usages plus intenses de NextCloud, on se rend vite compte des limites de ce service. Dans ce cas, on se retrouve confronté à une problématique de taille, à savoir gérer la quantité d’utilisateurs tout en limitant les coûts. C’est là qu’intervient l’offre GlobalScale de NextCloud.

À l’heure où ces lignes sont rédigées il existe peu de documentation sur le sujet. Nous allons tenter de combler ensemble ce manque avec cet article.

GlobalScale permet de répartir la charge du trafic et donc de gérer une utilisation plus intense de NextCloud. Cela aide énormément lorsque l’on veut utiliser NextCloud dans un cadre professionnel à grande échelle ou lorsque l’on en a une utilisation avancée comme par exemple la mise en place de nombreux plugins ou le stockage de fichiers volumineux.

Points importants

Attention: Cette installation a été réalisée sous NextCloud version 20, nous ne pouvons confirmer la validité de cette procédure pour les versions ultérieures.

Dans cet article, nous nous attarderons seulement sur la mise en place de la partie GlobalScale, nous considérerons que vos serveurs Linux sont déjà en place et que les produits de base sont déjà installés.

Les points suivants ne seront pas traités ici :

  • l’adressage IP
  • le dimmensionnement des serveurs
  • l’installation de l’OS
  • la mise en place d’un Reverse Proxy
  • La gestion des certificats
  • la mise en place des bases de données
  • la supervision ou la métrologie
  • la haute disponibilité

Caractéristiques de l’architecture GlobalScale

Pour la mise en place de cette architecture, nous aurons besoin basiquement pour la partie NextCloud :

  • d’un serveur primaire NextCloud, qui servira de relai pour rediriger l’utilisateur vers le serveur où sont situées ses données/son espace personnel.
  • d’un ou plusieurs serveurs secondaires sur lesquels nous allons répartir les données de nos utilisateurs, c’est en cela que réside la particularité de cette architecture et qui va permettre d’éviter les goulots d’étranglement.
  • un Lookup server qui sera le serveur interrogé pour rediriger les utilisateurs vers le serveur secondaire sur lequel ils disposent d’un espace personnel.

architecture

Évidemment pour pouvoir identifier nos clients il est nécessaire d’inclure dans cette architecture un portail d’authentification Single Sign-On (SSO) ou un serveur LDAP.

Voici la nomenclature qui sera utilisée :

Nom Rôle Application
nextcloud1.app.domain.com Nextcloud Primaire Nextcloud verison 20
nextcloud2.app.domain.com Nextcloud Secondaire Nextcloud version 20
nextcloud3.app.domain.com Nextcloud Secondaire Nextcloud version 20
ls.app.domain.com Lookup Server Nextcloud version 20
keycloak.app.domain.com WebSSO Keycloak
collabora.domain.com Édition Collaborative Collabora Online

Commençons l’installation !

Installation

Prérequis

Dans notre contexte, voici comment va se présenter notre architecture :

  • les différents nœuds NextCloud,
  • OpenLDAP afin de centraliser les comptes et les informations utilisateurs,
  • Keycloak comme WebSSO s’appuyant sur l’annuaire LDAP pour l’authentification des utilisateurs,
  • Collabora Online, un outil collaboratif open-source basé sur LibreOffice Online.

Remarque: Dans le cadre d’une mise en production, nous pourrions intégrer à cette architecture un serveur REDIS pour les caches de sessions mais cela ne sera pas abordé dans cet article.

L’annuaire OpenLDAP

Dans notre architecture, nous allons nous servir d’OpenLDAP pour centraliser les utilisateurs et faciliter la gestion de leurs données.

Chaque utilisateur disposera de sa fiche qui sera présentée comme ceci:

  • cn : nom d’affichage (prénom / nom)
  • sn : nom de famille
  • givenName : prénom
  • mail : adresse mail
  • nclocator : URL Nextcloud vers ses données
  • uid : uid
  • userPassword : mot de passe utilisateur

Exemple :

cn: John DOE
sn: DOE
givenName: John
mail: john.doe@example.com
nclocator : https://nextcloud-2.example.com/
uid : jdoe
userPassword : $HASH$

Keycloak va s’appuyer sur ces fiches afin de gérer les authentifications des clients et gérer efficacement les accès aux espaces personnels de chacun.

Le WebSSO Keycloak

Afin que notre outil de SSO (Single Sign-On) puisse accéder à l’annuaire LDAP pour l’authentification des utilisateurs, il est nécessaire de définir un nouveau fournisseur LDAP comme suit :

Configuration de la Fédération d’utilisateurs

Après avoir défini le nouveau fournisseur, il est nécessaire de faire correspondre les attributs de l’annuaire avec ceux des utilisateurs qui vont être stockés dans Keycloak et qui pourront être transmis aux applications clientes :

LISTE DES ATTIBUTS RÉCUPÉRÉS DU LDAP

Voici la configuration à adopter pour chaque attribut :

LAST NAME

PRENOM

NCLOCATOR

NOM UTILISATEUR

EMAIL

Une fois le mappage terminé, nous allons configurer la partie SAML et définir le noeud principal en tant que client :

Configuration SAML du Nextcloud primaire

Enfin il faut lui donner les éléments que l’on vient de définir pour lui permettre de s’en servir durant la connexion.

ATTRIBUTS TRANSMITS PAR SAML

Que l’on va définir commme ceci :

EMAIL

ROLES

NCLOCATOR

UID

Une fois toutes ces configurations faites, nous pouvons passer à la configuration du noeud primaire NextCloud.

Nextcloud Primaire

En premier lieu, nous devons modifier les Content Security Policy afin de permettre aux instances d’utiliser les iframes d’une instance à une autre. Vous devrez trouver le fichier .php au chemin suivant :

~/lib/public/AppFramework/Http/ContentSecurityPolicy.php

Voici à quoi ressemble notre fichier de conf après modification :

~# cat ./lib/public/AppFramework/Http/ContentSecurityPolicy.php
...
 protected $allowedFrameDomains = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];

 protected $allowedFrameAncestors = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];`

Ensuite il faut commenter les options du X-Frame dans le .htaccess pour autoriser les autres origines :

~# cat .htaccess
# Header always set X-Frame-Options "SAMEORIGIN"`

Du côté de NextCloud, la partie SAML doit être configurée comme ceci :

Authentication SAML Authentication SAML 2

Voici un extrait du config.php modifié pour GlobalScale :

~# cat config/config.php
<?php
$CONFIG = array (
<...>
 'overwriteprotocol' => 'https',
 'overwritehost' => 'nextcloud1.app.domain.com',
<...>
 'overwritewebroot' => '/',
 'trusted_domains' =>
 array (
 0 => 'nextcloud1.app.domain.com',
 1 => 'nextcloud2.app.domain.com',
 2 => 'nextcloud3.app.domain.com',
 ),
 'datadirectory' => '/var/www/nextcloud/data',
 'lookup_server' => 'https://ls.app.domain.com',
<...>
 'overwrite.cli.url' => 'https://nextcloud1.app.domain.com/nextcloud',
<...>
 'app_install_overwrite' =>
 array (
 0 => 'globalsiteselector',
 ),
 'gss.jwt.key' => 'XXXXX',
 'gss.mode' => 'master',
 'gss.master.admin' =>
 array (
 0 => 'admin',
 ),
 'gs.enabled' => true,
 'gss.user.discovery.module' => '\\OCA\\GlobalSiteSelector\\UserDiscoveryModules\\UserDiscoverySAML',
 'gss.discovery.saml.slave.mapping' => 'nclocator',
<...>
);

NextCloud Secondaire

Comme pour le noeud primaire, vous devez modifier les CSP afin d’autoriser l’utilisation des iframes d’une instance à une autre comme ceci :

protected $allowedFrameDomains = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];
 protected $allowedChildSrcDomains = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];
 protected $allowedFrameAncestors = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];

Il est impératif de commenter la ligne suivante dans le .htaccess comme pour le noeud primaire :

~# cat .htaccess
#Header always set X-Frame-Options "SAMEORIGIN"

Contrairement au nœud primaire, les nœuds secondaires doivent être connectés à un annuaire LDAP pour les informations utilisateurs avec un filtre correspondant aux utilisateurs uniquement de cette instance :

LDAP - Page Server

On va ensuite créer un filtre correspondant au nclocator du GlobalScale :

Configuration LDAP - Page Users

Pour le reste, ça reste une configuration classique :

Page Login Attributes

Dans l’onglet Avancé, nous désactiverons la pagination des recherches dans l’annuaire :

Onglet Avancé

Pour simplifier la lecture entre SAML et LDAP, nous avons fait correspondre l’uid de l’utilisateur :

Onglet Expert

Voici un extrait du fichier config.php correspondant aux modifications pour le GlobalScale pour une instance secondaire :

~# cat config/config.php
<?php
$CONFIG = array (
<...>
 'trusted_domains' =>
 array (
 0 => 'nextcloud3.app.domain.com',
 1 => 'nextcloud2.app.domain.com',
 2 => 'nextcloud1.app.domain.com',
 ),
<...>
 'overwrite.cli.url' => 'https://nextcloud2.app.domain.com',
 'installed' => true,
 'app_install_overwrite' =>
 array (
 0 => 'globalsiteselector',
 ),
<...>
 'overwritewebroot' => '/',
 'overwriteprotocol' => 'https',
 'gss.mode' => 'slave',
 'gss.discovery.saml.slave.mapping' => 'nclocator',
 'lookup_server' => 'https://ls.app.domain.com',
 'gss.jwt.key' => 'XXXXXXXX',
 'gss.master.url' => 'https://nextcloud1.app.domain.com/',
<...>
);

Lookup Server

Voici à quoi ressemble le fichier de configuration par défaut :

# cat config/config.php
<?php
// Lookup-Server Config
$CONFIG = [
<...>
 // max user search page. limit the maximum number of pages to avoid scraping.
 'MAX_SEARCH_PAGE' => 100,
 // max requests per IP and 10min.
 'MAX_REQUESTS' => 100000,
 // credential to read the replication log. IMPORTANT!! SET TO SOMETHING SECURE!!
 'REPLICATION_AUTH' => 'XXXXXX',
 // credential to read the slave replication log. Replication slaves are read only and don't get the authkey.
IMPORTANT!! SET TO SOMETHING SECURE!!
 'SLAVEREPLICATION_AUTH' => 'YYYYYYYYYYY',
 // the list of remote replication servers that should be queried in the cronjob
 'REPLICATION_HOSTS' => [],
 // ip black list. usefull to block spammers.
 'IP_BLACKLIST' => [],
 // spam black list. usefull to block spammers.
 'SPAM_BLACKLIST' => [
 ],
 // Email sender address
 'EMAIL_SENDER' => 'www@ttttt.com',
 // Public Server Url
 'PUBLIC_URL' => 'https://ls.app.domain.com',
 // does the lookup server run in a global scale setup
 'GLOBAL_SCALE' => true,
 // auth token
 'AUTH_KEY' => 'ZZZZZZZZZ'
 'TWITTER' => [
 'CONSUMER_KEY' => '',
 'CONSUMER_SECRET' => '',
 'ACCESS_TOKEN' => '',
 'ACCESS_TOKEN_SECRET' => '',
 ],
];

Remarque: La partie Twitter est nécessaire mais peut rester vide.

Durant l’exécution du cron.php de NextCloud, les utilisateurs sont créés via une requête LDAP et sont injectés dans la base de données du Lookup Server comme suit :

MariaDB [lookup]> select * from users where federationId like 'user%' ;
+------+-----------------------------------------+---------------------+
| id | federationId | timestamp |
+------+-----------------------------------------+---------------------+
| 2555 | user1@nextcloud2.app.domain.com | 2021-03-03 17:14:14 |
| 24 | user10@nextcloud2.app.domain.com | 2021-03-03 14:36:07 |
| 2643 | user100@nextcloud2.app.domain.com | 2021-03-03 17:14:56 |
| 544 | user1000@nextcloud2.app.domain.com | 2021-03-03 15:42:14 |
| 1048 | user100001@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1049 | user100002@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1050 | user100003@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1051 | user100004@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1052 | user100005@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1053 | user100006@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1054 | user100007@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1055 | user100008@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1056 | user100009@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1057 | user100010@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1058 | user100011@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1059 | user100012@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
…
| 3028 | user490@nextcloud2.app.domain.com | 2021-03-03 17:17:52 |
| 3029 | user491@nextcloud2.app.domain.com | 2021-03-03 17:17:53 |
| 3030 | user492@nextcloud2.app.domain.com | 2021-03-03 17:17:53 |
| 3031 | user493@nextcloud2.app.domain.com | 2021-03-03 17:17:54 |
| 3032 | user494@nextcloud2.app.domain.com | 2021-03-03 17:17:54 |
| 3033 | user495@nextcloud2.app.domain.com | 2021-03-03 17:17:54 |
| 3034 | user496@nextcloud2.app.domain.com | 2021-03-03 17:17:55 |
| 3035 | user497@nextcloud2.app.domain.com | 2021-03-03 17:17:55 |
| 3036 | user498@nextcloud2.app.domain.com | 2021-03-03 17:17:56 |
| 3037 | user499@nextcloud2.app.domain.com | 2021-03-03 17:17:56 |
| 3038 | user500@nextcloud2.app.domain.com | 2021-03-03 17:17:57 |
+------+---------------------------------------------+---------------------+

On peut alors constater les requêtes de mise à jour via l’API du Lookup Server depuis toutes les instances :

ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:57 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:57 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"

Collabora

La spécificité de notre configuration de Collabora ici est qu’elle doit permettre le partage d’iframe d’un NextCLoud à un autre. Pour ce faire, nous allons alors fixer les adresses pouvant utiliser cette option dans notre fichier loolwsd.xml :

~# cat /etc/loolwsd/loolwsd.xml
<...>
 <frame_ancestors desc="Specify who is allowed to embed the LO Online iframe (loolwsd and WOPI host are
always allowed). Separate multiple hosts by space.">https://nextcloud*\.app\.domain\.com</frame_ancestors>
<...>
 <host desc="Regex pattern of hostname to allow or deny." allow="true">nextcloud1\.app\.domain\.com</host>
 <host desc="Regex pattern of hostname to allow or deny." allow="true">nextcloud2\.app\.domain\.com</host>
 <host desc="Regex pattern of hostname to allow or deny." allow="true">nextcloud3\.app\.domain\.com</host>
<...>
 <host desc="Hostname to allow" allow="true">nextcloud1\.app\.domain\.com</host>
 <host desc="Hostname to allow" allow="true">nextcloud2\.app\.domain\.com</host>
 <host desc="Hostname to allow" allow="true">nextcloud3\.app\.domain\.com</host>
<...>
~# systemctl restart loolwsd

Après redémarrage du service, les serveurs NextCloud peuvent désormais ouvrir des accès à leur instance aux autres.

Attention : Pour l’exemple, nous déployons un seul Collabora unique pour tous nos serveurs NextCloud, cependant il est tout à fait possible de les séparer pour que chaque serveur possède un Collabora qui lui est propre.

Cas d’usage

Maintenant que vous avez terminé l’installation de GlobalScale, voici quelques cas d’usage pour Nextcloud.

Tester son installation

Afin de tester notre architecture, nous allons procéder de la façon suivante :

  1. Nous allons d’abord nous rendre sur l’URL du noeud primaire https://nextcloud1.app.domain.com puis nous nous authentifions :

Auth SSO

  1. Si tout se passe bien, nous sommes alors redirigé vers le noeud secondaire :

Redir_SSO

Partager un fichier

Sur NextCloud, nous avons 2 solutions pour partager un fichier : soit via le mail de notre collaborateur, soit via son nom.

share mail

share name

Conclusion

Félicitations ! Si vos tests ont réussi alors vous avez désormais une architecture NextCloud GlobalScale.

Il est important de noter que la disposition mise en place dans ce tutoriel n’est qu’un exemple et reste ajustable selon vos besoins.

Voici ci-après une liste de liens utiles concernant la documentation des différents éléments mise en place dans ce tutoriel.

Liens utiles

Produit URL
NextCloud https://nextcloud.com/
NextCloud config.php https://docs.nextcloud.com/server/stable/admin_manual/
Lookup Server https://github.com/nextcloud/lookup-server
RichDocuments https://github.com/nextcloud/richdocuments
User SAML https://github.com/nextcloud/user_saml
Global Site Selector https://github.com/nextcloud/globalsiteselector
KeyCloak https://www.keycloak.org/
Openldap https://www.openldap.org/
🔲 ☆

Diffuser votre conférence Jitsi sur Peertube

Dans cet article, nous allons détailler les différentes étapes pour réussir à diffuser votre conférence Jitsi sur Peertube.

1. Pourquoi ?

C’est sans doute la question la plus importante, pourquoi vouloir diffuser une conférence Jitsi au plus grand nombre, pourquoi passer par Peertube ?

D’abord on parle ici de diffusion en direct (ou streaming pour nos amis anglophiles) et non de rediffusion (donc du contenu enregistré et remis à la disposition du plus grand nombre après).

Ensuite nous parlons ici d’outils Open Source. Que ce soit Jitsi ou Peertube, ce sont des projets disponibles au public sans restriction, que tout le monde peut mettre en place sur un serveur et adapter à ses besoins (ce point là est particulièrement important). Il existe des alternatives propriétaires : Zoom, Twitch, Youtube, mais qui sont toutes la propriété de grands groupes et ne vous donnent que peu de marge de manoeuvre et surtout vont vouloir monétiser d’une façon ou d’une autre leur bande passante, stockage ou utilisation de serveur.

Le cas de figure classique va être une conférence avec quelques intervenants (qui sont physiquement à des endroits différents, de deux à dix intervenants par exemple) et une audience massive (plusieurs centaines / milliers de spectateurs).

La première solution va être de mettre tout le monde sur Jitsi… plusieurs milliers d’utilisateurs dont seulement quelques-uns vont avoir la parole semble vain, mais surtout va mettre à mal votre infrastructure (aussi bien le réseau que vos serveurs).

Le principe est donc ici de mettre en place une conférence relativement classique via Jitsi et de la diffuser massivement via Peertube. On limite ainsi aussi bien la bande passante, vos serveurs, mais on peut aussi mettre en place un replay pour les personnes qui auraient raté la conférence.

2. Jitsi c’est quoi ?

Jitsi est une solution Open Source de conférence, incluant audio et vidéo.

Pour faire court, c’est une alternative à d’autres solutions de conférence propriétaires comme Zoom. Elle va donc vous permettre de mettre en place des conférences privées ou publiques. Pour installer Jitsi, je vous conseille de suivre ce lien : Guide de démarrage

3. Peertube c’est quoi ?

Peertube est une solution Open Source d’hébergement et de diffusion de vidéo, un peu comme Youtube mais avec quelques fonctionnalités intéressantes, comme la fédération (le fait de pouvoir distribuer des vidéos sur différentes instances de Peertube, une sorte de redondance des vidéos si on veut), le partage de la bande passante entre clients via Peer to Peer, etc.

Cet outil va donc vous permettre d’héberger vos vidéos, mais ici surtout elle vous permettra de diffuser en direct (ou streamer) du contenu au plus grand nombre.

Pour installer Peertube, je vous conseille le lien suivant : Guide d’installation

4. La mise en place

Avant de pouvoir diffuser vos conférences Jitsi, il vous faudra installer différents éléments comme Jibri, Jicofo, Chromium, FFmpeg, Java8, … Voyons ensemble comment les mettre en place.

Configurer Jitsi et permettre à Jibri de se connecter et “participer” aux conférences vidéos

Quelques définitions:

  • Prosody - serveur XMPP qui permet à tous les composants de se connecter les uns aux autres : web, jicofo, jvb et tous les autres composants
  • Jicofo - service qui s’occupe de répartir les processus entre les participants à la conférence et le bridge video
  • Jitsi (ou Jitsi Meet) - service maître, visible, qui affiche les fonctionnalités à l’écran

Configurer Prosody

nano /etc/prosody/prosody.cfg.lua

Enlever les commentaires dans la section “conference”

---Set up a MUC (multi-user chat) room server on conference.example.com:
Component "conference.jitsi.example.com" "muc"
--- Store MUC messages in an archive and allow users to access it
modules_enabled = { "muc_mam" }

Créer une entrée dans le composant MCU interne. Indispensable pour que Jicofo puisse trouver des clients Jibri sur une MCU qui n’est pas accessible en externe.

Créez une entrée dans votre vhost pour le compte de session chrome de Jibri

A ajouter donc pour se “logger” sur le serveur jitsi

nano /etc/prosody/conf.avail/meet.worteks.com.cfg.lua

A la fin du fichier

-- internal muc component, meant to enable pools of jibri and jigasi clients
Component "internal.auth.meet.worteks.com" "muc"
    modules_enabled = {
	    "ping";
    }
    storage = "memory"
    muc_room_cache_size = 1000

VirtualHost "recorder.meet.worteks.com"
    modules_enabled = {
        "ping";
    }
    authentication = "internal_plain"

Recharger Prosody

systemctl reload prosody

Et on ajoute deux comptes sur Jibri (un pour le contrôle et un pour l’enregistrement)

prosodyctl register jibri auth.meet.worteks.com JibrisPass
prosodyctl register recorder recorder.meet.Worteks.com RecordersPass

Configurer Jicofo

Faire pointer le MCU vers les controllers Jibri

nano /etc/jitsi/jicofo/sip-communicator.properties

Ajouter ces deux lignes pour la salle de contrôle Jibri et le timeout

org.jitsi.jicofo.jibri.BREWERY=JibriBrewery@internal.auth.meet.worteks.com
org.jitsi.jicofo.jibri.PENDING_TIMEOUT=90

On recharge Jicofo

systemctl reload Jicofo

Configurer Jitsi Meet

S’assurer qu’il existe un bouton pour enregistrer et diffuser dans la configuration

nano /etc/jitsi/meet/meet.worteks.com-config.js

Utiliser les adresses ip plus que les noms de domaines pour la connection Bosh

Configuration par défaut avec nom de domaine

bosh: '//meet.worteks.com/http-bind'

Changé en

bosh: '//192.168.10.10/http-bind'

Et ajouter les propriétés suivantes

fileRecordingsEnabled: true, // If you want to enable file recording
liveStreamingEnabled: true, // If you want to enable live streaming
hiddenDomain: 'recorder.meet.worteks.com',

Installer Jibri

Pré-requis

ALSA et LoopBack Device

  • Assurez vous que le module Loopback Device est disponible. Ces modules peuvent être installés sur une Ubuntu 20.04 en utilisant le nom de paquet linux-image-extra-virtual
  • Faites les tâches suivantes en tant que root:
    • mettre le module au démarrage echo "snd-aloop" >> /etc/modules
    • charger le module dans le kernel modprobe snd-aloop
    • vérifier que le module est déjà chargé lsmod | grep snd_aloop
  • Si la sortie montre que le module snd_aloop est chargé, la configuration est finie.

FFmpeg et le support de X11 capture

Jibri requiert une version relativement moderne de FFmpeg avec le support x11 compilé dedans. Ceci est fait par défaut sur Ubuntu 16.04/18.04/20.04 en installant le package ffmpeg. Pour les versions précédentes c’est un peu plus complexe (et on n’abordera pas le sujet ici).

Autres paquets

sudo apt-get install wget gnupg software-properties-common default-jre-headless  curl alsa-utils icewm xdotool xserver-xorg-input-void xserver-xorg-video-dummy

Installer Google Chrome

curl -o - https://dl-ssl.google.com/linux/linux_signing_key.pub | apt-key add
echo "deb [arch=amd64] http://dl.google.com/linux/chrome/deb/ stable main" > /etc/apt/sources.list.d/google-chrome.list
apt update
apt install google-chrome-stable

Installer Chrome Driver

CHROME_DRIVER_VERSION=`curl -sS chromedriver.storage.googleapis.com/LATEST_RELEASE`
wget -N http://chromedriver.storage.googleapis.com/$CHROME_DRIVER_VERSION/chromedriver_linux64.zip -P ~/
unzip ~/chromedriver_linux64.zip -d ~/
rm ~/chromedriver_linux64.zip
sudo mv -f ~/chromedriver /usr/local/bin/chromedriver
sudo chmod 0755 /usr/local/bin/chromedriver

Enlever les alertes de contrôle de script dans Chrome

mkdir -p /etc/opt/chrome/policies/managed

echo '{ "CommandLineFlagSecurityWarningsEnabled": false }' >>/etc/opt/chrome/policies/managed/managed_policies.json

Installer Jibri (enfin !)

Il s’installe sur le même serveur que Jitsi

sudo apt-get install jibri

Ajouter Jibri dans les bons groupes

sudo usermod -aG adm,audio,video,plugdev jibri

Configurer Jibri

Nous allons installer les paquets nécessaires depuis le repository par défaut des Debian 10. Nous allons configurer l’environnement XMPP et l’endroit où vont être stockés les enregistrements

On ouvre donc le fichier de configuration

nano /etc/jitsi/jibri/config.json

Avec les options suivantes

{
    "recording_directory":"/srv/recordings",
    "finalize_recording_script_path": "/path/to/finalize_recording.sh",
    "xmpp_environments": [
        {
            "name": "prod environment",
            "xmpp_server_hosts": [
                "meet.worteks.com"
            ],
            "xmpp_domain": "meet.worteks.com",
            "control_login": {
                // The domain to use for logging in
                "domain": "auth.meet.worteks.com",
                // The credentials for logging in
                "username": "jibri",
                "password": "JibrisPass"
            },
            "control_muc": {
                "domain": "internal.auth.meet.worteks.com",
                "room_name": "JibriBrewery",
                "nickname": "jibri-nickname"
            },
            "call_login": {
                "domain": "recorder.meet.worteks.com",
                "username": "recorder",
                "password": "RecordersPass"
            },
            "room_jid_domain_string_to_strip_from_start": "conference.",
            "usage_timeout": "0"
        }
    ]
}

Code Jibri (disponible ici)

/src/main/kotlin/org/jitsi/jibri/selenium/JibriSelenium.kt

Changer le code pour accepter des certificats non sécurisés ou auto-signés

chromeOptions.addArguments("--ignore-certificate-errors")

chromeOptions.setAcceptInsecureCerts(true)

URL RTMP

src/main/kotlin/org/jitsi/jibri/service/impl/StreamingJibriService.kt

const val YOUTUBE_URL = "rtmp://zb01.lmt.glcx.cnpc:1935/myapp"

On compile le code de Jibri

mvn package -DskipTests

Après sa compilation on remplace l’ancien fichier jar par le nouveau

sudo /opt/jibri/target/jibri-8.0-Snapshot-with-dependies.jar /opt/jitsi/jibri

On recharge Jibri

systemctl reload jibri

On crée le répertoire pour les enregistrements et on lui donne les droits

mkdir /recordings
chown jibri:jibri /recordings

Installer Java 8 et configuration par défaut pour Jibri

Installer Java 8

wget -O - https://adoptopenjdk.jfrog.io/adoptopenjdk/api/gpg/key/public | sudo apt-key add -
add-apt-repository https://adoptopenjdk.jfrog.io/adoptopenjdk/deb/
apt update
apt install adoptopenjdk-8-hotspot

Ouvrir launch.sh

nano /opt/jitsi/jibri/launch.sh

Mettre Java8 par défaut pour Jibri au lieu de du java par défaut, remplacer le mot “java” par le chemin vers Java 8

/usr/lib/jvm/adoptopenjdk-8-hotspot-amd64/bin/java

Redémarre tous les services, mettre dispo et démarrer Jibri

systemctl restart prosody
systemctl restart jicofo
systemctl restart jitsi-videobridge2
systemctl enable --now jibri

5. La diffusion

Maintenant que tout le setup un peu fastidieux a été fait, il est temps de mettre en place les éléments sur les deux logiciels utilisés, c’est à dire Jitsi pour la conférence et Peertube pour la diffusion.

Peertube

La première étape va être de mettre en place la session live, le streaming si vous voulez sur Peertube.

Cliquez sur “Publier” (le bouton en haut à droite) et sélectionnez la tabulation “aller au direct”

Création du direct Peertube

Sélectionnez les options appropriées et cliquez sur “Aller au direct”

Sur la page suivante, cliquez sur la tabulation “Paramètres du direct”

Paramètres du direct Peertube

Vous avez accès aux informations de diffusion, en particulier l’url RTMP du direct ainsi que la clef de diffusion qui vous seront utiles dans l’étape suivante, copiez ces données temporairement quelque part.

Jitsi Meet

Sur votre session Jitsi, créez une conférence, invitez les personnes dont vous avez besoin pour votre diffusion/conférence, réglez l’audio, la vidéo, toutes ces choses qui feront de votre conférence un intérêt pour le public.

Diffusion en direct Jitsi

Dans les options, une nouvelle option est apparue “Démarrer la diffusion en direct”

Diffusion en direct Jitsi

Vous pouvez rentrer vos informations l’url RTMP vers votre Peertube ainsi que la clef de diffusion

Concaténez votre URL comme rtmp://peertube.olicha:1935/live avec un slash / suivi de votre clef de diffusion

url et clef de diffusion

Cliquez sur “Démarrer la diffusion en direct” et voilà votre conférence est visible par tous

6. Et après?

Vous n’avez pas de Jitsi ou Peertube disponible et installé et cherchez une solution OpenSource pour diffuser au plus grand nombre ?

Il existe des alternatives comme BBB qui peuvent vous permettre de faire ça… mais ce sera pour un autre article !

🔲 ☆

Utiliser le logiciel Mailtrain pour ses campagnes de communication

Présentation

Chez Worteks, nous souhaitons utiliser le maximum de logiciel libre dans notre activité quotidienne, et nous cherchions un remplaçant à MailChimp avec lequel nous gérions nos envois de lettres d’informations jusque fin 2022. Après plusieurs recherches et essais, nous avons opté pour Mailtrain.

Logo Mailtrain

Mailtrain est un logiciel libre (licence GPL v3.0) permettant de gérer ses campagnes de communication par mail. Comme ses principaux concurrents il propose les fonctionnalités attendues de ce type d’outil :

  • Liste de contact avec possibilité d’inscription et de désinscription
  • Modèle de lettre (template)
  • Campagne d’envoi, avec statistiques de consultation des mails et des ouvertures des liens

Un des manques actuels est sans nul doute la documentation utilisateur : il faut consacrer un certain temps à la prise en main de l’interface avant de pouvoir réussir sa première campagne. Cet article sera une de nos façons de contribuer à réduire ce manque, nous espérons qu’il vous sera utile !

Installation

L’installation du logiciel est assez facile et bien documentée (voir le fichier README.md du dépôt du projet).

Il faut bien comprendre la logique des trois adresses d’accès à mettre en place :

  • trusted : Interface d’administration, pour la gestion des listes et des campagnes. Peut rester privé.
  • sandbox : Moteur de rendu des modèles et des lettres lors de leur conception. Peut rester privé.
  • public : Pages devant être accessibles à tous les contacts, pour la gestion des inscriptions, la vue des lettres hors client de messagerie et les différentes ressources incluses dans la lettre envoyée par mail. Cette adresse doit obligatoirement être publique.

Chez Worteks, nous avons déployé Mailtrain dans un conteneur sur notre Openshift et configuré notre reverse-proxy pour donner l’accès à l’adresse public. La version installée est la dernière version stable (Mailtrain v2 2021-06-09). Des améliorations ont été apportées depuis, dont le support de la langue française, mais il faudra donc attendre la prochaine version stable pour l’avoir (ou alors installer depuis les sources). Dans la suite de l’article, les captures d’écran sont en anglais pour cette raison.

Une fois le logiciel installé, vous pouvez accéder à l’adresse trusted et vous connecter :

Connexion à Mailtrain

Vous arriverez alors sur la page d’accueil :

Connecté Mailtrain

Nous n’aborderons pas ici les fonctions de gestion de l’authentification, des comptes utilisateurs et des profils associés.

Création d’un modèle

Cliquez sur Templates puis Create template :

Création d'un template

Plusieurs types de moteurs de templates sont disponibles, nous avons fait le choix de Code editor qui permet d’écrire le code HTML complet souhaité.

Une fois le modèle créé, on peut commencer à modifier son contenu :

Template créé

Là vos compétences en HTML sont requises, mais il est assez simple sinon d’utiliser un éditeur et récupérer le code HTML généré.

Il faut néanmoins connaître quelques astuces pour utiliser au maximum les capacités de l’outil, nous en présentons quelques-unes ci-dessous.

Gestion des images

Vous souhaiterez généralement inclure quelques images dans l’email envoyé, a minima le logo de votre entreprise.

Pour cela cliquez en haut à droite sur Files puis téléchargez depuis votre ordinateur les images que vous voulez utiliser :

Chargement d'un fichier

Vous verrez dans la colonne la plus à droite deux logos permettant de télécharger le fichier ou de le supprimer. Il faut copier le lien de téléchargement et utiliser ce lien dans le code HTML du mail pour voir l’image apparaître.

Lorsque le mail sera envoyé à vos contacts, le client de messagerie ira récupérer l’image sur votre serveur. Il est donc important que votre adresse public soit bien configurée !

Utilisation des tags

Dans la page d’édition du modèle, cliquez sur le bouton Merge tag reference, seront alors affichés les différents tags disponibles.

Il suffit d’utiliser ceux-ci dans votre code HTML.

Par exemple pour le lien de désinscription :

<a href="[LINK_UNSUBSCRIBE]">Se désinscrire</a>

Voici par exemple à quoi ressemble un de nos modèles :

Modèle Worteks

Création d’une liste

Une liste est une collection de contects auxquels vous allez envoyer vos communications. Vous pouvez créer plusieurs listes et même des segments sur une même liste mais nous n’aborderons pas la notion de segment ici.

Cliquez sur Lists puis Create List :

Création d'une liste

Les champs importants à compléter sont :

  • Name : nom de la liste.
  • Representation of subscriber’s name : utilisation d’un seul champ pour le nom de votre contact, ou deux champs (nom et prénom). Cela va dépendre des informations que vous utiliserez pour importer vos contacts.
  • Send configuration : configuration à utiliser pour l’envoi des mails.
  • Subscription : autoriser l’inscription via un formulaire web.
  • Unsubscription : méthode pour la désinscription (nombre et nature des étapes).

Une fois la liste créée, il faut y importer vos contacts. Pour cela le plus simple est d’avoir un export CSV de votre base de contact avec a minima le champ Email et les champ nom complet (ou les champs nom et prénom en fonction de ce que vous avez configuré dans la liste).

En haut à droite de votre liste, cliquez sur Imports puis Create Import :

Création d'un import

Mailtrain va analyser le fichier CSV et vous demander l’association des champs :

Mapping CSV

Il ne reste plus qu’à lancer l’import et vérifier son statut :

Statut d'un import

On peut effectuer plusieurs imports sur la même liste, seuls les nouveaux contacts seront ajoutés.

Création d’une campagne

À présent nous pouvons créer une campagne en cliquant sur Campains > Create Campaign > Regular :

Création d'une campagne

Vous devez sélectionner dans cet écran la liste des contacts précédemment créée, ainsi que le modèle à utiliser en choisissant l’option Custom content cloned from template, ce qui vous permettra compléter le contenu.

Renseignez bien “Subject” line qui correspond à l’objet du mail qui sera envoyé.

Cliquez sur Save and edit content pour finaliser le mail en éditant le contenu issu du template. Vous pourrez ici aussi ajouter des images et des tags, comme nous l’avons vu avec les templates.

Voici par exemple notre carte de vœux pour 2023 :

Campagne Worteks

Et voilà comment souhaiter une bonne année à tous ses contacts !

☑️ ☆

Complexité, facilité et simplicité, un triptyque paradoxal qu’il convient de concilier

Complexité, facilité et simplicité, un triptyque paradoxal qu’il convient de concilier

Notre quotidien consiste à gérer la complexité en évaluant les impacts d’un nouveau composant ou d’une nouvelle version, en établissant un plan d’action pour une montée de version, en réagissant lorsqu’un changement provoque des conséquences imprévues. Cette complexité semble inhérente à n’importe quel projet, on le sait, comme une fatalité, avec le temps, un projet devient difficile à faire évoluer, et même à maintenir en condition opérationnelle.

Pour qu’un projet reste maintenable et conserve son potentiel d’évolution, il est nécessaire de tendre vers la plus grande simplicité. Cela semble évident au premier abord. On pourrait penser que chacun d’entre nous souhaite appliquer la solution la plus simple à un problème donné. En effet, il n’existe pas de raison de tendre systématiquement vers la complexité…

Malheureusement, penser que tout à chacun tende vers la recherche de la solution la plus simple, c’est commettre une erreur fondamentale, en confondant les notions de facilité et de simplicité. Tendre vers la solution la plus facile est une évidence biologique. Pour les animaux que nous sommes, économiser son énergie c’est favoriser sa survie. La facilité est une question d’effort alors que la simplicité est une question de conception que l’on pourrait définir par le fait d’avoir peu de composants et surtout peu de liens entre ceux-ci. Parfois, la solution la plus simple est aussi la plus facile. Parfois, en revanche ça n’est pas le cas.

Nous pouvons citer un exemple où simplicité et facilité vont de pair : “l’architecture web classique”. Difficile de faire plus simple que de stocker les données dans une base de données et stocker la logique et l’interface dans une application.

Application 3 Tiers Classique

Un contre-exemple : je dispose d’une application sur laquelle les utilisateurs internes d’une organisation s’authentifient via un SSO, annuaire, ou autre. J’ai besoin qu’un prestataire extérieur puisse accéder à cette application. La solution la plus facile serait probablement de créer un compte local dans l’application à cet utilisateur, sans passer par un annuaire ou un SSO. C’est facile… mais ça n’est pas simple. On se retrouve dans une situation qui contraint à gérer le cycle de vie des comptes locaux. Le passage à l’échelle (plusieurs prestataires, plusieurs applications… ) va vite devenir une problématique forte.

La complexité vient de l’amoncellement de futures petites actions pour lesquelles la facilité est priorisée, car toujours urgentes, mais qui ne sont pas coordonnées et qui créent peu à peu de la lourdeur et irrémédiablement à la fois de la dette technique et un surcroît de gestion.

Cas des référentiels

Comment « faire simple »

Nous l’avons vu, la simplicité ne vient pas naturellement, y accéder demande de la discipline. Pour ce faire, voyons quelques angles d’attaque

  • Conception :

La simplicité d’un système se décide et se joue souvent dès la conception. Celle-ci doit favoriser le fait d’avoir peu de composants, qu’ils soient complémentaires (pour éviter les redondances qui dupliquent le travail de maintenance) et que leurs interactions soient peu nombreuses et bien définies (pour limiter les effets de bords dus à des interactions inconnues).

Dans un tel système, une petite équipe peut se concentrer sur un seul composant et n’a besoin d’interagir qu’avec les quelques équipes dont le composant dépend directement. La philosophie UNIX est l’exemple le plus connu de conception basée sur la simplicité (KISS). L’UNIX original comprend peu de commandes et d’appels systèmes et il y a peu de mécanismes d’interaction (descripteurs de fichiers, signaux).

  • Sobriété :

Difficile de faire plus simple qu’un système qui n’existe pas. Dès la conception, renoncer à certaines fonctionnalités marginales ou supprimer celles qui ne sont plus nécessaires, permet mécaniquement de réduire le nombre de composants, le volume de code ainsi que la consommation de ressources. A-t-on besoin d’implémenter un cas d’usage qui se produit une fois par an et qui peut être traité par un administrateur manuellement ? A-t-on vraiment besoin de stocker des données personnelles qui amènent avec elles leur lot de contraintes techniques et légales ? Est-il vraiment utile d’implémenter un système de remontée automatique d’alertes dans le nouveau logiciel alors que le monitoring en place le fait déjà ?

  • Extensibilité :

Le fait de pouvoir améliorer un système, qu’il s’agisse de sa modification directe ou via un système de plugin, permet souvent d’économiser un composant supplémentaire qui aurait servi de passerelle.

Exemple : un plugin permettant aux utilisateurs AD de se connecter à une application permet d’économiser la mise en place d’un batch d’import des utilisateurs, avec synchronisation des mots de passe, gestion des suppressions.

  • Interopérabilité et standards :

Favoriser le respect de standards établis et l’interopérabilité entre solutions permet de s’abstraire d’une technologie particulière. La dépendance à un fournisseur donné est ainsi réduite, mais ça n’est pas le seul avantage. Pouvoir remplacer un composant par un autre est indispensable à des fins de tests (bouchons, etc.) et renforce l’assurance qu’un composant testé en isolation fonctionnera comme attendu une fois intégré.

HTTP est un excellent exemple : de nouveaux usages de HTTP apparaissent constamment, facilités par le fait qu’il n’y a pas besoin de modifier les clients et les serveurs existants. Lorsque l’on développe un protocole basé sur HTTP, il n’est pas nécessaire de tester la gestion des connexions réseau par les bibliothèques qui implémentent ce protocole ; on sait que ça fonctionne.

  • Long terme :

On l’a vu, la simplicité est parfois à l’opposé de la facilité. Elle a donc parfois un coût de mise en œuvre plus important. Cependant, ce surcoût est vite rentabilisé, car l’équipe de maintenance reste de taille modeste, le projet reste facile à appréhender et les évolutions ont à la fois moins d’impact et restent plus faciles à tester.

  • Refactoring

On prend rarement, dans un projet, le temps nécessaire à la consolidation des différentes évolutions et notamment supprimer ce qui n’a plus lieu d’être. En d’autres mots faire du nettoyage. Les développeurs agiles parlent de réusinage/refactoring, une étape essentielle qui est très souvent négligée. Le refactoring s’applique en réalité à tous les domaines. Par exemple, si un load balancer a été installé pour le projet X, il ne faudra pas oublier de le supprimer si un load balancer mutualisé est mis en place plus tard.

Le salut via l’Open Source ?

Le fait que le code d’un logiciel soit ouvert ou non n’a pas une influence directe sur son caractère de “simplicité”. On trouve des logiciels simples et bien conçus mais privateurs et on trouve des amas de complexité à des codes parfaitement libres. N’insistez pas, nous ne donnerons pas d’exemples…

Keep It Simple Stupid

Pourtant le mode de développement communautaire de l’Open Source encourage la simplicité du design : de petites équipes, souvent peu coordonnées entre elles qui développent des solutions basées sur des standards d’interopérabilité. La bonne maintenance du logiciel est assurée par le fait que les développeurs ne disposent parfois que de ressources limitées, et la sobriété est garantie par le fait que bien souvent, c’est à celui qui désire une fonctionnalité de faire l’effort de l’implémenter. Gare à celui qui augmentera trop la complexité d’un logiciel existant en introduisant une nouvelle fonctionnalité, les mainteneurs seront particulièrement vigilants à ce que cela n’arrive pas, puisque justement, ce sera à eux que reviendra la tâche de la maintenir.

Conclusion

Nous sommes convaincus, peut-être que vous aussi maintenant, que la simplicité doit redevenir une priorité dans les projets informatiques. Cet effort sera récompensé par un gain de réactivité concernant les évolutions et apportera cohérence et maintenabilité sur le long terme. Un système d’information simplifié permet tout autant aux équipes d’alléger leur surcharge cognitive que de mieux anticiper les impacts de leurs actions.

“Faisons l’effort de faire plus simple !”

🔲 ☆

Sortie d’OpenLDAP 2.5.12 et 2.6.2

Logo OpenLDAP

Courant janvier 2022, un évènement important a ébranlé la communauté OpenLDAP : l’annonce d’une nouvelle politique de publication de version d’OpenLDAP.

En effet, celle-ci propose un développement en parallèle de deux versions différentes d’OpenLDAP :

  • la version LTS (Long Term Support), d’une durée de 5 ans environ, est axée sur la stabilité et la sécurité
  • la version orientée fonctionnalités, qui permet l’ajout de nouvelles fonctionnalités et l’amélioration des performances, au prix d’incompatibilités potentielles

La version LTS actuelle est la 2.5, tandis que la version orientée fonctionnalités est la 2.6.

Logo LTB

L’initiative LDAP Tool Box (LTB project) propose du contenu lié aux annuaires LDAP, et en particulier des paquets pour les principales distributions Linux.

Depuis l’abandon de la version 2.4 d’OpenLDAP, l’équipe LTB a travaillé à la publication des nouveaux paquets pour la version à long terme 2.5 (depuis la 2.5.7). Elle est fière aujourd’hui de vous présenter les toutes dernières versions d’OpenLDAP, incluant la version orientée fonctionnalités :

Des dépôts dédiés soit aux versions 2.5, soit aux versions 2.6 ont été créés afin d’éviter une mise à jour majeure intempestive, cette dernière imposant des adaptations.

Par exemple, pour debian 11, le dépôt pour OpenLDAP 2.5 est :

deb [arch=amd64] https://ltb-project.org/debian/openldap25/bullseye bullseye main

tandis que pour OpenLDAP 2.6, il s’agit de :

deb [arch=amd64] https://ltb-project.org/debian/openldap26/bullseye bullseye main

Les paquets LTB pour OpenLDAP 2.5 et 2.6 sont disponibles en téléchargement direct ou bien dans des dépôts APT et RPM dédiés :

Nouveautés d’OpenLDAP LTB 2.5.12

Les principaux changements dans les paquets OpenLDAP LTB 2.5.12 sont les suivants :

  • la nouvelle version 2.2 du module étendu de politique de mots de passe ppm a été intégrée. Celle-ci peut maintenant être compilée indifféremment sur OpenLDAP 2.5 ou 2.6. Cette nouvelle version implémente un maximum de caractères autorisés pour chaque classe, et corrige quelques bugs mineurs.
  • la nouvelle version 2.9 de slapd-cli a été intégrée. Celle-ci gère maintenant les deux versions d’OpenLDAP à travers une variable SLAPD_VERSION. Elle intègre des templates de configuration et des jeux de données de tests pour OpenLDAP 2.5 et 2.6. Ces jeux de données utilisent maintenant par défaut le module étendu de politique de mots de passe.
  • un problème de permissions sur les répertoires sbin et share a été corrigé

Nouveautés d’OpenLDAP LTB 2.6.2

Les principaux changements dans les paquets OpenLDAP LTB 2.6.2 sont les suivants :

  • l’overlay lastbind a été supprimé. Celui-ci permettait de se souvenir de la date de dernière authentification des utilisateurs. Cette fonctionnalité est maintenant gérée par la configuration standard d’OpenLDAP (voir les paramètres olcLastBind et olcLastBindPrecision)
  • le chemin du module étendu de politique de mots de passe n’est plus défini dans chaque politique, mais dans la configuration de l’overlay ppolicy (voir paramètre ppolicy_check_module). Chaque politique peut alors décider d’activer ou non ce module étendu avec l’attribut pwdUseCheckModule.
  • la configuration du module de répartition de charge lload a évolué et doit être mise à jour. Les backends sont maintenant groupés par “tiers” qui précisent la stratégie de répartition.
  • OpenLDAP LTB n’utilise plus rsyslog pour la gestion de logs, mais les nouvelles fonctionnalités offertes par OpenLDAP : olcLogFile, olcLogFileFormat, olcLogFileOnly et olcLogFileRotate (voir pages de manuel). Ce nouveau système de logs promet d’être plus efficace que les implémentations syslog.
  • toutes les modifications d’OpenLDAP LTB 2.5.12 sont intégrées.

N’hésitez pas à donner leur chance à ces nouvelles versions !

☑️ ☆

Des nouvelles du projet LDAP Tool Box

Le projet LDAP Tool Box (LTB project) a été créé il y a plus de 10 ans afin de regrouper des outils d’installation, d’administration et d’exploitation des annuaires LDAP.

Worteks est le principal contributeur du projet et héberge désormais le site, la documentation et les paquets, qui étaient auparavant sur un serveur personnel. Les codes sources sont disponibles sur Github et répliqués sur le Gitlab OW2.

Nous revenons ici sur les outils utilisés sur notre serveur pour le projet, ainsi que sur l’une des grandes nouveautés de la fin de l’année 2021 : les paquets pour OpenLDAP 2.5.

Site web et documentation

Précédemment nous utilisions le logiciel Dokuwiki pour le site web et la documentation.

Afin d’améliorer la documentation, nous avons fait le choix d’utiliser Sphinx. Cela a tout d’abord était fait pour Self Service Password, puis Service Desk et enfin White Pages :

Pour le reste de la documentation (installation des paquets OpenLDAP, utilisation de slapd-cli, scripts de supervision et d’exploitation), un nouveau sous-projet a été créé, et les pages sont publiées à la fois sur Read the docs et sur le nouveau site web.

Les informations du wiki ne faisant pas partie de la documentation technique (page d’accueil, contact, liens de téléchargement) ont été déplacées dans un site web construit avec un générateur de site statique : Templer. Les sources sont publiées dans le dépôt git et le site est en ligne sur le nouveau serveur : https://ltb-project.org/.

Capture d'écran Site Web

Site web et documentation sont donc libres, comme le reste du code du projet, et chacun peut maintenant y contribuer en proposant des améliorations !

Pour être exhaustif sur cette partie, ajoutons que nous avons mis en place GoAccess en remplacement de AWStats pour scanner les fichiers de logs Apache et générer des statistiques. Elles nous permettent d’avoir une idée des requêtes efectuées sur le serveur, que ce soit sur le site ou dans les dépôts.

Capture d'écran GoAccess

Dépôts des paquets

Le projet LTB propose depuis l’origine des dépôts APT (Debian/Ubuntu) et RPM (CentOS/RHEL), pour les paquets OpenLDAP, Self Service Password, White Pages et Service Desk.

Pour les dépôts RPM, c’est l’utilitaire createrepo qui est utilisé.

Les dépôts APT étaient jusqu’ici gérés avec reprepro mais nous avons choisi de changer pour aptly qui nous permet de gérer facilement plusieurs dépôts et conserver plusieurs versions du même paquet dans un dépôt.

OpenLDAP 2.5

La communauté OpenLDAP a choisi d’accéler le cycle des versions majeures et après plus d’une dizaine d’années passées sur la version 2.4, la version 2.5 a été publiée en septembre 2021 et la version 2.6 en décembre 2021. La version 2.4 est donc désormais obsolète.

Nous avons travaillé sur de nouveaux paquets pour la version 2.5, qui incluent de nombreux changements :

  • Backends et overlays sont désormais compilés en module, et doivent donc être chargés dans la configuration
  • Enrichissement de l’outil slapd-cli avec en particulier la possibilité d’injecter des données de test
  • Renommage du service slapd en slapd-ltb
  • Le module ppm est inclus dans le paquet openldap-contrib-overlays suite à son acceptation dans les sources d’OpenLDAP

Nous avons donné une conférence lors du salon Identity Days pour présenter cette nouvelle version.

L’équipe va poursuivre ses travaux cette année en publiant les paquets pour la version 2.6, encore assez jeune. Nous recommandons pour le moment de faire la migration vers la version 2.5, le passage en 2.6 devrait être ensuite plus simple.

Les paquets LTB pour OpenLDAP 2.5 sont disponibles en téléchargement direct ou bien dans des dépôts APT et RPM dédiés :

🔲 ☆

Tekton : Intégration et déploiement continus sur Kubernetes

Tekton est un framework natif Kubernetes complet, orienté intégration et déploiement continus, ayant fait son apparition au début de l’année 2019.

La communauté s’étant formée autour de Tekton regroupe des contributeurs de RedHat, Google, … tous les grands acteurs Kubernetes. Tekton est aujourd’hui disponible sur OpenShift 4, pouvant se substituer aux BuildConfig ou autres pipelines Jenkins.

Profitant de l’ajout récent du support ARM, depuis Tekton Pipeline v0.19.0 (9 décembre 2020), Tekton Triggers v0.10.0 (26 octobre 2020) et Tekton Dashboard v0.12.2 (15 décembre 2020), et donnant suite à notre article concernant le deploiement d’un cluster Kubernetes sur Raspberry Pi, ainsi que celui sur la configuration de volumes persistants et d’une registry, nous regarderons aujourd’hui comment assembler nos propres images sur Kubernetes.

Tekton Pipelines

Build d’Images Docker

À ce stade, nous pourrons tester l’exécution d’un pipeline. Pour cela, commençons par créer une tâche, décrivant l’assemblage d’une image :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Task
metadata:
  name: docker-build-kaniko
  namespace: ci
spec:
  params:
  - default: gcr.io/kaniko-project/executor:multi-arch-v1.3.0
    description: The location of the kaniko builder image.
    name: builderimage
    type: string
  - default: Dockerfile
    description: The name of the Dockerfile
    name: dockerfile
    type: string
  - default: .
    description: Parent directory for your Dockerfile.
    name: dockerroot
    type: string
  - default: ""
    description: Forces USER in Dockerfile - either a specific uid, or any string would translate to 1001
    name: forceuid
    type: string
  - default: ""
    description: Forces FROM in Dockerfile.
    name: fromimage
    type: string
  resources:
    inputs:
    - name: source
      type: git
    outputs:
    - name: image
      type: image
  steps:
  - command:
    - /bin/sh
    - -c
    - |
        if echo "$(inputs.params.fromimage)" | grep -E '/.*/' >/dev/null; then \
            sed -i "s|^[ ]*FROM[ ]*[^ ]*$|FROM $(inputs.params.fromimage)|" \
                 "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
        elif test "$(inputs.params.fromimage)"; then \
            sed -i "s|^[ ]*FROM[ ]*[^ ]*$|FROM registry.registry.svc.cluster.local:5000/ci/$(inputs.params.fromimage)|" \
                 "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
        fi; \
        if test "$(inputs.params.forceuid)" -a "$(inputs.params.forceuid)" -gt 0 >/dev/null 2>&1; then \
            if ! grep -E '^USER[ \t]*[0-9]' "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)" >/dev/null; then \
                echo USER $(inputs.params.forceuid) \
                    >>"$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
            fi; \
        elif test "$(inputs.params.forceuid)"; then \
            if ! grep -E '^USER[ \t]*[0-9]' "$(inputs.params.dockerroot)/$(inputs.params.dockerfile)" >/dev/null; then \
                echo USER 1001 >>"$(inputs.params.dockerroot)/$(inputs.params.dockerfile)"; \
            fi; \
        fi
    image: docker.io/busybox:latest
    name: patch-from
    securityContext:
      privileged: true
    workingDir: /workspace/source
  - command:
    - /kaniko/executor
    - --skip-tls-verify-pull
    - --skip-tls-verify
    - "--build-arg=DO_UPGRADE=true"
    - "--build-arg=SRC_CLONE_PASS=$(inputs.params.clonepass)"
    - "--build-arg=SRC_CLONE_USER=$(inputs.params.cloneuser)"
    - --dockerfile=$(inputs.params.dockerroot)/$(inputs.params.dockerfile)
    - --context=dir:///workspace/source
    - --destination=$(outputs.resources.image.url)
    env:
    - name: DOCKER_CONFIG
      value: /builder/home/.docker
    image: $(inputs.params.builderimage)
    name: build-and-push
    securityContext:
      privileged: true
    workingDir: /workspace/source
EOF

Notons que nous avons ici choisi d’utiliser Kaniko, un projet publié par Google en 2018, permettant l’assemblage d’images de conteneur, depuis un autre conteneur.
Notons que d’autres implémentations existent, et nous pourrons notament citer BuildKit, Img, ou Buildah, fourni par RedHat, tout aussi capable que Kaniko, mais avec l’inconvénient de ne pas encore proposer d’image arm64.

À ce stade, bien que Kaniko ou Buildah prétendent assembler des images sans privilèges particuliers, notons que ce n’est pas vraiment le cas sur Kubernetes, ou il faudra toujours laisser ces conteneurs s’exécuter en tant que root. Pour cela, nous voudrons créer un ServiceAccount, et lui donner les privilèges nécessaires :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Pipeline
metadata:
  name: docker-build
  namespace: ci
spec:
  params:
  - default: Dockerfile
    name: dockerfile
    type: string
  - default: .
    name: dockerroot
    type: string
  - default: ""
    description: Forces FROM in Dockerfile.
    name: fromimage
    type: string
  resources:
  - name: app-git
    type: git
  - name: app-image
    type: image
  tasks:
  - name: build
    params:
    - name: dockerfile
      value: $(params.dockerfile)
    - name: dockerroot
      value: $(params.dockerroot)
    - name: fromimage
      value: $(params.fromimage)
    - name: tlsverify
      value: "false"
    resources:
      inputs:
      - name: source
        resource: app-git
      outputs:
      - name: image
        resource: app-image
    taskRef:
      kind: Task
      name: docker-build-kaniko
EOF

Pipelines et Tasks ont pour vocation à être réutilisés. Ils seront contextualisés, à l’aide de paramètres tels que dépôts git ou registry, que nous définirons de la manière suivante :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: tekton.dev/v1alpha1
kind: PipelineResource
metadata:
  name: registry-exporter-git
  namespace: ci
spec:
  params:
  - name: url
    value: https://gitlab.com/Worteks/docker-registry-exporter
  - name: revision
    value: master
  type: git
---
apiVersion: tekton.dev/v1alpha1
kind: PipelineResource
metadata:
  name: registry-exporter-image
  namespace: ci
spec:
  params:
  - name: url
    value: registry.registry.svc.cluster.local:5000/ci/registry-exporter:master
  type: image
EOF

Enfin, l’exécution d’un job se déclanchera avec la création d’un PipelineRun, tel que le suivant :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: PipelineRun
metadata:
  name: registry-exporter-1
  namespace: ci
spec:
  pipelineRef:
    name: docker-build
  resources:
  - name: app-git
    resourceRef:
      name: registry-exporter-git
  - name: app-image
    resourceRef:
      name: registry-exporter-image
  serviceAccountName: tkn-ci
  timeout: 30m0s
EOF

Nous pourrons suivre l’exécution de notre pipeline :

$ kubectl  get pods -n ci
NAME                                        READY   STATUS            RESTARTS   AGE
registry-exporter-1-build-gc7k8-pod-sp6qh   0/5     PodInitializing   0          19s
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh
error: a container name must be specified for pod registry-exporter-1-build-gc7k8-pod-sp6qh, choose one of: [step-create-dir-image-wql9r step-git-source-source-2jpbq step-patch-from step-build step-image-digest-exporter-kzr5b] or one of the init containers: [working-dir-initializer place-tools]
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
Error from server (BadRequest): container "step-git-source-source-2jpbq" in pod "registry-exporter-1-build-gc7k8-pod-sp6qh" is waiting to start: PodInitializing
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-create-dir-image-wql9r
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
{"level":"info","ts":1610369828.8041682,"caller":"git/git.go:165","msg":"Successfully cloned https://github.com/Worteks/docker-registry-exporter @ 0388c04686d4aaaddd28c747a66dd3f362b35428 (grafted, HEAD, origin/fix-docker-build) in path /workspace/source"}
{"level":"info","ts":1610369828.899402,"caller":"git/git.go:203","msg":"Successfully initialized and updated submodules in path /workspace/source"}
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
{"level":"info","ts":1610369828.8041682,"caller":"git/git.go:165","msg":"Successfully cloned https://github.com/Worteks/docker-registry-exporter @ 0388c04686d4aaaddd28c747a66dd3f362b35428 (grafted, HEAD, origin/fix-docker-build) in path /workspace/source"}
{"level":"info","ts":1610369828.899402,"caller":"git/git.go:203","msg":"Successfully initialized and updated submodules in path /workspace/source"}
$ kubectl logs -n ci registry-exporter-1-build-gc7k8-pod-sp6qh -f -c step-git-source-source-2jpbq
E0109 13:04:30.159776      14 aws_credentials.go:77] while getting AWS credentials NoCredentialProviders: no valid providers in chain. Deprecated.
For verbose messaging see aws.Config.CredentialsChainVerboseErrors
INFO[0007] Resolved base name python:3.7-alpine to base
INFO[0007] Retrieving image manifest python:3.7-alpine
INFO[0007] Retrieving image python:3.7-alpine
INFO[0009] Retrieving image manifest python:3.7-alpine
INFO[0009] Retrieving image python:3.7-alpine
INFO[0010] Retrieving image manifest python:3.7-alpine
INFO[0010] Retrieving image python:3.7-alpine
INFO[0011] Retrieving image manifest python:3.7-alpine
INFO[0011] Retrieving image python:3.7-alpine
INFO[0012] Built cross stage deps: map[0:[/install]]
INFO[0012] Retrieving image manifest python:3.7-alpine
INFO[0012] Retrieving image python:3.7-alpine
INFO[0014] Retrieving image manifest python:3.7-alpine
INFO[0014] Retrieving image python:3.7-alpine
INFO[0016] Executing 0 build triggers
INFO[0016] Unpacking rootfs as cmd RUN  apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev requires it.
INFO[0019] RUN  apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev
INFO[0019] Taking snapshot of full filesystem...
INFO[0022] cmd: /bin/sh
INFO[0022] args: [-c apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev]
INFO[0022] Running: [/bin/sh -c apk add --no-cache --virtual=build-dependencies     autoconf     automake     g++     gcc     linux-headers     make     openssl-dev     zlib-dev]
fetch http://dl-cdn.alpinelinux.org/alpine/v3.12/main/aarch64/APKINDEX.tar.gz
fetch http://dl-cdn.alpinelinux.org/alpine/v3.12/community/aarch64/APKINDEX.tar.gz
(1/24) Installing m4 (1.4.18-r1)
(2/24) Installing perl (5.30.3-r0)
(3/24) Installing autoconf (2.69-r2)
(4/24) Installing automake (1.16.2-r0)
(5/24) Installing libgcc (9.3.0-r2)
(6/24) Installing libstdc++ (9.3.0-r2)
(7/24) Installing binutils (2.34-r1)
(8/24) Installing gmp (6.2.0-r0)
(9/24) Installing isl (0.18-r0)
(10/24) Installing libgomp (9.3.0-r2)
(11/24) Installing libatomic (9.3.0-r2)
(12/24) Installing libgphobos (9.3.0-r2)
(13/24) Installing mpfr4 (4.0.2-r4)
(14/24) Installing mpc1 (1.1.0-r1)
(15/24) Installing gcc (9.3.0-r2)
(16/24) Installing musl-dev (1.1.24-r10)
(17/24) Installing libc-dev (0.7.2-r3)
(18/24) Installing g++ (9.3.0-r2)
(19/24) Installing linux-headers (5.4.5-r1)
(20/24) Installing make (4.3-r0)
(21/24) Installing pkgconf (1.7.2-r0)
(22/24) Installing openssl-dev (1.1.1i-r0)
(23/24) Installing zlib-dev (1.2.11-r3)
(24/24) Installing build-dependencies (20210109.130446)
Executing busybox-1.31.1-r19.trigger
OK: 238 MiB in 59 packages
INFO[0029] Taking snapshot of full filesystem...
INFO[0057] RUN mkdir /install
INFO[0057] cmd: /bin/sh
INFO[0057] args: [-c mkdir /install]
INFO[0057] Running: [/bin/sh -c mkdir /install]
INFO[0057] Taking snapshot of full filesystem...
INFO[0065] WORKDIR /install
INFO[0065] cmd: workdir
INFO[0065] Changed working directory to /install
INFO[0065] No files changed in this command, skipping snapshotting.
INFO[0065] COPY requirements.txt /requirements.txt
INFO[0065] Taking snapshot of files...
INFO[0065] RUN pip install --prefix=/install -r /requirements.txt
INFO[0065] cmd: /bin/sh
INFO[0065] args: [-c pip install --prefix=/install -r /requirements.txt]
INFO[0065] Running: [/bin/sh -c pip install --prefix=/install -r /requirements.txt]
Collecting prometheus_client==0.4.2
  Downloading prometheus_client-0.4.2.tar.gz (29 kB)
Collecting Twisted==19.7.0
  Downloading Twisted-19.7.0.tar.bz2 (3.1 MB)
Collecting attrs>=17.4.0
  Downloading attrs-20.3.0-py2.py3-none-any.whl (49 kB)
Collecting Automat>=0.3.0
  Downloading Automat-20.2.0-py2.py3-none-any.whl (31 kB)
Collecting constantly>=15.1
  Downloading constantly-15.1.0-py2.py3-none-any.whl (7.9 kB)
Collecting hyperlink>=17.1.1
  Downloading hyperlink-21.0.0-py2.py3-none-any.whl (74 kB)
Collecting idna>=2.5
  Downloading idna-3.1-py3-none-any.whl (58 kB)
Collecting incremental>=16.10.1
  Using cached incremental-17.5.0-py2.py3-none-any.whl (16 kB)
Collecting PyHamcrest>=1.9.0
  Downloading PyHamcrest-2.0.2-py3-none-any.whl (52 kB)
Collecting zope.interface>=4.4.2
  Downloading zope.interface-5.2.0.tar.gz (227 kB)
Requirement already satisfied: setuptools in /usr/local/lib/python3.7/site-packages (from zope.interface>=4.4.2->Twisted==19.7.0->-r /requirements.txt (line 1)) (51.0.0)
Collecting six
  Downloading six-1.15.0-py2.py3-none-any.whl (10 kB)
Building wheels for collected packages: prometheus-client, Twisted, zope.interface
  Building wheel for prometheus-client (setup.py): started
  Building wheel for prometheus-client (setup.py): finished with status 'done'
  Created wheel for prometheus-client: filename=prometheus_client-0.4.2-py3-none-any.whl size=35285 sha256=f3149f489ce679d5ea7c70a06d2f14b35705b5d2b20ce36f4698eff88e0a1b2e
  Stored in directory: /root/.cache/pip/wheels/4e/be/ec/c91dde5309bc0e660bda4735162575e19e238983dd64c60bc9
  Building wheel for Twisted (setup.py): started
  Building wheel for Twisted (setup.py): finished with status 'done'
  Created wheel for Twisted: filename=Twisted-19.7.0-cp37-cp37m-linux_aarch64.whl size=3034359 sha256=fdacf8565c06b15cae0bb42d01102a0296feb678c4eb870c917c6aca3ae01025
  Stored in directory: /root/.cache/pip/wheels/bc/28/f9/e991f24acf0acd2ed39e7733413e85745ee998f843a311a8f6
  Building wheel for zope.interface (setup.py): started
  Building wheel for zope.interface (setup.py): finished with status 'done'
  Created wheel for zope.interface: filename=zope.interface-5.2.0-cp37-cp37m-linux_aarch64.whl size=195430 sha256=f22cc40da76c4591fd2e38874ba8d4278d809fd6be6ac4d43032c750b5106881
  Stored in directory: /root/.cache/pip/wheels/27/57/14/5b2a6cd8b6869470681f04a8ce56aeb6cba0cd534598730527
Successfully built prometheus-client Twisted zope.interface
Installing collected packages: six, idna, attrs, zope.interface, PyHamcrest, incremental, hyperlink, constantly, Automat, Twisted, prometheus-client
  WARNING: The script automat-visualize is installed in '/install/bin' which is not on PATH.
  Consider adding this directory to PATH or, if you prefer to suppress this warning, use --no-warn-script-location.
  WARNING: The scripts cftp, ckeygen, conch, mailmail, pyhtmlizer, tkconch, trial, twist and twistd are installed in '/install/bin' which is not on PATH.
  Consider adding this directory to PATH or, if you prefer to suppress this warning, use --no-warn-script-location.
Successfully installed Automat-20.2.0 PyHamcrest-2.0.2 Twisted-19.7.0 attrs-20.3.0 constantly-15.1.0 hyperlink-21.0.0 idna-3.1 incremental-17.5.0 prometheus-client-0.4.2 six-1.15.0 zope.interface-5.2.0
INFO[0113] Taking snapshot of full filesystem...
INFO[0120] Saving file install for later use
INFO[0121] Deleting filesystem...
INFO[0123] Retrieving image manifest python:3.7-alpine
INFO[0123] Retrieving image python:3.7-alpine
INFO[0124] Retrieving image manifest python:3.7-alpine
INFO[0124] Retrieving image python:3.7-alpine
INFO[0125] Executing 0 build triggers
INFO[0125] Unpacking rootfs as cmd COPY --from=base /install /usr/local requires it.
INFO[0129] COPY --from=base /install /usr/local
INFO[0130] Taking snapshot of files...
INFO[0133] COPY exporter /exporter
INFO[0133] Taking snapshot of files...
INFO[0133] WORKDIR /exporter
INFO[0133] cmd: workdir
INFO[0133] Changed working directory to /exporter
INFO[0133] No files changed in this command, skipping snapshotting.
INFO[0133] ENTRYPOINT ["python", "/exporter/exporter.py"]
INFO[0133] USER 1001
INFO[0133] cmd: USER

Build de Paquets

Tekton n’est pas limité à l’assemblage d’images Docker. Nous pourrions l’utiliser pour toute sorte de scripts. Prenons l’exemple d’un paquet Debian, pour OpenLDAP LTB. Il nous faut une ressource de type Git, d’ou l’on va télécharger l’arboresence nécessaire à la généreration de nos paquets :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1alpha1
kind: PipelineResource
metadata:
  name: openldap-ltb-deb
  namespace: ci
spec:
  params:
  - name: url
    value: https://github.com/ltb-project/openldap-deb
  - name: revision
    value: master
  type: git
EOF

Il nous faut ensuite une Task, décrivant comment assembler nos paquets, depuis ce dépôt. Une fois les paquets générés, il faudra les envoyer vers un dépôt : nous utiliserons un serveur Nexus, sur lequel nous avons au préalable un dépôt APT de type Hosted. Disposant d’un compte de service permettant l’ajout d’objets à ce dépôt Nexus APT, nous pourrons créer la Task suivante :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Task
metadata:
  name: deb-build-ltb-openldap
  namespace: ci
spec:
  params:
  - default: https://nexus.example.com
    description: Nexus Repository Address
    name: nexusaddress
    type: string
  - default: admin
    description: Nexus Repository Username
    name: nexususer
    type: string
  - default: secret
    description: Nexus Repository Password
    name: nexussecret
    type: string
  - default: apt-ltb
    description: OpenLDAP LTB Nexus Repository Name
    name: nexusrepo
    type: string
  - default: 2.4.56
    description: OpenLDAP Version to Build
    name: ldapversion
    type: string
  resources:
    inputs:
    - name: source
      type: git
  steps:
  - command:
    - /bin/sh
    - -c
    - |
    set -x; \
        export DEBIAN_FRONTEND=noninteractive; \
        MYARCH=`uname -m`; \
        test "$MYARCH" = aarch64 && MYARCH=arm64; \
        apt-get update \
        && apt-get install -y wget tar build-essential autoconf automake autotools-dev debhelper dh-make \
            devscripts fakeroot file gnupg git lintian patch patchutils pbuilder libsodium23 libsodium-dev \
            libltdl7 libltdl-dev libsasl2-2 libsasl2-dev zlib1g zlib1g-dev openssl libssl-dev mime-support \
            mawk libcrack2-dev libwrap0-dev curl \
        && cd debian/paquet-berkeleydb-debian \
        && tar -xvzf db-4.6.21.NC.tar.gz \
        && cp -r db-4.6.21.NC/* berkeleydb-ltb-4.6.21.NC \
        && tar -czf berkeleydb-ltb_4.6.21.NC-4.orig.tar.gz berkeleydb-ltb-4.6.21.NC \
        && cd berkeleydb-ltb-4.6.21.NC/ \
        && dpkg-buildpackage -us -uc \
        && dpkg -i ../berkeleydb-ltb_4.6.21.NC-4-patch4_$MYARCH.deb \
        && cd ../../paquet-openldap-debian \
        && wget ftp://ftp.openldap.org/pub/OpenLDAP/openldap-release/openldap-$(inputs.params.ldapversion).tgz \
        && tar -xvzf openldap-$(inputs.params.ldapversion).tgz \
        && cp -r openldap-$(inputs.params.ldapversion)/* openldap-ltb-$(inputs.params.ldapversion)/ \
        && tar -czf openldap-ltb-$(inputs.params.ldapversion).orig.tar.gz \
            openldap-ltb-$(inputs.params.ldapversion) \
        && cd openldap-ltb-$(inputs.params.ldapversion) \
        && dpkg-buildpackage -us -uc \
        && dpkg -i ../openldap-ltb_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-explockout_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-mdb-utils_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-ppm_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-check-password_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-dbg_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && dpkg -i ../openldap-ltb-contrib-overlays_$(inputs.params.ldapversion).1_$MYARCH.deb \
        && cd ../../ \
        && ls -l paquet-* \
        && for f in paquet-berkeleydb-debian/berkeleydb-ltb_4.6.21.NC-4-patch4_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-explockout_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-mdb-utils_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-ppm_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-check-password_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-dbg_$(inputs.params.ldapversion).1_$MYARCH.deb \
                paquet-openldap-debian/openldap-ltb-contrib-overlays_$(inputs.params.ldapversion).1_$MYARCH.deb; \
        do \
            curl -u "$(inputs.params.nexususer):$(inputs.params.nexussecret)" \
                -k -X POST -H "Content-Type: multipart/form-data" --data-binary "@$f" \
                "$(inputs.params.nexusaddress)/repository/$(inputs.params.nexusrepo)/"; \
        done
    image: docker.io/debian:buster
    name: build
    securityContext:
      privileged: true
    workingDir: /workspace/source
EOF

Déclarer un Pipeline, liant la ressource Git à notre Task :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: Pipeline
metadata:
  name: build-ltb-openldap
  namespace: ci
spec:
  params:
  - default: 2.4.56
    description: OpenLDAP Version to Build
    name: ldapversion
    type: string
  resources:
  - name: app-git
    type: git
  tasks:
  - name: build
    params:
    - name: ldapversion
      value: $(params.ldapversion)
    resources:
      inputs:
      - name: source
        resource: app-git
    taskRef:
      kind: Task
      name: deb-build-ltb-openldap
EOF

Et lancer un job, en créant le PipelineRun suivant :

$ cat <<EOF | kubectl apply -f-
apiVersion: tekton.dev/v1beta1
kind: PipelineRun
metadata:
  name: ltb-openldap-1
  namespace: ci
spec:
  pipelineRef:
    name: build-ltb-openldap
  resources:
  - name: app-git
    resourceRef:
      name: openldap-ltb-deb
  serviceAccountName: tkn-ci
  timeout: 2h0m0s
EOF

Nous pourrons suivre l’exécution du job, qui assemblera une suite de paquets, les installera en local, et si tout s’est bien passé : poussera les archives debian générées vers notre dépôt Nexus.

$ kubectl logs -n ci -c step-build ltb-openldap-1-build-7npcv-pod-mp28x
+ export DEBIAN_FRONTEND=noninteractive
+ uname -m
+ MYARCH=aarch64
+ test aarch64 = aarch64
+ MYARCH=arm64
+ apt-get update
Get:1 http://security.debian.org/debian-security buster/updates InRelease [65.4 kB]
Get:2 http://deb.debian.org/debian buster InRelease [121 kB]
Get:3 http://deb.debian.org/debian buster-updates InRelease [51.9 kB]
Get:4 http://security.debian.org/debian-security buster/updates/main arm64 Packages [254 kB]
Get:5 http://deb.debian.org/debian buster/main arm64 Packages [7737 kB]
Get:6 http://deb.debian.org/debian buster-updates/main arm64 Packages [7848 B]
Fetched 8238 kB in 4s (2346 kB/s)
Reading package lists...
+ apt-get install -y wget tar
...
+ curl -u XXX:YYY -k -X POST -H Content-Type: multipart/form-data --data-binary @paquet-openldap-debian/openldap-ltb-dbg_2.4.56.1_arm64.deb https://nexus.example.com/repository/apt-ltb/
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100 3978k    0     0  100 3978k      0   791k  0:00:05  0:00:05 --:--:--     0
+ curl -u XXX:YYY -k -X POST -H Content-Type: multipart/form-data --data-binary @paquet-openldap-debian/openldap-ltb-contrib-overlays_2.4.56.1_arm64.deb https://nexus.example.com/repository/apt-ltb/
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100  333k    0     0  100  333k      0  61846  0:00:05  0:00:05 --:--:--     0

Et depuis notre dépôt Nexus, nous pourrons confirmer que nos paquets sont maintenant disponibles :

Tekton Nexus

De la même façon, nous pourrions exécuter des tests unitaires, scanner notre code ou image, lancer un déploiement utilisant nos derniers montages pour y exécuter des tests d’intégration, … Automatiser les différentes étapes d’une chaine d’intégration et déploiements continue devient un jeu d’enfant. Vous retrouverez une suite d’exemples, sur le dépôt GitHub Catalog, du projet Tekton.

Tekton Triggers

Jusque la, nous avons vu comment exécuter nos jobs, mais dans le contexte d’une chaine d’intégration et déploiements continus, il nous faut maintenant traiter la réception d’évenements.

Tekton Triggers est une composante optionelle, ajoutant de nouveaux types d’objets au cluster, en vue de réceptionner et traiter des notifications http, par exemple pour programmer l’exécution d’un pipeline suite au push d’une modification sur un dépôt git.

Nous déploierons la dernière version depuis GitHub :

$ kubectl apply -f https://storage.googleapis.com/tekton-releases/triggers/previous/v0.10.2/release.yaml
$ kubectl get pods -n tekton-pipelines
NAME                                           READY   STATUS    RESTARTS   AGE
tekton-pipelines-controller-5cdb46974f-fzfdh   1/1     Running   0          25m
tekton-pipelines-webhook-6479d769ff-wxbxr      1/1     Running   0          25m
tekton-triggers-controller-5994f6c94b-fw2dm    1/1     Running   0          1m
tekton-triggers-webhook-68c7866d8-zdttm        1/1     Running   0          1m

Nous pouvons maintenant configurer un premier Event Listener.

L’Event Listener interroge l’API du cluster Kubernetes, il faudra avant tout lui créer un ServiceAccount, auquel on déleguera les privilèges necessaires :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: tkn-triggers-ci
  namespace: ci
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: tekton-triggers
  namespace: ci
rules:
- apiGroups: ["triggers.tekton.dev"]
  resources: ["eventlisteners", "triggerbindings", "triggertemplates", "triggers"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["configmaps", "secrets"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["tekton.dev"]
  resources: ["pipelineruns", "pipelineresources", "taskruns"]
  verbs: ["create"]
- apiGroups: [""]
  resources: ["serviceaccounts"]
  verbs: ["impersonate"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: tekton-triggers
  namespace: ci
subjects:
- kind: ServiceAccount
  name: tkn-triggers-ci
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: tekton-triggers
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: tekton-triggers
rules:
- apiGroups: ["triggers.tekton.dev"]
  resources: ["clustertriggerbindings"]
  verbs: ["get", "list", "watch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: tekton-triggers-ci
subjects:
- kind: ServiceAccount
  name: tkn-triggers-ci
  namespace: ci
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: tekton-triggers
EOF

Notre Event Listener doit traiter des notifications en provenance de GitHub. Nous allons donc créer un TriggerBinding, associant les champs de l’objet JSON envoyé par GitHub, aux variables que l’on souhaite réutiliser dans la programmation de notre job :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: triggers.tekton.dev/v1alpha1
kind: TriggerBinding
metadata:
  name: github-pr-binding
  namespace: ci
spec:
  params:
  - name: gitrevision
    value: $(body.pull_request.head.sha)
  - name: gitrepositoryname
    value: $(body.repository.name)
  - name: gitrepositoryurl
    value: $(body.repository.clone_url)
---
apiVersion: triggers.tekton.dev/v1alpha1
kind: TriggerBinding
metadata:
  name: github-push-binding
  namespace: ci
spec:
  params:
  - name: gitrevision
    value: $(body.after)
  - name: gitrepositoryname
    value: $(body.repository.name)
  - name: gitrepositoryurl
    value: $(body.repository.clone_url)
EOF

Nous allons ensuite créer un TriggerTemplate, décrivant que faire lorsqu’une notification est reçue. Dans notre cas, fonction des variables extraites par notre TriggerBinding, nous voudrons créer un PipelineRun, dont les ressources Git et Image seront deduites de la notification reçue:

$ cat <<EOF | kubectl apply -f-
apiVersion: triggers.tekton.dev/v1alpha1
kind: TriggerTemplate
metadata:
  name: github-pipelinerun-template
  namespace: ci
spec:
  params:
  - name: gitrevision
  - name: gitrepositoryname
  - name: gitrepositoryurl
  resourcetemplates:
  - apiVersion: tekton.dev/v1beta1
    kind: PipelineRun
    metadata:
      generateName: github-job-
    spec:
      pipelineRef:
        name: docker-build
      resources:
      - name: app-git
        resourceSpec:
          type: git
          params:
          - name: revision
            value: $(tt.params.gitrevision)
          - name: url
            value: $(tt.params.gitrepositoryurl)
      - name: app-image
        resourceSpec:
          type: image
          params:
          - name: url
            value: registry.registry.svc.cluster.local:5000/ci/$(tt.params.gitrepositoryname):$(tt.params.gitrevision)
      serviceAccountName: tkn-ci
      timeout: 1h0m0s
EOF

Enfin, nous allons créer un Secret, dans lequel conserver un token que l’on configurera par la suite, dans notre WebHook GitHub, un EventListener décrivant sous quelles conditions notifier notre TriggerBinding, et un Ingress, exposant l’Event Listener :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: Secret
metadata:
  name: github-secret
  namespace: ci
stringData:
  secretToken: changeme
type: Opaque
---
apiVersion: triggers.tekton.dev/v1alpha1
kind: EventListener
metadata:
  name: github-listener
  namespace: ci
spec:
  serviceAccountName: tkn-triggers-ci
  triggers:
  - name: github-pr-listener
    interceptors:
      - github:
          secretRef:
            secretName: github-secret
            secretKey: secretToken
          eventTypes:
          - pull_request
    bindings:
    - ref: github-pr-binding
    template:
      ref: github-pipelinerun-template
  - name: github-push-listener
    interceptors:
      - github:
          secretRef:
            secretName: github-secret
            secretKey: secretToken
          eventTypes:
          - push
    bindings:
    - ref: github-push-binding
    template:
      ref: github-pipelinerun-template
---
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  annotations:
  name: github-eventlistener
  namespace: ci
spec:
  rules:
  - host: git-ci-el.router.example.com
    http:
      paths:
      - backend:
          serviceName: el-github-listener
          servicePort: 8080
EOF

La création d’un EventListener aura demarré un nouveau Pod, en charge de receptionner et traiter les notifications :

# kubectl get pods -n ci
NAME                                               READY   STATUS      RESTARTS   AGE
...
el-github-listener-657bd5b5d8-9rgwx                1/1     Running     0          2m

Confirmer, depuis un navigateur, que l’addresse https://git-ci-el.router.example, définie dans notre Ingress, est bien joignable en dehors du cluster. Rendons-nous ensuite sur GitHub, dans les settings du dépôt de votre choix, section WebHooks :

github webhook 2

Rajouter un webhook :

Webhooc config

L’Event Listener ne semble pas supporter les notifications de type application/x-www-form-urlencoded, il faudra choisir l’option application/json.

Renseigner le Secret fonction de l’accessToken créé précédemment.

Cocher le type d’évenements sur lequel nous souhaitons recevoir une notification, push et pull requests :

Github webhook

Maintenant, nous pouvons pousser un commit sur ce dépôt, pour déclancher un job. Depuis les logs de l’EventListener, confirmer que l’on a bien reçu le message, et verifier qu’un nouveau Pod s’est lance. Nous pourrons suivre les logs d’execution du job :

$ kubectl logs -n ci el-github-listener-657bd5b5d8-9rgwx
{"level":"error","ts":"2021-01-12T08:48:49.089Z","logger":"eventlistener","caller":"sink/sink.go:209","msg":"event type ping is not allowed","knative.dev/controller":"eventlistener","/triggers-eventid":"85m9z","/trigger":"github-push-listener","stacktrace":"github.com/tektoncd/triggers/pkg/sink.Sink.processTrigger\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:209\ngithub.com/tektoncd/triggers/pkg/sink.Sink.HandleEvent.func1\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:129"}
{"level":"error","ts":"2021-01-12T08:48:49.093Z","logger":"eventlistener","caller":"sink/sink.go:209","msg":"event type ping is not allowed","knative.dev/controller":"eventlistener","/triggers-eventid":"85m9z","/trigger":"github-pr-listener","stacktrace":"github.com/tektoncd/triggers/pkg/sink.Sink.processTrigger\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:209\ngithub.com/tektoncd/triggers/pkg/sink.Sink.HandleEvent.func1\n\tgithub.com/tektoncd/triggers/pkg/sink/sink.go:129"}
{"level":"info","ts":"2021-01-12T09:08:45.303Z","logger":"eventlistener","caller":"sink/sink.go:238","msg":"ResolvedParams : [{Name:gitrevision Value:17bb6ac63b8d504dc9d635cd2b6be396bc9964b3} {Name:gitrepositoryname Value:docker-registry-exporter} {Name:gitrepositoryurl Value:https://github.com/faust64/docker-registry-exporter.git}]","knative.dev/controller":"eventlistener","/triggers-eventid":"25m7f","/trigger":"github-push-listener"}
{"level":"info","ts":"2021-01-12T09:08:45.307Z","logger":"eventlistener","caller":"resources/create.go:95","msg":"Generating resource: kind: &APIResource{Name:pipelineruns,Namespaced:true,Kind:PipelineRun,Verbs:[delete deletecollection get list patch create update watch],ShortNames:[pr prs],SingularName:pipelinerun,Categories:[tekton tekton-pipelines],Group:tekton.dev,Version:v1beta1,StorageVersionHash:RcAKAgPYYoo=,}, name: github-job-","knative.dev/controller":"eventlistener"}
{"level":"info","ts":"2021-01-12T09:08:45.307Z","logger":"eventlistener","caller":"resources/create.go:103","msg":"For event ID \"25m7f\" creating resource tekton.dev/v1beta1, Resource=pipelineruns","knative.dev/controller":"eventlistener"}
$ kubectl get pods -n ci
NAME                                               READY   STATUS      RESTARTS   AGE
...
el-github-listener-657bd5b5d8-9rgwx                1/1     Running     0          12m
github-job-92pjk-build-b66g6-pod-2nvtk             5/5     Running     0          15s
$ kubectl logs -n ci -c step-build -f github-job-92pjk-build-b66g6-pod-2nvtk
E0112 09:09:02.750462      13 aws_credentials.go:77] while getting AWS credentials NoCredentialProviders: no valid providers in chain. Deprecated.
For verbose messaging see aws.Config.CredentialsChainVerboseErrors
INFO[0007] Resolved base name python:3.7-alpine to base
INFO[0007] Retrieving image manifest python:3.7-alpine
...
INFO[0133] WORKDIR /exporter
INFO[0133] cmd: workdir
INFO[0133] Changed working directory to /exporter
INFO[0133] No files changed in this command, skipping snapshotting.
INFO[0133] ENTRYPOINT ["python", "/exporter/exporter.py"]
INFO[0133] USER 1001
INFO[0133] cmd: USER

L’Event Listener recevant une notification de GitHub, a bien créé un PipelineRun :

root@pandore:~/wip-triggers# kubectl get pipelinerun -n ci
NAME                         SUCCEEDED   REASON      STARTTIME   COMPLETIONTIME
docker-registry-exporter-1   True        Succeeded   2d21h       2d21h
github-job-92pjk             True        Succeeded   16m         13m
ltb-openldap-1               True        Succeeded   13h         12h
root@pandore:~/wip-triggers# kubectl get pipelinerun -n ci -o yaml github-job-92pjk
apiVersion: tekton.dev/v1beta1
kind: PipelineRun
...
spec:
  pipelineRef:
    name: docker-build
  resources:
  - name: app-git
    resourceSpec:
      params:
      - name: revision
        value: 17bb6ac63b8d504dc9d635cd2b6be396bc9964b3
      - name: url
        value: https://github.com/faust64/docker-registry-exporter.git
      type: git
  - name: app-image
    resourceSpec:
      params:
      - name: url
        value: registry.registry.svc.cluster.local:5000/ci/docker-registry-exporter:17bb6ac63b8d504dc9d635cd2b6be396bc9964b3
      type: image
  serviceAccountName: tkn-ci
  timeout: 1h0m0s

Comme prévu, le job a bien utilisé le hash reçu par notre notification, pour cloner le dépôt source, et tagguer l’image correspondante.

Nous pourrions par la suite compléter notre Pipeline, intégration continue, publication d’une release si le commit s’est fait sur votre branche master, …

Tekton CLI

Notons que Tekton fourni son propre client, tkn, téléchargeable depuis leur dépôt GitHub.

Celui-ci aura l’avantage de simplifier l’interraction avec vos jobs. Rien de révolutionnaire, son utilisation n’est en aucun cas obligatoire, kubectl peut tout faire, mais propose moins d’automatismes.

Citons par exemple l’execution de Tasks ou Pipelines, sans que l’on ait à rédiger de TaskRun ou PipelineRun. Tkn permet aussi de suivre les logs d’un job, aggregeant la sortie de l’ensemble des conteneurs en question, là ou Kubectl ne suivra qu’un conteneur à la fois.

Tekton Dashboard

Pour l’instant, nous avons manipulé exclusivement en ligne de commande, mais l’écosystème Tekton dispose bien sûr d’une Dashboard.

À nouveau, nous pourrons installer la dernière release, disponible sur GitHub :

$ kubectl apply -f https://github.com/tektoncd/dashboard/releases/download/v0.12.0/tekton-dashboard-release.yaml
$ kubectl get pods -n tekton-pipelines
NAME                                           READY   STATUS    RESTARTS   AGE
tekton-dashboard-56c78f485b-fw4tn              1/1     Running   0          2m
tekton-pipelines-controller-5cdb46974f-fzfdh   1/1     Running   0          50m
tekton-pipelines-webhook-6479d769ff-wxbxr      1/1     Running   0          50m
tekton-triggers-controller-5994f6c94b-fw2dm    1/1     Running   0          26m
tekton-triggers-webhook-68c7866d8-zdttm        1/1     Running   0          26m

Le Pod tekton-dashboard ayant démarré, il nous reste à créer un Ingress, exposant la Dashboard en dehors du SDN Kubernetes :

$ cat <<EOF | kubectl apply -f-
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: tekton-dashboard
  namespace: tekton-pipelines
spec:
  rules:
  - host: tekton.router.example.com
    http:
      paths:
      - backend:
          serviceName: tekton-dashboard
          servicePort: 9097
EOF

Nous pouvons maintenant nous y connecter, depuis un navigateur. Nous y retrouverons nos PipelineRuns :

Pipeline run

Les EventListeners :

Event listener

Nous pourrons consulter les logs d’un job :

Log job

Importer des Tasks ou Pipelines depuis une source externe :

Import Tasks ou Pipeline

Ou lancer un Pipeline, sans passer par la ligne de commande :

image create pipeline

Dans l’ensemble cette Dashboard fait tout ce que l’on peut en attendre, mais il reste à notre charge d’identifier les utilisateurs s’y connectant, et peu probable que l’on puisse facilement restreindre le champ d’action d’un utilisateur une fois celui-ci connecté. Nous pourrions de meme regretter quelques soucis, de longue date, avec les navigateurs Chrome – Firefox et ses dérivés fonctionnent parfaitement.

Conclusion

La suite Tekton simplifie l’implémentation d’une chaine d’intégration et déploiement continues. Si OpenShift pouvait disposer d’un avantage certain dans ce domaine, en proposant les objets de type BuildConfig, Tekton nous offre ici une solution native Kubernetes, tout aussi capable.

Sachant que le projet en est toujours dans ses premières annéés, la roadmap reste conséquente et les fonctionnalitées qu’il reste à implementer ne manquent pas. Depuis décembre 2020, les dernière releases de Tekton Pipelines, Tekton Triggers et Tekton Dashboard permettent enfin de déployer Tekton sur ARM. Le cycle de release est assez soutenu, le projet murit doucement.

L’essentiel est là, fiable, malgrès une relative complexitée à mettre en oeuvre – les adeptes d’OpenShift remarqueront que l’exécution d’un job implique beaucoup de ressources, différentes, tandis qu’une BuildConfig restera, en règle générale, beaucoup plus simple. Cette architecture, plus riche, permet déjà une plus grande modularité.

🔲 ☆

Ceph & Kubernetes : Container Storage Interface

Ceph est une solution de SDS (Software Defined Storage) opensource, qui s’intègre avec divers PAAS / IAAS, tels qu’OpenStack, OpenNebula, ou Kubernetes. Donnant suite à notre article concernant le déploiement d’un cluster Kubernetes sur Raspberry Pi, aujourd’hui nous allons voire comment s’interfacer avec un cluster Ceph, pour y héberger les volumes persistants de nos applications.

Logo Ceph

CSI

Depuis janvier 2019, l’implémentation CSI (Container Storage Interface) de Kubernetes est considérée comme stable et se généralise, au point que les versions récentes de Kubernetes ne permettent souvent plus de monter des volumes tel que nous avions pu le documenter en 2018.

Les éditeurs de solutions SDS sont mis à contribution, et doivent implémenter leurs propres contrôleurs, ceux-ci devant automatiser la création, l’expansion ou la purge, ainsi que les montages et détachement de volumes. Dans le cas de Ceph, nous retrouverons le nécessaire sur GitHub.

Raspberry Pi

Dans le contexte de noeuds Raspberry Pi, nous évoquions la chose dans notre précédent article, il faudra prendre en compte que Raspbian ne livre pas le module kernel rbd, habituellement au coeur de toute interaction avec les volumes de type block Ceph.

Mais notons qu’rbd n’est pas indispensable pour autant. Il existe un client alternatif, moins connu, qui nous permettra de manipuler nos volumes Ceph sur nos Raspberry Pi.

Pour se rattacher à un volume, depuis la ligne de commande, nous pourrions utiliser :

# apt-get install ceph-common rbd-nbd
# scp -p root@ceph-host:/etc/ceph/ceph.conf /etc/ceph/
# scp -p root@ceph-host:/etc/ceph/ceph.client.admin.keyring /etc/ceph/
# rbd-nbd -v
<version ceph>
# rbd -p kube ls
<liste de volumes rbd dans le pool kube>
# rbd-nbd map kube/kubernetes-dynamic-pvc-d3c6c506-3247-11eb-a46b-4249a933eab7
/dev/nbd0
# mount /dev/nbd0 /mnt
# date >/mnt/the_date
# ls -1 /mnt
date
lost+found
# mount /mnt
# rbd-nbd unmap /dev/nbd0

ARM

Nous avons pu voir que Raspbian, en l’absence de module rbd, reste néanmoins capable de monter un volume Ceph. Mais qu’en est-il de CSI ?

C’est un autre contre-temps, les images officielles des contrôleurs Ceph CSI n’étant pas publiées pour ARM. Cependant, la question est à l’étude, on retrouve un premier ticket GitHub sur le projet Rook — ayant donné lieu à un second ouvert chez Ceph — mentionnant entre autres les noms de dépôts DockerHub, servant aux tests de contributeurs. Si ces images ne sont pas fréquemment mises à jour, elles sont pour l’instant relativement récentes, et ont le mérite de fonctionner sur ARM. Par ailleurs, qu’elles soient issues de contributions Rook donne bon espoir qu’elles ne soient plus très loin d’être intégrées aux releases officielles.

Un détail à ne pas négliger : certaines images ne sont pour l’instant pas disponible en 32b, il faudra impérativement flasher vos Raspberry Pi avec l’image Raspbian 64b.

Préparatif Ceph

Dans un premier temps, nous allons créer un pool sur notre cluster Ceph devant accueillir les volumes du cluster Kubernetes.

# ceph -c /etc/ceph/ceph.conf osd pool create kube 32

Afin de ne pas ré-utiliser le keyring de l’admin du cluster, nous allons de même créer un utilisateur Ceph, disposant du minimum de privilèges :

# ceph -c /etc/ceph/ceph.conf auth get-or-create client.kube mon 'allow r' osd 'allow class-read object_prefix rbd_children, allow rwx pool=kube' -o /etc/ceph/ceph.client.kube.keyring

Prendre note de la liste des Monitors, du Cluster ID, et du keyring généré :

# grep -E '^mon host|fsid' /etc/ceph/ceph.conf
fsid = eb53775c-ec88-484f-b5f5-b421b55079d7
mon host = [v2:10.42.253.110:3300,v1:10.42.253.110:6789],[v2:10.42.253.111:3300,v1:10.42.253.111:6789],[v2:10.42.253.112:3300,v1:10.42.253.112:6789]

# cat /etc/ceph/ceph.client.kube.keyring
[client.kube]
    key = AQAKfNJeC/z0FhAAbmBgMu0NdWUw2wfua4Lf9Q==
    caps mon = "allow r"
    caps osd = "allow class-read object_prefix rbd_children, allow rwx pool=kube"

Préparatif Kubernetes

Du côté de Kubernetes, il faudra d’abord créer un Namespace :

$ kubectl create ns rbd-provisioner

Préparons ensuite la configuration décrivant comment s’interfacer à notre cluster Ceph. Celle-ci comprend une ConfigMap, listant les Cluster ID et Monitors du cluster et un Secret qui contiendra la clé du keyring créé précédemment :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: ceph-csi-config
  namespace: rbd-provisioner
data:
  config.json: |-
    [
      {
        "clusterID": "eb53775c-ec88-484f-b5f5-b421b55079d7",
        "monitors": [
          "10.42.253.110",
          "10.42.253.111",
          "10.42.253.112"
        ],
        "cephFS": {
          "subvolumeGroup": "k8srpicsi"
        }
      }
    ]
---
apiVersion: v1
kind: Secret
metadata:
  name: ceph-secret-user
  namespace: rbd-provisioner
stringData:
  userID: kube
  userKey: AQAKfNJeC/z0FhAAbmBgMu0NdWUw2wfua4Lf9Q==
EOF

Provisioner

Ensuite, ayant activé les PodSecurityPolicies au déploiement du cluster, nous devrons créer le nécessaire permettant au provisioner CSI l’accès à une partie de l’arboresence du système de fichiers de nos noeuds Kubernetes :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: policy/v1beta1
kind: PodSecurityPolicy
metadata:
  name: rbd-csi-provisioner-psp
spec:
  allowPrivilegeEscalation: true
  allowedCapabilities:
  - 'SYS_ADMIN'
  fsGroup:
    rule: RunAsAny
  privileged: true
  runAsUser:
    rule: RunAsAny
  seLinux:
    rule: RunAsAny
  supplementalGroups:
    rule: RunAsAny
  volumes:
  - 'configMap'
  - 'emptyDir'
  - 'projected'
  - 'secret'
  - 'downwardAPI'
  - 'hostPath'
  allowedHostPaths:
  - pathPrefix: '/dev'
    readOnly: false
  - pathPrefix: '/sys'
    readOnly: false
  - pathPrefix: '/lib/modules'
    readOnly: true
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: rbd-provisioner
  name: rbd-csi-provisioner-psp
rules:
- apiGroups: ['policy']
  resources: ['podsecuritypolicies']
  verbs: ['use']
  resourceNames: ['rbd-csi-provisioner-psp']
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-provisioner-psp
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: rbd-csi-provisioner-psp
  apiGroup: rbac.authorization.k8s.io
EOF

Par ailleurs, le provisioner dépend de l’API du cluster, devant pouvoir lister ses PersistentVolumeClaims, créer et supprimer les objets PersistentVolume, …

Nous ajouterons donc :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-external-provisioner-runner
rules:
- apiGroups: [""]
  resources: ["nodes"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["secrets"]
  verbs: ["get", "list"]
- apiGroups: [""]
  resources: ["events"]
  verbs: ["list", "watch", "create", "update", "patch"]
- apiGroups: [""]
  resources: ["persistentvolumes"]
  verbs: ["get", "list", "watch", "create", "update", "delete", "patch"]
- apiGroups: [""]
  resources: ["persistentvolumeclaims"]
  verbs: ["get", "list", "watch", "update"]
- apiGroups: [""]
  resources: ["persistentvolumeclaims/status"]
  verbs: ["update", "patch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["storageclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshots"]
  verbs: ["get", "list"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotcontents"]
  verbs: ["create", "get", "list", "watch", "update", "delete"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["volumeattachments"]
  verbs: ["get", "list", "watch", "update", "patch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["volumeattachments/status"]
  verbs: ["patch"]
- apiGroups: ["storage.k8s.io"]
  resources: ["csinodes"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotcontents/status"]
  verbs: ["update"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-provisioner-role
subjects:
- kind: ServiceAccount
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
roleRef:
  kind: ClusterRole
  name: rbd-external-provisioner-runner
  apiGroup: rbac.authorization.k8s.io
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: rbd-provisioner
  name: rbd-external-provisioner-cfg
rules:
- apiGroups: [""]
  resources: ["configmaps"]
  verbs: ["get", "list", "watch", "create", "update", "delete"]
- apiGroups: ["coordination.k8s.io"]
  resources: ["leases"]
  verbs: ["get", "watch", "list", "delete", "update", "create"]
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-provisioner-role-cfg
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: rbd-csi-provisioner
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: rbd-external-provisioner-cfg
  apiGroup: rbac.authorization.k8s.io

Enfin, déployons le provisioner.

Notons que les images utilisées ici ont été choisiees pour ARM64. Vous retrouverez l’original des configurations distribuées par Ceph, pour x86, sur leur dépôt GitHub.

$ cat <<EOF | kubectl apply -f-
---
kind: Service
apiVersion: v1
metadata:
  name: csi-rbdplugin-provisioner
  namespace: rbd-provisioner
  labels:
    app: csi-metrics
spec:
  selector:
    app: csi-rbdplugin-provisioner
  ports:
  - name: http-metrics
    port: 8080
    protocol: TCP
    targetPort: 8680
---
kind: Deployment
apiVersion: apps/v1
metadata:
  name: csi-rbdplugin-provisioner
  namespace: rbd-provisioner
spec:
  replicas: 3
  selector:
    matchLabels:
      app: csi-rbdplugin-provisioner
  template:
    metadata:
      labels:
        app: csi-rbdplugin-provisioner
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - csi-rbdplugin-provisioner
            topologyKey: "kubernetes.io/hostname"
      nodeSelector:
        kubernetes.io/arch: arm64
      serviceAccount: rbd-csi-provisioner
      containers:
      - name: csi-provisioner
        image: docker.io/jamesorlakin/multiarch-csi-provisioner:2.0.1
        args:
        - "--csi-address=$(ADDRESS)"
        - "--v=5"
        - "--timeout=150s"
        - "--retry-interval-start=500ms"
        - "--leader-election=true"
        - "--feature-gates=Topology=false"
        - "--default-fstype=ext4"
        - "--extra-create-metadata=true"
        env:
        - name: ADDRESS
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-snapshotter
        image: docker.io/jamesorlakin/multiarch-csi-snapshotter:2.1.1
        args:
        - "--csi-address=$(ADDRESS)"
        - "--v=5"
        - "--timeout=150s"
        - "--leader-election=true"
        env:
        - name: ADDRESS
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        securityContext:
          privileged: true
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-attacher
        image: docker.io/jamesorlakin/multiarch-csi-attacher:3.0.0
        args:
        - "--v=5"
        - "--csi-address=$(ADDRESS)"
        - "--leader-election=true"
        - "--retry-interval-start=500ms"
        env:
        - name: ADDRESS
          value: /csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-resizer
        image: docker.io/jamesorlakin/multiarch-csi-resizer:1.0.0
        args:
        - "--csi-address=$(ADDRESS)"
        - "--v=5"
        - "--timeout=150s"
        - "--leader-election"
        - "--retry-interval-start=500ms"
        - "--handle-volume-inuse-error=false"
        env:
        - name: ADDRESS
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
      - name: csi-rbdplugin
        securityContext:
          privileged: true
          capabilities:
            add: ["SYS_ADMIN"]
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--nodeid=$(NODE_ID)"
        - "--type=rbd"
        - "--controllerserver=true"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--v=5"
        - "--drivername=rbd.csi.ceph.com"
        - "--pidlimit=-1"
        - "--rbdhardmaxclonedepth=8"
        - "--rbdsoftmaxclonedepth=4"
        env:
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        - name: NODE_ID
          valueFrom:
            fieldRef:
              fieldPath: spec.nodeName
        - name: CSI_ENDPOINT
          value: unix:///csi/csi-provisioner.sock
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        - mountPath: /dev
          name: host-dev
        - mountPath: /sys
          name: host-sys
        - mountPath: /lib/modules
          name: lib-modules
          readOnly: true
        - name: ceph-csi-config
          mountPath: /etc/ceph-csi-config/
        - name: keys-tmp-dir
          mountPath: /tmp/csi/keys
      - name: csi-rbdplugin-controller
        securityContext:
          privileged: true
          capabilities:
            add: ["SYS_ADMIN"]
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--type=controller"
        - "--v=5"
        - "--drivername=rbd.csi.ceph.com"
        - "--drivernamespace=$(DRIVER_NAMESPACE)"
        env:
        - name: DRIVER_NAMESPACE
          valueFrom:
            fieldRef:
              fieldPath: metadata.namespace
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: ceph-csi-config
          mountPath: /etc/ceph-csi-config/
        - name: keys-tmp-dir
          mountPath: /tmp/csi/keys
      - name: liveness-prometheus
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--type=liveness"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--metricsport=8680"
        - "--metricspath=/metrics"
        - "--polltime=60s"
        - "--timeout=3s"
        env:
        - name: CSI_ENDPOINT
          value: unix:///csi/csi-provisioner.sock
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        imagePullPolicy: IfNotPresent
      volumes:
      - name: host-dev
        hostPath:
          path: /dev
      - name: host-sys
        hostPath:
          path: /sys
      - name: lib-modules
        hostPath:
          path: /lib/modules
      - name: socket-dir
        emptyDir: {
          medium: "Memory"
        }
      - name: ceph-csi-config
        configMap:
          name: ceph-csi-config
      - name: keys-tmp-dir
        emptyDir: {
          medium: "Memory"
        }
EOF

Suivre le déploiement des Pods provisioner. Dans cette configuration, trois Pods vont se lancer. Une élection décidera d’un contrôleur primaire, qui prendra alors en charge le provisionnement de nos volumes.

Node Plugin

Dans le même temps, nous devrons déployer le second contrôleur en charge de rattacher nos volumes à nos noeuds.

Toujours dans le cas où les PodSecurityPolicies soient actives sur votre cluster, nous devrons créer le nécessaire permettant au contrôleur CSI de manipuler et d’attacher nos volumes aux noeuds de notre cluster.

$ cat <<EOF | kubectl apply -f-
---
apiVersion: policy/v1beta1
kind: PodSecurityPolicy
metadata:
  name: rbd-csi-nodeplugin-psp
spec:
  allowPrivilegeEscalation: true
  allowedCapabilities:
  - 'SYS_ADMIN'
  fsGroup:
    rule: RunAsAny
  privileged: true
  hostNetwork: true
  hostPID: true
  runAsUser:
    rule: RunAsAny
  seLinux:
    rule: RunAsAny
  supplementalGroups:
    rule: RunAsAny
  volumes:
  - 'configMap'
  - 'emptyDir'
  - 'projected'
  - 'secret'
  - 'downwardAPI'
  - 'hostPath'
  allowedHostPaths:
  - pathPrefix: '/dev'
    readOnly: false
  - pathPrefix: '/run/mount'
    readOnly: false
  - pathPrefix: '/sys'
    readOnly: false
  - pathPrefix: '/lib/modules'
    readOnly: true
  - pathPrefix: '/var/lib/kubelet/pods'
    readOnly: false
  - pathPrefix: '/var/lib/kubelet/plugins/rbd.csi.ceph.com'
    readOnly: false
  - pathPrefix: '/var/lib/kubelet/plugins_registry'
    readOnly: false
  - pathPrefix: '/var/lib/kubelet/plugins'
    readOnly: false
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin-psp
  namespace: rbd-provisioner
rules:
- apiGroups: ['policy']
  resources: ['podsecuritypolicies']
  verbs: ['use']
  resourceNames: ['rbd-csi-nodeplugin-psp']
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin-psp
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: rbd-csi-nodeplugin
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: rbd-csi-nodeplugin-psp
  apiGroup: rbac.authorization.k8s.io
EOF

De plus, ce contrôleur doit pouvoir interroger l’API du cluster, à la recherche de ConfigMaps, Secrets et Nodes. Nous ajouterons alors :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: rbd-csi-nodeplugin
  namespace: rbd-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin
rules:
- apiGroups: [""]
  resources: ["nodes"]
  verbs: ["get"]
- apiGroups: [""]
  resources: ["secrets"]
  verbs: ["get"]
- apiGroups: [""]
  resources: ["configmaps"]
  verbs: ["get"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: rbd-csi-nodeplugin
subjects:
- kind: ServiceAccount
  name: rbd-csi-nodeplugin
  namespace: rbd-provisioner
roleRef:
  kind: ClusterRole
  name: rbd-csi-nodeplugin
  apiGroup: rbac.authorization.k8s.io
EOF

Enfin, déployer ce contrôleur :

$ cat <<EOF | kubectl apply -f-
---
kind: DaemonSet
apiVersion: apps/v1
metadata:
  name: csi-rbdplugin
  namespace: rbd-provisioner
spec:
  selector:
    matchLabels:
      app: csi-rbdplugin
  template:
    metadata:
      labels:
        app: csi-rbdplugin
    spec:
      serviceAccount: rbd-csi-nodeplugin
      hostNetwork: true
      hostPID: true
      nodeSelector:
        kubernetes.io/arch: arm64
      dnsPolicy: ClusterFirstWithHostNet
      containers:
      - name: driver-registrar
        securityContext:
          privileged: true
        #image: docker.io/colek42/csi-node-driver-registrar:latest
        image: docker.io/jamesorlakin/multiarch-csi-node-registrar:2.0.0
        args:
        - "--v=5"
        - "--csi-address=/csi/csi.sock"
        - "--kubelet-registration-path=/var/lib/kubelet/plugins/rbd.csi.ceph.com/csi.sock"
        env:
        - name: KUBE_NODE_NAME
          valueFrom:
            fieldRef:
              fieldPath: spec.nodeName
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        - name: registration-dir
          mountPath: /registration
      - name: csi-rbdplugin
        securityContext:
          privileged: true
          capabilities:
            add: ["SYS_ADMIN"]
          allowPrivilegeEscalation: true
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--nodeid=$(NODE_ID)"
        - "--type=rbd"
        - "--nodeserver=true"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--v=5"
        - "--drivername=rbd.csi.ceph.com"
        env:
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        - name: NODE_ID
          valueFrom:
            fieldRef:
              fieldPath: spec.nodeName
        - name: CSI_ENDPOINT
          value: unix:///csi/csi.sock
        imagePullPolicy: "IfNotPresent"
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        - mountPath: /dev
          name: host-dev
        - mountPath: /sys
          name: host-sys
        - mountPath: /run/mount
          name: host-mount
        - mountPath: /lib/modules
          name: lib-modules
          readOnly: true
        - name: ceph-csi-config
          mountPath: /etc/ceph-csi-config/
        - name: plugin-dir
          mountPath: /var/lib/kubelet/plugins
          mountPropagation: "Bidirectional"
        - name: mountpoint-dir
          mountPath: /var/lib/kubelet/pods
          mountPropagation: "Bidirectional"
        - name: keys-tmp-dir
          mountPath: /tmp/csi/keys
      - name: liveness-prometheus
        securityContext:
          privileged: true
        image: quay.io/cephcsi/cephcsi:v3.2.1-arm64
        args:
        - "--type=liveness"
        - "--endpoint=$(CSI_ENDPOINT)"
        - "--metricsport=8680"
        - "--metricspath=/metrics"
        - "--polltime=60s"
        - "--timeout=3s"
        env:
        - name: CSI_ENDPOINT
          value: unix:///csi/csi.sock
        - name: POD_IP
          valueFrom:
            fieldRef:
              fieldPath: status.podIP
        volumeMounts:
        - name: socket-dir
          mountPath: /csi
        imagePullPolicy: "IfNotPresent"
      volumes:
      - name: socket-dir
        hostPath:
          path: /var/lib/kubelet/plugins/rbd.csi.ceph.com
          type: DirectoryOrCreate
      - name: plugin-dir
        hostPath:
          path: /var/lib/kubelet/plugins
          type: Directory
      - name: mountpoint-dir
        hostPath:
          path: /var/lib/kubelet/pods
          type: DirectoryOrCreate
      - name: registration-dir
        hostPath:
          path: /var/lib/kubelet/plugins_registry/
          type: Directory
      - name: host-dev
        hostPath:
          path: /dev
      - name: host-sys
        hostPath:
          path: /sys
      - name: host-mount
        hostPath:
          path: /run/mount
      - name: lib-modules
        hostPath:
          path: /lib/modules
      - name: ceph-csi-config
        configMap:
          name: ceph-csi-config
      - name: keys-tmp-dir
        emptyDir: {
          medium: "Memory"
        }
---
apiVersion: v1
kind: Service
metadata:
  name: csi-metrics-rbdplugin
  namespace: rbd-provisioner
  labels:
    app: csi-metrics
spec:
  ports:
  - name: http-metrics
    port: 8080
    protocol: TCP
    targetPort: 8680
  selector:
    app: csi-rbdplugin
EOF

StorageClass

Nous pourrons conclure avec l’ajout de la StorageClass suivante, faisant le lien entre nos configurations précédentes :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  annotations:
    storageclass.beta.kubernetes.io/is-default-class: "true"
  name: rwo-storage
allowVolumeExpansion: true
parameters:
  clusterID: eb53775c-ec88-484f-b5f5-b421b55079d7
  csi.storage.k8s.io/provisioner-secret-name: ceph-secret-user
  csi.storage.k8s.io/provisioner-secret-namespace: rbd-provisioner
  csi.storage.k8s.io/controller-expand-secret-name: ceph-secret-user
  csi.storage.k8s.io/controller-expand-secret-namespace: rbd-provisioner
  csi.storage.k8s.io/node-stage-secret-name: ceph-secret-user
  csi.storage.k8s.io/node-stage-secret-namespace: rbd-provisioner
  csi.storage.k8s.io/fstype: ext4
  imageFeatures: layering
  imageFormat: "2"
  mapOptions: nbds_max=16
  mounter: rbd-nbd
  pool: kube
  volumeNamePrefix: k8s-rpi-
provisioner: rbd.csi.ceph.com
reclaimPolicy: Delete
volumeBindingMode: Immediate
EOF

Notez que nous passons une option mounter valant rbd-nbd : comme évoqué précédemment, il s’agit de ne pas dépendre du module rbd, absent de la distribution Raspbian.

Tester

Tout est prêt, il ne nous reste plus qu’à tester.

Nous pourrons d’abord créer une PersistentVolumeClaim :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: test-pvc-too
  namespace: default
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 8Gi
EOF

Avant de ne lancer cette commande, depuis un autre terminal, nous pourrons nous rattacher aux logs du provisioner, pour suivre la création de notre volume :

$ kubectl get pods -n rbd-provisioner -w
NAME                                        READY   STATUS              RESTARTS   AGE
csi-rbdplugin-24wk8                         3/3     Running             0          55s
csi-rbdplugin-6kgnk                         3/3     Running             0          51s
csi-rbdplugin-94dnw                         3/3     Running             0          50s
csi-rbdplugin-9l59x                         3/3     Running             0          52s
csi-rbdplugin-c9bv2                         3/3     Running             0          53s
csi-rbdplugin-fl5dx                         3/3     Running             0          50s
csi-rbdplugin-ldqrb                         3/3     Running             0          47s
csi-rbdplugin-m8421                         3/3     Running             0          53s
csi-rbdplugin-n4ckr                         3/3     Running             0          54s
csi-rbdplugin-provisioner-7b59568f8-2n4hd   0/7     ContainerCreating   0          57s
csi-rbdplugin-provisioner-7b59568f8-5xs5q   7/7     Running             0          57s
csi-rbdplugin-provisioner-7b59568f8-h7ks7   0/7     ContainerCreating   0          57s
csi-rbdplugin-sjxkl                         3/3     Running             0          45s
csi-rbdplugin-wzrqm                         3/3     Running             0          49s
csi-rbdplugin-xnskj                         3/3     Running             0          51s
$ kubectl logs -n rbd-provisioner csi-rbdplugin-provisioner-7b59568f8-5xs5q -c csi-provisioner  -f
I0111 09:55:09.400769       1 csi-provisioner.go:121] Version: v2.0.1-0-g4e612cc-dirty
I0111 09:55:09.401039       1 csi-provisioner.go:135] Building kube configs for running in cluster...
I0111 09:55:09.425902       1 connection.go:153] Connecting to unix:///csi/csi-provisioner.sock
W0111 09:55:19.426118       1 connection.go:172] Still connecting to unix:///csi/csi-provisioner.sock
W0111 09:55:29.426155       1 connection.go:172] Still connecting to unix:///csi/csi-provisioner.sock
W0111 09:55:39.426148       1 connection.go:172] Still connecting to unix:///csi/csi-provisioner.sock
I0111 09:55:40.722714       1 common.go:111] Probing CSI driver for readiness
I0111 09:55:40.723054       1 connection.go:182] GRPC call: /csi.v1.Identity/Probe
I0111 09:55:40.723170       1 connection.go:183] GRPC request: {}
I0111 09:55:40.730806       1 connection.go:185] GRPC response: {}
I0111 09:55:40.730985       1 connection.go:186] GRPC error: 
I0111 09:55:40.731014       1 connection.go:182] GRPC call: /csi.v1.Identity/GetPluginInfo
I0111 09:55:40.731030       1 connection.go:183] GRPC request: {}
I0111 09:55:40.733538       1 connection.go:185] GRPC response: {"name":"rbd.csi.ceph.com","vendor_version":"v3.2.1"}
I0111 09:55:40.733699       1 connection.go:186] GRPC error: 
I0111 09:55:40.733728       1 csi-provisioner.go:182] Detected CSI driver rbd.csi.ceph.com
W0111 09:55:40.733766       1 metrics.go:142] metrics endpoint will not be started because `metrics-address` was not specified.
I0111 09:55:40.733790       1 connection.go:182] GRPC call: /csi.v1.Identity/GetPluginCapabilities
I0111 09:55:40.733806       1 connection.go:183] GRPC request: {}
I0111 09:55:40.738163       1 connection.go:185] GRPC response: {"capabilities":[{"Type":{"Service":{"type":1}}},{"Type":{"VolumeExpansion":{"type":1}}},{"Type":{"Service":{"type":2}}}]}
I0111 09:55:40.738676       1 connection.go:186] GRPC error: 
I0111 09:55:40.738816       1 connection.go:182] GRPC call: /csi.v1.Controller/ControllerGetCapabilities
I0111 09:55:40.739012       1 connection.go:183] GRPC request: {}
I0111 09:55:40.741701       1 connection.go:185] GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":5}}},{"Type":{"Rpc":{"type":7}}},{"Type":{"Rpc":{"type":9}}}]}
I0111 09:55:40.742063       1 connection.go:186] GRPC error: 
I0111 09:55:40.743107       1 controller.go:735] Using saving PVs to API server in background
I0111 09:55:40.746567       1 leaderelection.go:243] attempting to acquire leader lease  rbd-provisioner/rbd-csi-ceph-com...
I0111 09:55:40.760038       1 leader_election.go:172] new leader detected, current leader: csi-rbdplugin-provisioner-7b59568f8-xr2g8
I0111 09:56:00.421214       1 leaderelection.go:253] successfully acquired lease rbd-provisioner/rbd-csi-ceph-com
I0111 09:56:00.421229       1 leader_election.go:172] new leader detected, current leader: csi-rbdplugin-provisioner-7b59568f8-5xs5q
I0111 09:56:00.421553       1 leader_election.go:165] became leader, starting
I0111 09:56:00.522001       1 controller.go:820] Starting provisioner controller rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8!
I0111 09:56:00.522051       1 volume_store.go:97] Starting save volume queue
I0111 09:56:00.522170       1 clone_controller.go:66] Starting CloningProtection controller
I0111 09:56:00.522401       1 clone_controller.go:84] Started CloningProtection controller
I0111 09:56:00.623959       1 controller.go:869] Started provisioner controller rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8!

== A ce moment, nous créons le volume décrit précédemment :

I0111 09:56:36.834686       1 controller.go:1317] provision "default/test-pvc-too" class "rwo-storage": started
I0111 09:56:36.835459       1 event.go:282] Event(v1.ObjectReference{Kind:"PersistentVolumeClaim", Namespace:"default", Name:"test-pvc-too", UID:"c06c760d-b718-48a5-b92f-56683049e6d2", APIVersion:"v1", ResourceVersion:"2703309", FieldPath:""}): type: 'Normal' reason: 'Provisioning' External provisioner is provisioning volume for claim "default/test-pvc-too"
I0111 09:56:36.834922       1 controller.go:570] CreateVolumeRequest {Name:pvc-c06c760d-b718-48a5-b92f-56683049e6d2 CapacityRange:required_bytes:8589934592  VolumeCapabilities:[mount: access_mode: ] Parameters:map[clusterID:eb53775c-ec88-484f-b5f5-b421b55079d7 csi.storage.k8s.io/controller-expand-secret-name:ceph-secret-admin csi.storage.k8s.io/controller-expand-secret-namespace:rbd-provisioner csi.storage.k8s.io/fstype:ext4 csi.storage.k8s.io/node-stage-secret-name:ceph-secret-user csi.storage.k8s.io/node-stage-secret-namespace:rbd-provisioner csi.storage.k8s.io/provisioner-secret-name:ceph-secret-admin csi.storage.k8s.io/provisioner-secret-namespace:rbd-provisioner imageFeatures:layering imageFormat:2 mapOptions:nbds_max=16 mounter:rbd-nbd pool:kube volumeNamePrefix:k8s-rpi-] Secrets:map[] VolumeContentSource: AccessibilityRequirements: XXX_NoUnkeyedLiteral:{} XXX_unrecognized:[] XXX_sizecache:0}
I0111 09:56:36.853789       1 connection.go:182] GRPC call: /csi.v1.Controller/CreateVolume
I0111 09:56:36.853869       1 connection.go:183] GRPC request: {"capacity_range":{"required_bytes":8589934592},"name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","parameters":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","volumeNamePrefix":"k8s-rpi-"},"secrets":"***stripped***","volume_capabilities":[{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}}]}

I0111 09:56:41.441551       1 connection.go:185] GRPC response: {"volume":{"capacity_bytes":8589934592,"volume_context":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","imageName":"k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda","journalPool":"kube","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","radosNamespace":"","volumeNamePrefix":"k8s-rpi-"},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda"}}
I0111 09:56:41.441998       1 connection.go:186] GRPC error: 
I0111 09:56:41.442311       1 controller.go:652] create volume rep: {CapacityBytes:8589934592 VolumeId:0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda VolumeContext:map[clusterID:eb53775c-ec88-484f-b5f5-b421b55079d7 csi.storage.k8s.io/pv/name:pvc-c06c760d-b718-48a5-b92f-56683049e6d2 csi.storage.k8s.io/pvc/name:test-pvc-too csi.storage.k8s.io/pvc/namespace:default imageFeatures:layering imageFormat:2 imageName:k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda journalPool:kube mapOptions:nbds_max=16 mounter:rbd-nbd pool:kube radosNamespace: volumeNamePrefix:k8s-rpi-] ContentSource: AccessibleTopology:[] XXX_NoUnkeyedLiteral:{} XXX_unrecognized:[] XXX_sizecache:0}
I0111 09:56:41.442523       1 controller.go:734] successfully created PV pvc-c06c760d-b718-48a5-b92f-56683049e6d2 for PVC test-pvc-too and csi volume name 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
I0111 09:56:41.442582       1 controller.go:750] successfully created PV {GCEPersistentDisk:nil AWSElasticBlockStore:nil HostPath:nil Glusterfs:nil NFS:nil RBD:nil ISCSI:nil Cinder:nil CephFS:nil FC:nil Flocker:nil FlexVolume:nil AzureFile:nil VsphereVolume:nil Quobyte:nil AzureDisk:nil PhotonPersistentDisk:nil PortworxVolume:nil ScaleIO:nil Local:nil StorageOS:nil CSI:&CSIPersistentVolumeSource{Driver:rbd.csi.ceph.com,VolumeHandle:0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda,ReadOnly:false,FSType:ext4,VolumeAttributes:map[string]string{clusterID: eb53775c-ec88-484f-b5f5-b421b55079d7,csi.storage.k8s.io/pv/name: pvc-c06c760d-b718-48a5-b92f-56683049e6d2,csi.storage.k8s.io/pvc/name: test-pvc-too,csi.storage.k8s.io/pvc/namespace: default,imageFeatures: layering,imageFormat: 2,imageName: k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda,journalPool: kube,mapOptions: nbds_max=16,mounter: rbd-nbd,pool: kube,radosNamespace: ,storage.kubernetes.io/csiProvisionerIdentity: 1610358940742-8081-rbd.csi.ceph.com,volumeNamePrefix: k8s-rpi-,},ControllerPublishSecretRef:nil,NodeStageSecretRef:&SecretReference{Name:ceph-secret-user,Namespace:rbd-provisioner,},NodePublishSecretRef:nil,ControllerExpandSecretRef:&SecretReference{Name:ceph-secret-admin,Namespace:rbd-provisioner,},}}
I0111 09:56:41.443201       1 controller.go:1420] provision "default/test-pvc-too" class "rwo-storage": volume "pvc-c06c760d-b718-48a5-b92f-56683049e6d2" provisioned
I0111 09:56:41.443292       1 controller.go:1437] provision "default/test-pvc-too" class "rwo-storage": succeeded
I0111 09:56:41.443313       1 volume_store.go:154] Saving volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
I0111 09:56:41.502958       1 volume_store.go:157] Volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2 saved
I0111 09:56:41.504698       1 event.go:282] Event(v1.ObjectReference{Kind:"PersistentVolumeClaim", Namespace:"default", Name:"test-pvc-too", UID:"c06c760d-b718-48a5-b92f-56683049e6d2", APIVersion:"v1", ResourceVersion:"2703309", FieldPath:""}): type: 'Normal' reason: 'ProvisioningSucceeded' Successfully provisioned volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
E0111 09:56:41.505723       1 controller.go:1443] couldn't create key for object pvc-c06c760d-b718-48a5-b92f-56683049e6d2: object has no meta: object does not implement the Object interfaces
I0111 09:56:41.505847       1 controller.go:1078] Claim processing succeeded, removing PVC c06c760d-b718-48a5-b92f-56683049e6d2 from claims in progress
I0111 09:56:41.505965       1 controller.go:1317] provision "default/test-pvc-too" class "rwo-storage": started
I0111 09:56:41.506001       1 controller.go:1326] provision "default/test-pvc-too" class "rwo-storage": persistentvolume "pvc-c06c760d-b718-48a5-b92f-56683049e6d2" already exists, skipping
I0111 09:56:41.506024       1 controller.go:1080] Stop provisioning, removing PVC c06c760d-b718-48a5-b92f-56683049e6d2 from claims in progress

Nous pouvons alors confirmer que le volume a bien été provisionné :

$ kubectl get pvc
NAME           STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS   AGE
test-pvc-too   Bound    pvc-c06c760d-b718-48a5-b92f-56683049e6d2   8Gi        RWO            rwo-storage    26s

Maintenant, essayons d’étendre ce volume :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: test-pvc-too
  namespace: default
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 16Gi
EOF

A ce stade, la Capacity du PersistentVolumeClaim apparait toujours à 8Gi :

$ kubectl describe pvc test-pvc-too
Name:          test-pvc-too
Namespace:     default
StorageClass:  rwo-storage
Status:        Bound
Volume:        pvc-c06c760d-b718-48a5-b92f-56683049e6d2
Labels:        
Annotations:   pv.kubernetes.io/bind-completed: yes
               pv.kubernetes.io/bound-by-controller: yes
               volume.beta.kubernetes.io/storage-provisioner: rbd.csi.ceph.com
Finalizers:    [kubernetes.io/pvc-protection]
Capacity:      8Gi
Access Modes:  RWO
VolumeMode:    Filesystem
Mounted By:    
Conditions:
  Type                      Status  LastProbeTime                     LastTransitionTime                Reason  Message
  ----                      ------  -----------------                 ------------------                ------  -------
  FileSystemResizePending   True    Mon, 01 Jan 0001 00:00:00 +0000   Mon, 11 Jan 2021 10:05:05 +0000           Waiting for user to (re-)start a pod to finish file system resize of volume on node.
Events:
  Type     Reason                    Age                    From                                                                                             Message
  ----     ------                    ----                   ----                                                                                             -------
  Normal   Provisioning              9m39s                  rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8  External provisioner is provisioning volume for claim "default/test-pvc-too"
  Normal   ExternalProvisioning      9m36s (x2 over 9m39s)  persistentvolume-controller                                                                      waiting for a volume to be created, either by external provisioner "rbd.csi.ceph.com" or manually created by system administrator
  Normal   ProvisioningSucceeded     9m34s                  rbd.csi.ceph.com_csi-rbdplugin-provisioner-7b59568f8-5xs5q_b3ea2092-486f-4ae8-ab41-0793c60da5f8  Successfully provisioned volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
  Warning  ExternalExpanding         71s                    volume_expand                                                                                    Ignoring the PVC: didn't find a plugin capable of expanding the volume; waiting for an external controller to process this PVC.
  Normal   Resizing                  71s                    external-resizer rbd.csi.ceph.com                                                                External resizer is resizing volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
  Normal   FileSystemResizeRequired  70s                    external-resizer rbd.csi.ceph.com                                                                Require file system resize of volume on node
$ kubectl get events
10m         Normal    FileSystemResizeRequired     persistentvolumeclaim/test-pvc-too   Require file system resize of volume on node
10m         Normal    Resizing                     persistentvolumeclaim/test-pvc-too   External resizer is resizing volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
10m         Warning   ExternalExpanding            persistentvolumeclaim/test-pvc-too   Ignoring the PVC: didn't find a plugin capable of expanding the volume; waiting for an external controller to process this PVC.
18m         Normal    ExternalProvisioning         persistentvolumeclaim/test-pvc-too   waiting for a volume to be created, either by external provisioner "rbd.csi.ceph.com" or manually created by system administrator
18m         Normal    Provisioning                 persistentvolumeclaim/test-pvc-too   External provisioner is provisioning volume for claim "default/test-pvc-too"
18m         Normal    ProvisioningSucceeded        persistentvolumeclaim/test-pvc-too   Successfully provisioned volume pvc-c06c760d-b718-48a5-b92f-56683049e6d2
21m         Normal    Provisioning                 persistentvolumeclaim/test-pvc-too   External provisioner is provisioning volume for claim "default/test-pvc-too"

Nous sommes donc en attente que ce volume soit rattaché à un noeud, pour que son système de fichiers soit étendu.

Nous pourrons créer le Pod suivant, pour finaliser l’opération, tout en confirmant que l’on peut bien rattacher nos volumes aux noeuds Kubernetes :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: Pod
metadata:
  name: ceph-test
  namespace: default
spec:
  nodeSelector:
    kubernetes.io/arch: arm64
  containers:
  - name: dummy
    command: [ /bin/sh ]
    args:
    - -c
    - sleep 86400
    image: busybox
    volumeMounts:
    - name: mypvc
      mountPath: /data
  securityContext:
    runAsUser: 1001
  volumes:
  - name: mypvc
    persistentVolumeClaim:
      claimName: test-pvc-too
EOF

Nous pourrons suivre les logs d’attachement du volume, depuis le Pod rbdplugin s’executant sur le noeud où notre conteneur de test a été schedulé :

$ kubectl get pods -o wide | grep ceph-test
ceph-test   1/1     Running   0          8s    10.233.198.3   erato.friends.intra.example.com

$ kubectl get pods -o wide -n rbd-provisioner | grep erato
csi-rbdplugin-ldqrb    3/3     Running   0          24m   10.42.253.46    erato.friends.intra.example.com

$ kubectl logs -n rbd-provisioner csi-rbdplugin-ldqrb -c csi-rbdplugin
...
I0111 10:07:32.267613     537 utils.go:132] ID: 15 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:32.267854     537 utils.go:133] ID: 15 GRPC request: {}
I0111 10:07:32.269571     537 utils.go:138] ID: 15 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:32.296373     537 utils.go:132] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC call: /csi.v1.Node/NodeStageVolume
I0111 10:07:32.298122     537 utils.go:133] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC request: {"secrets":"***stripped***","staging_target_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount","volume_capability":{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}},"volume_context":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","imageName":"k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda","journalPool":"kube","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","radosNamespace":"","storage.kubernetes.io/csiProvisionerIdentity":"1610358940742-8081-rbd.csi.ceph.com","volumeNamePrefix":"k8s-rpi-"},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda"}
I0111 10:07:32.299358     537 rbd_util.go:808] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda setting disableInUseChecks on rbd volume to: false
I0111 10:07:32.375106     537 omap.go:84] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda got omap values: (pool="kube", namespace="", name="csi.volume.4b509ebf-53f3-11eb-a32d-e210cfc3feda"): map[csi.imageid:1004b3115f3d9b csi.imagename:k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda csi.volname:pvc-c06c760d-b718-48a5-b92f-56683049e6d2]
I0111 10:07:34.685087     537 cephcmds.go:59] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda command succeeded: rbd [device list --format=json --device-type nbd]
I0111 10:07:36.260359     537 rbd_attach.go:215] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd: map mon 10.42.253.110,10.42.253.111,10.42.253.112
I0111 10:07:38.881072     537 cephcmds.go:59] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda command succeeded: rbd [--id kube -m 10.42.253.110,10.42.253.111,10.42.253.112 --keyfile=***stripped*** map kube/k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda --device-type nbd --options nbds_max=16]
I0111 10:07:38.881490     537 nodeserver.go:291] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd image: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda/kube was successfully mapped at /dev/nbd0
I0111 10:07:42.568682     537 nodeserver.go:230] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd: successfully mounted volume 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda to stagingTargetPath /var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount/0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
I0111 10:07:42.568974     537 utils.go:138] ID: 16 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC response: {}
I0111 10:07:42.584611     537 utils.go:132] ID: 17 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:42.585122     537 utils.go:133] ID: 17 GRPC request: {}
I0111 10:07:42.585505     537 utils.go:138] ID: 17 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:42.592659     537 utils.go:132] ID: 18 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:42.593737     537 utils.go:133] ID: 18 GRPC request: {}
I0111 10:07:42.594932     537 utils.go:138] ID: 18 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:42.606252     537 utils.go:132] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC call: /csi.v1.Node/NodeExpandVolume
I0111 10:07:42.606900     537 utils.go:133] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC request: {"capacity_range":{"required_bytes":17179869184},"staging_target_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount","volume_capability":{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda","volume_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount"}
I0111 10:07:44.925118     537 cephcmds.go:59] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda command succeeded: rbd [device list --format=json --device-type nbd]
I0111 10:07:45.529426     537 utils.go:138] ID: 19 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC response: {}
I0111 10:07:45.583743     537 utils.go:132] ID: 20 GRPC call: /csi.v1.Node/NodeGetCapabilities
I0111 10:07:45.583850     537 utils.go:133] ID: 20 GRPC request: {}
I0111 10:07:45.584001     537 utils.go:138] ID: 20 GRPC response: {"capabilities":[{"Type":{"Rpc":{"type":1}}},{"Type":{"Rpc":{"type":2}}},{"Type":{"Rpc":{"type":3}}}]}
I0111 10:07:45.606729     537 utils.go:132] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC call: /csi.v1.Node/NodePublishVolume
I0111 10:07:45.607477     537 utils.go:133] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC request: {"staging_target_path":"/var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount","target_path":"/var/lib/kubelet/pods/4e062abc-7fd4-4384-9c77-9469dde98fe4/volumes/kubernetes.io~csi/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/mount","volume_capability":{"AccessType":{"Mount":{"fs_type":"ext4"}},"access_mode":{"mode":1}},"volume_context":{"clusterID":"eb53775c-ec88-484f-b5f5-b421b55079d7","csi.storage.k8s.io/pv/name":"pvc-c06c760d-b718-48a5-b92f-56683049e6d2","csi.storage.k8s.io/pvc/name":"test-pvc-too","csi.storage.k8s.io/pvc/namespace":"default","imageFeatures":"layering","imageFormat":"2","imageName":"k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda","journalPool":"kube","mapOptions":"nbds_max=16","mounter":"rbd-nbd","pool":"kube","radosNamespace":"","storage.kubernetes.io/csiProvisionerIdentity":"1610358940742-8081-rbd.csi.ceph.com","volumeNamePrefix":"k8s-rpi-"},"volume_id":"0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda"}
I0111 10:07:45.608877     537 nodeserver.go:518] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda target /var/lib/kubelet/pods/4e062abc-7fd4-4384-9c77-9469dde98fe4/volumes/kubernetes.io~csi/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/mount
isBlock false
fstype ext4
stagingPath /var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount/0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
readonly false
mountflags [bind _netdev]
I0111 10:07:45.643938     537 nodeserver.go:426] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda rbd: successfully mounted stagingPath /var/lib/kubelet/plugins/kubernetes.io/csi/pv/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/globalmount/0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda to targetPath /var/lib/kubelet/pods/4e062abc-7fd4-4384-9c77-9469dde98fe4/volumes/kubernetes.io~csi/pvc-c06c760d-b718-48a5-b92f-56683049e6d2/mount
I0111 10:07:45.644138     537 utils.go:138] ID: 21 Req-ID: 0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda GRPC response: {}

Et enfin confirmer que le volume a bien été agrandi :

$ kubectl exec -it ceph-test -- /bin/sh
/ $ df -h /data
Filesystem                Size      Used Available Use% Mounted on
/dev/nbd0                15.6G     44.0M     15.6G   0% /data
/ $ exit
$ kubectl get pvc
NAME           STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS   AGE
test-pvc-too   Bound    pvc-c06c760d-b718-48a5-b92f-56683049e6d2   16Gi       RWO            rwo-storage    12m
$ kubectl delete pod ceph-test
EOF

Moins critique, mais à contrôler tout de même, vérifions que la suppression d’un volume fonctionne :

$ kubectl describe pv pvc-c06c760d-b718-48a5-b92f-56683049e6d2
Name:            pvc-c06c760d-b718-48a5-b92f-56683049e6d2
Labels:          
Annotations:     pv.kubernetes.io/provisioned-by: rbd.csi.ceph.com
Finalizers:      [kubernetes.io/pv-protection]
StorageClass:    rwo-storage
Status:          Bound
Claim:           default/test-pvc-too
Reclaim Policy:  Delete
Access Modes:    RWO
VolumeMode:      Filesystem
Capacity:        16Gi
Node Affinity:   
Message:         
Source:
    Type:              CSI (a Container Storage Interface (CSI) volume source)
    Driver:            rbd.csi.ceph.com
    FSType:            ext4
    VolumeHandle:      0001-0024-eb53775c-ec88-484f-b5f5-b421b55079d7-0000000000000004-4b509ebf-53f3-11eb-a32d-e210cfc3feda
    ReadOnly:          false
    VolumeAttributes:      clusterID=eb53775c-ec88-484f-b5f5-b421b55079d7
                           csi.storage.k8s.io/pv/name=pvc-c06c760d-b718-48a5-b92f-56683049e6d2
                           csi.storage.k8s.io/pvc/name=test-pvc-too
                           csi.storage.k8s.io/pvc/namespace=default
                           imageFeatures=layering
                           imageFormat=2
                           imageName=k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda
                           journalPool=kube
                           mapOptions=nbds_max=16
                           mounter=rbd-nbd
                           pool=kube
                           radosNamespace=
                           storage.kubernetes.io/csiProvisionerIdentity=1610358940742-8081-rbd.csi.ceph.com
                           volumeNamePrefix=k8s-rpi-
Events:                
$ kubectl delete pvc test-pvc-too

Notons l’imageName, qui correspond au nom du volume du point de vue de notre cluster Ceph, avant de supprimer le PersistentVolumeClaim.

Depuis l’un des noeuds du cluster Ceph, nous pourrons confirmer que ce volume est présent, avant suppression du PersistentVolumeClaim, et qu’il n’existe plus ensuite :

[root@mon1 ~]# rbd -p kube ls | grep k8s-rpi
k8s-rpi-4b509ebf-53f3-11eb-a32d-e210cfc3feda
k8s-rpi-606956de-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-60695852-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-82e2ef87-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-c85d564d-50ea-11eb-9407-4e8ab1a29c3f
k8s-rpi-e10db2bd-526d-11eb-a0b5-0eaaf84a28e4
...
[root@mon1 ~]# rbd -p kube ls | grep k8s-rpi
k8s-rpi-606956de-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-60695852-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-82e2ef87-51d5-11eb-a0b5-0eaaf84a28e4
k8s-rpi-c85d564d-50ea-11eb-9407-4e8ab1a29c3f
k8s-rpi-e10db2bd-526d-11eb-a0b5-0eaaf84a28e4

Une fois la suppression du volume effective sur Kubernetes, nous pouvons confirmer que le volume Ceph correspondant a bien été supprimé.

Création, expansion, suppression, attachement et détachement des volumes du noeud : tout est en ordre.

Registry Docker

Registry Docker

Nous pourrons maintenant passer aux choses sérieuses, de déployer nos premières applications, à commencer par Prometheus, sujet sur lequel nous reviendrons dans un autre article, ou pour patienter, une registry Docker :

$ kubeclt create ns registry
$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: Service
metadata:
  name: registry
  namespace: registry
spec:
  ports:
  - name: registry
    port: 5000
  selector:
    k8s-app: registry
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: registry-pvc
  namespace: registry
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 100Gi
---
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: registry
  namespace: registry
spec:
  replicas: 1
  selector:
    matchLabels:
      name: registry
  template:
    metadata:
      labels:
        name: registry
    spec:
      containers:
      - env:
        - name: REGISTRY_HTTP_ADDR
          value: :5000
        - name: REGISTRY_STORAGE_FILESYSTEM_ROOTDIRECTORY
          value: /var/lib/registry
        image: docker.io/library/registry:2.7.1
        imagePullPolicy: IfNotPresent
        name: registry
        ports:
        - containerPort: 5000
          name: registry
          protocol: TCP
        volumeMounts:
        - mountPath: /var/lib/registry
          name: registry-pvc
      volumes:
      - persitentVolumeClaim:
          claimName: registry-pvc
        name: registry-pvc
EOF

Rappelons alors que nous avions deployé Kubernetes avec, dans l’inventaire Kubespray, la variable suivante :

containerd_config:
  grpc:
    max_recv_message_size: 16777216
    max_send_message_size: 16777216
  debug:
    level: ""
  registries:
    docker.io: "https://registry-1.docker.io"
    katello: "https://katello.vms.intra.example.com:5000"
    "registry.registry.svc.cluster.local:5000": "http://registry.registry.svc.cluster.local:5000"
  max_container_log_line_size: -1
  metrics:
    address: ""
    grpc_histogram: false

Nos noeuds sont donc déjà en mesure d’accéder à cette registry, libre à nous d’y pousser de premières images, … Un point sur lequel nous reviendrons dans un prochain article, consacré à Tekton.

Snapshots

Enfin, notons que depuis Kubernetes 1.17, nous pourrons profiter d’une fonctionnalitée introduite par CSI, et déployer un snapshot controller.

Commencer par créer un ServiceAccount pour lui déléguer les privilèges nécessaire.

$ cat <<EOF | kubectl apply -f-
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: snapshot-controller
  namespace: rbd-provisioner
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: snapshot-controller-runner
rules:
- apiGroups: [""]
  resources: ["persistentvolumes"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["persistentvolumeclaims"]
  verbs: ["get", "list", "watch", "update"]
- apiGroups: ["storage.k8s.io"]
  resources: ["storageclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: [""]
  resources: ["events"]
  verbs: ["list", "watch", "create", "update", "patch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotclasses"]
  verbs: ["get", "list", "watch"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshotcontents"]
  verbs: ["create", "get", "list", "watch", "update", "delete"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshots"]
  verbs: ["get", "list", "watch", "update"]
- apiGroups: ["snapshot.storage.k8s.io"]
  resources: ["volumesnapshots/status"]
  verbs: ["update"]
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: snapshot-controller-role
subjects:
- kind: ServiceAccount
  name: snapshot-controller
  namespace: rbd-provisioner
roleRef:
  kind: ClusterRole
  name: snapshot-controller-runner
  apiGroup: rbac.authorization.k8s.io
---
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: rbd-provisioner
  name: snapshot-controller-leaderelection
rules:
- apiGroups: ["coordination.k8s.io"]
  resources: ["leases"]
  verbs: ["get", "watch", "list", "delete", "update", "create"]
---
kind: RoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: snapshot-controller-leaderelection
  namespace: rbd-provisioner
subjects:
- kind: ServiceAccount
  name: snapshot-controller
  namespace: rbd-provisioner
roleRef:
  kind: Role
  name: snapshot-controller-leaderelection
  apiGroup: rbac.authorization.k8s.io
EOF

Poursuivre en déployant le contrôleur :

$ cat <<EOF | kubectl apply -f-
---
kind: StatefulSet
apiVersion: apps/v1
metadata:
  name: snapshot-controller
  namespace: rbd-provisioner
spec:
  serviceName: snapshot-controller
  replicas: 1
  selector:
    matchLabels:
      app: snapshot-controller
  template:
    metadata:
      labels:
        app: snapshot-controller
    spec:
      serviceAccount: snapshot-controller
      containers:
      - name: snapshot-controller
        image: k8s.gcr.io/sig-storage/snapshot-controller:v3.0.2
        args:
        - "--v=5"
        - "--leader-election=false"
        imagePullPolicy: Always
        securityContext:
          runAsUser: 1001
EOF

Il faudra ensuite créer une VolumeSnapshotClass, semblable à notre StorageClass :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: snapshot.storage.k8s.io/v1beta1
kind: VolumeSnapshotClass
metadata:
  name: csi-rbdplugin-snapclass
driver: rbd.csi.ceph.com
parameters:
  clusterID: eb53775c-ec88-484f-b5f5-b421b55079d7
  snapshotNamePrefix: k8s-rpi-snap-
  csi.storage.k8s.io/snapshotter-secret-name: ceph-secret-admin
  csi.storage.k8s.io/snapshotter-secret-namespace: rbd-provisioner
deletionPolicy: Delete
EOF

Enfin, nous pourrons manipuler nos snapshots Ceph depuis l’API de notre cluster Kubernetes.

Demander la création d’un snapshot d’un volume existant en créant un VolumeSnapshot :

$ cat <<EOF | kubectl apply -f-
---
apiVersion: snapshot.storage.k8s.io/v1beta1
kind: VolumeSnapshot
metadata:
  name: rbd-pvc-snapshot
  namespace: downloads
spec:
  volumeSnapshotClassName: csi-rbdplugin-snapclass
  source:
    persistentVolumeClaimName: medusa-kube
EOF
$ kubectl get volumesnapshot -n downloads
NAME               READYTOUSE   SOURCEPVC     SOURCESNAPSHOTCONTENT   RESTORESIZE   SNAPSHOTCLASS             SNAPSHOTCONTENT                                    CREATIONTIME   AGE
rbd-pvc-snapshot   false        medusa-kube                                         csi-rbdplugin-snapclass   snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225                  31s

Nous pourrons suivre la création du snapshot, en interrogeant les logs de notre contrôleur :

$ kubectl logs -n rbd-provisioner snapshot-controller-0 -f
I0129 13:57:28.404847       1 main.go:66] Version: v3.0.2
I0129 13:57:28.410398       1 main.go:93] Start NewCSISnapshotController with kubeconfig [] resyncPeriod [1m0s]
I0129 13:57:28.412022       1 reflector.go:207] Starting reflector *v1beta1.VolumeSnapshotContent (1m0s) from github.com/kubernetes-csi/external-snapshotter/client/v3/informers/externalversions/factory.go:117
[...]
I0129 14:03:58.732509       1 snapshot_controller_base.go:158] enqueued "downloads/rbd-pvc-snapshot" for sync
I0129 14:03:58.732586       1 snapshot_controller_base.go:202] syncSnapshotByKey[downloads/rbd-pvc-snapshot]
I0129 14:03:58.732611       1 snapshot_controller_base.go:205] snapshotWorker: snapshot namespace [downloads] name [rbd-pvc-snapshot]
I0129 14:03:58.732632       1 snapshot_controller_base.go:328] checkAndUpdateSnapshotClass [rbd-pvc-snapshot]: VolumeSnapshotClassName [csi-rbdplugin-snapclass]
[...]
I0129 14:04:35.033443       1 snapshot_controller_base.go:222] Updating snapshot "downloads/rbd-pvc-snapshot"
I0129 14:04:35.033988       1 snapshot_controller_base.go:358] updateSnapshot "downloads/rbd-pvc-snapshot"
I0129 14:04:35.034056       1 util.go:258] storeObjectUpdate updating snapshot "downloads/rbd-pvc-snapshot" with version 21039253
I0129 14:04:35.034157       1 snapshot_controller.go:180] synchronizing VolumeSnapshot[downloads/rbd-pvc-snapshot]: bound to: "snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225", Completed: true
I0129 14:04:35.034182       1 snapshot_controller.go:182] syncSnapshot [downloads/rbd-pvc-snapshot]: check if we should remove finalizer on snapshot PVC source and remove it if we can
I0129 14:04:35.034228       1 snapshot_controller.go:903] checkandRemovePVCFinalizer for snapshot [rbd-pvc-snapshot]: snapshot status [&v1beta1.VolumeSnapshotStatus{BoundVolumeSnapshotContentName:(*string)(0x40004c1940), CreationTime:(*v1.Time)(0x4000350de0), ReadyToUse:(*bool)(0x4000527b9e), RestoreSize:(*resource.Quantity)(0x4000374c00), Error:(*v1beta1.VolumeSnapshotError)(nil)}]
I0129 14:04:35.034334       1 snapshot_controller.go:858] Checking isPVCBeingUsed for snapshot [downloads/rbd-pvc-snapshot]
I0129 14:04:35.034473       1 snapshot_controller.go:883] isPVCBeingUsed: no snapshot is being created from PVC downloads/medusa-kube
I0129 14:04:35.034515       1 snapshot_controller.go:911] checkandRemovePVCFinalizer[rbd-pvc-snapshot]: Remove Finalizer for PVC medusa-kube as it is not used by snapshots in creation
I0129 14:04:35.059226       1 snapshot_controller.go:851] Removed protection finalizer from persistent volume claim medusa-kube
I0129 14:04:35.059293       1 snapshot_controller.go:191] syncSnapshot[downloads/rbd-pvc-snapshot]: check if we should add invalid label on snapshot
I0129 14:04:35.059312       1 snapshot_controller.go:209] syncSnapshot[downloads/rbd-pvc-snapshot]: validate snapshot to make sure source has been correctly specified
I0129 14:04:35.059329       1 snapshot_controller.go:218] syncSnapshot[downloads/rbd-pvc-snapshot]: check if we should add finalizers on snapshot
I0129 14:04:35.059355       1 snapshot_controller.go:386] syncReadySnapshot[downloads/rbd-pvc-snapshot]: VolumeSnapshotContent "snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225" found
I0129 14:04:39.890672       1 reflector.go:515] github.com/kubernetes-csi/external-snapshotter/client/v3/informers/externalversions/factory.go:117: Watch close - *v1beta1.VolumeSnapshot total 5 items received

Une fois le snapshot finalisé, nous devrions pouvoir confirmer que la colonne READYTOUSE est devenue true :

$ kubectl get volumesnapshot -n downloads
NAME               READYTOUSE   SOURCEPVC     SOURCESNAPSHOTCONTENT   RESTORESIZE   SNAPSHOTCLASS             SNAPSHOTCONTENT                                    CREATIONTIME   AGE
rbd-pvc-snapshot   true         medusa-kube                           8Gi           csi-rbdplugin-snapclass   snapcontent-3cb99542-97e1-45f9-9445-0bbb06e35225   14s            46s

Vérifions aussi sur le cluster Ceph, que notre snapshot est bien présent :

$ rbd -p kube ls
k8s-rpi-02f29ddf-5e51-11eb-a107-3a439f3884b7
...
k8s-rpi-e462aa11-5e54-11eb-a107-3a439f3884b7
k8s-rpi-snap-e725bd91-623a-11eb-8935-9e78daa852af

Controverse

La situation n’est pas parfaite, et il faut ici mentionner un problème de taille, commun à toutes les implémentations de CSI.

Lorsqu’un noeud ne répond plus, son status change en NotReady. Après un timeout, si celui-ci ne s’est pas manifesté, Kubernetes doit re-scheduler les Pods impactés sur un autre noeud.

Mais aujourd’hui, la spécification CSI veut que le contrôleur en charge d’attacher un volume a un noeud, lorsqu’il s’attribue un volume, créé un lease, empêchant l’attachement par un autre noeud lorsque notre volume a un accessModes de ReadWriteOnce.

Ceci implique donc que lorsqu’un noeud devient injoignable, l’attacher en question n’est plus en mesure de relacher son lock. Les Pods rattachés à de tels volumes ne seront pas en mesure de démarrer, tant que le noeud souffrant d’un incident ne sera pas revenu.

Nous pourrons reproduire, en débranchant le réseau d’un noeud hébergeant de tels Pods. Une fois que notre nouveau Pod est schedulé sur un noeud sain, nous retrouverons un évènement tel que le suivant :

Events:
  Type     Reason              Age   From                     Message
  ----     ------              ----  ----                     -------
  Normal   Scheduled           13s   default-scheduler        Successfully assigned downloads/sabnzbd-kube-7fdff54694-5v6zb to melpomene.friends.intra.example.com
  Warning  FailedAttachVolume  13s   attachdetach-controller  Multi-Attach error for volume "pvc-33c81bfe-109f-4439-8979-d5e6309f42fe" Volume is already used by pod(s) sabnzbd-kube-7fdff54694-mzst9

Il s’agit là d’une régression, par rapport aux versions plus anciennes de Kubernetes.

Le plus simple, à ce stade, sera de redémarrer le noeud fautif, en espérant que celui-ci rejoigne bien le cluster – ce qui ne sera pas garanti, notament lors d’incidents impactant un disque.

Pour l’instant, l’utilisation de volumes NFS, quoi que rarement recommandé, sera l’une des dernières pouvant fonctionner sans CSI, et ne souffrant donc pas de ce problème.

Si les premières versions de CSI ne permettaient en aucun cas de remonter un volume lors de tels incidents, notons que les dernières releases ont introduit une solution de contournement. En effet, nous retrouverons aujourd’hui ces locks, empêchant l’accès à une PersistentVolumeClaim par d’autres noeuds, en interrogeant les VolumeAttachments du cluster.

# kubectl describe pvc -n downloads sabnzbd-kube
Name:          sabnzbd-kube
Namespace:     downloads
StorageClass:  rwo-storage
Status:        Bound
Volume:        pvc-33c81bfe-109f-4439-8979-d5e6309f42fe
...
# kubectl get volumeattachments
NAME                                                                 ATTACHER         PV                                       NODE                             ATTACHED   AGE
...
csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f rbd.csi.ceph.com pvc-33c81bfe-109f-4439-8979-d5e6309f42fe clio.friends.intra.example.com   true       23m
...
# kubectl describe volumeattachment csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f
Name:         csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f
...
Spec:
  Attacher:   rbd.csi.ceph.com
  Node Name:  clio.friends.intra.example.com
  Source:
    Persistent Volume Name:  pvc-33c81bfe-109f-4439-8979-d5e6309f42fe
...
# kubectl delete volumeattachment csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f
volumeattachment.storage.k8s.io "csi-f0c7854ca41926e4fd1f766f481c6492b43152b689244fbdb190e7b8bda4106f" deleted
# kubectl get events -n downloads -w
...
0s          Normal    SuccessfulAttachVolume   pod/sabnzbd-kube-7fdff54694-5v6zb    AttachVolume.Attach succeeded for volume "pvc-33c81bfe-109f-4439-8979-d5e6309f42fe"

Après suppression du VolumeAttachment mentionnant le nom de notre PersistentVolume, nous pouvons confirmer que le nouveau Pod démarre finalement.

Et de même, nous pouvons voire que si ce VolumeAttachment n’est pas supprimé, notre Pod témoin refuse de se lancer :

root@pandore:~# kubectl get pods -o wide -n downloads -w
NAME                                  READY  STATUS             RESTARTS  AGE    IP              NODE
backups-kube-64fb9d44cd-dgdws         2/2    Running            0         13m    10.233.198.25   erato.friends.intra.example.com
medusa-kube-7ff5cbfd66-4jrj5          0/2    ContainerCreating  0         6m24s            euterpe.friends.intra.example.com
medusa-kube-7ff5cbfd66-zhr7f          2/2    Terminating        0         15m    10.233.197.116  clio.friends.intra.example.com
newznab-kube-669d69ddc8-8r682         4/4    Running            0         7d15h  10.233.193.25   epimethee.friends.intra.example.com
newznab-mariadb-kube-6c67d6b57-2kt5t  2/2    Running            0         7d16h  10.233.195.40   pyrrha.friends.intra.example.com
sabnzbd-kube-7fdff54694-5v6zb         3/4    Running            0         6m24s  10.233.200.39   melpomene.friends.intra.example.com
sabnzbd-kube-7fdff54694-mzst9         4/4    Terminating        0         15m    10.233.197.115  clio.friends.intra.example.com
transmission-kube-c68dd989-9fk2j      4/4    Running            0         7d17h  10.233.195.36   pyrrha.friends.intra.example.com

Une fois nos applications de nouveau joignables, nous pourrons nous pencher sur notre noeud. Si son reboot n’a pas suffit, peut-être voudra-t-on le redéployer, réutilisant les mêmes noms et IPs. Ou le supprimer complètement du cluster, purgeant Node, Pods, VolumeAttachments, … toutes les ressources ingoignables.

Conclusion

Si les plateformes ARM ont pu souffrir du manque de plusieurs fonctionnalités par le passé, notament CSI, elles se prètent de mieux en mieux au déploiement de clusters Kubernetes. On y retrouve aujourd’hui tous les incontournables : Containerd, Prometheus, Tekton, …

Par ailleurs, l’arrivée des Raspberry 4, disposant de 4 ou 8G de mémoire RAM, en font un choix de prédilection, pour le déploiement d’un cluster Kubernetes.

En combinaison avec Ceph : une recette parfaite pour déployer votre cloud à moindre coût. Bien que l’on puisse regretter les lacunes de CSI.

❌