❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

Dans les coulisses de Numéricité : automatiser nos workflows en mode produit

Dans un précédent épisode de nos backstages, on vous présentait Ricobot, notre robot fait maison qui épargne un bon nombre de tracas à notre équipe, et surtout à Marie et Joana. Depuis sa mise en service, le Rico est devenu la pierre angulaire de l’entreprise. Pensé pour simplifier le pilotage des projets, Rico était déjà plein de promesses et voué à évoluer dans le temps.

C’est pourquoi après plusieurs semaines de réflexion, d’échanges et de travail, nous disposons désormais de workflows automatisés qui créent des espaces projets, récupèrent des informations dans nos agendas, classent des documents ou pré-remplissent certaines données administratives. Avec, au milieu de tout cela, un peu d’IA. Mais pas seulement.

Parce qu’avant de se demander « où est-ce qu’on pourrait mettre de l’intelligence artificielle ? », on a commencé par une question beaucoup plus intéressante : qu’est-ce qui nous fait perdre du temps ?

Appliquer le mode produit… à nous-mêmes

Chez Numéricité, on passe une bonne partie de notre temps à dire qu’un bon produit numérique est d’abord conçu à partir des besoins de ses utilisateurs. C’aurait été fort de café de ne pas l’appliquer en interne !

Pour comprendre les usages de l’IA et les besoins de l’équipe, notre stagiaire Mohamed a fait le tour du bureau avec des questions simples : quelles sont les tâches que vous répétez ? Quelles informations recopiez-vous d’un outil à l’autre ? Qu’est-ce que vous devez régulièrement vérifier ? Où perdez-vous du temps ? Qu’est-ce qui vous fait soupirer très fort devant votre écran ?

L’objectif était double : comprendre le quotidien réel de chacune et chacun, et identifier les endroits où une automatisation pouvait avoir un effet concret.

Les premiers échanges, notamment avec Marie et Joana, ont rapidement fait émerger plusieurs sujets côté administratif : l’ouverture des nouveaux projets, le suivi documentaire, les comptes-rendus d’activité ou encore certains processus financiers. Une fois les besoins recensés et priorisés, le chantier pouvait commencer.

Et comme souvent lorsque l’on travaille en mode produit, la solution imaginée au départ n’est pas nécessairement celle que l’on a fini par construire…

Automatiser sans mettre de l’IA partout

Quand on parle aujourd’hui d’automatisation, difficile de ne pas penser directement à l’IA générative et aux grands modèles de langage (LLM). Pour autant, tout problème ne nécessite pas un LLM. Parfois, quelques règles suffisent. D’autres fois, un script peut être plus rapide et moins coûteux. Notre boussole a été de ne retenir l’IA que lorsqu’elle apportait une vraie valeur ajoutée. Par exemple pour interpréter un texte, rapprocher des informations, ou comprendre un document qui n’a pas été standardisé. En somme, choisir à chaque étape la solution la plus appropriée pour répondre aux besoins de l’équipe .

Pour orchestrer tout ça, Mohamed s’est plongé dans n8n, un outil permettant d’enchaîner des actions entre différents services. Une première pour lui, où il a fallu tester, casser quelques workflows, les reconstruire, comprendre comment faire dialoguer nos outils de tous les jours… Il a pu compter sur l’aide de Mehdi, déjà grand utilisateur de n8n.

Petit à petit, Slack, Nextcloud et Ricobot ont commencé à discuter entre eux. Mais pour que Rico puisse participer à la conversation, une pièce manquait : une API.

💡Qu’est-ce qu’une API ?

Une API (Application Programming Interface, ou interface de programmation) est un moyen standardisé permettant à deux applications de communiquer entre elles. Elle définit les règles selon lesquelles un outil peut demander, envoyer ou modifier des données dans un autre, sans avoir besoin d’en connaître le fonctionnement interne.

Pour que ces outils puissent réellement dialoguer avec Rico (et rendre le terrain de jeu encore plus intéressant) il a donc fallu la créer.

Ces premières explorations ont donné lieu à trois cas d’usage qui montrent que l’important ce n’est pas forcément l’outil, mais bien l’usage pour lequel il est conçu !

Premier chantier – Comment huiler la transmission d’informations au début d’un projet ?

Lorsqu’une mission commence, on a quelques réflexes afin que les informations soient “in the open” et partagée à toutes et tous. Des choses aussi banales que créer un canal dédié au projet sur Slack, les dossiers correspondants dans Nextcloud (notre serveur de stockage), s’assurer que les équipes projets aient les accès nécessaires, ajouter les bonnes informations, et évidemment créer le projet dans Ricobot. Une série de petits gestes qui semblent anodins mais qui sont essentiels bien qu’à la longue ils deviennent chronophages et multiplient les ressaisies d’informations, et donc les possibilités de faire des erreurs.

Vous nous voyez venir, la première idée était donc très simple. Chaque nouvelle création de projet déclenche automatiquement la création du message Slack, des canaux et des dossiers associés. Après quelques tests, on s’est rendus compte que le frein n’était pas seulement dû à la multiplication des actions, mais aussi à un manque d’informations.

Pour créer correctement tous ces éléments, le workflow devait disposer d’un certain nombre d’informations : nom du projet, personnes concernées, client, modalités de suivi… En plus de déclencher les différentes actions, le prototype récupère désormais toutes ces informations en amont.

Une itération n’arrive jamais seule, et une étape supplémentaire s’est imposée par la pratique. Comme dans n’importe quel projet numérique, on ne peut pas faire fi de l’humain – du moins c’est notre conviction. Dans celui-ci, une vérification manuelle s’est imposée pour éviter les erreurs ou les oublis avant la création des espaces de travail et la transmission des éléments à l’équipe mobilisée. Si la confiance n’exclut pas le contrôle, il en est de même pour l’automatisation. Automatiser ne rime pas avec supprimer toute intervention humaine du processus. C’est peut être un détail pour vous, mais c’est un élément central de notre façon de faire.

Deuxième chantier : pré-remplir Ricobot sur la base de nos agendas Outlook 

Dans cette lancée, on a voulu continuer à développer le Ricobot. Vous l’aviez peut être découvert dans les backstages précédentes, Rico est notre outil interne de pilotage des activités. Il facilite notamment le suivi des activités de chaque membre de l’équipe sur chacun des projets qui lui sont attribués et la consommation du temps.

Tout le monde dans l’équipe a déjà entendu Marie et Joana dire au dernier stand-up du mois “pensez à bien remplir vos CRA (compte-rendu d’activité, ndlr), on va facturer !”. Pour cela, on a rendez-vous sur notre espace individuel Ricobot. Et c’est là que le bât blesse : comment reconstituer finement l’activité d’un mois quand on travaille sur plusieurs projets en parallèle ?

Avec les fonctionnalités de prises de note et de complétion automatique des CRA qui existaient déjà, Ricobot apporte une première partie de la réponse. L’idée était de compléter le suivi – qu’on fait plus ou moins au cours du mois – en s’appuyant sur les informations de nos agendas électroniques et éviter de remplir plusieurs fois une même information.

Pour chaque événement de l’agenda Outlook, le système analyse notamment son intitulé, sa durée et les informations disponibles. Il commence par rechercher des correspondances avec les missions en cours dans Ricobot à partir de règles et de mots-clés. Quand celles-ci suffisent, inutile d’aller plus loin. Lorsqu’aucune correspondance évidente n’est trouvée, un modèle d’IA installé localement peut prendre le relais et tenter de rapprocher l’événement des missions connues de la personne.

Le résultat est ensuite envoyé à Ricobot grâce à sa nouvelle API. Le but n’est pas que Rico décide tout seul de ce que chacun a fait pendant sa journée. Le système pré-remplit un suivi, que chaque personne peut ensuite vérifier, corriger ou compléter.

💡L’importance de la qualité de nos données

Ce chantier a mis en lumière l’importance d’une bonne convention de nommage, partagée par l’ensemble de l’équipe. C’est en partie pour cela que le premier chantier était important, car il permettait d’uniformiser les informations. Car si un même projet a un nom différent sur chacun de nos outils, la meilleure automatisation ne parviendra pas à faire le rapprochement. Automatiser, c’est aussi standardiser nos pratiques internes et être plus rigoureux dans la complétion des informations.

Troisième chantier : remettre un peu d’ordre dans la jungle documentaire

Autre terrain fertile : les documents administratifs et financiers. Ils arrivent par mail, puis il faut les télécharger, comprendre à quel projet ils se rapportent, les ranger dans Nextcloud et suivre ce qu’il reste à en faire. À mesure que leur nombre augmente, garder une vision claire devient vite compliqué.

Nous avons imaginé une application capable de prendre en charge une partie de ce parcours. Lorsqu’un mail avec une pièce jointe arrive, le système récupère le document et en extrait les informations utiles à son classement : client, date, sujet, référence ou projet concerné.

Pour limiter le recours à l’IA et son coût, le document est d’abord transformé en texte et débarrassé des informations inutiles. Le modèle n’intervient ensuite que pour analyser ce contenu et aider à identifier le bon projet ou le bon classement. L’application peut alors proposer un dossier existant dans Nextcloud, permettre d’en créer un s’il manque, ou laisser l’utilisateur rechercher manuellement le bon emplacement.

💡Un traitement particulier pour les bons de commande

Lorsque le système détecte que le document est un bon de commande, il peut rechercher à la fois dans Nextcloud et dans Ricobot, extraire les informations importantes du document (montant, dates, références) et en générer certaines lorsqu’elles manquent. Toutes ces données viennent ensuite pré-remplir un formulaire. Là encore, l’humain conserve le contrôle : Marie ou Joana peuvent modifier et compléter ce qui manque avant validation et enregistrement automatique dans le Ricobot.

L’application embarque également un système de statuts : document classé, en attente, signé, à signer, à renvoyer… On peut filtrer les documents par état, les prévisualiser ou les télécharger directement. L’intérêt n’est alors plus seulement d’éviter quelques clics entre une boîte mail et Nextcloud. Nous obtenons progressivement un point d’entrée unique pour suivre le cycle de vie des documents. Au lieu de se demander si l’information est dans le mail, dans Nextcloud ou dans Ricobot, on dispose d’une vue centralisée du travail restant à faire.

La technologie révèle aussi les problèmes d’organisation

Ces expérimentations ont confirmé quelque chose que nous observons régulièrement chez nos clients : une automatisation fonctionne d’autant mieux que le processus qu’elle automatise est clair.

Pour rapprocher automatiquement un événement d’un projet, encore faut-il que les projets portent des noms cohérents. Pour ranger automatiquement un document, encore faut-il que l’arborescence des dossiers soit compréhensible. Pour déclencher correctement l’ouverture d’un nouveau projet, encore faut-il savoir quelles informations sont obligatoires et qui doit les valider.

Autrement dit, l’automatisation ne masque pas les incohérences d’un processus. Elle a plutôt tendance à les mettre sous un énorme projecteur. Le travail ne consiste finalement pas seulement à mettre de l’IA dans nos outils mais aussi à simplifier, documenter et harmoniser nos façons de travailler.

La prochaine étape sera la plus intéressante : déployer les premiers workflows auprès des équipes. Observer comment ils sont utilisés. Identifier les erreurs. Ajuster la fréquence de synchronisation. Déterminer à quels endroits les contrôles humains sont nécessaires. Standardiser certaines conventions, notamment dans les agendas et les noms de projets.

En bref : faire du produit. Les vrais enseignements viendront de Marie, Joana et du reste de l’équipe lorsqu’ils et elles commenceront à utiliser ces outils chaque jour.

Et la suite ?

La liste des candidats à l’automatisation est loin d’être terminée.

Les notes de frais constituent déjà un prochain terrain d’expérimentation. Un premier bot existe, mais génère encore des erreurs et des doublons. L’objectif serait de pouvoir déclarer une dépense simplement, ranger automatiquement son justificatif dans Nextcloud et compléter les informations nécessaires dans le fichier de suivi, avant une dernière vérification humaine.

Autre piste : les marchés et appels d’offres. Au fil du temps, Numéricité accumule une quantité importante d’expériences, de références et de compétences mobilisables. Notre futur enjeu sera de mieux structurer cette connaissance pour pouvoir analyser nos marchés gagnés et perdus, comprendre les facteurs qui ont joué et, à terme, rapprocher automatiquement une nouvelle offre des expériences et des profils les plus pertinents au sein du collectif.

Ici encore, le sujet n’est pas de demander à une IA de faire notre travail à notre place. Il s’agit plutôt de lui confier ce qu’elle sait bien faire – parcourir, rapprocher, extraire, suggérer – pour laisser aux humains ce pour quoi ils sont nettement meilleurs : comprendre le contexte, arbitrer et décider.

☑️ ☆

Mettre en place l’architecture GlobalScale afin de fluidifier votre NextCloud

Introduction

La formule standard de NextCloud est utile pour bien des usages. Cependant, lorsque la volumétrie des utilisateurs évolue et que l’on arrive à des usages plus intenses de NextCloud, on se rend vite compte des limites de ce service. Dans ce cas, on se retrouve confronté à une problématique de taille, à savoir gérer la quantité d’utilisateurs tout en limitant les coûts. C’est là qu’intervient l’offre GlobalScale de NextCloud.

À l’heure où ces lignes sont rédigées il existe peu de documentation sur le sujet. Nous allons tenter de combler ensemble ce manque avec cet article.

GlobalScale permet de répartir la charge du trafic et donc de gérer une utilisation plus intense de NextCloud. Cela aide énormément lorsque l’on veut utiliser NextCloud dans un cadre professionnel à grande échelle ou lorsque l’on en a une utilisation avancée comme par exemple la mise en place de nombreux plugins ou le stockage de fichiers volumineux.

Points importants

Attention: Cette installation a été réalisée sous NextCloud version 20, nous ne pouvons confirmer la validité de cette procédure pour les versions ultérieures.

Dans cet article, nous nous attarderons seulement sur la mise en place de la partie GlobalScale, nous considérerons que vos serveurs Linux sont déjà en place et que les produits de base sont déjà installés.

Les points suivants ne seront pas traités ici :

  • l’adressage IP
  • le dimmensionnement des serveurs
  • l’installation de l’OS
  • la mise en place d’un Reverse Proxy
  • La gestion des certificats
  • la mise en place des bases de données
  • la supervision ou la métrologie
  • la haute disponibilité

Caractéristiques de l’architecture GlobalScale

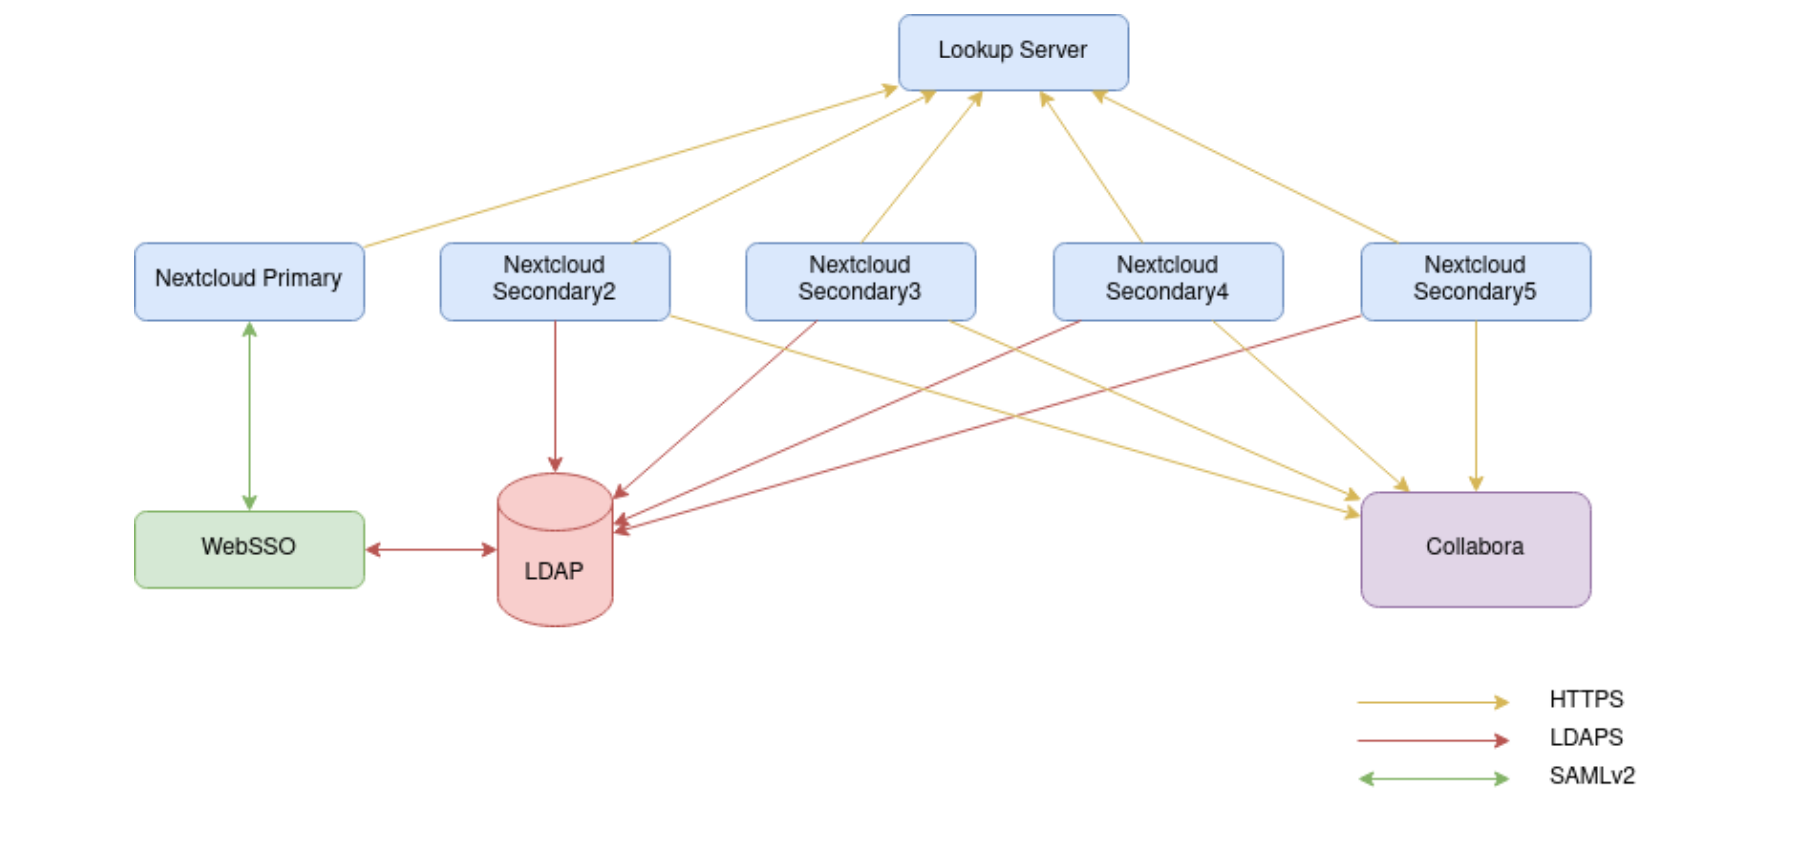
Pour la mise en place de cette architecture, nous aurons besoin basiquement pour la partie NextCloud :

  • d’un serveur primaire NextCloud, qui servira de relai pour rediriger l’utilisateur vers le serveur où sont situées ses données/son espace personnel.
  • d’un ou plusieurs serveurs secondaires sur lesquels nous allons répartir les données de nos utilisateurs, c’est en cela que réside la particularité de cette architecture et qui va permettre d’éviter les goulots d’étranglement.
  • un Lookup server qui sera le serveur interrogé pour rediriger les utilisateurs vers le serveur secondaire sur lequel ils disposent d’un espace personnel.

architecture

Évidemment pour pouvoir identifier nos clients il est nécessaire d’inclure dans cette architecture un portail d’authentification Single Sign-On (SSO) ou un serveur LDAP.

Voici la nomenclature qui sera utilisée :

Nom Rôle Application
nextcloud1.app.domain.com Nextcloud Primaire Nextcloud verison 20
nextcloud2.app.domain.com Nextcloud Secondaire Nextcloud version 20
nextcloud3.app.domain.com Nextcloud Secondaire Nextcloud version 20
ls.app.domain.com Lookup Server Nextcloud version 20
keycloak.app.domain.com WebSSO Keycloak
collabora.domain.com Édition Collaborative Collabora Online

Commençons l’installation !

Installation

Prérequis

Dans notre contexte, voici comment va se présenter notre architecture :

  • les différents nœuds NextCloud,
  • OpenLDAP afin de centraliser les comptes et les informations utilisateurs,
  • Keycloak comme WebSSO s’appuyant sur l’annuaire LDAP pour l’authentification des utilisateurs,
  • Collabora Online, un outil collaboratif open-source basé sur LibreOffice Online.

Remarque: Dans le cadre d’une mise en production, nous pourrions intégrer à cette architecture un serveur REDIS pour les caches de sessions mais cela ne sera pas abordé dans cet article.

L’annuaire OpenLDAP

Dans notre architecture, nous allons nous servir d’OpenLDAP pour centraliser les utilisateurs et faciliter la gestion de leurs données.

Chaque utilisateur disposera de sa fiche qui sera présentée comme ceci:

  • cn : nom d’affichage (prénom / nom)
  • sn : nom de famille
  • givenName : prénom
  • mail : adresse mail
  • nclocator : URL Nextcloud vers ses données
  • uid : uid
  • userPassword : mot de passe utilisateur

Exemple :

cn: John DOE
sn: DOE
givenName: John
mail: john.doe@example.com
nclocator : https://nextcloud-2.example.com/
uid : jdoe
userPassword : $HASH$

Keycloak va s’appuyer sur ces fiches afin de gérer les authentifications des clients et gérer efficacement les accès aux espaces personnels de chacun.

Le WebSSO Keycloak

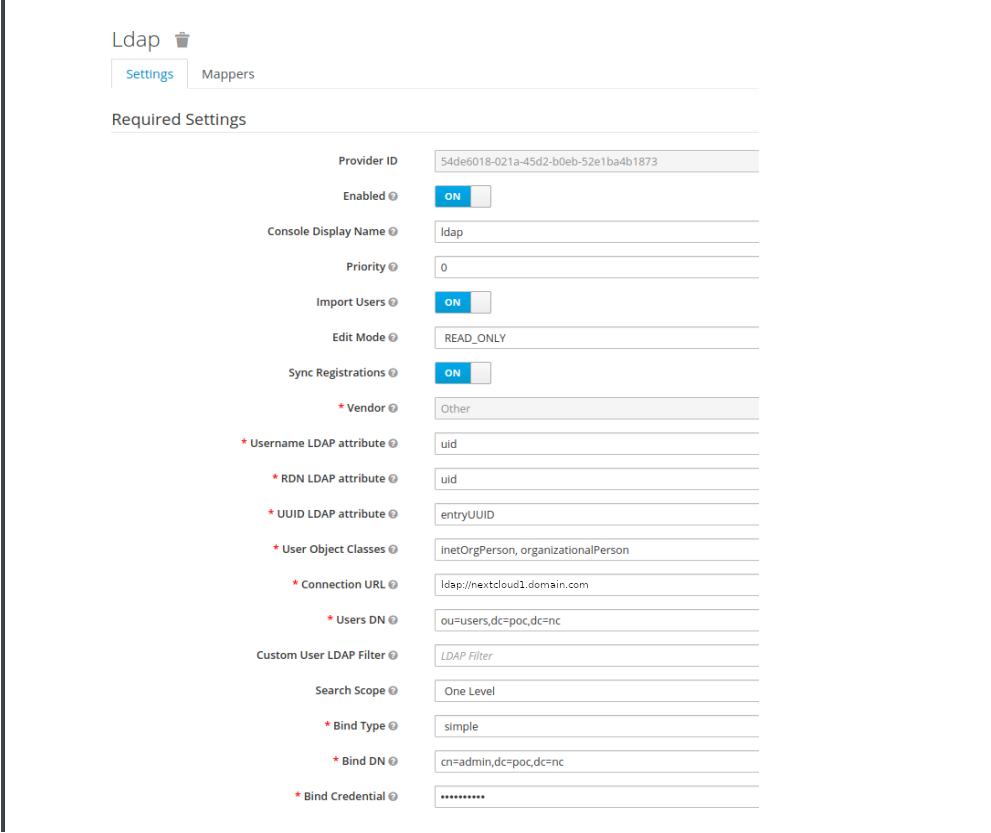
Afin que notre outil de SSO (Single Sign-On) puisse accéder à l’annuaire LDAP pour l’authentification des utilisateurs, il est nécessaire de définir un nouveau fournisseur LDAP comme suit :

Configuration de la Fédération d’utilisateurs

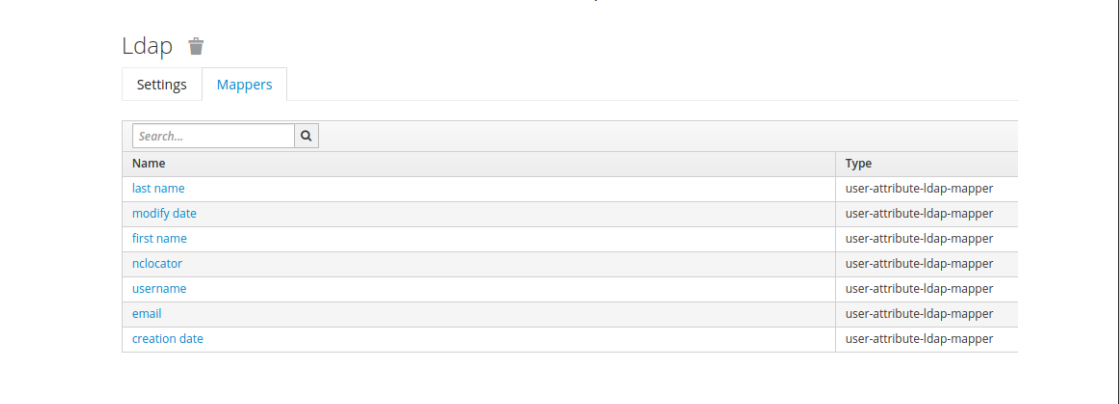
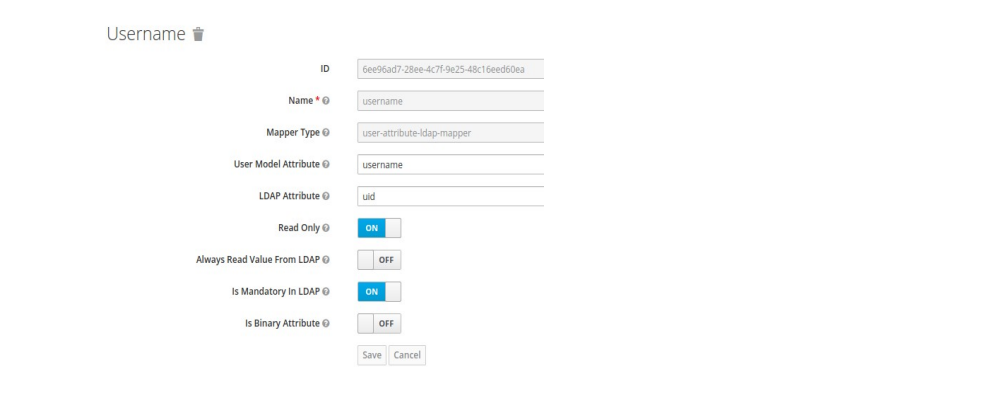
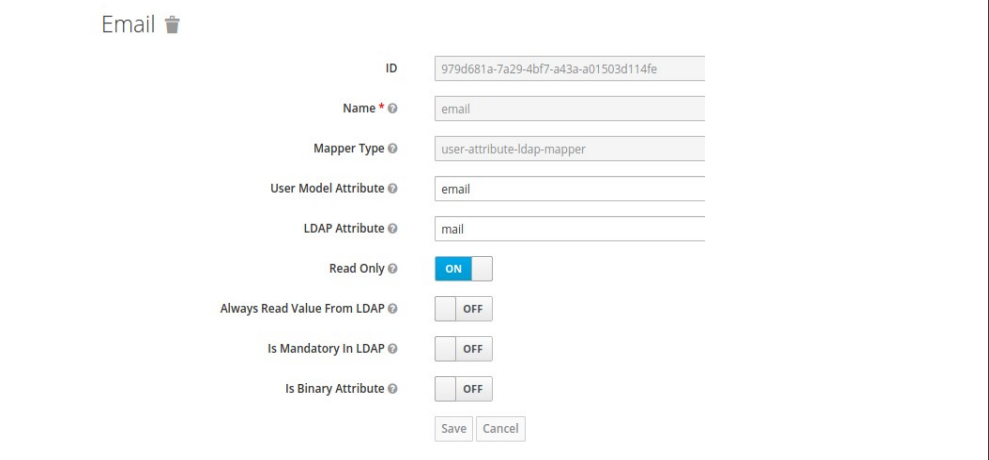
Après avoir défini le nouveau fournisseur, il est nécessaire de faire correspondre les attributs de l’annuaire avec ceux des utilisateurs qui vont être stockés dans Keycloak et qui pourront être transmis aux applications clientes :

LISTE DES ATTIBUTS RÉCUPÉRÉS DU LDAP

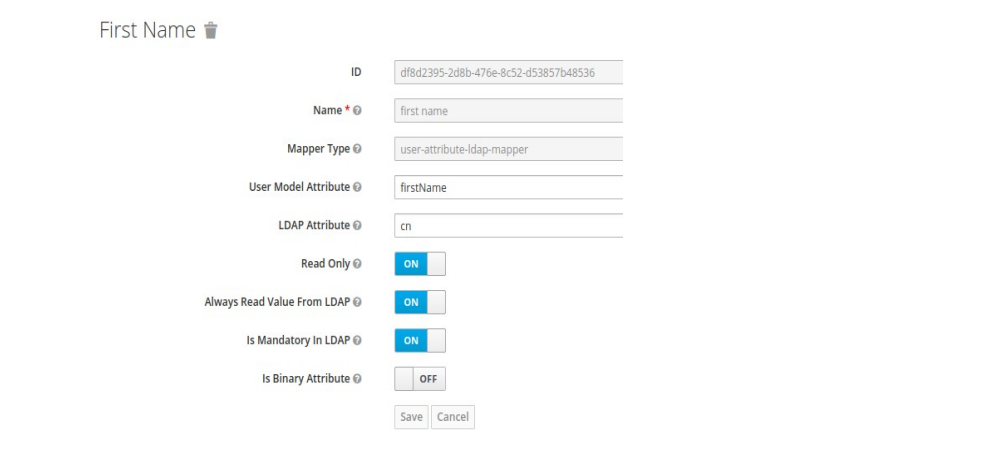
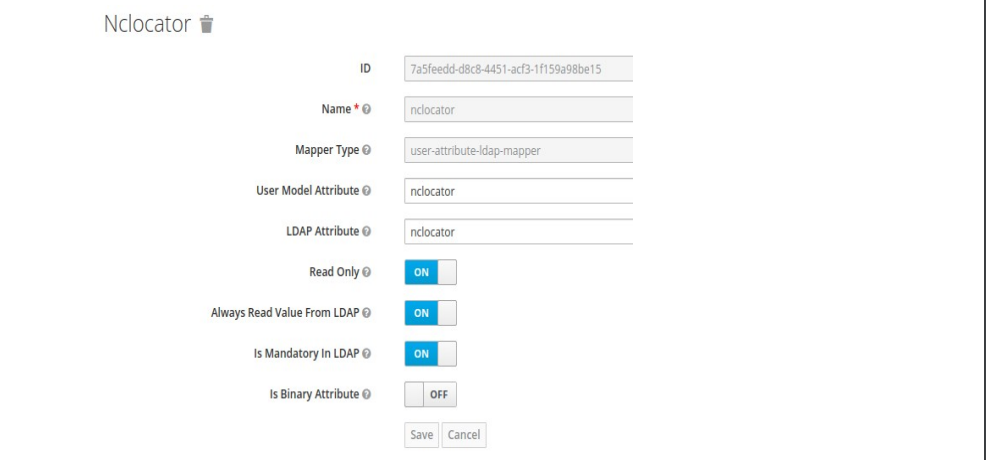
Voici la configuration à adopter pour chaque attribut :

LAST NAME

PRENOM

NCLOCATOR

NOM UTILISATEUR

EMAIL

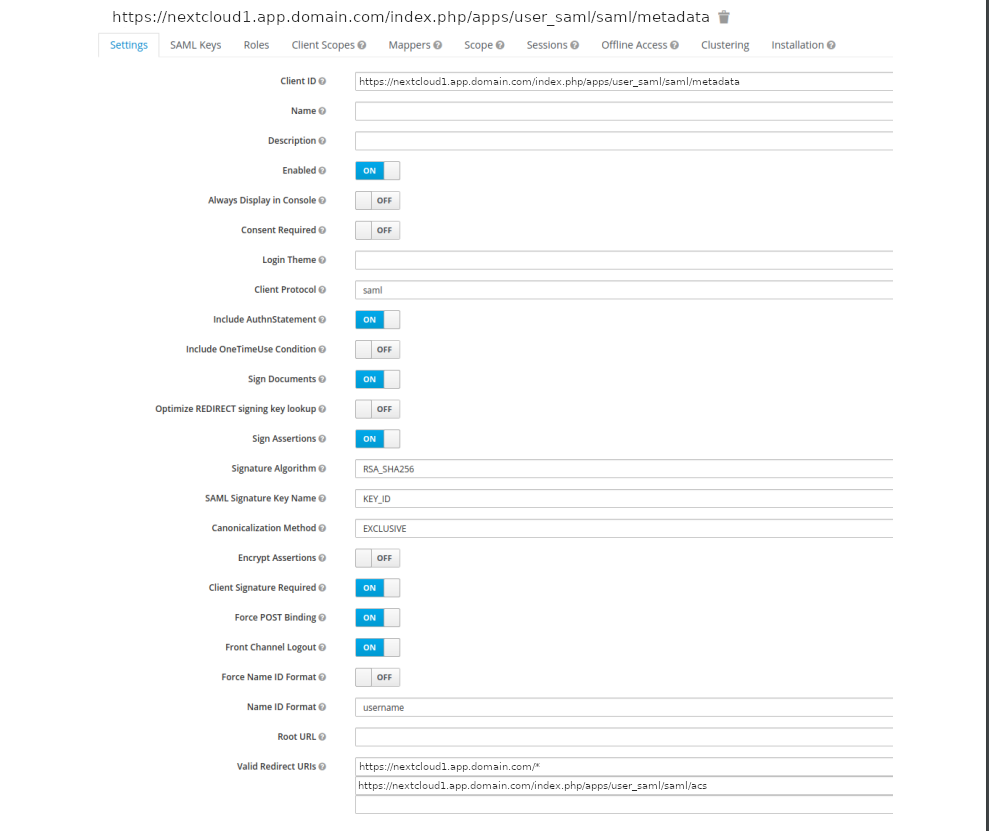
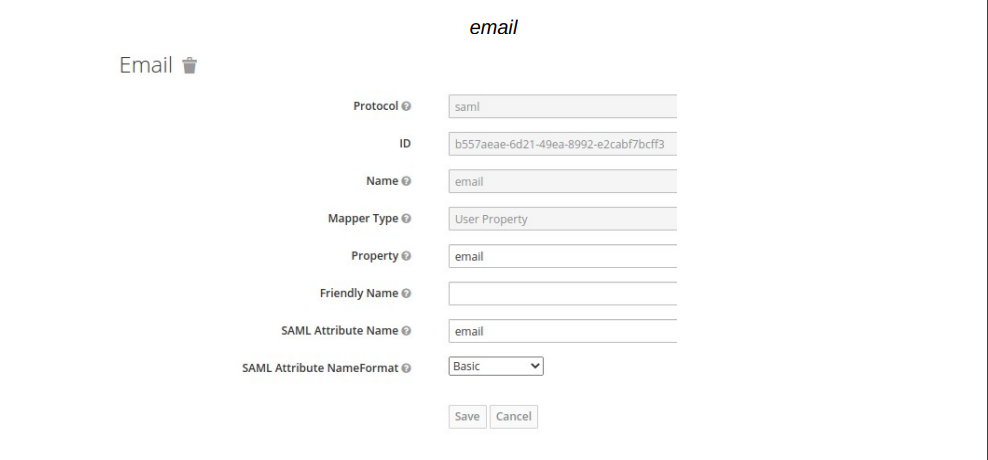
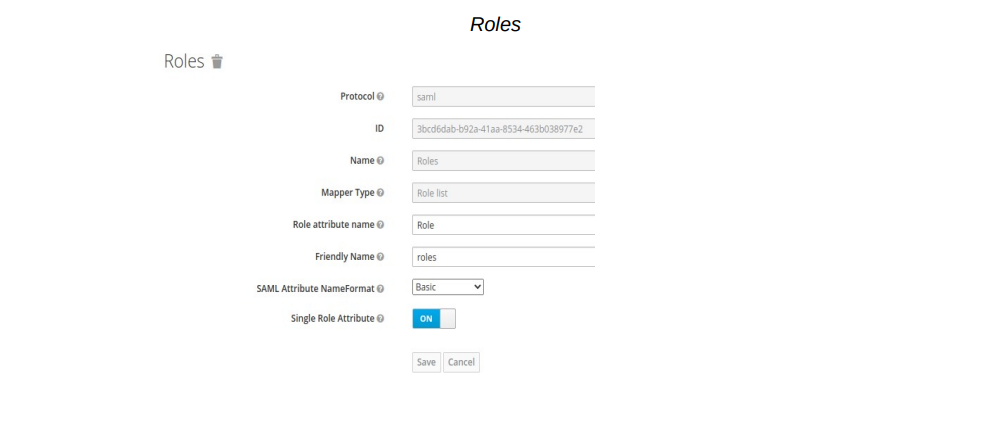
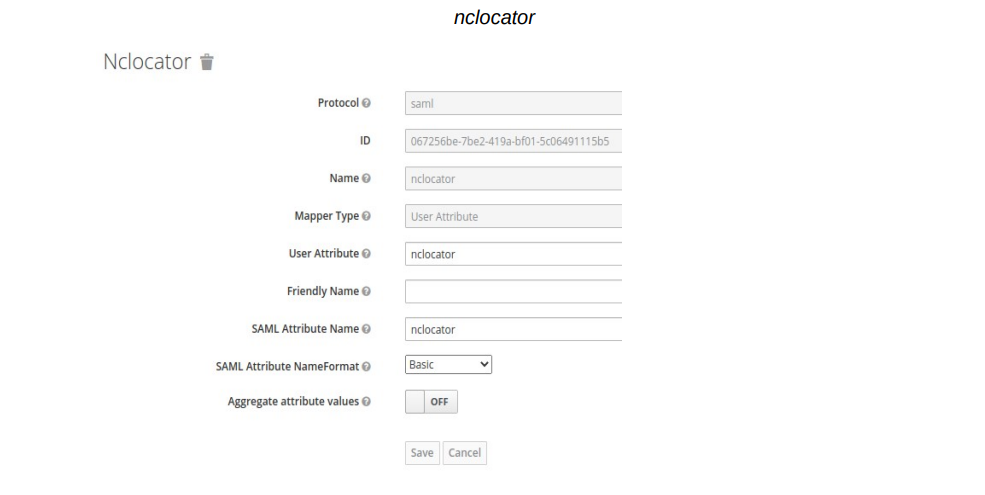
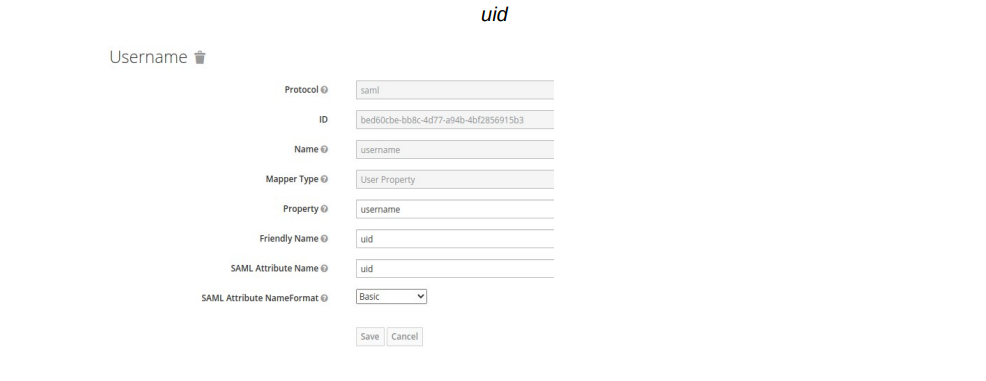
Une fois le mappage terminé, nous allons configurer la partie SAML et définir le noeud principal en tant que client :

Configuration SAML du Nextcloud primaire

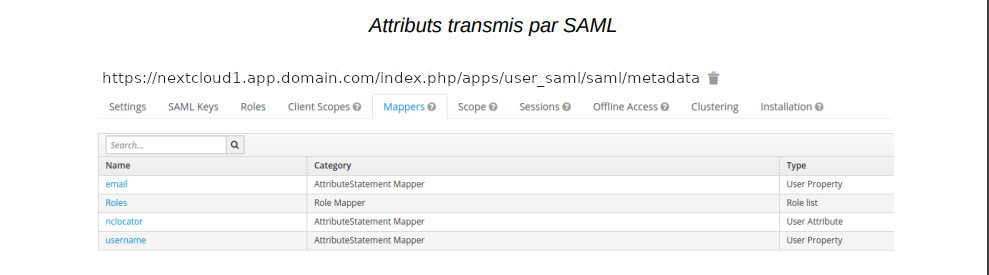
Enfin il faut lui donner les éléments que l’on vient de définir pour lui permettre de s’en servir durant la connexion.

ATTRIBUTS TRANSMITS PAR SAML

Que l’on va définir commme ceci :

EMAIL

ROLES

NCLOCATOR

UID

Une fois toutes ces configurations faites, nous pouvons passer à la configuration du noeud primaire NextCloud.

Nextcloud Primaire

En premier lieu, nous devons modifier les Content Security Policy afin de permettre aux instances d’utiliser les iframes d’une instance à une autre. Vous devrez trouver le fichier .php au chemin suivant :

~/lib/public/AppFramework/Http/ContentSecurityPolicy.php

Voici à quoi ressemble notre fichier de conf après modification :

~# cat ./lib/public/AppFramework/Http/ContentSecurityPolicy.php
...
 protected $allowedFrameDomains = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];

 protected $allowedFrameAncestors = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];`

Ensuite il faut commenter les options du X-Frame dans le .htaccess pour autoriser les autres origines :

~# cat .htaccess
# Header always set X-Frame-Options "SAMEORIGIN"`

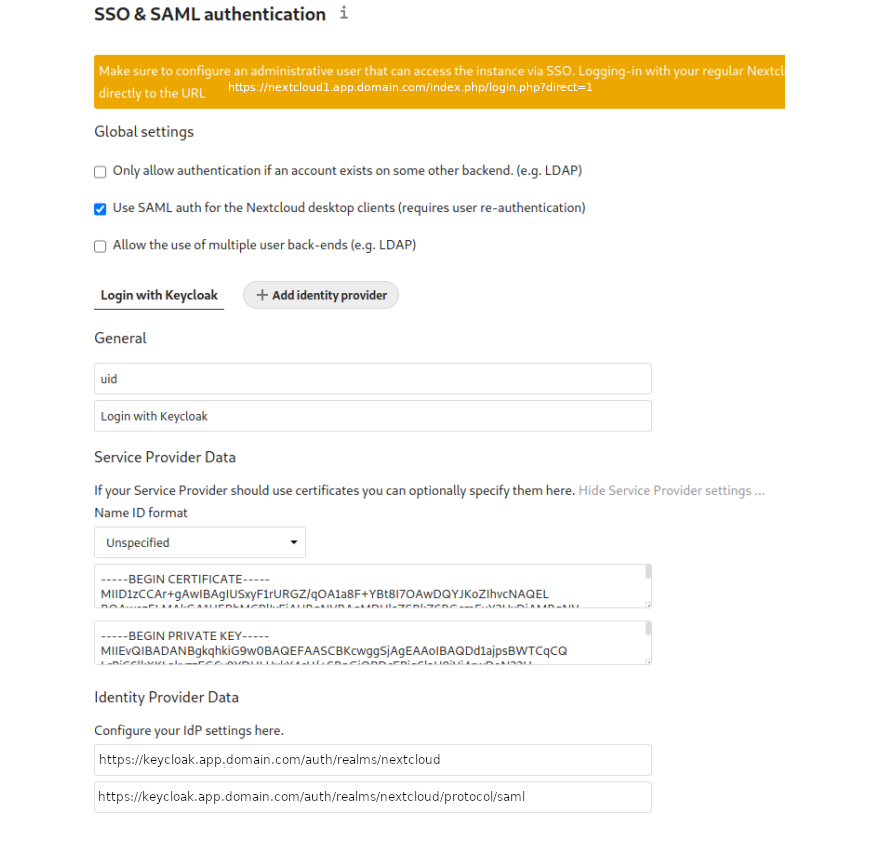
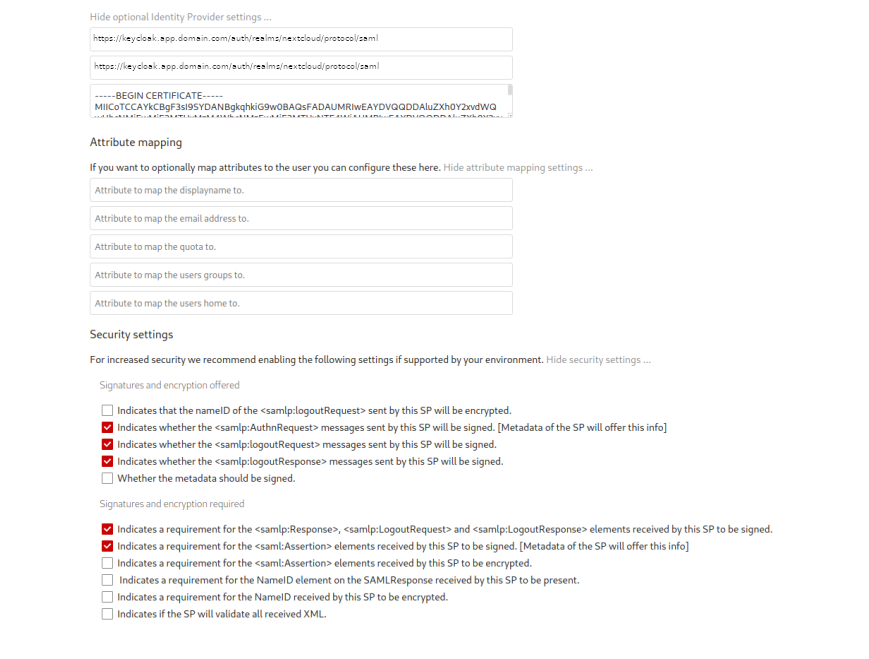
Du côté de NextCloud, la partie SAML doit être configurée comme ceci :

Authentication SAML Authentication SAML 2

Voici un extrait du config.php modifié pour GlobalScale :

~# cat config/config.php
<?php
$CONFIG = array (
<...>
 'overwriteprotocol' => 'https',
 'overwritehost' => 'nextcloud1.app.domain.com',
<...>
 'overwritewebroot' => '/',
 'trusted_domains' =>
 array (
 0 => 'nextcloud1.app.domain.com',
 1 => 'nextcloud2.app.domain.com',
 2 => 'nextcloud3.app.domain.com',
 ),
 'datadirectory' => '/var/www/nextcloud/data',
 'lookup_server' => 'https://ls.app.domain.com',
<...>
 'overwrite.cli.url' => 'https://nextcloud1.app.domain.com/nextcloud',
<...>
 'app_install_overwrite' =>
 array (
 0 => 'globalsiteselector',
 ),
 'gss.jwt.key' => 'XXXXX',
 'gss.mode' => 'master',
 'gss.master.admin' =>
 array (
 0 => 'admin',
 ),
 'gs.enabled' => true,
 'gss.user.discovery.module' => '\\OCA\\GlobalSiteSelector\\UserDiscoveryModules\\UserDiscoverySAML',
 'gss.discovery.saml.slave.mapping' => 'nclocator',
<...>
);

NextCloud Secondaire

Comme pour le noeud primaire, vous devez modifier les CSP afin d’autoriser l’utilisation des iframes d’une instance à une autre comme ceci :

protected $allowedFrameDomains = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];
 protected $allowedChildSrcDomains = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];
 protected $allowedFrameAncestors = [
 'nextcloud1.app.domain.com',
 'nextcloud2.app.domain.com',
 'nextcloud3.app.domain.com',
 'collabora.domain.com',
 ];

Il est impératif de commenter la ligne suivante dans le .htaccess comme pour le noeud primaire :

~# cat .htaccess
#Header always set X-Frame-Options "SAMEORIGIN"

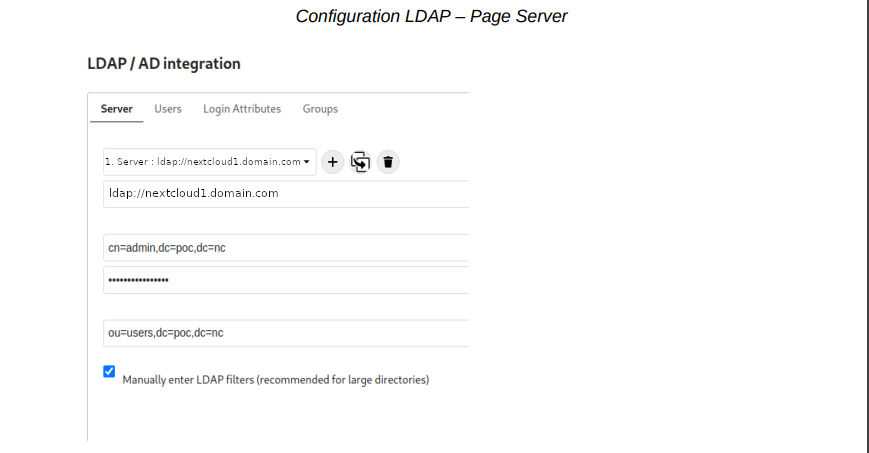
Contrairement au nœud primaire, les nœuds secondaires doivent être connectés à un annuaire LDAP pour les informations utilisateurs avec un filtre correspondant aux utilisateurs uniquement de cette instance :

LDAP - Page Server

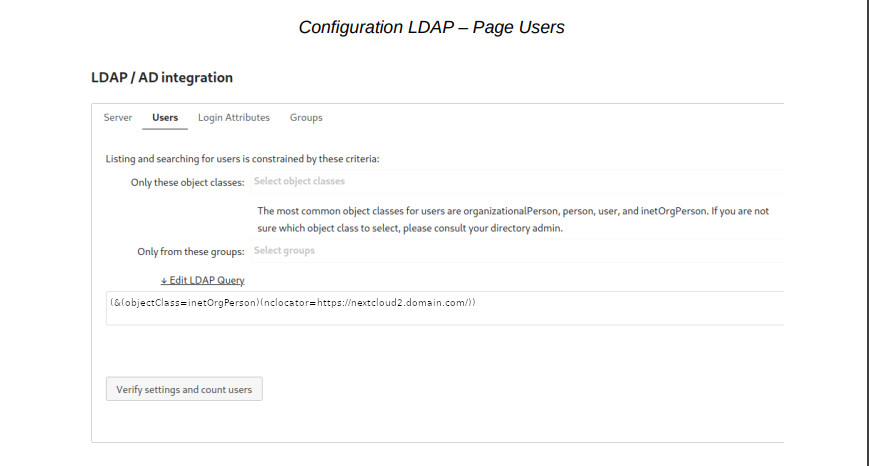
On va ensuite créer un filtre correspondant au nclocator du GlobalScale :

Configuration LDAP - Page Users

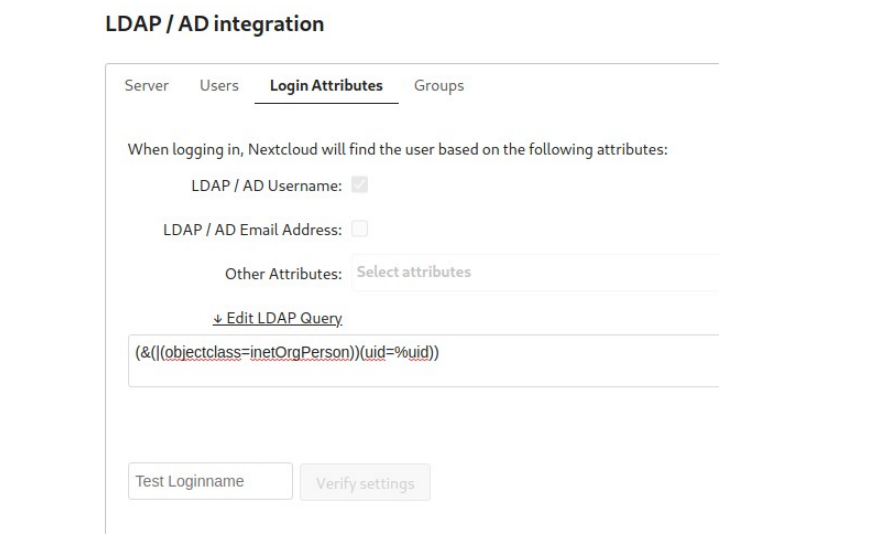
Pour le reste, ça reste une configuration classique :

Page Login Attributes

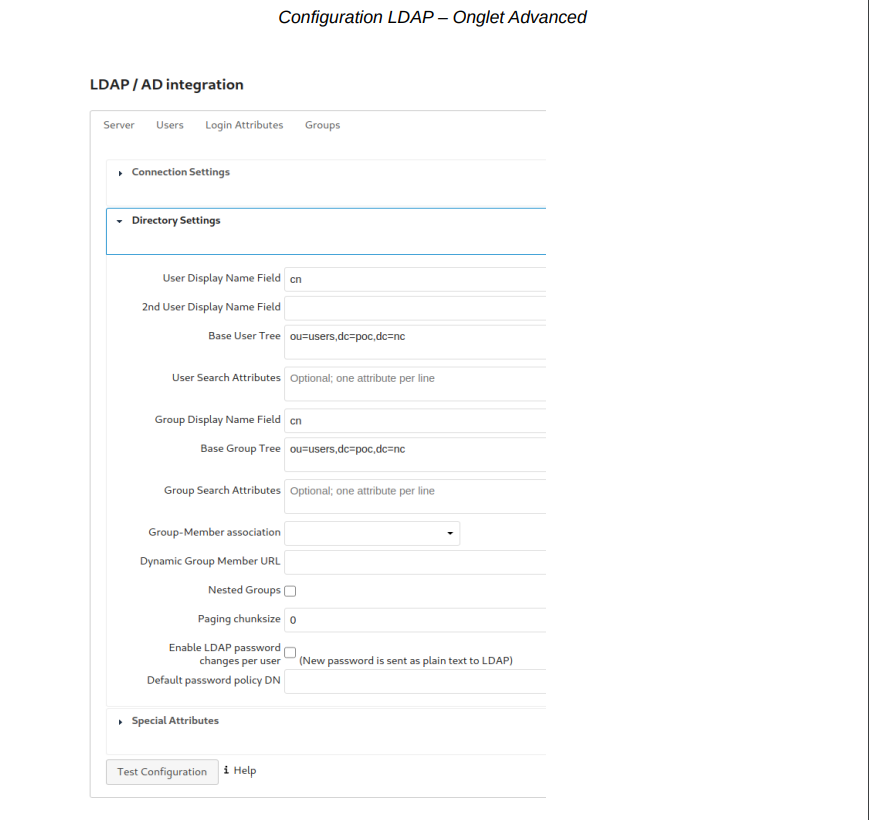
Dans l’onglet Avancé, nous désactiverons la pagination des recherches dans l’annuaire :

Onglet Avancé

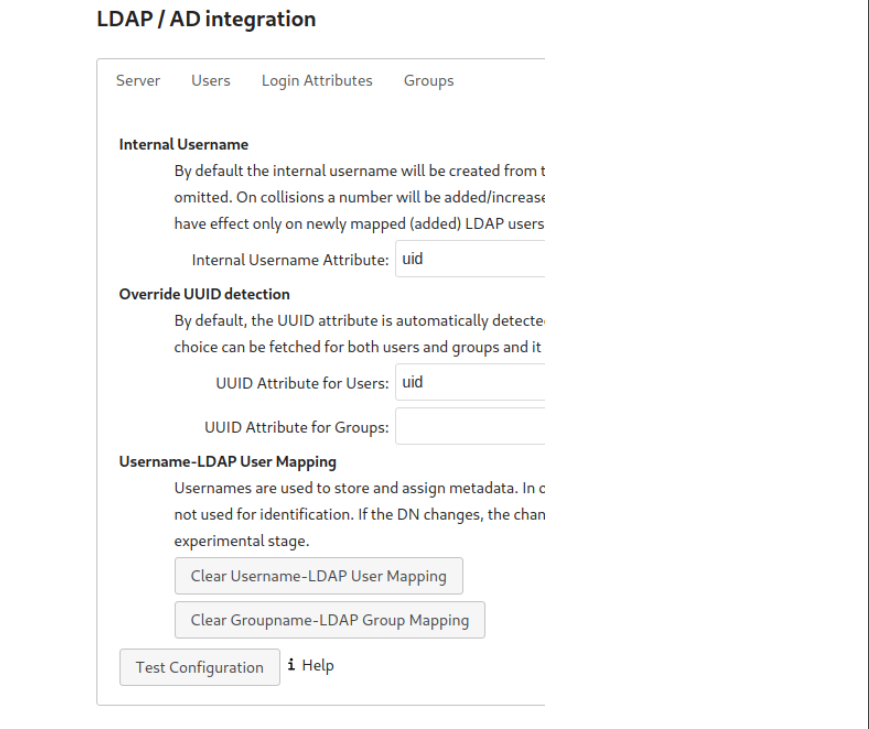
Pour simplifier la lecture entre SAML et LDAP, nous avons fait correspondre l’uid de l’utilisateur :

Onglet Expert

Voici un extrait du fichier config.php correspondant aux modifications pour le GlobalScale pour une instance secondaire :

~# cat config/config.php
<?php
$CONFIG = array (
<...>
 'trusted_domains' =>
 array (
 0 => 'nextcloud3.app.domain.com',
 1 => 'nextcloud2.app.domain.com',
 2 => 'nextcloud1.app.domain.com',
 ),
<...>
 'overwrite.cli.url' => 'https://nextcloud2.app.domain.com',
 'installed' => true,
 'app_install_overwrite' =>
 array (
 0 => 'globalsiteselector',
 ),
<...>
 'overwritewebroot' => '/',
 'overwriteprotocol' => 'https',
 'gss.mode' => 'slave',
 'gss.discovery.saml.slave.mapping' => 'nclocator',
 'lookup_server' => 'https://ls.app.domain.com',
 'gss.jwt.key' => 'XXXXXXXX',
 'gss.master.url' => 'https://nextcloud1.app.domain.com/',
<...>
);

Lookup Server

Voici à quoi ressemble le fichier de configuration par défaut :

# cat config/config.php
<?php
// Lookup-Server Config
$CONFIG = [
<...>
 // max user search page. limit the maximum number of pages to avoid scraping.
 'MAX_SEARCH_PAGE' => 100,
 // max requests per IP and 10min.
 'MAX_REQUESTS' => 100000,
 // credential to read the replication log. IMPORTANT!! SET TO SOMETHING SECURE!!
 'REPLICATION_AUTH' => 'XXXXXX',
 // credential to read the slave replication log. Replication slaves are read only and don't get the authkey.
IMPORTANT!! SET TO SOMETHING SECURE!!
 'SLAVEREPLICATION_AUTH' => 'YYYYYYYYYYY',
 // the list of remote replication servers that should be queried in the cronjob
 'REPLICATION_HOSTS' => [],
 // ip black list. usefull to block spammers.
 'IP_BLACKLIST' => [],
 // spam black list. usefull to block spammers.
 'SPAM_BLACKLIST' => [
 ],
 // Email sender address
 'EMAIL_SENDER' => 'www@ttttt.com',
 // Public Server Url
 'PUBLIC_URL' => 'https://ls.app.domain.com',
 // does the lookup server run in a global scale setup
 'GLOBAL_SCALE' => true,
 // auth token
 'AUTH_KEY' => 'ZZZZZZZZZ'
 'TWITTER' => [
 'CONSUMER_KEY' => '',
 'CONSUMER_SECRET' => '',
 'ACCESS_TOKEN' => '',
 'ACCESS_TOKEN_SECRET' => '',
 ],
];

Remarque: La partie Twitter est nécessaire mais peut rester vide.

Durant l’exécution du cron.php de NextCloud, les utilisateurs sont créés via une requête LDAP et sont injectés dans la base de données du Lookup Server comme suit :

MariaDB [lookup]> select * from users where federationId like 'user%' ;
+------+-----------------------------------------+---------------------+
| id | federationId | timestamp |
+------+-----------------------------------------+---------------------+
| 2555 | user1@nextcloud2.app.domain.com | 2021-03-03 17:14:14 |
| 24 | user10@nextcloud2.app.domain.com | 2021-03-03 14:36:07 |
| 2643 | user100@nextcloud2.app.domain.com | 2021-03-03 17:14:56 |
| 544 | user1000@nextcloud2.app.domain.com | 2021-03-03 15:42:14 |
| 1048 | user100001@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1049 | user100002@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1050 | user100003@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1051 | user100004@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1052 | user100005@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1053 | user100006@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1054 | user100007@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1055 | user100008@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1056 | user100009@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1057 | user100010@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1058 | user100011@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
| 1059 | user100012@nextcloud3.app.domain.com | 2021-03-03 15:53:00 |
…
| 3028 | user490@nextcloud2.app.domain.com | 2021-03-03 17:17:52 |
| 3029 | user491@nextcloud2.app.domain.com | 2021-03-03 17:17:53 |
| 3030 | user492@nextcloud2.app.domain.com | 2021-03-03 17:17:53 |
| 3031 | user493@nextcloud2.app.domain.com | 2021-03-03 17:17:54 |
| 3032 | user494@nextcloud2.app.domain.com | 2021-03-03 17:17:54 |
| 3033 | user495@nextcloud2.app.domain.com | 2021-03-03 17:17:54 |
| 3034 | user496@nextcloud2.app.domain.com | 2021-03-03 17:17:55 |
| 3035 | user497@nextcloud2.app.domain.com | 2021-03-03 17:17:55 |
| 3036 | user498@nextcloud2.app.domain.com | 2021-03-03 17:17:56 |
| 3037 | user499@nextcloud2.app.domain.com | 2021-03-03 17:17:56 |
| 3038 | user500@nextcloud2.app.domain.com | 2021-03-03 17:17:57 |
+------+---------------------------------------------+---------------------+

On peut alors constater les requêtes de mise à jour via l’API du Lookup Server depuis toutes les instances :

ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:55 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:56 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:57 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"
ls.app.domain.com [03/Mar/2021:17:17:57 +0100] "POST /gs/users HTTP/1.1" 200 "-" "Nextcloud Server
Crawler"

Collabora

La spécificité de notre configuration de Collabora ici est qu’elle doit permettre le partage d’iframe d’un NextCLoud à un autre. Pour ce faire, nous allons alors fixer les adresses pouvant utiliser cette option dans notre fichier loolwsd.xml :

~# cat /etc/loolwsd/loolwsd.xml
<...>
 <frame_ancestors desc="Specify who is allowed to embed the LO Online iframe (loolwsd and WOPI host are
always allowed). Separate multiple hosts by space.">https://nextcloud*\.app\.domain\.com</frame_ancestors>
<...>
 <host desc="Regex pattern of hostname to allow or deny." allow="true">nextcloud1\.app\.domain\.com</host>
 <host desc="Regex pattern of hostname to allow or deny." allow="true">nextcloud2\.app\.domain\.com</host>
 <host desc="Regex pattern of hostname to allow or deny." allow="true">nextcloud3\.app\.domain\.com</host>
<...>
 <host desc="Hostname to allow" allow="true">nextcloud1\.app\.domain\.com</host>
 <host desc="Hostname to allow" allow="true">nextcloud2\.app\.domain\.com</host>
 <host desc="Hostname to allow" allow="true">nextcloud3\.app\.domain\.com</host>
<...>
~# systemctl restart loolwsd

Après redémarrage du service, les serveurs NextCloud peuvent désormais ouvrir des accès à leur instance aux autres.

Attention : Pour l’exemple, nous déployons un seul Collabora unique pour tous nos serveurs NextCloud, cependant il est tout à fait possible de les séparer pour que chaque serveur possède un Collabora qui lui est propre.

Cas d’usage

Maintenant que vous avez terminé l’installation de GlobalScale, voici quelques cas d’usage pour Nextcloud.

Tester son installation

Afin de tester notre architecture, nous allons procéder de la façon suivante :

  1. Nous allons d’abord nous rendre sur l’URL du noeud primaire https://nextcloud1.app.domain.com puis nous nous authentifions :

Auth SSO

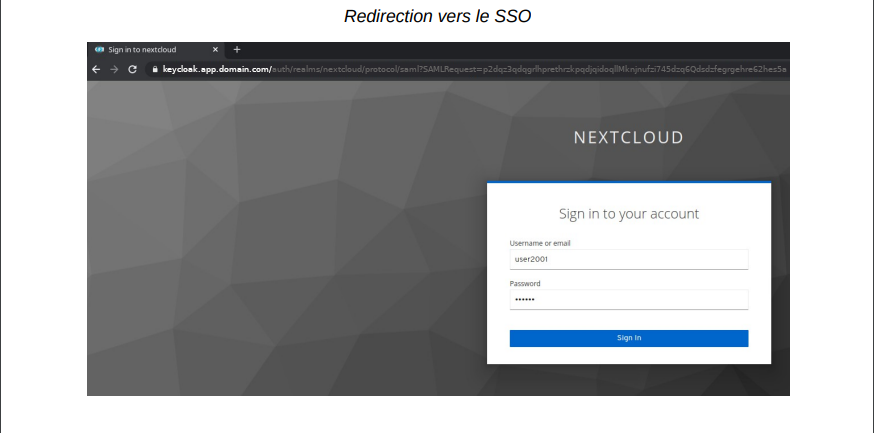
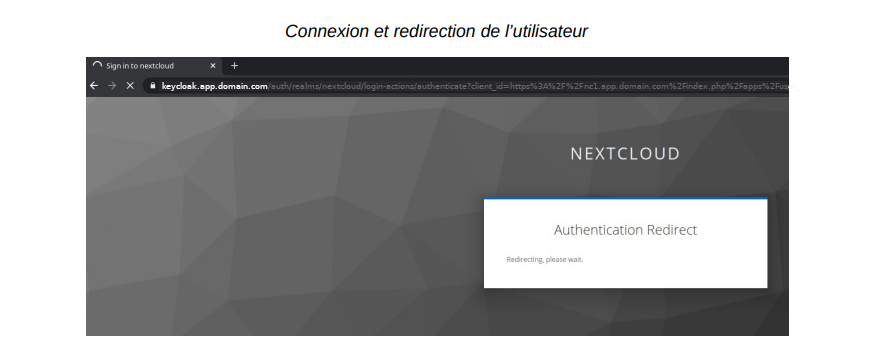
  1. Si tout se passe bien, nous sommes alors redirigé vers le noeud secondaire :

Redir_SSO

Partager un fichier

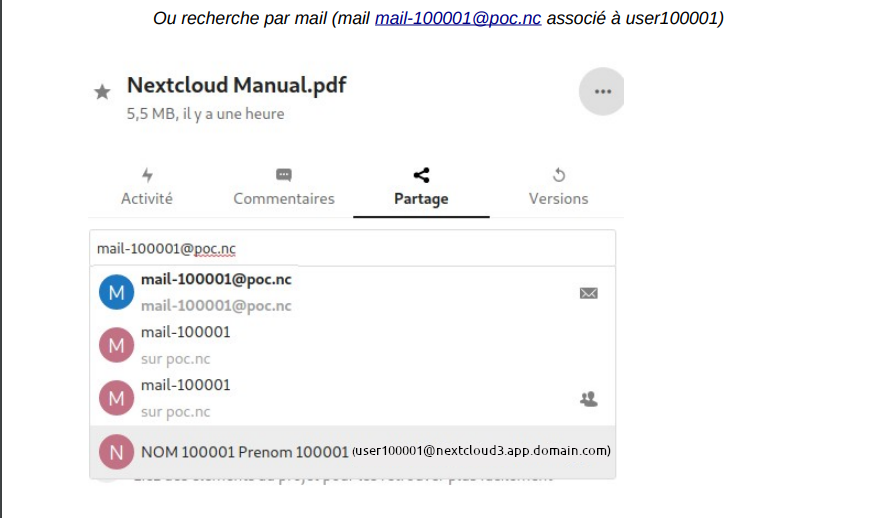
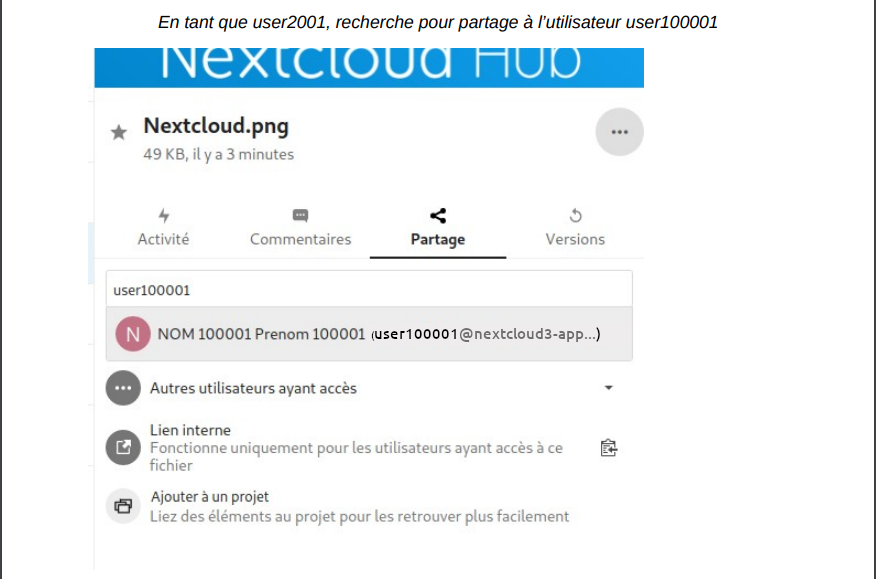
Sur NextCloud, nous avons 2 solutions pour partager un fichier : soit via le mail de notre collaborateur, soit via son nom.

share mail

share name

Conclusion

Félicitations ! Si vos tests ont réussi alors vous avez désormais une architecture NextCloud GlobalScale.

Il est important de noter que la disposition mise en place dans ce tutoriel n’est qu’un exemple et reste ajustable selon vos besoins.

Voici ci-après une liste de liens utiles concernant la documentation des différents éléments mise en place dans ce tutoriel.

Liens utiles

Produit URL
NextCloud https://nextcloud.com/
NextCloud config.php https://docs.nextcloud.com/server/stable/admin_manual/
Lookup Server https://github.com/nextcloud/lookup-server
RichDocuments https://github.com/nextcloud/richdocuments
User SAML https://github.com/nextcloud/user_saml
Global Site Selector https://github.com/nextcloud/globalsiteselector
KeyCloak https://www.keycloak.org/
Openldap https://www.openldap.org/
❌