❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

Grist : quand un tableur devient une application métier

Un tableur pour stocker des données, jusque-là rien de très surprenant.

Mais un tableur capable d’authentifier des utilisateurs, d’afficher des documents, de proposer une interface de notation sur mesure, de croiser automatiquement plusieurs évaluations et d’alimenter un site web ? C’est déjà un peu moins commun et c’est pour ça que ça nous intéresse !

De prime abord, Grist ressemble à un tableur collaboratif. Mais derrière cette interface familière se trouve un outil open source particulièrement flexible, qui a l’avantage de pouvoir être déployé et maîtrisé dans un environnement souverain. Son modèle relationnel, son système de permissions, la gestion des pièces jointes, ses formules Python et surtout ses modules personnalisés, permettent de dépasser largement les usages classiques d’un tableur pour en faire le socle d’une véritable application métier.

Grist et La Suite numérique

Grist fait partie des outils développés et soutenus dans le cadre de La Suite numérique, l’écosystème de services numériques collaboratifs porté par l’État, notamment par la DINUM et l’ANCT. L’objectif est de proposer aux agents publics et à leurs partenaires des outils ouverts, interopérables et maîtrisés, constituant des alternatives crédibles aux grandes plateformes propriétaires.

Notre usage de Grist s’inscrit donc également dans une logique de souveraineté numérique : privilégier des briques open source,dont les conditions d’hébergement, les données et les évolutions peuvent rester maîtrisées.

Cette combinaison entre ouverture, maîtrise des données et capacité de personnalisation, en fait une alternative particulièrement intéressante aux solutions SaaS propriétaires. Grist permet de construire rapidement des outils adaptés à des besoins spécifiques, tout en conservant la maîtrise de leur hébergement, de leur évolution et des données qu’ils contiennent.

C’est précisément l’usage que nous en faisons dans plusieurs de nos projets. Partir d’un besoin métier, structurer les données dans Grist, puis construire autour d’elles les interfaces et les automatisations nécessaires. Nous pouvons ainsi concentrer nos efforts de développement sur ce qui apporte réellement de la valeur aux utilisateurs, tout en nous appuyant sur une infrastructure relativement légère, sécurisée et maîtrisable.

Revenons ensemble sur le potentiel offert pas Grist à travers deux cas d’usage !

Le point de départ : faire travailler plusieurs personnes autour des mêmes données

Premier cas d’usage : un dispositif de notation de formations pour la Délégation interministérielle à la stratégie nationale pour les troubles du neurodéveloppement (DITND). Dans le cadre de la construction de la plateforme nationale dédiée à l’autisme et aux troubles associés, une commission était chargée d’évaluer la qualité des contenus de formations déposés par différents organismes au regard des Repères nationaux.

Dans l’idée, le processus est simple : plusieurs experts examinent de façon asynchrone les formations, consultent les documents associés, et les évaluent sur la base d’une trentaine de critères. Chacun de ces experts doit pouvoir donner son avis (critère atteint, partiellement atteint, non atteint…) et apporter des commentaires. L’ensemble des ces interactions doit pouvoir être tracé. Il faut ensuite croiser les différentes évaluations, repérer les désaccords pour permettre à la commission d’aboutir à une décision.

En pratique, cela représente beaucoup de données à croiser, beaucoup d’interactions et une multiplication des fichiers et des ressaisies. Il fallait aussi garantir la sincérité de l’évaluation en s’assurant que chaque expert ne voit que ses notes et éviter tout biais de jugement.
💡Plus qu’un tableur en ligne, un tableur souverain ?

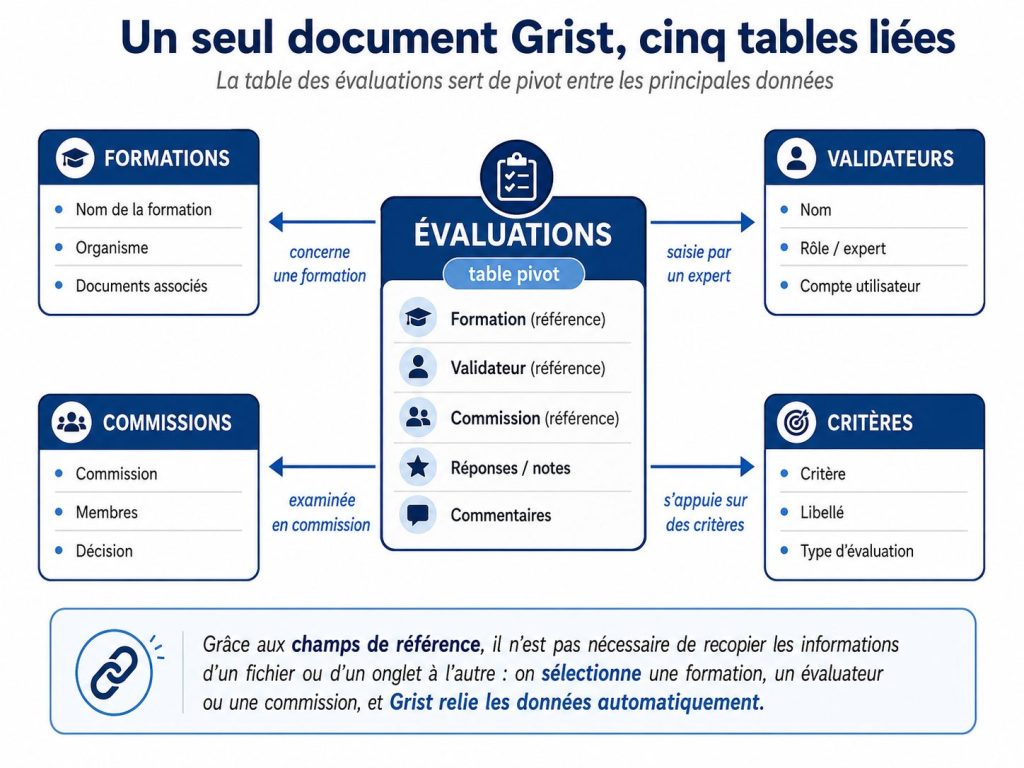
Pour comprendre notre choix, revenons sur ce qu’est Grist. Au premier regard, il ressemble à un tableur collaboratif. Mais cette interface familière cache un fonctionnement plus proche de celui d’une base de données.

Les colonnes sont typées, les tables peuvent être liées entre elles par des références et les formules sont écrites en Python. Grist permet aussi de gérer les pièces jointes ainsi que les droits d’accès des utilisateurs pour chaque table et selon des groupes personnalisables.

À ce stade, Grist joue déjà le rôle d’une petite base de données relationnelle. Mais stocker correctement l’information ne réglait qu’une partie du problème. Hors de question pour les utilisateurs de travailler directement dans les tables : il faut leur proposer une interface adaptée. C’est là que les modules personnalisés entrent en jeu.

Bien plus joli qu’un tableur, une interface user friendly

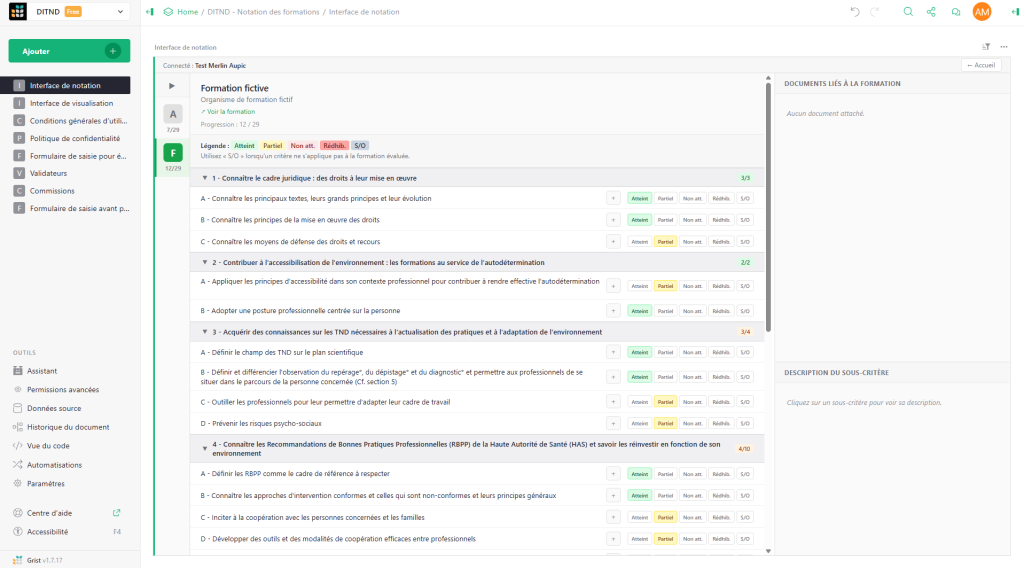
Grâce aux modules personnalisés – ou custom widgets – de Grist, nous avons développé une interface dédiée aux validateurs, directement connectée aux données de la base.

💡Qu’est-ce qu’un widget ?

Un widget est une petite application web connectée directement au document. Elle peut lire ses tables, afficher les données autrement que sous la forme de lignes et de colonnes et, si nécessaire, écrire de nouvelles informations dans Grist.

Chaque membre de la commission est authentifié via son compte Grist. Dès lors, il retrouve les formations qui lui sont attribuées, et peut consulter les documents associés, parcourir les différents critères, sélectionner son avis et ajouter ses commentaires. Les réponses sont enregistrées directement dans les tables, sans étape intermédiaire ni ressaisie.

L’évaluateur n’a donc pas besoin de manipuler directement les tables situées derrière l’application. Il utilise une interface conçue spécifiquement pour son besoin, tandis que Grist continue d’assurer le stockage et la structuration des données en arrière-plan.
Le même principe est utilisé quand la commission se réunit grâce à une seconde interface. Elle agrège les évaluations, affiche les avis côte à côte et permet de repérer immédiatement les critères faisant consensus ou, au contraire, ceux sur lesquels les évaluateurs divergent.

Le résultat ne ressemble donc plus vraiment à un tableur. Pour les utilisateurs , il s’agit d’une application métier dédiée à l’évaluation d’une formation de bout en bout. En arrière-plan, Grist reste le moteur qui stocke les données, gère les accès et assure leur cohérence.

💡Un workflow complet dans un seul environnement

La formation et ses documents sont d’abord déposés grâce à un formulaire. Les validateurs l’évaluent ensuite depuis leur interface. Les résultats alimentent directement les tables Grist. Les réponses sont consolidées par l’interface de commission, puis un export au format JSON est généré pour alimenter le site public.

On obtient donc une chaîne complète : dépôt → évaluation → consolidation → décision → export → publication. Avec un avantage important : les différentes étapes travaillent toujours à partir des mêmes données. Ce qui nous intéresse ici n’est pas seulement l’automatisation de quelques tâches. C’est la capacité à faire circuler les données dans tout le workflow sans avoir à construire et maintenir une succession de bases, d’exports et d’interfaces intermédiaires.

Grist fournit le socle, tandis que le développement sur mesure porte sur l’expérience et les règles métier. Le principe est simple : le module s’annonce d’abord auprès de Grist et précise les droits dont il a besoin. Les modules personnalisés communiquent directement avec Grist via sa son API dédiée (grist-plugin-api). Ils peuvent ensuite lire les données d’une table puis créer ou modifier des enregistrements lorsque l’utilisateur agit dans l’interface.

Grist, un socle flexible pour prototyper

Grist permet de prototyper très rapidement une interface ou un workflow, mais tous les besoins n’ont pas vocation à rester entièrement dans l’outil.

Pour les applications qui doivent durer, nous pouvons par exemple héberger les modules personnalisés comme des applications web indépendantes, afin de retrouver les pratiques classiques du développement logiciel : versionnement, gestion des dépendances et déploiement maîtrisé.

La même logique vaut pour la structuration des données. Dans notre cas d’usage, stocker chaque critère d’évaluation sur une ligne aurait généré plusieurs milliers d’enregistrements. Nous avons donc choisi de regrouper les réponses d’une évaluation dans une donnée structurée au format JSON, interprétée par le module personnalisé. Nous choisissons la structure la plus adaptée au volume, aux usages et aux contraintes du projet plutôt que de complexifier l’infrastructure par défaut.

L’enjeu n’est donc pas de tout faire dans Grist, mais de l’utiliser comme un socle flexible, en adaptant l’architecture et le stockage aux contraintes réelles du projet.

Une même architecture pour des besoins très différents

Cette approche modulaire ne se limite pas aux outils de notation. Nous l’avons également utilisée dans le cadre de l’accompagnement du gouvernement grec dans le cadre de l’Open Data Maturity Assessment.

Cette fois, le point de départ était très différent : un fichier Excel de la Commission européenne particulièrement complexe à manipuler. Il contient les réponses de plusieurs pays européens, dont la Grèce et la France, quant à leur degré de maturité en termes d’Open Data.
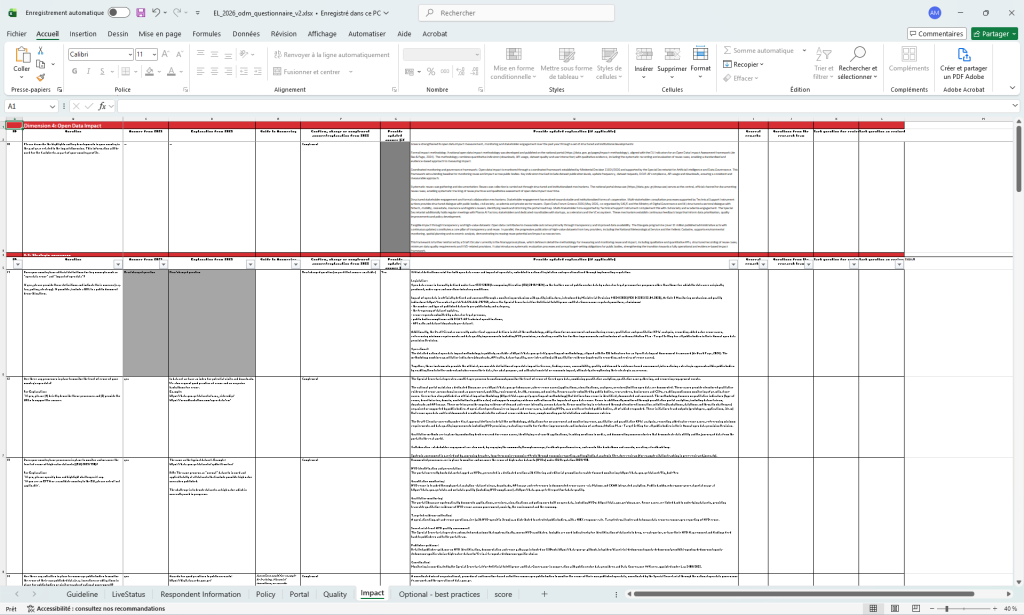
Aperçu de l'Excel d'évaluation
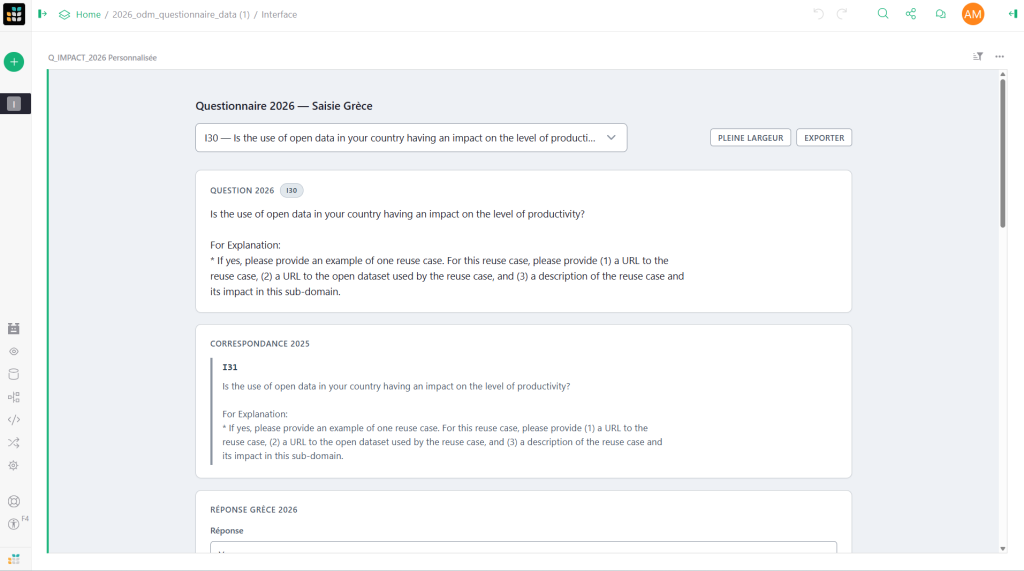
Aperçu de l'application Grist pour la Grèce

Nous l’avons transformé en un véritable espace de travail collaboratif permettant de présenter chaque question de manière lisible, de rétablir les correspondances entre les questionnaires 2025 et 2026, et d’afficher les réponses grecques et françaises côte à côte afin de faciliter leur comparaison et leur complétion. Les sources restent tracées et plusieurs personnes peuvent travailler ensemble sur le même support.

Le cas d’usage change, mais le principe reste le même : des données structurées dans Grist, sur lesquelles nous construisons une interface adaptée au travail réel des utilisateurs.

Pourquoi cette approche nous intéresse : automatiser sans nécessairement construire une usine

Ces projets illustrent finalement une autre manière d’aborder l’automatisation. Développer une application métier sur mesure implique habituellement de mettre en place plusieurs briques dès le départ : une base de données, une authentification, une gestion des permissions, du stockage documentaire, une interface d’administration, parfois une API.

Grist prend déjà en charge une bonne partie de ce socle. Nous pouvons alors concentrer le temps de conception et de développement sur ce qui différencie réellement l’outil : les workflows, les règles métier, l’ergonomie ou les interfaces spécialisées. Grist apporte de son côté l’authentification, le stockage, les données structurées et l’accès depuis un simple navigateur. Il permet également de conserver un historique des actions et des sauvegardes automatiques fiables et régulières.

C’est probablement là que réside le principal intérêt de l’outil pour nous. Il permet de tester rapidement un fonctionnement, de l’adapter aux retours des utilisateurs et, lorsque le besoin le justifie, de faire progressivement évoluer le tableur vers une véritable application métier.

Et c’est là que se situe notre savoir-faire : identifier les cas où cette architecture est pertinente, modéliser les données, construire les interfaces métier nécessaires et connecter l’ensemble aux autres composants du système d’information. Autrement dit, ne pas simplement « faire un Grist », mais concevoir une application métier légère autour de Grist, lorsqu’il s’agit du bon outil pour le problème à résoudre.
🔲 ☆

Intelligence artificielle et réalité augmentée, un couple fait pour durer ! - Grégory MAUBON

Encore un article qui va parler d’IA me direz-vous ! En effet, mais vous devez constater avec moi qu’au-delà du buzzword, l’intelligence artificielle bouscule de plus en plus de domaines depuis quelques années. Les technologies immersives, et en particulier la RA ne sont pas, ne sont pas épargnées et j’en avais déjà parlé à propos des lunettes de réalité augmentée.
— Permalien
🔲 ☆

Les données récupérées par les applications d’achat de vêtements

Incogni Applis Shopping

— Article en partenariat avec Incogni —

Allez, ce matin avec Incogni on va continuer notre exploration des différents services qui récupèrent nos données à notre insu pour les revendre aux datas brokers. Il y a seulement quelques jours je vous parlais des applications Android visant spécialement nos bambins, aujourd’hui ce sont les applications de shopping. Histoire que vous sachiez de quoi il retourne d’ici les prochaines soldes.

Ces dernières années nous avons vu une explosion des applications mobiles pour l’e-commerce. Temu, Shein, Ali Express … même les grandes enseignes historiques comme Nike, The North Face & co poussent à utiliser l’app plutôt que passer par le site web classique. Je vous entends vous demander « mais pourquoi donc ? ». Si si, je l’ai entendu jusqu’ici, ne niez pas.

La réponse : car il est plus simple d’y récolter un max de données ciblées. Une app peut accéder à un tas d’informations différentes sur votre téléphone alors qu’un site web aura plus de mal. Dans son étude, le laboratoire de recherches Incogni a analysé 180 applications de shopping différentes et comme chaque fois les résultats ne sont pas glorieux. Vous êtes habitués maintenant, l’idée c’est d’extraire des infos pour ensuite les revendre et créer des profils les plus complets possibles de qui nous sommes, nos habitudes, etc.

Ce qui est intéressant c’est de voir que ces applis shopping abusent un peu moins que celles dédiées aux gamins, ou même que votre voiture intelligente. En toute logique, l’énorme majorité va stocker ce dont elle a besoin pour vous offrir le service promis : mail, adresse de livraison, numéro de téléphone, etc. Bref là rien de spécial, difficile de vous livrer un colis sans demander au moins le point de livraison. Par contre 1/4 d’entre elles (cela reste énorme) vont récolter votre galerie photo, 6-7% vos vidéos, 5% votre historique web ou la liste des applis installées et 3.3% votre orientation sexuelle ou votre liste de contacts. 22 sur 180 vont cibler précisément vos différentes localisations (dont Adidas). De plus la moitié partagent vos données directement avec des tiers (autrement dit les data brokers) et l’Europe est la seconde zone la plus touchée.

En France nous avons la chance de n’avoir quasi que de mauvais élèves, comme en politique. Les apps H&M, Hacoo (jamais entendu parler), Shein et Nike collectent à peu près tout ce qu’ils peuvent dont vos messages (pour Nike). Spéciale dédicace à ASOS, Vinted et Zalando qui non seulement récoltent un max de choses, mais en plus en revendent la moitié. Le seul bon élève ? Zara. Vous pouvez creuser la liste complète ici en fonction de votre pays de résidence.

Bref une fois encore nous sommes de bonnes vaches à lait. Pas de surprises malheureusement. Mais c’est là qu’intervient Incogni pour nous remonter un peu le moral. Grâce au service de Surfshark, il est possible de faire retirer les données que nous jugeons trop sensibles (toutes ?) des bases de données des courtiers en informations. Ce qui va couper certaines sources d’approvisionnement et fera tourner vos infos un peu moins rapidement dans les méandres du web.

Nom, prénom, adresse mail, numéro de téléphone, etc. Il suffit de dire à Incogni quoi supprimer et il va alors consulter tous les brokers qu’il connait pour leur demander de vous effacer de leurs listes. Et cela sur le long terme puisque le service va vérifier régulièrement que vous n’êtes pas rajouté par la suite (des fois que le broker aurait acheté une nouvelle base avec vous dedans). Vous pouvez aller jeter un oeil à mon test Incogni pour voir comment cela fonctionne concrètement et les résultats.

Maintenant qu’est-ce que l’on peut faire de notre côté pour limiter tout cela et agir de manière proactive ? Et bien déjà passer par la version web classique d’une boutique plutôt que via son appli. Point bonus si votre navigation est un minimum sécurisée (VPN, bloqueur de traqueur, etc.). Oui je sais, il faudra refuser l’offre promo exclusive de 3€ offerts sur votre première commande après avoir installé l’appli. Ou alors, soyons fous, tout simplement résister aux sirènes du consumérisme et arrêter d’acheter des choses inutiles en ligne. Dur.

Si vous n’êtes mentalement pas encore prêt à franchir le cap, vous pouvez déjà enclencher la solution Incogni pour moins de 95€ TTC/an. Et cela sans risques grâce à la garantie satisfait ou remboursé de 30 jours.

Testez Incogni !

🔲 ☆

La moitié des applis pour enfants sur Android récoltent leurs données

— Article en partenariat avec Incogni —

Salut la compagnie. Alors si vous avez l’habitude de me suivre, vous savez que j’ai déjà présenté l’outil Incogni de Surfshark d’un tas de façons différentes. Et mentionné les nombreux services qu’il peut rendre en fonction de votre situation. Mais s’il y a une cible que je n’ai pas abordée, c’est celui de nos marmottes marmots.

Parce que oui, lorsqu’on pense aux informations personnelles récupérées pour le plus grand bonheur des datas brokers (courtiers en données), on pense souvent aux nôtres, celles des « grands ». Et cela afin de créer des profils les plus complets possibles, notamment pour obtenir une image assez précise des sites que nous visitons, de nos achats en ligne, notre situation financière, nos centres d’intérêt, etc.

Sauf qu’il y a une catégorie d’utilisateurs que l’ont a tendance à oublier dans l’histoire, les enfants. Et oui, à notre époque pas mal de gamins passent déjà des heures en ligne (sur un smartphone ou à la maison) sans se préoccuper de savoir s’il y a un danger. Et les parents ne sont pas souvent capables de sécuriser leur environnement et leur apprendre les bons réflexes. Peu vont se renseigner sur les pratiques et les accès accordés aux applications installées (déjà que les parents eux-mêmes utilisent encore des passoires notoires comme Meta & Co …). Or les outils qu’utilisent les enfants, même s’ils semblent aussi peu dangereux que Oui-Oui, n’en sont pas mieux sécurisés pour autant. Ces bases de données centralisent et récupèrent leurs actions et peuvent ensuite tomber entre des mains malhonnêtes.

Le laboratoire de recherche d’Incogni a ainsi analysé 74 applications parmi les plus téléchargées et utilisées au monde par les plus jeunes. Sans surprise cela a permis d’épingler presque 50% de celles-ci (34) dont 2/3 (21) annoncent directement partager leurs données avec des tiers. Quasi 15% récoltent jusqu’à 7 types d’informations différentes : email, historique d’achat, localisation … voire photo. On comprend vite comment les choses peuvent mal tourner. En Europe c’est en moyenne 5 informations qui sont récupérées, la 2e région du monde la plus surveillée.

Incogni applis android pour enfants

Bon après il s’agit la plupart du temps de récolter de la data pour raison marketing, ou pour diagnostiquer des problèmes techniques (bugs & co). Mais encore faut-il faire confiance aux développeurs de l’appli en question. Ainsi Pokémon Quest annonce être clean sur le Google Play Store alors qu’elle récupère des données et les partage. À peine 1 appli sur 7 permet de désactiver cette récolte de données, et 1 sur 3 ne permet pas de supprimer ses infos (pas très RGPD). Une bonne nouvelle s’il faut en trouver une ? 94% chiffrent les données. C’est déjà ça.

Pour différencier les bons des mauvais élèves, vous pouvez vous rendre sur ce lien (onglet « App Rankings » puis cherchez votre pays). En France les cartons rouges sont pour Toca Life World, Kahoot et Avatar World (7 à 12 infos collectées), par contre les jeux des studios YovoGames et BabyBus c’est safe. Ainsi que Pat Partouille à la Rescousse … ouf, je vais mes gosses vont pouvoir continuer à jouer.

Du coup, pour en revenir à Incogni, disposer d’un service qui va nettoyer les bases de données du web des informations liées à vos enfants pourra s’avérer une bonne pratique à mettre en oeuvre. Plus vous commencez tôt et moins les informations se retrouveront dans de multiples bases de données. Si l’adresse mail de votre enfant se retrouve chez un broker, la faire retirer au plus vite est un bon réflexe à avoir, avant qu’elle ne soit reprise à gauche et à droite. N’attendez pas d’intégrer la liste de dizaines de brokers comme je l’ai fait, ça m’apprendra à laisser mon email chez n’importe qui 😉

Encore faut-il se rendre compte que tel ou tel courtier a ces informations en main. C’est le travail d’Incogni, qui va scanner l’ensemble des brokers qu’il surveille afin d’y trouver les éléments que vous voulez faire supprimer. Il contactera alors en votre nom ces derniers et leur demandera des retraits, et répétera l’opération jusqu’à ce qu’ils lâchent l’affaire. Des heures et des heures de recherches économisées et vous aurez l’esprit tranquille en sachant qu’il va s’assurer que ces retraits soient définitifs. Vous pouvez même suivre l’avancée des travaux directement depuis une interface simple.

Mais n’oubliez pas que VOUS êtes le premier rempart de votre progéniture. Eduquez-les, expliquez-leur les conséquences potentielles de tout ce qu’ils font sur la toile, etc. Vous ne les laisseriez pas jouer n’importe où ni avec n’importe qui en extérieur, il n’y a pas de raison que ce soit différent en ligne. Et si vous vous y mettez un peu tard, appelez le soldat Incogni à la rescousse pour vous assurer que les dommages sont limités !

Je découvre Incogni

☑️ ☆

Chat with RTX, l’application de NVIDIA pour créer son propre chatbot sur PC

NVIDIA lance Chat with RTX, une application qui permet de configurer un chatbot d’IA et de l’exécuter sur un PC local sous Windows 11. Connecté au contenu de l’utilisateur (documents, notes, vidéos ou autres données), celui-ci génère rapidement des réponses fiables et totalement sécurisées puisque connexion internet ou serveur cloud ne sont pas requis.

Pour générer ses réponses, le chatbot est basé sur un LLM : il est possible de choisir entre les modèles open source Mistral 7B de Mistral AI et LLama 2 13B de Meta.

Chat With RTX prend en charge une grande variété de formats de fichiers (incluant .txt, .PDF, .doc/docx et .XML). Pour charger automatiquement ces fichiers dans la bibliothèque de l’application, il suffit de pointer le dossier contenant les fichiers.

Les utilisateurs peuvent également inclure des informations provenant de vidéos et de listes de lecture YouTube. Lorsqu’ils fournissent l’URL d’une playlist YouTube, l’application charge automatiquement les transcriptions associées aux vidéos correspondantes. Ils peuvent par exemple demander des recommandations de voyage basées sur le contenu de vidéos ou obtenir des tutoriels éducatifs.

La génération augmentée de récupération (RAG) améliore la qualité et la pertinence des réponses du LLM choisi. Cette approche combine les capacités de génération de texte d’un modèle de langage pré-entraîné avec la récupération d’informations pertinentes à partir des données fournies. Cela permet au chatbot d’offrir des réponses contextuellement adaptées et précises.

Chat with RTX est conçu pour fonctionner sur un PC sous Windows 11, équipé d’un GPU NVIDIA GeForce RTX 30 ou 40 ou d’un GPU NVIDIA RTX Ampere ou Ada avec au moins 8 Go de mémoire vidéo (VRAM). Il tire parti de TensorRT-LLM, un logiciel open source qui augmente les performances d’inférence de l’IA.

Un minimum de mémoire vive (RAM) de 16 Go est nécessaire ainsi que la version 535.11 ou supérieure des pilotes de la carte graphique.

Chat with RTX est présenté comme une application de démonstration, NVIDIA attend les premiers retours pour améliorer cette première version.

L’application a été créée à partir du projet de référence pour les développeurs TensorRT-LLM RAG, disponible sur GitHub. Les développeurs peuvent utiliser le projet de référence pour développer et déployer leurs propres applications basées sur RAG pour RTX, accélérées par TensorRT-LLM.

La démo de Chat with RTX peut être téléchargée ici.

Chat with RTX, l'application de NVIDIA pour créer son propre chatbot sur PC

❌