Le Commissariat à l’énergie atomique et aux énergies alternatives (CEA) et Dawex, entreprise française leader dans le domaine de l’échange de données, ont récemment signé un accord de partenariat pour la création d’un laboratoire commun de Recherche et Développement. Conjuguant leurs expertises, le CEA et Dawex stimuleront la recherche de pointe sur l’ingénierie des données et l’IA pour apporter des réponses technologiques aux enjeux économiques et environnementaux.
Dawex, fondée en 2015 par Fabrice Tocco et Laurent Lafaye, est reconnue pour son expertise en matière d’échange de données sécurisé, de gouvernance des données et d’interopérabilité. L’entreprise développe des solutions de Data Exchange avancées et participe activement aux travaux sur les réglementations, normes et standards.
Elle est membre de GAIA-X, une initiative franco-allemande lancée en 2019, visant à proposer aux acteurs européens le plus grand nombre de services, plateformes, outils et infrastructures souverains permettant d’exploiter et d’échanges des données dans un cadre éthique et sécurisé, avec un accent sur la portabilité et à l’interopérabilité des solutions. Reconnue Technology Pioneer par le Forum Économique Mondial, Dawex est également à l’initiative du programme international de standardisation Trusted Data Transaction.
De son côté, le CEA joue un rôle essentiel dans la transformation de l’industrie, notamment à travers ses programmes dédiés à l’industrie du futur, au jumeau numérique, à l’IA et à la confiance numérique. Le CEA apporte à cette collaboration une vaste expérience en matière de recherche appliquée et de développement technologique, visant à construire un puissant écosystème d’innovation basé sur des valeurs de responsabilité sociale et environnementale.
Le laboratoire commun de R&D s’appuiera sur l’expertise des deux partenaires pour créer des écosystèmes de données sécurisés, interopérables et de confiance, favorisant ainsi l’adoption de technologies avancées comme l’IA générative. En stimulant l’innovation technologique, le CEA et Dawex aspirent à contribuer significativement à la création d’un avenir plus durable et résilient.
Fabrice Tocco, co-PDG de Dawex, commente :
“L’innovation et la recherche font partie de l’ADN de Dawex depuis le premier jour. Dawex œuvre continuellement pour faire progresser les questions relatives au Data Exchange et anticiper les futurs enjeux liés aux données, en fournissant la technologie d’échange de données la plus avancée. Nous sommes ravis de collaborer avec le CEA et de co-innover pour apporter les innovations “nouvelle génération” qui transformeront l’échange de données”.
Alexandre Bounouh, directeur du CEA-List, ajoute :
“L’échange de données joue un rôle majeur dans la transformation de l’industrie à laquelle la France et l’Europe sont confrontées aujourd’hui. Pour accompagner cette transformation, le CEA a fait le choix de s’associer à Dawex, entreprise leader dans le domaine de l’échange de données et des écosystèmes de données. La création d’un laboratoire de R&D commun nous permettra d’apporter à l’industrie des solutions numériques avancées et de confiance, avec un objectif en tête : accélérer les transitions, et parmi elles, celles de l’énergie et du climat. Nous sommes ravis de poursuivre cette ambition avec Dawex”.
Data exchange le CEA et Dawex s'associent pour créer un laboratoire de R&D commun
La Commission nationale de l’informatique et des libertés (CNIL) a enregistré un nombre record de plaintes en 2023 (16 433) soit le double par rapport à avant 2018 (8 360 plaintes en 2017). Par ailleurs, les sites web de la CNIL ont cumulé environ 11,8 millions de visites (800 000 visites de plus qu’en 2022).
Aïe aïe aïe, on dirait bien que ce cher TikTok s’est encore fourré dans un sacré pétrin ! Figurez-vous que ces petits malins ont eu la riche idée de lancer en douce une nouvelle fonctionnalité dans leur app, sobrement intitulée « Task & Rewards« , dispo en France et en Espagne. Jusque-là, rien de bien méchant, me direz-vous sauf que voilà, cette version soi-disant « light » du réseau social cache en fait un système de récompenses qui paye les utilisateurs en échange de leur fidélité. Et ça, ça ne plaît pas du tout à l’Union Européenne !
En effet, la Commission Européenne vient de sortir l’artillerie lourde en exigeant des réponses de la part de TikTok dans un délai de 24 heures. Pourquoi tant de précipitation ? Eh bien figurez-vous que cette nouvelle fonctionnalité « Task & Rewards » qui rémunère les utilisateurs de plus de 18 ans à coup de bons d’achat ou de « coins » virtuels en échange de leur attention, inquiète.
Toute d’abord, on peut légitimement se poser la question de l’impact d’un tel système sur la santé mentale des utilisateurs, et en particulier des plus jeunes. Parce que bon, encourager les gens à scroller comme des zombies pour gratter trois cacahuètes, c’est quand même un peu limite… Surtout quand on sait à quel point les réseaux sociaux peuvent générer des comportements addictifs. La Commission s’inquiète notamment de l’efficacité de la vérification de l’âge des utilisateurs et de la gestion des plaintes par la plateforme.
Ensuite, il y a la question épineuse de la protection des données personnelles parce que pour distribuer ses récompenses, TikTok va forcément récolter encore plus d’infos sur nos habitudes, nos goûts, nos clics… Bref, de quoi remplir gentiment sa base de données, nourrir son algorithme et cibler toujours plus finement les utilisateurs.
Et là, l’UE ne rigole pas, elle veut des réponses, et vite !!!
TikTok a donc 24 heures chrono pour fournir son évaluation des risques liés à ce nouveau programme et s’il s’avère que la boîte chinoise a encore une fois voulu capturer toutes nos données sans prendre les précautions qui s’imposent, ça risque de chauffer pour son matricule ! La Commission a des pouvoirs qui pourraient potentiellement forcer TikTok à revoir entièrement, voire stopper son modèle économique si des impacts toxiques son relevés.
Bien sûr, TikTok assure qu’il a pris toutes les dispositions nécessaires, genre limiter l’accès à la fonctionnalité « Task & Rewards » aux plus de 18 ans, plafonner les récompenses à environ 1€ par jour et limiter le temps passé quotidiennement sur l’app, pour gratter des points, à seulement une heure. Mais bon, on ne va pas se mentir, ça ressemble quand même furieusement à une stratégie pour garder les gens le plus longtemps possible sur la plateforme. Comme d’hab quoi.
Les associations de consommateurs en Europe avaient déjà tiré la sonnette d’alarme sur l’UX / UI de la plateforme, notamment l’utilisation de monnaie virtuelle pour créer des incitations à l’engagement. Mais à en juger par la surveillance exercée par la Commission sur l’approche de l’app chinoise en matière de conformité au Digital Services Act (DSA), celle-ci devra peut-être aller plus loin pour satisfaire les responsables de ce nouveau règlement européen.
En mai 2023, SAS, pionnier dans les solutions d’IA et de données, s’engageait à investir 1 milliard de dollars d’ici 2026 afin de poursuivre le développement de solutions analytiques avancées, ciblées sur les besoins spécifiques de certaines industries. Aujourd’hui, à l’occasion de SAS Innovate, son évènement phare à destination des chefs d’entreprise, des utilisateurs techniques et de ses partenaires, la société a dévoilé un ensemble de modèles d’IA légers qui viennent compléter les solutions existantes de la plateforme SAS Viya.
L’annonce de l’investissement s’inscrivait dans la lignée de la démocratisation de l’analyse des données, engagement majeur de SAS. Les salariés peuvent d’ailleurs participer au processus analytique de leur entreprise quel que soit leur niveau de compétence, grâce aux options low code / no code, fournies par les solutions fonctionnant sur sa plateforme analytique d’IA et cloud native, SAS Viya.
Pour rester compétitives, de plus en plus d’entreprise se tournent désormais vers l’IA mais se trouvent confrontées à un défi de taille : la pénurie de compétences en IA, notamment de spécialistes en data science.
Fort de son expertise dans le domaine, SAS capitalise sur des décennies d’expérience dans le déploiement de modèles d’IA évolutifs et fiables pour divers secteurs tels que la finance, la santé et l’industrie ou les institutions gouvernementales. Avant cet investissement de mai dernier, SAS proposait déjà un large éventail de solutions sectorielles, elle élargit son portefeuille avec des modèles d’IA légers et prêts à l’emploi, facilement adaptables aux besoins spécifiques des entreprises, allant de la détection de fraudes à l’optimisation de la chaîne d’approvisionnement, en passant par la gestion des entités et la vérification de la conformité des paiements des frais de santé.
Démocratiser l’IA
Les premiers modèles SAS qui devraient être disponibles cette année seront eux aussi accessibles indépendamment du niveau de compétence. La société, qui vise désormais à démocratiser l’IA générative, a développé un assistant IA pour l’optimisation des entrepôts qui pourra être adapté pour d’autres cas d’utilisation.
Udo Sglavo, Vice-Président de l’IA et de l’analytique chez SAS, affirme :
“Les modèles SAS fournissent aux organisations une IA flexible, précise et accessible qui s’aligne aux défis de chaque secteur. Que vous débutiez votre parcours dans l’IA ou que vous cherchiez à accélérer l’expansion de l’IA dans votre entreprise, SAS répond aux besoins uniques de votre entreprise avec une acuité et une ampleur inégalées”.
Viya Workbench, un environnement de développement flexible et évolutif
SAS a également annoncé la prochaine disponibilité de SAS Viya Workbench, offrant un libre accès à un environnement de calcul dans le cloud, idéal pour la préparation des données, l’analyse exploratoire et le développement de modèles analytiques et d’apprentissage automatique.
SAS Viya Workbench permet aux utilisateurs de travailler dans le langage de leur choix, initialement SAS et Python, avec l’intégration prévue du langage R à l’avenir. Cette flexibilité est soutenue par une interface intuitive offrant deux options d’environnement de développement : Jupyter Notebook/JupyterLab et Visual Studio Code.
Grâce à l’utilisation des procédures analytiques de SAS (PROCs) et des API Python natives, les développeurs peuvent accélérer le développement de modèles performants d’IA. De plus, des bibliothèques Python personnalisées uniques à Viya Workbench permettent d’augmenter la vitesse et les performances des modèles avec peu d’efforts.
L’environnement de développement Viya Workbench est conçu pour être évolutif et disponible sur demande, avec une gestion automatique des ressources et une puissance de calcul CPU/GPU personnalisable pour répondre aux besoins des projets. Les modèles et les résultats obtenus peuvent ensuite être intégrés dans la plateforme SAS Viya pour une gestion optimale des données, une gouvernance renforcée et un déploiement opérationnel efficace.
Cette annonce répond à une série de défis rencontrés par les développeurs d’IA, notamment la nécessité de travailler avec des outils modernes et des capacités de calcul avancées, tout en gérant les coûts et en recherchant des infrastructures pré-construites et évolutives.
Jared Peterson, Senior Vice President chez Engineering, SAS, explique :
“Les multiples défis auxquels les développeurs font face ne sont pas à prendre à la légère. Au contraire, ce sont des obstacles qui les empêchent de répondre aux questions importantes et d’accomplir leurs tâches. Viya Workbench offre une flexibilité maximale et des résultats optimaux en permettant aux développeurs d’utiliser le langage et l’environnement de développement intégré (IDE) de leur choix, d’ajuster la puissance de calcul à la hausse comme à la baisse selon les besoins du projet, et, in fine, d’améliorer leur productivité et leur efficacité. Ils peuvent travailler plus rapidement, être plus créatifs et prendre plus de risques – ce qui, soyons honnêtes, est non seulement attendu, mais rend également le travail plus agréable.”
Viya Workbench sera initialement disponible sur Amazon AWS Marketplace au deuxième trimestre. D’autres fournisseurs de cloud seront progressivement pris en charge, ainsi que des projets liés à une option de déploiement en SaaS.
SAS renforce son offre avec des modèles d'IA prêts à l'emploi
Alors que les pressions inflationnistes s’alourdissent et que les assurés exigent une transparence accrue, une récente étude du Capgemini Research Institute met en lumière les impératifs cruciaux pour une transformation réussie du secteur de l’assurance dommages (IARD – Incendie, Automobile et Risques Divers) confronté à des défis sans précédent.
D’après le rapport sur l’Assurance dommages (World Property and Casualty Insurance Report 2024), les capacités de souscription des assureurs, c’est à dire leur aptitude à évaluer de manière efficace et précise les risques associés à une police d’assurance, à prendre des décisions appropriées et à fournir une couverture adaptée aux besoins du client, sont limitées par des contraintes organisationnelles.
Seuls 8 % des assureurs sont identifiés comme des “précurseurs” en matière de souscription, exploitant pleinement les capacités de l’IA et de l’automatisation pour prendre des décisions éclairées. Un faible pourcentage d’autant plus surprenant que 62 % des dirigeants reconnaissent que l’IA permet d’améliorer la qualité de la souscription et de réduire la fraude.
Améliorer l’expérience client tout en faisant face à de nouveaux défis
Confrontés à l’inflation, les assurés sont à la recherche de primes abordables : au cours des deux dernières années, 27 % d’entre eux ont opté pour un autre assureur leur ayant proposé des primes moins chères (60 %) et de couvertures plus étendues (53 %). Ils demandent également plus de transparence : 42 % des assurés trouvent le processus de souscription actuel complexe et long.
Malgré l’augmentation des primes, le processus de souscription a rencontré des difficultés : les ratios combinés dépassant les 100 %, les assureurs ont enregistré des pertes. Cette situation découle de plusieurs facteurs, notamment les catastrophes naturelles, l’évolution des risques liés aux avancées technologiques telles que les cybermenaces et l’émergence de l’IA générative, ainsi que la complexité réglementaire.
Les dirigeants du secteur signalent d’importants obstacles organisationnels qui compromettent leur capacité à répondre aux attentes des clients : un accès insuffisant aux données (54 %), des systèmes technologiques obsolètes (51 %) et une pénurie de talents qualifiés (47 %).
Adam Denninger, en charge du secteur de l’assurance chez Capgemini, commente :
“L’assureur opère aujourd’hui dans l’un des environnements les plus instables de ces dernières années. Le secteur doit faire face à cette volatilité en repensant les conditions de souscription. Il faut pour cela s’éloigner des modèles traditionnels et moderniser les systèmes centraux en déployant des technologies avancées qui permettent de meilleurs résultats et une plus grande transparence. Il est crucial pour le secteur de tirer parti des données et de l’automatisation permise par l’IA afin de créer un environnement concurrentiel propice à la rentabilité de la souscription, tout en s’adaptant à l’évolution des risques et des comportements des assurés”.
Instaurer la confiance des souscripteurs
Bien que pour les dirigeants l’IA améliore la qualité de la souscription et réduise la fraude, une réticence persiste chez les souscripteurs, les professionnels qui évaluent les risques et déterminent les conditions de couverture des polices d’assurance : ils ne sont que 43 % à faire confiance et à accepter régulièrement les recommandations automatisées des outils d’analyse prédictive d’aide à la décision.
Cette hésitation est due à un sentiment de trop grande complexité (67 %) et à des craintes quant à l’intégrité et explicabilité des données (59 %). La solution pour obtenir leur adhésion serait, selon les auteurs du rapport, de les impliquer dès le début du développement des modèles, en conservant l’aspect « humain dans la boucle » (Human-In-The-Loop) pour que les modèles d’IA soient explicables et suffisamment transparents, et en évaluant continuellement les progrès accomplis.
Malgré des efforts prometteurs, peu d’assureurs se distinguent en tant que “précurseurs”, capables de prendre des décisions rapides, impartiales et innovantes, obtenant des gains en efficacité (moins de délais et de dépenses), précision (coûts des sinistres et détection des fraudes) et expérience client (développement commercial et fidélisation des assurés). Le rapport révèle que moins de 13 % d’entre eux n’atteignent pas leurs objectifs commerciaux, contre 21 à 36 % des assureurs traditionnels.
La nécessité d’une exploitation efficace de données sécurisées
Alors que la majorité des assureurs IARD (83%) reconnaissent le rôle essentiel des modèles prédictifs dans l’avenir de la souscription, seuls 27 % déclarent disposer des capacités avancées nécessaires.
Les écarts entre l’importance des différentes sources de données et la capacité des assureurs à les traiter efficacement sont flagrants, mettant en évidence un besoin criant de consolidation et de rationalisation des systèmes de données.
Au niveau mondial, 53 % des assurés se disent préoccupés par la quantité d’informations personnelles collectées par les assureurs. Cependant, près des deux tiers d’entre eux se disent prêts à partager davantage de données pour obtenir plus de transparence et des tarifs préférentiels, à condition que les informations partagées soient sécurisées.
Les assureurs en IARD sont confrontés à un défi majeur pour répondre aux attentes de leurs souscripteurs quant aux données : 49 % des souscripteurs accordent de l’importance aux données issues de clichés pris par des drones, mais très peu d’assureurs sont en mesure de les traiter et de les analyser efficacement. De même, un souscripteur sur deux souhaite disposer de données provenant d’appareils connectés pour obtenir des informations en temps réel sur des biens personnels et commerciaux, mais seuls 12 % des assureurs sont en mesure de capturer ces données de manière efficace.
Pour les experts de CapGemini, le manque de contrôle des données qui en résulte nuit à l’activité principale des assureurs, car 77 % d’entre eux n’évaluent pas complètement les risques. En raison du peu de données disponibles, 73 % des entreprises sont confrontées à une tarification peu précise, ce qui empêche de couvrir les sinistres correctement et peut, à terme, nuire à leur solvabilité. D’autant plus que 70 % des assureurs affirment que le manque de cohérence de décisions en matière de souscription constitue un problème majeur.
Rapport Capgemini Research Institute Le secteur de l'assurance IARD à l'ère de l'IA
Il n’est pas simple de suivre les avancées dans le domaine de l’intelligence artificielle, encore moins leur mise en œuvre. Cependant, face à la mise en place de nouvelles réglementations (IA Act ou la déclaration de Bletchley sur la sécurité de l’IA signée par 28 pays), il sera bientôt difficile d’invoquer cette excuse. Un cadre plus précis pour la réglementation de l’IA va faciliter sa mise en œuvre dans les entreprises, à condition de disposer d’un socle de données solide.
Principale conséquence, les dirigeants mettent la pression sur leurs collaborateurs en leur demandant de démontrer rapidement la valeur de l’IA pour l’entreprise. Ce sont les équipes en charge des données qui se trouvent en première ligne. Ces experts jouent un rôle clé dans toute stratégie d’IA, car leur mission consiste à alimenter les modèles en injectant des informations contrôlées tout en s’assurant de leur pertinence et de leur éthique.
Les équipes data entretiennent désormais avec l’IA des relations réellement fusionnelles. Certes, une de leurs missions consiste à vérifier les informations alimentant l’intelligence artificielle, mais pour réaliser son plein potentiel, l’IA peut avant tout les aider à extraire le maximum de valeur des données disponibles.
Améliorer les processus de données avec l’IA
S’il est reconnu depuis longtemps que les données massives engrangées par les entreprises cachent une valeur significative ; aujourd’hui l’IA peut jouer un rôle majeur dans l’amélioration des processus analytiques et contribuer à exploiter pleinement le potentiel non encore exploré des données.
Au-delà de la rapidité d’analyse souvent associée à l’IA, ces technologies sont capables de créer des modèles prédictifs qui permettent aux entreprises d’anticiper les tendances et leurs résultats, un avantage incontesté dans un contexte économique perturbé. Ainsi, dans le domaine de la santé, les entreprises collectent des données à chaque interaction avec le patient et à chaque test de diagnostic. Ces données sont ensuite utilisées pour prévoir de possibles goulots d’étranglement et le flux de patients entre les services, pour mieux répondre à la demande et dispenser les meilleurs soins possibles.
Le principal atout de l’IA pour les équipes data est bien là : apporter des réponses aux questions qu’elles ne se posaient même pas. Outre la capacité à analyser de très grandes quantités d’informations, l’IA peut instantanément identifier des relations, des formes, des patterns et des anomalies dans des jeux de données. Pour les entreprises cela signifie que sans être des data scientists, les utilisateurs métiers et les analystes seront capables de tirer des données toute leur valeur.
Et pourtant adopter l’IA ne se fait pas d’un coup de baguette magique. Les équipes data connaissent les difficultés que présente l’intégration de l’IA aux processus en place qui ont fait leurs preuves, même s’ils demeurent perfectibles. Des tests rigoureux et le respect des réglementations en vigueur sont essentiels pour créer un socle de données nécessaire à l’adoption de l’IA et atteindre l’équilibre entre le risque et l’innovation.
Mettre l’IA au service des équipes data
Conscients des avantages, mais aussi des interrogations que peuvent avoir les professionnels des données qui cherchent à améliorer les processus analytiques grâce à l’IA, comment appliquer concrètement ces techniques et les mettre en pratique pour maximiser leur valeur ?
Trouver des quick wins : malgré la capacité de l’IA à gérer des données non structurées, c’est dans les informations structurées que se trouvent les gains les plus rapides. Connues et exploitées de façon régulière par les entreprises, ces données sont propres, fiables et représentent une bonne base pour tester des techniques d’IA plus sophistiquées sans prendre de risques.
Choisir un cas d’usage pour mesurer l’impact de l’IA : fait désormais avéré, l’IA aura un fort impact dans les entreprises. Il est donc important d’associer l’IA à un cas d’usage précis pour produire un retour démontrable. Simplement expérimenter avec la technologie ne mènera nulle part. Pour démontrer les avantages de la technologie, les initiatives et les investissements dans l’IA, souvent pilotés par l’équipe data chargée de la gestion des modèles, doivent être guidés par un objectif précis.
Penser aux utilisateurs : utiliser l’IA dans les processus de données ne garantit pas qu’elle apportera un résultat business. Une analyse avancée ne présente aucun intérêt si elle ne peut être partagée clairement avec les décideurs. Il est essentiel d’impliquer les utilisateurs de ces informations dans tout le processus, de la création du modèle d’IA jusqu’à la manière dont les insights vont être partagés. Trop souvent les modèles innovants restent non utilisés parce que la façon dont ils sont déployés ne correspond pas aux besoins et aux attentes de l’utilisateur final des données.
Minimiser les risques grâce à l’intégration des données : l’intégration et la gouvernance des données sont deux piliers essentiels à la mise en œuvre de nouveaux processus impliquant l’IA. Cette dernière exige également une approche plus souple de la gestion des données, parce que l’ingestion de nouvelles données peut très vite modifier un modèle. Les organisations doivent bâtir une source de données fiable, solide et gouvernée, pour soutenir les processus de données et d’analyse actuels, mais aussi être en mesure de s’ouvrir aux nouvelles techniques basées sur l’IA.
Aller de l’avant et expérimenter : le déploiement de processus de sécurité et de gouvernance des données ne doit pas empêcher les équipes data d’expérimenter avec l’IA. Il est essentiel de se donner des objectifs clairs, correctement anonymiser les données et introduire des POC avec le concours du service IT. Remettre en cause des processus existants n’est jamais facile, c’est même une raison de plus pour expérimenter sans tarder.
Avec l’aide de l’IA, les équipes data peuvent extraire les données plus rapidement et en obtenant des résultats bien meilleurs. Parfois des applications adressant des consommateurs font la une, mais avant d’y arriver, il est indispensable d’optimiser l’utilisation des données pour les équipes internes. Comme pour toute nouvelle technologie, introduire de l’AI dans des processus établis suscite des débats sur son véritable impact business. Si l’IA était appliquée aux process fondamentaux qui sous-tendent l’IA, cet impact pourrait être exponentiel.
Compte tenu du potentiel que cachent les données d’entreprise, l’IA semble un allié indispensable pour beaucoup, mais son l’adoption reste un long chemin. Pour maximiser son intérêt, les équipes data doivent avancer étape par étape, par itérations et apprendre en permanence, sans négliger les pratiques éthiques et responsables. Et surtout, se lancer sans hésiter !
L’Association pour l’Intermédiation de Données (AID) a été créée en novembre dernier par Agdatahub, Apidae Tourisme, Dawex, Hub One DataTrust, Orange Business et Prometheus-X, avec le soutien de la Banque des Territoires. Face à l’émergence rapide et mondiale de la GenAI, elle affirme l’importance des intermédiaires de données tant sur l’aspect éthique des échanges que sur celui du respect des droits des détenteurs de données et du respect du droit de la concurrence. Une position au cœur de sa contribution à la consultation publique sur l’IA générative lancée par l’Autorité de la Concurrence en février dernier.
Outre rassembler les organisations dont l’activité se rapporte à l’intermédiation de données, l’association AID, que la plateforme de partage de données personnelles MiTrust a rejoint en février dernier, ambitionne en effet de contribuer pleinement aux consultations amont aux politiques publiques favorisant la transaction de données, et ceci au sein d’un système reposant sur la confiance, la transparence et la sécurité.
Dans ce but, elle est organisée autour de 4 collèges de membres :
Les prestataires d’intermédiation de données (PSID) regroupant Agdatahub, Hub One DataTrust et Prometheus-X ;
Les opérateurs utilisateurs des services d’intermédiation de données (détenteurs et/ou utilisateurs de données) qui comptent Apidae Tourisme et Orange Business ;
Les prestataires technologiques nécessaires pour opérer les plateformes d’intermédiation de données, Dawex et Orange Business ;
Les membres associés, avec la Banque des Territoires.
Lors de l’annonce de sa création, Sébastien Picardat, Président de AID et Directeur général d’Agdatahub, expliquait :
“Notre volonté partagée est de développer la confiance, la transparence et la sécurité des transactions de données en nous appuyant sur des garanties fortes. Loin de partir d’une feuille blanche, nous nous appuyons sur les bonnes pratiques déjà existantes de chacun des membres de l’association, pour les partager, voire les renforcer et les améliorer si possible”.
Au-delà des échanges entre membres, AID entend en outre jeter les bases d’un dialogue avec l’ensemble des acteurs professionnels de l’intermédiation de données au niveau européen en vue de favoriser la construction d’un marché unique européen des données.
Les intermédiaires de données : une réponse aux risques de distorsion de la concurrence
En tant que tiers de confiance, les Prestataires de Service d’Intermédiation de Données répondent aux risques d’un marché asymétrique : celui des détenteurs de données (dont font partie les TPE/PME) face à un nombre très limité d’éditeurs d’IA générative, constituant, de fait, un oligopole.
Apportant une réponse structurelle et technologique aux risques, par exemple, de verrouillage de l’accès aux data ou à leur manque de portabilité, les PSID orchestrent des transactions de données sécurisées et transparentes sur les volets juridiques, commerciaux et techniques.
Intermédiaire de données, un statut régulé
Le statut d’intermédiaire de données est un rôle récent, réglementé en France par l’Arcep dans le cadre du projet de loi “Sécuriser et Réguler l’Espace Numérique” (SREN), adopté par la commission mixte paritaire le 26 mars 2024 puis par le Sénat le 2 avril suivant, qui devrait être définitivement voté par l’Assemblée nationale ce 10 avril. Sa réglementation repose également sur le Data Governance Act, applicable depuis septembre dernier et l’AI Act.
Ce rôle garantit la libre circulation des données au sein de l’Union Européenne, dans le respect des droits des détenteurs de données et du droit de la concurrence entre détenteurs et utilisateurs de données.
Le secteur de l’IA Générative a besoin d’accéder en masse à des données personnelles et non personnelles, mais pour l’AID cela ne peut se faire réglementairement et structurellement qu’au travers d’un cadre sécurisé dans lequel les détenteurs de données acceptent de rendre celles-ci accessibles aux éditeurs d’IA générative (en tant qu’utilisateurs). C’est la raison d’être des Prestataires de Service d’Intermédiation de Données.
Sébastien Picardat commente :
“Les prestataires d’intermédiation de données ont un rôle essentiel à jouer dans la mise en place d’un marché de la donnée équilibré entre détenteurs et utilisateurs de données, à l’heure où la confiance et la transparence sont des éléments clés pour développer ce marché dans le respect de la réglementation et des valeurs européennes”.
La forte hausse de la participation à la 3e édition du World AI Cannes Festival a confirmé le succès de cet évènement international dédié à l’IA et à ses enjeux économiques, humains et sociétaux. Du 8 au 10 février dernier, le Palais des Festivals et des Congrès a ainsi accueilli plus de 8 000 visiteurs professionnels (soit + 36 % vs. 2023) sur les deux journées dédiées, et plus de 5 000 visiteurs grand public sur la journée du samedi.
Des personnalités de renom présentes sur cette édition
L’édition 2024 du WAICF a notamment été marquée par la visite de Marina Ferrari, tout juste nommée Secrétaire d’État chargée du numérique, et par l’intervention exclusive de Bruno Le Maire, ministre de l’Économie, des Finances et de la Souveraineté industrielle et numérique.
Ce dernier a rappelé la position de leadership européen en IA de la France et ses atouts : l’excellence de ses scientifiques et ses laboratoires, le dynamisme de ses entreprises et son énergie décarbonée favorable au développement de supercalculateurs. Il a souligné l’attractivité des Alpes Maritimes, le rôle crucial de la Région pour soutenir les ambitions en matière d’IA du pays ainsi que l’importance de retenir les talents en IA, mettant l’accent sur la nécessité de leur offrir des rémunérations compétitives et des équipements adéquats.
Il a également abordé le sujet des données, la matière première de l’IA. Pour lui, il est crucial d’aligner entraînement des modèles et souveraineté européenne. Pour garantir la sécurité économique de l’UE face au monopole des GAFAM, il appelle les États membres à la création d’un marché unique européen de la donnée.
Le VC Summit, dédié à l’investissement dans les startups
Parmi les nouveautés de cette édition ; on retiendra le VC Summit, programme dédié exclusivement aux investisseurs. Lors de tables rondes, de discussions informelles, avec notamment le témoignage de Julien Simon sur la success-story de Hugging Face, les intervenants ont pu appréhender les problématiques et les opportunités des investissements dans le domaine de l’IA notamment avec la découverte des startups les plus innovantes du secteur.
Des conférences et des tables rondes premium sur la scène des Ambassadeurs
Le WAICF 2024 a proposé un programme de conférences de haut niveau offrant un panorama complet de l’IA, de ses applications pratiques à ses implications stratégiques, éthiques et entrepreneuriales. La scène des Ambassadeurs proposait d’explorer ce que l’IA peut faire de nos jours pour imaginer ce que les innovations futures apporteront à la société et aux organisations de demain. Deux des tables rondes ont abordé des sujets capitaux :
« Should we slow down research on AI ? »
Yann LeCun, Vice-Président et scientifique en chef de l’IA, META AI, Mark Brakel, Directeur des politiques, Future of Life Institute, Nick Bostrom, professeur à l’Université d’Oxford et Directeur de l’Institut pour l’avenir de l’humanité et Francesca Rossi, membre d’IBM et responsable mondiale de l’éthique ont débattu du bien-fondé de ralentir la recherche sur l’IA comme l’avaient réclamé certains acteurs de l’IA dans une lettre ouverte l’an passé. Si Mark Brakel a défendu une réglementation contraignante face aux dangers potentiels de l’IA, Yann LeCun, partisan de l’open source, s’est déclaré en faveur d’une réglementation des applications d’IA plutôt que de la R&D.
« Challenges in the adoption of AI Act : protecting individual freedoms while encouraging innovation in Europe »
L’AI Act a été adopté par les États membres de l’UE le 2 février dernier, puis le 13 mars suivant par les eurodéputés. Il ne lui manque plus que la validation du Conseil de l’Europe en avril prochain et sa publication dans le Journal officiel de l’UE pour entrer en vigueur progressivement selon le niveau de risque des systèmes ou modèles d’IA.
Yonah Welker, Explorer, Public Evaluator, Board Member Eu Commission Projects, Yonah.org, Georgie Courtois : Avocat — Associé chez de Gaulle Fleurance & Associés, Aurore Belfrage : Investisseur technologique et stratège géopolitique chez Sustechable et Dragoș Tudorache (en distanciel), membre du Parlement européen ont abordé les défis et les implications de cette loi européenne.
Un focus complet sur les applications de l’IA
La scène Applications de l’IA a de son côté apporté un éclairage sur le potentiel de l’IA pour les organisations à travers différents cas d’usage dans plusieurs secteurs.
Dans le domaine de la santé, lors de la session « Frontière pharmaceutique de l’IA générative : tracer une voie responsable pour les percées cliniques », Sam Khalil de NOVO NORDISK a exploré comment l’IA générative peut être utilisée de manière responsable pour réaliser des avancées dans le domaine clinique tandis que Shameer Khader, Directeur exécutif/Responsable mondial du cluster de biologie computationnelle et de la médecine de précision chez SANOFI.a abordé l’utilisation de l’IA pour la découverte de nouveaux médicaments lors de la session « La découverte de cibles médicamenteuses à l’ère de l’intelligence artificielle. ».
Laurent Prud’hon du Crédit Mutuel, Jean-Philippe Debiolles et Carolina Camacho R. d’IBM ont partagé leur expérience pour un autre cas d’utilisation : celui de la GenAI pour le secteur bancaire avec « L’IA générative à l’œuvre dans le secteur bancaire : comment déployer des solutions d’entreprise de confiance ».
Une zone thématique dédiée à la robotique
L’édition 2024 a de nouveau fait la part belle à la robotique. Lors d’expériences immersives, les visiteurs ont découvert les avancées significatives faites dans ce domaine. Ils ont notamment été accueillis par le robot humanoïde saoudien SARA, fruit d’une collaboration de Digital Saudi et Qss Company, avec qui ils ont pu interagir tout comme avec des compagnons de nouvelle génération un peu différents, notamment les robots Mirokai. Développés par la start-up parisienne Enchanted Tools, Miroki et sa version améliorée présentée au CES 2024 Miroka, ressemblent à des personnages de cartoon.. Dotés d’un visage animé en temps réel, très expressif, de pouces opposables et d’une poignée universelle, ces concentrés de technologie se déplacent sur un globe roulant. Ils sont testés dans les hôpitaux parisiens où ils assistent les aides-soignants auprès des patients.
Ils ont également pu découvrir Buddy, un petit robot social, de compagnie, mobile et émotionnel développé par la start-up française Blue Frog Robotics. Destiné à devenir un membre à part entière de la famille, il est pour l’instant commercialisé auprès d’entreprises où il joue le rôle d’agent d’accueil.
Que ce soit auprès des professionnels ou du grand public, cette édition 2024 a rencontré un franc succès, démontrant un intérêt croissant pour l’IA et les perspectives qu’elle offre. Ses organisateurs vous donnent d’ores et déjà rendez-vous le 13 février 2025 pour cet évènement désormais incontournable.
Retour sur les temps forts du World AI Cannes Festival 2024
France Travail, ex-Pôle Emploi, a annoncé avoir subi une cyberattaque : les données de 43 millions de Français sont en danger. Pour Bastien Le Querrec, juriste à la Quadrature du Net, cette fuite était absolument prévisible. « La question n’était pas…
Nous sommes Numéricité, un collectif d’experts qui accompagne les acteurs publics et privés, en France et à l’étranger, pour réussir leur transformation numérique en faisant en sorte que cette transition soit aussi un plaisir.
Numéricité s’organise autour de 3 pôles qui travaillent ensemble et s’enrichissent mutuellement :
Coaching & consultance : accompagner, transformer et pérenniser les organisations et leurs projets à l’ère du tout numérique
Design & technologies : imaginer, concevoir, développer et délivrer des produits numériques d’excellence
Intelligence juridique & conformité : instruire le cadre légal de la transition numérique et designer le volet juridique des projets digitaux – C’est ce pôle que tu rejoindras !
Pour renforcer nos équipes mobilisées auprès de clients ayant des enjeux fort d’intérêt général tels que le GIP de l’Inclusion,Expertise-France ou encore la communauté des Startups d’Etat, nous recrutons un(e) stagiaire Juriste en droit du numérique et protection des données.
Être chez Numéricité, c’est croire qu’un autre numérique est possible et agir concrètement, à travers les missions que l’on nous confie, pour le rendre plus utile, frugal, ouvert, responsable, protecteur, vertueux et universel.
Si tu te retrouves dans ces valeurs : rejoins nous !
Missions
Conseil, audit et assistance pour la mise en conformité et le suivi de la conformité de nos clients (startup, grands comptes et organisations gouvernementales) en matière de protection de la vie privée et des données à caractère personnel (RGPD, Loi Informatique & Libertés, Règlement ePrivacy, NIS² etc) ;
Analyse, audit et stratégie de mise en conformité de produits numériques dans une approche privacy by design (rédaction des éléments indispensables à la conformité : mentions légales, AIPD, politique de confidentialité, CGU…) ;
Audit “façon CNIL” : dans le cadre de notre offre, audit sur pièce et sur site de la conformité d’organisations variées puis contribution à l’élaboration du plan d’actions et des mesures afférentes (tenue du registre, AIPD, procédures internes) ;
Etude de droit comparé sur les cadres juridiques relatifs au droit du numérique, notamment lors de missions auprès d’administrations ou de gouvernements étrangers ;
Veille juridique & technique, recherche et droit comparé.
2023 : une année de consolidation, de diversification et d’innovations
Numéricité est un studio des transformations, pour un numérique au service de l’impact et de l’intérêt général. Choisir Numéricité, c’est opter pour une méthode originale qui transforme la transformation (et les organisations).
L’année 2023 a été marquée par une consolidation et une diversification de nos activités.
Nous avons affirmé notre expertise dans la formation et le coaching des équipes projets, l’élaboration de stratégies data, la conception d’ateliers innovants et stimulants, ainsi que le développement de services numériques performants, toujours en conformité avec le RGPD.
Retour sur les moments phares qui ont rythmé cette année.
Numéricité a poursuivi sa croissance et s’est affirmé comme un acteur de la transformation numérique. Pour continuer d’accompagner au mieux les projets de nos clients, huit nouvelles personnes ont rejoint la famille Numéricité. Par ordre d’arrivée :
Romain Tales, Digital Transformation Specialist
Alexandre Le Borgne, Juriste en droit du numérique public
Daniel Manéa, Apprenti développeur full-stack
Mathilde Bras, Strategy & Innovation Manager
Maxime Lubrano, Responsable communication multimédia et stratégie éditoriale
Sarah Pilhan, Chargée de communication multimédia et stratégie éditoriale
Antoine Lelong, Développeur full-stack, apprenti recruté en CDI
Sam Khouma, Chef de projet & Product owner
Notre réseau d’experts s’est renforcé. Mathilde Hoang, Experte en transformation numérique, nous a rejoint en février. Cette collaboration nous permet d’avoir une deuxième implantation internationale, à Hanoï au Vietnam. Nous avons également renouvelé notre collaboration avec Vincent Motte, Chef de projet, et maintenons ainsi notre présence à Abidjan en Côte-d’Ivoire.
Afin d’œuvrer à la réussite des projets de nos clients, nous mettons nos expertises en commun. Celles-ci sont de plus en plus reconnues et demandées. Certains de nos experts sont d’ailleurs référencés par de grandes institutions internationales telles que le FMI ou la Banque Mondiale, et sélectionnés par ailleurs dans le cadre du Collège Numérique France 2030 du Secrétariat général pour l’investissement.
Un pôle communication s’est structuré au sein de Numéricité. Le défi ? Traduire et transmettre les expertises de l’équipe et mieux faire connaitre l’accompagnement 360° que l’on peut proposer qu’il s’agisse de conformité juridique, de développement produit en mode agile ou d’accompagnement en transformation numérique.
Cette année a également été marquée par la poursuite de nos partenariats avec d’autres acteurs de la transformation numérique tels qu’Octo, Nextmap, La Javaness, Hubvisory, Bearing Point, Malt et Opteamis.
Au sein de cet écosystème, nous faisons de notre connaissance fine du numérique public français une force. Plusieurs membres de l’équipe en ont été les forgerons dans une précédente vie professionnelle. En conciliant cela aux méthodes et techniques issues de la culture numérique, nous proposons une approche originale en mesure de donner de nouvelles capacités aux organisations que nous accompagnons.
Ensemble, transformons la transformation numérique pour en faire un levier d’amélioration de vos organisations :
Les entreprises et administrations publiques sont convaincues de la valeur de la donnée qui est un actif stratégique pour l’ensemble de l’organisation et pas seulement pour un seul service ou une direction métier. C’est pourquoi les entreprises et les administrations publiques se transforment afin de mieux valoriser ces données et investissent dans la construction et la mise en place d’une stratégie data au service de leur stratégie globale.
Nous appuyons cette transformation à travers la co-construction de stratégies data portant sur l’ouverture des données, la modernisation des SI afin de les orienter vers une meilleure circulation de la donnée, et construisons des produits data à destination des métiers. Nous intervenons ainsi dans des secteurs à l’impact quotidien : les mobilités, la santé, le logement, le travail, l’inclusion, l’environnement, la fiscalité, les douanes, etc.
Nous réinterrogeons et transformons les organisations à travers une meilleure prise en compte des données au service de l’impact : c’est une des traductions concrètes de notre offre Transfo-soft.
Afin de faciliter la vie des usagers, citoyens comme entreprises, notre pôle Intelligence juridique et conformité a appuyé l’ouverture des données, comme celles produites par France Chaleur Urbaine ou MaCantine.
Moderniser les SI est un prérequis pour faciliter la circulation de la donnée. Pour cela, nous proposons une expertise d’audit nous permettant de formuler des recommandations d’actions concrètes. L’objectif est d’engager la transformation par les métiers, en améliorant leur process internes ou leur organisation produit par exemple.
Nous avons accompagné de nombreux acteurs, territoires et gouvernements dans la concertation, la construction et la priorisation de leurs stratégies data. Un seul impératif : mettre l’humain, que ce soit les métiers, les acteurs économiques et/ou les usagers au cœur de la réflexion.
Pour embarquer ces différents collectifs, qu’ils soient spécialistes ou non de la data, nous disposons d’un large éventail de formats : open-lab, ateliers, entretiens, expérimentations, cas d’usage, datadays, hackathons. Il s’agit là d’une première brique de notre approche produit des stratégies data, visant ensuite à s’interroger sur les données à mobiliser, la gouvernance à constituer, les compétences à renforcer, avant de réaliser des expérimentations à petite échelle pour confirmer les orientations.
Ces missions ont largement ponctué notre activité en 2023. Voici quelques exemples emblématiques :
Réaliser le bilan de la feuille de route du numérique 2021-2023 du Ministère de l’Éducation nationale et de la Jeunesse et des Académies et identifier les actions du futur plan relatif aux données et codes sources pour la période 2024-2027 à travers un open-lab.
Mobiliser le potentiel des datas pour améliorer les mobilités à l’échelle régionale lors d’un hackathon au cours duquel les participants pouvaient répondre aux quatre défis pensés en lien avec la stratégie open data d’Île-de-France Mobilités.
Aligner les différentes parties prenantes du Groupe Vyv sur une position ambitieuse autour de l’ouverture des données assurantielles, qui permette de mettre l’usager au centre de l’utilisation de ces données, en organisant une série d’open-lab.
Accompagner la rédaction de la feuille de route de la Direction du Numérique et de la Modernisation de Nouvelle-Calédonie, en organisant en partenariat avec Atlas Management une série d’ateliers, en proposant un parangonnage des exemples internationaux et en coachant des prototypes (POC) data appuyés sur la donnée.
Nous suivons la même méthode produit dans la conception de services numériques appuyés sur des données. 2023 a été marquée par la conception de 10 produits numériques par notre Pôle design et technologies.
Par exemple, avec La Fabrique des ministères sociaux et l’ARS Île-de-France, nous avons conçu et développé un outil de datavisualisation des causes médicales de décès, s’appuyant sur quelques 315K certificats de décès franciliens émis depuis 2020 et l’industrialisation d’un flux de données de l’INSERM.
Nous avons également accompagné l’Agence Nationale d’Information sur le Logement (ANIL) dans l’élaboration d’une base de données partagée avec ses relais départementaux, afin de faciliter le partage d’informations au sein du réseau. AdilStatWeb2 a été consulté 815 000 fois et une interface de croisement des données a été créée.
La démocratisation des intelligences artificielle génératives (IAG) est en train de bousculer nos pratiques à une vitesse fulgurante. Avec ces avancées, viennent des défis complexes en matière de sécurité, de responsabilité et de protection des droits fondamentaux.
Pour en savoir plus sur l’encadrement législatif de l’intelligence artificielle, (re)découvrez nos derniers articles de décryptage :
En interne, nous mobilisons plusieurs outils d’IAG (ChatGPT, MidJourney et Copilot) pour gagner en maîtrise et en efficacité tout en explorant les fonctionnalités pour de futures missions. Nous sommes d’ailleurs en train d’entraîner un NuméricitéGPT, connecté à OpenAI et basé sur le scraping des contenus de notre site, pour répondre à des besoins de communication et de partage des savoirs en interne.
Dans le cadre de nos missions, nous nous sommes particulièrement intéressés au domaine des agents conversationnels appuyés sur de grands modèles de langage (Large Language Model ou LLM). Ces innovations nous ont permis de développer des solutions adaptables, qui garantissent la protection des données exploitées.
Nous avons entraîné un modèle basé sur le LLM Mistral pour expérimenter l’usage d’un agent conversationnel sur des questions de santé sexuelle. Pour répondre, l’agent s’appuie sur des contenus web scrapés sur différents sites officiels.
Nous avons prototypé deux agents conversationnels connectés à OpenAI grâce à une clé d’API. L’hébergement de ces bots sur nos serveurs garanti la souveraineté en assurant qu’aucune données fiscales sensibles ne soient transmises à OpenAI. Grâce à ces bots, les agents de la Direction Générale des Impôts (DGI) de Mauritanie acquièrent de l’autonomie dans leurs tâches quotidiennes en pouvant générer de manière automatisée des rapports d’analyse des indicateurs issus de leur tableau de bord (bot Reporter) et interroger directement leurs jeux de données (FileBot).
Notre pôle Intelligence juridique et conformité participe à déterminer et maîtriser les impacts de l’IA dans l’administration. Cela l’a conduit à élaborer différents guides de bonnes pratiques. Avec La Javaness, nous avons accompagné Pôle Emploi afin de confronter l’offre de service de la plateforme IA aux différents usages, afin d’en adapter le contenu et inscrire ce produit et les services associés dans un processus d’amélioration. L’enjeu était de créer un socle IA du service public de l’emploi qui soit un gage de souveraineté et d’efficacité pour la puissance publique.
Numéricité prône une approche 360° de la conformité : nos missions s’articulent entre la protection de la vie privée et la circulation des données. Nous intervenons tant à l’échelle d’un projet qu’à l’échelle d’une organisation et proposons pour cela une conception agile de la conformité. Pour cela, nous travaillons au plus près des équipes, en leur proposant de nombreux formats adaptés à leurs besoins, que ce soit des cliniques, des formations, des stands ou du question/réponse via messagerie instantanée.
Nous avons accompagné la conformité d’acteurs de toutes tailles, publics comme privés, dont plus d’une centaine de Startups d’État.
Nous avons pu également administrer un premier audit “blanc” à l’Unédic, inspiré des audits de certification appliqués par la CNIL, afin de formuler des recommandations et des corrections.
Chez Numéricité, nous avons l’open source chevillé au corps (et au cœur). Dans l’ensemble de nos projets, nous nous efforçons de mettre en place ou orienter nos clients vers des solutions open source.
Nos convictions dans les communs se sont aussi traduites par notre participation à la sixième édition de Numérique en Commun[s]. À cette occasion, nous avons pu proposer deux ateliers sur la conception de produits data avec et pour des utilisateurs non spécialistes de la donnée, et sur le RGPD comme accélérateur des projets. Nous avons également accompagné l’Institut national de l’information géographique et forestière (IGN), partenaire de l’évènement, dans la conception et l’éditorialisation de ses formats.
Vivez notre aventure à Numérique en Commun[s] et découvrez les cinq principes d’action pour développer des produits data avec et pour des utilisateurs non spécialistes de la donnée issus de l’atelier :
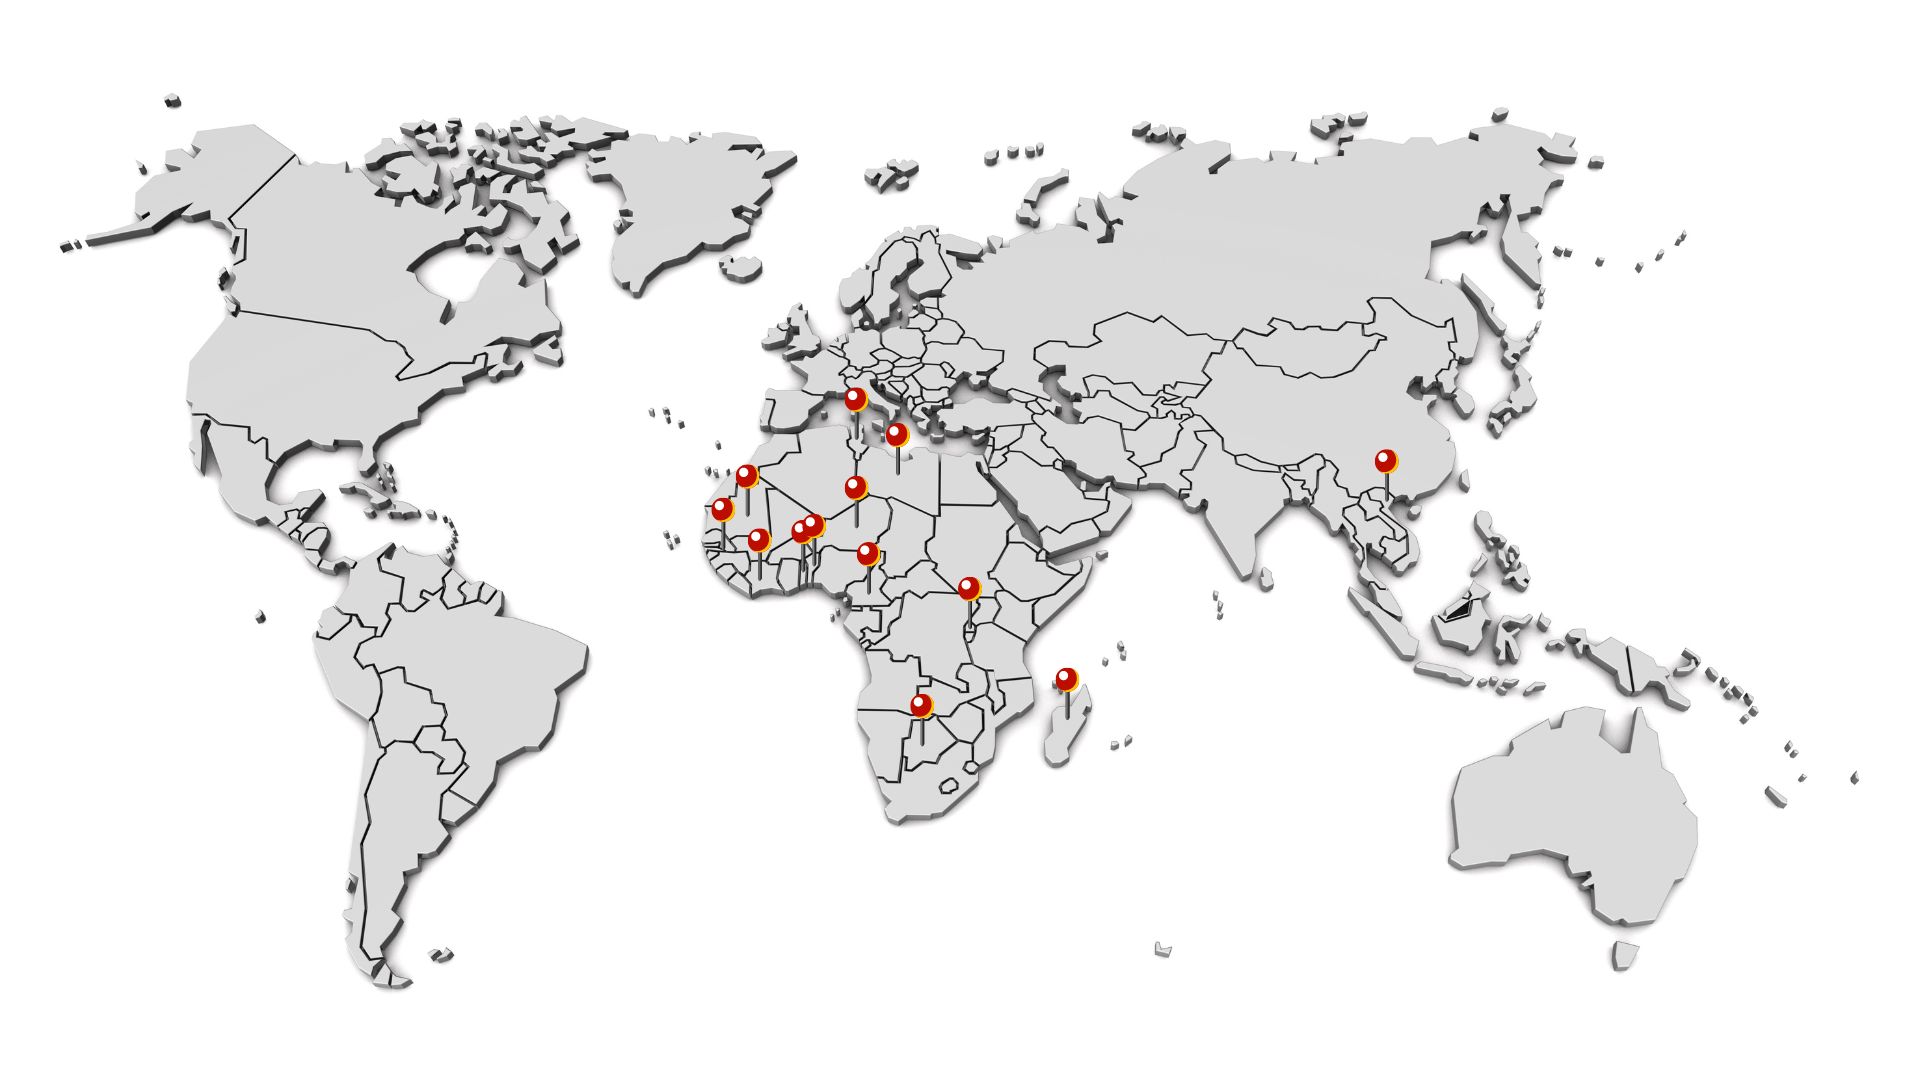
Cette rétrospective de nos activités en 2023 serait incomplète sans parler nos interventions à l’international et notre expertise e-gov. Nous intervenons actuellement dans 15 pays.
Carte des pays d'intervention de Numéricité en 2023
Nos interventions e-gov sont au croisement de l’ensemble de nos expertises.
Accompagnement dans l’élaboration de stratégies data
Au Rwanda, nous avons poursuivi notre mission afin d’évaluer la maturité numérique des administrations, mettre en place et animer la gouvernance du réseau interministériel des “chiefs digital officers”.
À Madagascar, nous sommes intervenus sur les enjeux du partage des données entre administration et la nécessaire rationalisation des architectures du SI en vue de la numérisation de l’État-civil, afin d’Insuffler la dynamique et la culture de l’interopérabilité au sein d’administrations fonctionnant en silo.
Au Botswana, nous avons formulé un cadrage stratégique des activités de l’opérationnalisation de la stratégie SmartBots, visant à stimuler la transformation numérique dans l’économie, le gouvernement et la société.
Nos experts référencés par le Fonds Monétaire International (FMI) ont par ailleurs appuyé la réalisation d’études préparatoires au Cameroun et en Tunisie.
En juillet 2023, nous avons été sollicités afin de construire et faciliter un séminaire de partage d’expérience organisé par le FMI pour 8 administrations fiscales d’Afrique centrale à Yaoundé : Burundi, Cameroun, Guinée équatoriale, République centrafricaine, République du Congo, République Démocratique du Congo, Sao Tomé-et-Principe, et Tchad.
En octobre 2023, nous avons évaluer la gestion de la conformité et l’analyse des données de la DGI tunisienne afin de formuler des recommandations techniques, et sensibiliser les agents et les cadres au lien avec le Compliance Risk Management.
Ingénierie juridique et conformité :
En Libye, au Bénin, en Mauritanie, au Cameroun et au Vietnam, nous avons réalisé une cartographie du droit applicable, et formulé des guides des bonnes pratiques afin d’orienter les édifices juridiques de ces pays.
Pour Ho Chi Minh Ville, nous avons analysé les textes prévus dans le cadre du déploiement d’une plateforme de services publics en lignes afin d’identifier les manques pour la mise en application opérationnelle (gouvernance des données, régulation, responsabilité, interopérabilité, etc.). Nous avons également formulé une série de recommandations en nous appuyant sur les meilleurs pratiques issues des standards internationaux en la matière.
Pour en savoir plus sur notre accompagnement de la Libye dans l’appréhension des enjeux de la transformation numérique
Mobiliser des modèles d’intelligence artificielle pour améliorer l’efficacité du contrôle douanier ? Nous l’avons rendu possible en expérimentant RandomForestClassifier, un algorithme d’apprentissage supervisé, avec les douanes nigériennes.
Automatiser la génération de rapports de données grâce à l’intelligence artificielle ? Nous avons prototypé deux bots pour la Direction Générale des Impôts mauritanienne. Le bot “Reporter” et le “FileBot” sont des Proof of concept servant de base à une étude préalable avant de développer un modèle d’intelligence artificielle générative.
Formations et transmission d’expertise :
Nous avons rédigé un guide à destination des cadres de l’administration vietnamienne, sur les bonnes pratiques françaises en matière de dématérialisation de l’administration.
En Côte-d’Ivoire, au Togo et en Mauritanie, 180 agents des administrations fiscales et douanières ont été formés aux techniques de datascience, à travers plus de 80 sessions de formations, donnant lieu à la création d’une quarantaine de tableaux de bord.
Les agents des impôts du Sénégal ont suivi nos formations aux techniques de webscraping et datamining.
2023 a été une année de succès, d’innovation et d’impact pour Numéricité. Nous nous imposons comme un acteur de l’écosystème de la transformation numérique, tout en y apportant notre touche d’originalité.
Nous continuons de transformer la transformation numérique avec une équipe talentueuse d’experts et des projets ambitieux, en portant une attention particulière à l’impact et à l’éthique.
Pour en découvrir davantage sur notre méthode et envisager de nouveaux projets ensemble, contactez-nous : contact@numericite.eu
C’est lors de l’AWS Summit Paris 2024, que Julien Groues (General Manager – Europe South, AWS) a annoncé hier l’arrivée en France d’Amazon Bedrock, un service qui permet de créer et de mettre à l’échelle des applications d’IA génératives à l’aide de modèles de fondation. Il donne désormais accès au dernier modèle de Mistral AI, Mistral Large, ainsi qu’à Claude 3 Haiku et Claude 3 Sonnet d’Anthropic.
Lancé en avril 2023, Amazon Bedrock permet à ses utilisateurs de personnaliser des LLM en fonction de leurs besoins et de leurs données au lieu d’utiliser des modèles prêts à l’emploi. A l’origine, ceux-ci avaient le choix entre les modèles de fondation des start-ups AI21 Labs, Anthropic, Stability AI et les modèles Titan d’Amazon, Titan Text Lite et Titan Text Express. En septembre dernier, AWS enrichissait ce service avec l’ajout de Claude 2 d’Anthropic, Stable Diffusion XL 1.0 de Stability AI, le modèle phare “Command” de la start-up canadienne Cohere ainsi que son modèle “Embed”.
AWS souligne qu’aucune des données du client n’est utilisée pour former les modèles sous-jacents, et comme toutes les données sont chiffrées et ne quittent pas le Virtual Private Cloud (VPC) d’un client, les clients peuvent être sûrs que leurs données resteront privées et confidentielles. Le service est facturé en fonction de son utilisation.
Lors de la keynote de cette conférence dédiée au cloud, à la data et l’IA, Julien Groues, accompagné de Mai-Lan Tomsen-Bukovec (VP of Technology, AWS), a expliqué comment les technologies AWS permettent aux clients de tirer parti de la puissance de l’IA générative. Après les témoignages clients de Fabien Mangeant (Chief Data and AI Officer, Air Liquide) et Raphaëlle Deflesselle (CTO, Groupe TF1), Arthur Mensch (cofondateur et CEO, Mistral AI), est monté sur scène où il a expliqué que la plateforme d’AWS est un canal de distribution particulièrement efficace. Thomas Wolf (cofondateur de Hugging Face) et Tom Brown (cofondateur d’Anthropic), deux start-ups qui ont bénéficié des investissements d’Amazon, Hugging Face lors de sa dernière levée de fonds, et Anthropic dans le cadre d’une collaboration élargie avec le géant du cloud qui pourrait lui rapporter jusqu’à 4 milliards, sont également intervenus.
Les 3 cofondateurs ont rappelé l’importance de l’infrastructure cloud d’AWS qui leur donne un accès aux puces AWS Trainium et Inferentia, conçues pour accélérer l’entraînement des modèles d’IA, améliorer le temps d’inférence et réduire les coûts.
AWS annonce la disponibilité d'Amazon Bedrock en France
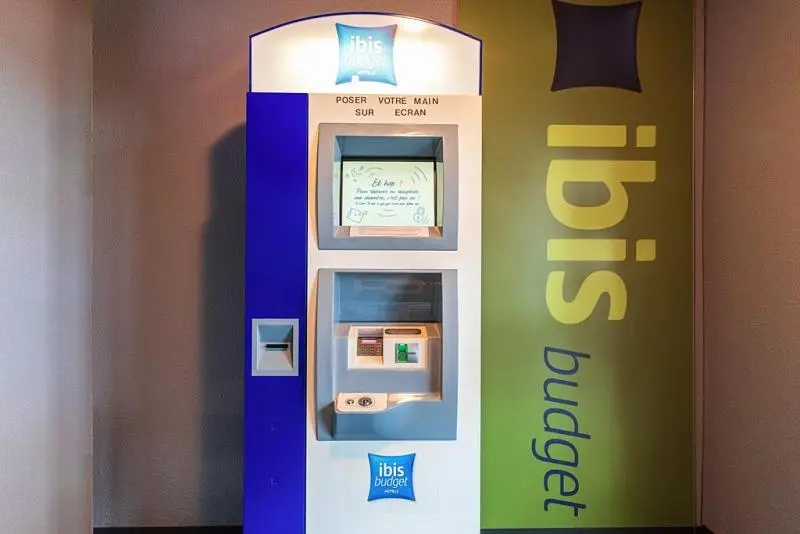
C’est vachement pratique de pouvoir récupérer sa chambre d’hôtel après une grosse journée, simplement en passant par le terminal qui se trouve dans l’entrée de l’hôtel. On tape son nom, on paye et paf, on récupère son numéro de chambre et le code pour y accéder. Sauf que ce que vous ignorez peut-être, c’est que ce même terminal vient potentiellement d’exposer votre code d’accès à des personnes mal intentionnées…
C’est exactement ce qui s’est passé dans un hôtel IBIS Budget à Hambourg, en Allemagne. Lors d’un congrès de hackers, la société Pentagrid a remarqué une faille de sécurité pour le moins inquiétante dans le terminal de check-in. Ainsi, en entrant une série de tirets à la place du numéro, le terminal liste toutes les réservations avec leur numéro, la date d’arrivée prévue et le prix total du séjour. Puis en sélectionnant une réservation, on accède directement au numéro de chambre et au code d’accès de la porte.
Dans l’hôtel en question, pas moins de 87 réservations étaient ainsi exposées, soit près de la moitié des 180 chambres de l’établissement !
Vous imaginez le désastre si ces codes tombaient entre de mauvaises mains ? Adieu vos effets personnels, surtout dans un hôtel bas de gamme comme celui-ci qui n’est pas équipé de coffres-forts dans les chambres. Et je vous parle pas des agressions en pleine nuit ! C’est la porte ouverte à toutes les fenêtres comme dirait l’autre.
Fort heureusement, Pentagrid a immédiatement signalé cette faille à la chaîne hôtelière Accor, propriétaire des hôtels IBIS. Le problème a depuis été corrigé, mais il aura fallu quand même plusieurs échanges et relances de la part des hackers pour que des actions soient entreprises de la part d’Accor.
Mais comment une telle faille a-t-elle pu se produire ? Et bien d’après les informations fournies par Pentagrid sur leur blog, il semblerait que le terminal de check-in ait une fonction de recherche des réservations qui nécessite uniquement le numéro de réservation pour afficher le numéro de chambre et le code d’accès. Donc c’est pas un bug, c’est une feature qui a mal tournée…
Le pire dans tout ça, c’est que de base, les numéros de réservation ne sont pas une donnée très sécurisée puisqu’on les retrouve sur toute la paperasse comme les factures…etc qui peuvent ensuite être récupérées dans une poubelle par exemple. Donc n’importe qui pourrait mettre la main dessus et accéder à votre chambre.
C’est pourquoi les auteurs de cette découverte recommandent aux hôtels de mettre en place une vérification supplémentaire pour accéder aux informations de réservation, comme un code PIN qui serait communiqué séparément au client. Les terminaux devraient aussi supprimer automatiquement les réservations dès que les informations ont été imprimées ou consultées.
En attendant, si vous séjournez dans un hôtel IBIS Budget prochainement, n’allez pas vous amuser à vérifier que la faille a été corrigée sur le terminal de check-in parce que vous ne voulez pas finir en prison pour piratage (lol).
En tout cas, sachez-le, la prochaine fois que je dors à l’IBIS, je vous attendrais de pied ferme en embuscade dans mon peignoir façon biopic DSK par Liam Neeson.
Vous en avez marre des logiciels de stéganographie qui ne tiennent pas vraiment leurs promesses en matière de sécurité et de furtivité ?
Ne cherchez plus, voici SecretPixel, un excellent outil pour planquer vos données sensibles dans des images afin de pouvoir ensuite les transmettre en toute discrétion.
Alors qu’est-ce qui fait de SecretPixel un outil si balèze comparé aux autres ? Déjà, il combine un chiffrement AES-256 de ouf pour vos données, avec une clé de session elle-même chiffrée avec RSA. Rien que ça, ça veut dire que seul le détenteur de la clé privée RSA pourra déchiffrer vos infos cachées. Niveau sécurité, on est donc au top.
Mais ce n’est pas tout ! Avant d’être chiffrées, vos données sont compressées avec zlib, ce qui réduit leur taille et minimise les schémas détectables par les outils de stéganalyse (oui c’est comme ça qu’on dit). Et pour vraiment brouiller les pistes, SecretPixel utilise un générateur de nombres pseudo-aléatoires pour déterminer les pixels qui vont accueillir vos bits cachés. Vos données sont ainsi éparpillées dans toute l’image, rendant leur détection quasi impossible, même avec des outils comme zsteg.
Le processus de chiffrement garantit que les données cachées restent confidentielles, tandis que la compression et la distribution aléatoire des données rendent extrêmement difficile pour les outils de stéganalyse de détecter la présence d’informations intégrées. L’utilisation d’un générateur de nombres aléatoires avec amorçage ajoute une couche de sécurité supplémentaire, car le schéma des données intégrées ne peut pas être prédit sans connaître l’amorce.
En prime, SecretPixel stocke aussi le nom original de votre fichier caché dans l’image. Comme ça, quand vous l’extrairez, il aura toujours son petit nom. Pratique non ?
Et vu qu’il est écrit en Python, vous pouvez l’utiliser sur n’importe quel système, tant que vous avez Python d’installé.
SecretPixel est conçu pour fonctionner avec une variété de formats de fichiers image : PNG, BMP, TGA et TIFF. Il est important de noter que le format d’image hôte choisi peut avoir un impact sur l’efficacité du processus de stéganographie. Les formats sans perte comme PNG et TIFF sont préférables pour garantir qu’aucune donnée n’est perdue pendant le processus d’intégration.
Maintenant, pour mettre la main sur ce petit bijou, rien de plus simple. Clonez le dépôt GitHub ou téléchargez le code source. Assurez-vous d’avoir Python 3 et les packages requis, et c’est parti !
git clone https://github.com/x011/SecretPixel.git
cd SecretPixel
pip install -r requirements.txt
Avant de jouer à cache-cache avec vos données, vous allez avoir besoin d’une paire de clés RSA – une clé privée et une clé publique. Pas de panique, les dev ont pensé à tout avec un script Python pour vous faciliter la tâche. Lancez donc generate_keys.py qui va vous générer une paire de clés RSA de 4096 bits en un clin d’oeil.
python generate_keys.py
Choisissez une phrase de passe bien corsée pour votre clé privée. Elle sera chiffrée avec AES-256 pour une protection maximale. Une fois le script terminé, vous aurez deux fichiers tout beaux tout chauds : myprivatekey.pem (votre clé privée chiffrée) et mypublickey.pem (votre clé publique, à partager sans modération).
Maintenant, passons aux choses sérieuses. Pour planquer un fichier dans une image, lancez cette commande :
Avant d’intégrer des données, l’image hôte ne doit pas contenir de contenu stéganographique antérieur ou de métadonnées sensibles qui pourraient entrer en conflit avec les nouvelles données ou révéler leur présence. En sélectionnant et en préparant soigneusement l’image hôte, vous améliorerez considérablement la sécurité et l’indétectabilité des données intégrées dans l’image.
De plus, l’image hôte servant de support pour les données cachées, afin de maintenir l’intégrité du processus de stéganographie et éviter la détection, il est crucial que l’image hôte soit suffisamment grande pour accueillir le fichier caché. En règle générale, l’image hôte doit avoir une capacité (en octets) au moins trois fois supérieure à la taille du fichier à cacher pour garantir que les modifications sont subtiles et largement dispersées.
Et hop, votre secret.txt est incrusté incognito dans host.png en utilisant votre clé publique mypublickey.pem. L’image résultante output.png a l’air innocente, mais elle cache bien son jeu !
Pour exfiltrer votre fichier caché d’une image, c’est tout aussi simple :
Votre fichier caché ressort de carrier.png grâce à votre clé privée myprivate.pem. Si vous ne fournissez pas de nom de fichier pour le .txt se sortie (extracted.txt), l’outil utilisera le nom du fichier qu’il aura conservé.
Des chercheurs de l’université d’Aston, en collaboration avec des pointures japonaises et américaines, viennent de réussir un exploit digne des meilleurs films de science-fiction. Ils ont réussi à transférer des données à une vitesse complètement délirante de 301 térabits par seconde, soit 301 millions de mégabits par seconde.
Pour vous donner une idée, c’est 4,5 millions de fois plus rapide que la moyenne du haut débit au Royaume-Uni, qui se traîne péniblement à 69,4 Mbit/s. Même aux États-Unis, où les connexions sont plus véloces avec une moyenne de 242,4 Mbit/s, ça reste plus d’un million de fois plus lent que ce que nos chers scientifiques ont réussi à atteindre.
Mais comment diable ont-ils fait pour arriver à un tel résultat ? Eh bien figurez-vous qu’ils ont utilisé de nouvelles bandes de longueurs d’onde qui ne sont pas encore exploitées dans les systèmes de fibre optique classiques. C’est un peu comme s’ils avaient découvert de nouvelles couleurs dans la spectre de la lumière capables de transporter les données à une vitesse supersonique dans les câbles. Ils ont même développé des amplificateurs optiques et des égaliseurs de gain pour dompter ces fameuses bandes et les rendre utilisables.
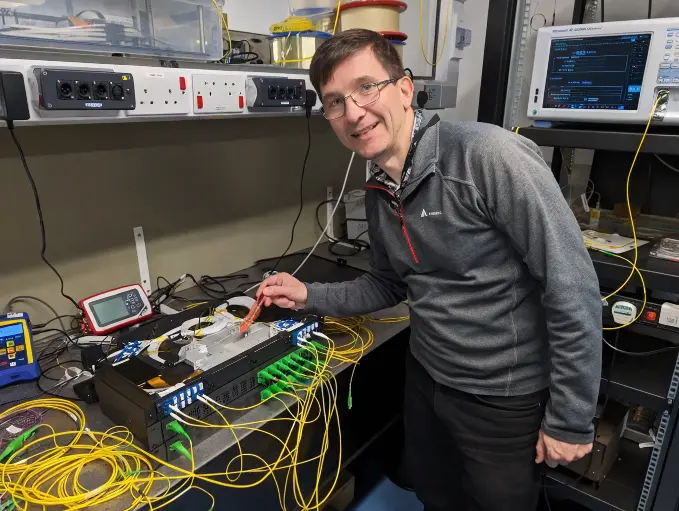
Le Dr Ian Phillips, qui a mené le développement d’un processeur optique à l’université d’Aston, explique que les données ont été envoyées via une fibre optique similaire à une connexion internet domestique. Sauf qu’en plus des bandes C et L disponibles dans le commerce, ils ont utilisé ces deux bandes spectrales supplémentaires, E et S, qui sont environ trois fois plus larges que les bandes C et L réunies. Avant leur invention, personne n’avait réussi à émuler correctement les canaux de la bande E de manière contrôlée.
Le professeur Forysiak, un autre cerveau de l’équipe, souligne que cette réalisation révolutionnaire met en lumière le rôle crucial des avancées dans la technologie de la fibre optique pour révolutionner les réseaux de communication et permettre une transmission de données plus rapide et plus fiable. En augmentant la capacité de transmission dans le réseau principal, leur expérience pourrait conduire à des connexions considérablement améliorées pour les utilisateurs finaux.
Et le plus beau dans tout ça, c’est que cette prouesse ne nécessite pas de nouvelles infrastructures pour améliorer drastiquement les vitesses internet. Elle permet d’augmenter significativement le débit des câbles de fibre optique existants. C’est non seulement une solution plus écologique que de déployer de nouvelles fibres et de nouveaux câbles, mais cela permet aussi de prolonger la durée de vie et la valeur commerciale du réseau de fibres déjà en place.
Alors certes, on n’est pas près de voir débarquer cette technologie de dingue chez nous, mais imaginez un peu ce que ça pourrait changer. Télécharger un film en 4K ? Une fraction de seconde. Streamer du contenu en 8K sans la moindre latence ? Facile. Jouer en ligne avec un ping proche du zéro absolu ? Du gâteau. Les possibilités sont juste hallucinantes.
Et ce n’est pas tout, car cette avancée pourrait aussi révolutionner l’accès à internet dans les zones mal desservies. Fini les connexions pourries dans les campagnes ou les régions reculées. Avec des débits pareils, on pourrait enfin avoir un internet à très haut débit partout, pour tout le monde. Ça serait un véritable bond en avant pour réduire la fracture numérique. Si Free propose ça un jour, promis, je change de crèmerie ^^.
Mais ne nous emballons pas trop vite non plus. Il faudra sûrement des années avant que cette technologie ne se démocratise et arrive dans nos petits foyers. Les opérateurs devront adapter leurs infrastructures, les fabricants devront créer des équipements compatibles, et tout ça va prendre un temps fou et coûter un bras. Mais quand même, savoir que c’est possible, et que des petits génies sont en train de repousser les limites de la science pour nous offrir un internet de folie, ça fait rêver.
Figurez-vous que notre cher Meta (anciennement Facebook, alias Face2Bouc pour tonton Michel), s’est fait prendre la main dans le sac en train d’espionner son concurrent Snapchat ! Et attention, on ne parle pas d’un petit coup d’œil indiscret, non c’est carrément une opération d’espionnage digne des meilleurs films d’espionnage, au nom de code : « Projet Ghostbusters » !
Alors comment cette histoire a débuté ?
Eh bien tout simplement parce que Zucky et sa bande étaient jaloux de ne pas avoir accès aux précieuses données analytiques de Snapchat. Ils ont donc sorti l’artillerie lourde : Onavo, leur propre VPN censé protéger la vie privée des utilisateurs. Sauf qu’en fait, c’était tout l’inverse !
Grâce à Onavo, Meta a pu installer ses propres certificats SSL/TLS ce qui lui a permis d’intercepter le trafic de Snapchat et d’autres apps comme YouTube ou Amazon, pour les espionner en douce !
Une équipe de choc de 41 avocats et dirigeants avait même été mobilisée pour mener à bien cette mission top secrète.
Bon évidemment, quand l’affaire a éclaté en 2018, Meta a essayé de noyer le poisson en mode « circulez y a rien à voir ». Mais aujourd’hui les documents judiciaires ne mentent pas et montrent bien que Zuckerberg était au courant de tout ce bazar. Et le pire dans tout ça, c’est que cette opération pourrait bien être totalement illégale selon la loi américaine sur les écoutes électroniques !
En espionnant Snapchat, Meta voulait surtout avoir un avantage sur le marché publicitaire où la concurrence fait rage.
Bref c’est pas joli joli et Zuckerberg risque bien d’avoir des ennuis avec la justice américaine.
Saviez vous que les fichiers Parquet se prenaient pour des bombes ? Alors pas des bombes latines mais plutôt des bombes zip.
Alors, pour ceux qui débarquent de la planète Mars, il faut savoir que Parquet est devenu le format de prédilection pour échanger des données tabulaires. Très utilisé dans tout ce qui est Big Data et qui met une claque à ce bon vieux CSV tout pourri, Parquet, c’est binaire, c’est colonnaire, c’est compressé, c’est top !
Mais attention, derrière cette apparente perfection se cache un danger mortel pour vos disques durs et autres SSD ! En effet, même un fichier Parquet parfaitement valide peut mettre un sacré bordel et faire planter tous vos services.
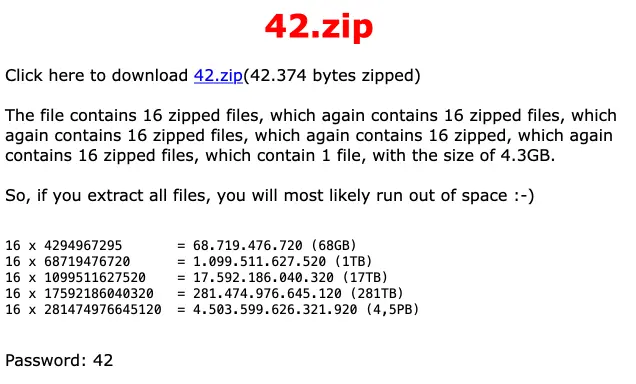
Comment ? Et bien simplement avec ce fichier de seulement 42 Ko qui contient… tenez-vous bien… plus de 4 PÉTAOCTETS de données !! Oui, on parle bien de 4 millions de gigaoctets dans un malheureux fichier de 42 Ko, fallait oser.
Eh bien c’est grâce à un petit tour de passe-passe démoniaque appelé « encodage par dictionnaire« . En gros, on lui donne un dictionnaire avec une seule valeur, et ensuite on fait référence à cette valeur en boucle, environ 2 milliards de fois. Résultat, on obtient un fichier minuscule car compressable au maximum mais qui une fois dézippé représente une table monstrueusement gigantesque.
C’est subtil… mais c’est vicieux ! 😈
Imaginez un peu le carnage si vous balancez ce fichier innocent dans votre pipeline Big Data sans faire gaffe… Boom ! 💥 Plantage général, crash systémique, apocalypse nucléaire ! Vos services vont tenter de lire ce fichier en pensant que c’est un gentil petit fichier Parquet de rien du tout, et là… Surprise ! C’est le chaos total. Votre cluster va fondre comme neige au soleil en essayant d’avaler ces pétaoctets de données.
Morale de l’histoire, faites attention à tout, même à ce que vous dézippez.
Et si vous avez un peu de place sur votre disque dur, vous pouvez toujours tenter l’aventure en téléchargeant 42.zip ici. (NON, NE DEZIPPEZ PAS CE TRUC !! MAUVAISE IDEE !!) (le mot de passe du zip est : 42)
Le Health Data Hub, plateforme de données de santé des patients français lancée en 2019, a choisi Microsoft Ireland pour héberger ces données particulièrement sensibles sur Azure. Choix qui a été loin de faire l’unanimité et bien qu’il ait été conforté en décembre dernier par la CNIL, plusieurs sociétés, associations et particuliers dont Clever Cloud, Cleyrop, Nexedi, Rapid.Space, l’Open Internet Project, l’Association de défense des libertés constitutionnelles et Bernard Benhamou de l’Institut de la souveraineté numérique ont décidé de saisir le Conseil d’Etat.
Le Health Data Hub a été créé pour permettre de croiser les bases de données de santé (système national des données de santé, données collectées auprès des hôpitaux, des médecins…) et faciliter leur utilisation par les nombreuses équipes de recherche et de développement avec un respect total de la vie privée des usagers du système de santé.
Le ministère de la Santé et de la Prévention et la CNIL privilégiaient à l’origine un hébergeur européen mais le ministère ayant considéré qu’il n’y avait pas de solutions européennes opérationnelles avant 2025, Microsoft Azure, qui avait été choisi comme hébergeur cloud sans appel d’offres, est amené à le rester pour quelque temps encore. Le problème est que même si ces données sont stockées dans des datacenters situés en France, Microsoft est basé aux Etats-Unis et sa filiale irlandaise est soumise au droit américain, ce qui implique la possibilité légale de demandes de communication des données par l’administration des Etats-Unis.
Dès 2020, la CNIL a exprimé des préoccupations concernant le risque de transfert de données vers les États-Unis. Des requérants, associations et professionnels, ont alors saisi le Conseil d’Etat d’un recours demandant la suspension du Health Data Hub. Dans son ordonnance du 13 octobre 2020, le Conseil d’État reconnaissait l’existence d’un risque de transfert de données issues du Health Data Hub vers les États-Unis et demandait des garanties supplémentaires, mais, au regard de son utilité pour la gestion de la crise sanitaire, refusait de suspendre le fonctionnement de la plateforme.
Le projet EMC2
Le Health Data Hub a remporté fin 2021 l’appel d’offres lancé par l’Agence européenne du médicament (EMA) visant à constituer un entrepôt de données de santé multi-centrique afin de permettre aux établissements de santé, aux institutions publiques, aux associations de patients ou encore aux agences européennes comme l’EMA de réaliser des recherches, des études et des évaluations. Cet entrepôt de données de santé dénommé “EMC2” est alimenté par les données de 4 établissements de santé partenaires avec un appariement à la base principale du Système National de Données de Santé (SNDS).
S’appuyant sur les avis de la DNS (Délégation au numérique en santé), l’Agence du Numérique en Santé (ANS), la Direction Interministérielle du Numérique (DINUM) et l’Institut National de Recherche en Informatique et en Automatique (INRIA), la CNIL a rendu en décembre dernier un avis favorable sur la capacité du Health Data Hub à gérer ce projet et l’a autorisé à mettre en œuvre le traitement automatisé de données à caractère personnel ayant pour finalité la constitution de cet entrepôt de données de santé.
Ce qui sous-entend que Microsoft va héberger pendant trois ans de nombreuses informations médicales de 300 000 à 600 000 patients français au grand dam des entreprises françaises et européennes qui seraient légitimes sur ce marché.
Clever Cloud, Cleyrop, Nexedi, Rapid.Space, l’Open Internet Project, l’Association de défense des libertés constitutionnelles et Bernard Benhamou demandent l’annulation de la décision de la CNIL, ou du moins la transmission d’une question préjudicielle à la CJUE, La Cour de justice de l’UE.
L’affaire sera traitée en audience publique le 19 mars à 11h, une conférence de presse sera organisée en présence des requérants le 18 mars à 8h30 au café le Concorde, à Paris.
Health Data Hub des entreprises s'insurgent contre la décision de la CNIL et saisissent le Conseil d'Etat





 Numéricité recrute un(e) juriste en stage pour rejoindre notre équipe de passionné(e)s !
 En bref :

 Numéricité 9 rue de Mulhouse 75002 Paris