❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

W’ise : l’offre Worteks qu’il est sage d’avoir pour son organisation

Une offre, sept domaines, plus de 100 technologies

W’ise, pour Worteks Intégration Support et Expertise, c’est notre façon de nommer ce que l’on fait depuis des années : intégrer des solutions Open Source éprouvées, les opérer en production, les maintenir dans le temps, et être là quand vous en avez besoin.

Découvrir l’offre W’ise

Sept domaines, des outils qui existent vraiment, des retours d’expérience réels.

Représentation des services de W'ise dans un nuages de logos des technologies couvertes

Cybersécurité, IAM / Auth / PKI / SIEM / Zero Trust

La cybersécurité est la principale préoccupation des RSSI depuis plusieurs années. Dans les faits, une proportion écrasante des incidents sérieux commence par la même chose : un compte compromis, un accès mal configuré, un droit qui n’aurait pas dû exister.

La vraie fondation, c’est l’IAM (Identity and Access Management). Pas le Zero Trust des discours marketing mais le Zero Trust en production !

Ce que l’on déploie :

  • LemonLDAP::NG, serveur WebSSO dont nous sommes contributeurs et mainteneurs. SAML 2.0, OpenID Connect, OAuth 2.0, CAS, Kerberos. Utilisé dans de nombreux ministères, des OIV (Opérateurs d’Importance Vitale), chez des grands comptes. La solution a fait ses preuves depuis de nombreuses années en production et gère l’authentification de plusieurs centaines de millions d’utilisateurs dans le monde.
  • Keycloak, quand les besoins d’intégration applicative le justifient, notamment pour les environnements multi-tenants ou les écosystèmes de microservices.
  • TOTP, WebAuthn/FIDO2, YubiKey, certificats. Des méthode de MFA sérieuses, pas de code par mail ou SMS qui sont des solutions désormais dépréciées.
  • PKI Open Source, EJBCA, Dogtag/FreeIPA, gestion des certificats internes, chaîne de confiance maîtrisée.
  • FranceConnect / ProConnect / eIDAS, intégrations opérationnelles pour le secteur public et ses partenaires.
  • Wazuh, IDS, détection comportementale, conformité (ISO 27001, NIS2, HDS), corrélation d’évènements.
  • Suricata / pfSense / OPNsense, IDS/IPS réseau et firewall Open Source en production.

Ce que nous avons fait : Migration IAM d’une administration centrale opérant plusieurs dizaines de milliers de comptes depuis un SSO vétuste vers LemonLDAP::NG, avec maintien de la production, intégration des applications métier legacy, et MFA déployé sur l’ensemble du parc sans interruption de service.

Virtualisation et VDI, Migration depuis VMware / IaaS / VDI

VMware post-Broadcom a rendu un grand service à l’Open Source : il a transformé une préférence philosophique en impératif budgétaire. Des DSI qui n’auraient jamais envisagé une migration se retrouvent à la planifier en urgence. Nous sommes là pour ça !

Ce que l’on déploie :

  • Proxmox VE, hyperviseur KVM/LXC, interface claire, clustering, migration live, sauvegarde intégrée avec PBS. C’est probablement le point d’atterrissage le plus direct depuis VMware pour les environnements de taille intermédiaire.
  • XCP-ng / XenServer, alternative sérieuse sur les parcs importants, notamment quand Citrix Hypervisor était en place.
  • oVirt, pour les environnements qui ont besoin de la gestion entreprise et du suivi de cycle de vie structuré.
  • OpenStack, pour les besoins de cloud privé à grande échelle, multi-tenant, API-compatible AWS/Azure.
  • Ceph, stockage distribué, résilient, sans SAN propriétaire.
  • VDI / publication d’applications, via des stacks intégrées autour d’Apache Guacamole, oVirt, et des automatismes AWX. Publication d’applications Linux et Windows, authentification forte intégrée via notre IAM. Le coût d’exploitation n’a rien à voir avec une licence Citrix.
  • Kyber, pour les besoins de déport d’affichage avec une autre philosophie que le VDI classique.

Ce que nous avons fait : Migration de clusters VMware vSphere (vCenter, vSAN) vers la ou les solutions pour des collectivités et des structures industrielles, avec plan de migration par vague, maintien de la production, et réduction des coûts d’infrastructure dans des proportions qui ont convaincu des directions financières pourtant peu sensibles à l’Open Source par principe. Tout en mettant en avant, en toute transparence, les coûts liés à la montée en compétences des équipes en interne et aux contraintes d’un projet.

Supervision et Logs, SIEM / Observabilité / Télémétrie

Une infrastructure qui n’est pas supervisée, c’est une infrastructure qui tombe sans prévenir. Une infrastructure supervisée avec des tableaux de bord qui clignotent sans seuils cohérents, c’est presque pareil.

L’observabilité, c’est savoir ce qui se passe, pourquoi, et être averti avant que les utilisateurs ne le soient.

Ce que l’on déploie :

  • Zabbix, supervision infrastructure, réseau, applicatif. Solide, scalable, peut-être pas très ergonomique mais efficace et éprouvé.
  • Prometheus + Grafana, métriques en temps réel, dashboards, alerting. Le standard, de fait, des environnements conteneurisés.
  • OpenTelemetry, collecte unifiée de métriques, traces et logs. Plus besoin d’utiliser trois agents différents.
  • Jaeger, pour voir ce qu’il se passe aux cœurs des applications.
  • Loki, agrégation de logs, requêtes simples, intégration native dans la stack Grafana.
  • OpenSearch / ELK, pour les besoins d’indexation et de recherche full-text sur les logs, avec Kibana ou OpenSearch Dashboards.
  • Wazuh, SIEM Open Source, corrélation d’évènements, détection d’intrusion, conformité réglementaire. Ici, il fait le pont entre supervision, sécurité et SOC.

Ce que nous avons fait : Mise en place d’une plateforme d’observabilité unifiée pour un opérateur critique, couvrant plusieurs centaines de nœuds, avec alerting gradué, escalade d’astreinte automatisée, et intégration SIEM pour la remontée des évènements de sécurité vers le SOC.

Collaboratif, W’Sweet / Visio / PeerTube

W’Sweet, c’est notre réponse concrète à la question qu’on entend souvent : “Microsoft 365, c’est bien, mais on aimerait ne plus en dépendre. C’est vraiment faisable ?”

Oui. C’est faisable. On le fait.

Ce que l’on intègre :

  • BlueMind, messagerie collaborative française, compatible Outlook en protocole natif (MAPI), pas un connecteur susceptible de ne plus fonctionner à chaque mise à jour. Agendas partagés, contacts, mobilité ActiveSync, webmail. Utilisé dans des environnements exigeants y compris dans le secteur public.
  • Nextcloud, partage de fichiers, édition collaborative (Collabora Online ou OnlyOffice intégré), gestion des tâches, flux d’approbation. Vos données restent sur votre infrastructure.
  • Matrix / Element, messagerie instantanée décentralisée, chiffrée de bout en bout, fédérable entre organisations. La vraie alternative à Teams pour la communication interne et inter-organisationnelle.
  • BigBlueButton visioconférence Open Source, déployée sur vos serveurs. Sans limite d’utilisateurs liée à une licence, sans données qui transitent chez un tiers.
  • Jitsi Meet, solution de visio plus légère, déployable rapidement pour des besoins moins formels.
  • PeerTube, hébergement et diffusion de vidéos interne ou public, fédéré, sans YouTube. Pour les formations, les webinaires, la communication institutionnelle…
  • La Suite, les outils de travail collaboratif soutenus par l’Etat, que nous savons déployer et intégrer à votre SI.

Ce que nous avons fait : Déploiement de W’Sweet pour des collectivités et des structures publiques qui sortaient de Microsoft 365 dans le cadre d’une démarche de souveraineté numérique, avec migration des données, formation des utilisateurs, et maintien de la compatibilité avec les partenaires externes restés sur Exchange/Outlook.

Audit, Sécurité / Rationalisation de SI / Conformité

Avant d’intégrer quoi que ce soit, il faut parfois comprendre dans quel état se trouve ce qu’on a. Et c’est souvent plus instructif qu’on ne le croit !

Ce que l’on fait :

  • Audit de sécurité, revue de configuration IAM, analyse des droits et des accès, audit de l’exposition réseau, revue des politiques de mot de passe et MFA, identification des comptes dormants et des privilèges excessifs.
  • Audit d’infrastructure, état des hyperviseurs, des sauvegardes, de la supervision, de la documentation. On dit ce qu’on trouve, y compris ce qui ne fait pas plaisir.
  • Audit de conformité, RGPD, NIS2, HDS, ISO 27001. Avec des livrables directement utilisables et des préconisations cohérentes et qu’il est possible de mettre en oeuvre.
  • Rationalisation de SI, identification des doublons fonctionnels, des licences inutilisées, des briques obsolètes. Nous connaissons des scoiétés qui payaient trois outils différents pour faire la même chose et dont aucun n’était performant.
  • Étude de migration, faisabilité, plan de migration, coût réel (pas optimiste), risques. Que ce soit depuis VMware, Citrix, Microsoft 365, ou un annuaire AD difficilement administré et rarement mis à jour.

Ce que nous avons fait : Audit de rationalisation pour une administration régionale avec cartographie des applications, identification des redondances, plan de migration sur 18 mois, et économies réalisées supérieures au coût de la mission dès la première année.

Conteneurs et CI/CD, Kubernetes / Talos / Tekton / ArgoCD

Les conteneurs ont gagné. Kubernetes est devenu le plan de contrôle de facto pour les workloads modernes. La question n’est plus “est-ce qu’on y passe ?” mais “comment on le fait proprement, sans dette technique dès le premier jour ?”.

Ce que l’on déploie :

  • Kubernetes, déploiement On-Premise ou sur cloud souverain, configuration réseau (Cilium, Calico), stockage persistant (Rook-Ceph, Longhorn), gestion des namespaces et des droits.
  • Talos Linux, OS minimaliste, immuable, conçu pour Kubernetes. Pas de SSH, pas de shell. La surface d’attaque est radicalement réduite. C’est le choix qu’on fait quand la sécurité compte vraiment.
  • Tekton, pipelines CI/CD natifs Kubernetes. Pas de solutions anciennes comme Jenkins par exemple qui sont difficiles à maintenir.
  • ArgoCD, GitOps, déploiement déclaratif, réconciliation continue. Ce qui est dans Git est ce qui tourne en production. Pas d’écart, pas de dérive.
  • Harbor, registry de conteneurs privé, avec scan de vulnérabilités intégré, politique de signature d’images.
  • Helm / Kustomize, templating et gestion des configurations, parce qu’un cluster sans gestion propre des manifests, c’est un cluster qui devient ingérable en six mois.

Ce que nous avons fait : Mise en place d’une plateforme Kubernetes On-Premise pour une structure publique, avec pipeline CI/CD complet depuis le commit jusqu’à la production, GitOps via ArgoCD, et OS Talos sur l’ensemble des nœuds. Zéro accès SSH sur les nœuds de production.

IA et HPC, LLM souverains / RAG / Calcul distribué

L’IA est utile. Ce n’est pas le problème. Le problème, c’est que la manière dont elle est proposée aujourd’hui revient à envoyer vos données confidentielles à un tiers, sous juridiction étrangère, sans que vous sachiez vraiment ce qui en est fait.

On propose autre chose : de l’IA sur votre infrastructure, avec vos données, sous votre contrôle.

Ce que l’on déploie :

  • Ollama , serveur local de LLM, déploiement simple de modèles Open Source (Mistral, Llama, Qwen, Gemma, CodeLlama…) sur vos serveurs. On-Premise ou cloud souverain.
  • Open WebUI, interface utilisateur propre pour interagir avec vos modèles. Les utilisateurs ont une expérience comparable à ChatGPT, mais les données ne sortent pas.
  • RAG (Retrieval Augmented Generation), interrogez votre base documentaire interne avec un LLM : vos wikis, vos notes, vos contrats, votre base de connaissances. Les réponses sont ancrées dans vos documents, les données restent chez vous.
  • Intégration Nextcloud, assistant IA intégré à votre espace collaboratif, résumé de documents, rédaction assistée, sans flux sortant vers OpenAI.
  • Transcription locale, vos réunions et visioconférences transcrites sur vos serveurs avec Whisper. Vos échanges confidentiels restent confidentiels.
  • Slurm, ordonnanceur de ressources pour le calcul distribué et le HPC. Quand vos workloads IA ou scientifiques dépassent le cadre d’un seul serveur GPU, on sait gérer les clusters de calcul.
  • vLLM, inférence haute performance pour les modèles en production à fort trafic.

Ce que nous avons fait : Déploiement d’une plateforme RAG pour un organisme public sur infrastructure souveraine, avec indexation de plusieurs milliers de documents internes, interface utilisateur déployée pour les agents, et zéro donnée sortante. Les agents posent des questions sur leurs procédures internes et obtiennent des réponses sourcées, sans que rien ne quitte leur réseau.

Ce qui ne change pas d’un domaine à l’autre

Quelle que soit la brique W’ise que l’on déploie, quelques constantes :

On contribue aux logiciels qu’on intègre. Sur LemonLDAP::NG , LSC, FusionIAM et d’autres, nous ne sommes pas des intégrateurs qui installent un logiciel qu’ils ont découvert hier. On connaît le code, on le fait évoluer, et quand il y a un bug, il est corrigé à la source.

Vos données, vos formats, vos logiciels. Le jour où vous voulez changer de prestataire, vos systèmes continuent de tourner. Vos données sont dans des formats ouverts. Vos logiciels ne sont pas sous licence donc vous n’êtes dépendants de personne. C’est la définition pratique de la souveraineté.

On dit ce qu’on ne sait pas faire. On ne vend pas tout à tout le monde. Si un de nos partenaires répond mieux à votre besoin, on vous le dit.

La documentation fait partie du livrable. Une infrastructure non documentée est une infrastructure qui appartient à son intégrateur, pas à son exploitant.

Si un ou plusieurs de ces domaines correspondent à un chantier que vous avez devant vous, nous sommes disponibles pour en parler !
Contactez-nous

🔲 ☆

La vie du composant Open Source après son intégration - 2/3

Cet article a pour objectif de lister les différents points à ne pas négliger quand on commence un projet intégrant des composants Open Source.

Toutes les parties de cet article sont accessibles ci-dessous :

Après avoir défini les critères de choix des composants, nous allons étudier les éléments techniques permettant d’effectuer un choix éclairé.

Les versions

Généralement, un composant Open Source est utilisé dans sa dernière version, mais ce n’est pas toujours le cas. Il est parfois nécessaire d’opter pour une version antérieure.

Du fait du nombre limité de contributeurs, il est rare que plusieurs versions d’un composant soient maintenues. Il faut s’en assurer quand on fait son choix et comprendre que l’impact d’une montée de version peut être important.

La plupart des projets utilisent la notation “Semantic Versioning”, avec des versions utilisant la notation X.Y.Z :

  • X représente les versions majeures, qui ne sont pas compatibles entre elles. L’introduction de modifications dans l’API est souvent la raison de ce changement de version.
  • Y représente les versions mineures, qui restent compatibles. L’introduction de nouvelles fonctions ne cause pas de modification de l’API, la nouvelle version reste utilisable sans changement du code qui s’appuie sur le composant.
  • Z représente les correctifs apportés au composant, sans changement de l’API.

Ce type de notation n’est pas universel. Une autre logique relativement récente consiste à livrer de nouvelles versions incrémentales fréquemment. Les utilisateurs doivent alors prendre en charge les ruptures techniques à chaque changement de version. On pourrait par exemple citer les navigateurs Chrome ou Firefox qui ont un cycle de release particulièrement court (environ une par semaine). Dans tous les cas, une veille technologique est indispensable. Des outils de suivi existent, tel Dependabot qui permet de savoir au jour le jour quel composant a changé de version.

Un autre aspect important concerne l’environnement dans lequel s’exécute le projet. Il est parfois nécessaire de maintenir un projet utilisant de vieilles versions d’un langage (par exemple Java 8) ou d’une version d’OS. En pratique, il suffit souvent de vérifier le bon fonctionnement dans les différentes versions d’un environnement. L’impact est clair : cela interdit souvent l’utilisation des dernières fonctionnalités. Néanmoins il faut être conscient que l’abandon d’une version impacte une quantité non négligeable d’utilisateurs.

Le problème est que la fréquence des releases tend à s’accroître, augmentant ainsi la charge de travail. Il n’est pas à exclure que cela devienne une difficulté de plus en plus importante, dans la mesure où un projet s’appuie sur des librairies, utilisées dans un framework logiciel qui s’appuie à son tour sur un container applicatif, lui-même exécuté dans une plateforme logicielle, dans une machine virtuelle ! Par exemple, Log4J utilisé dans une application Spring, tournant sur Tomcat, dans Docker, sur VMWare…

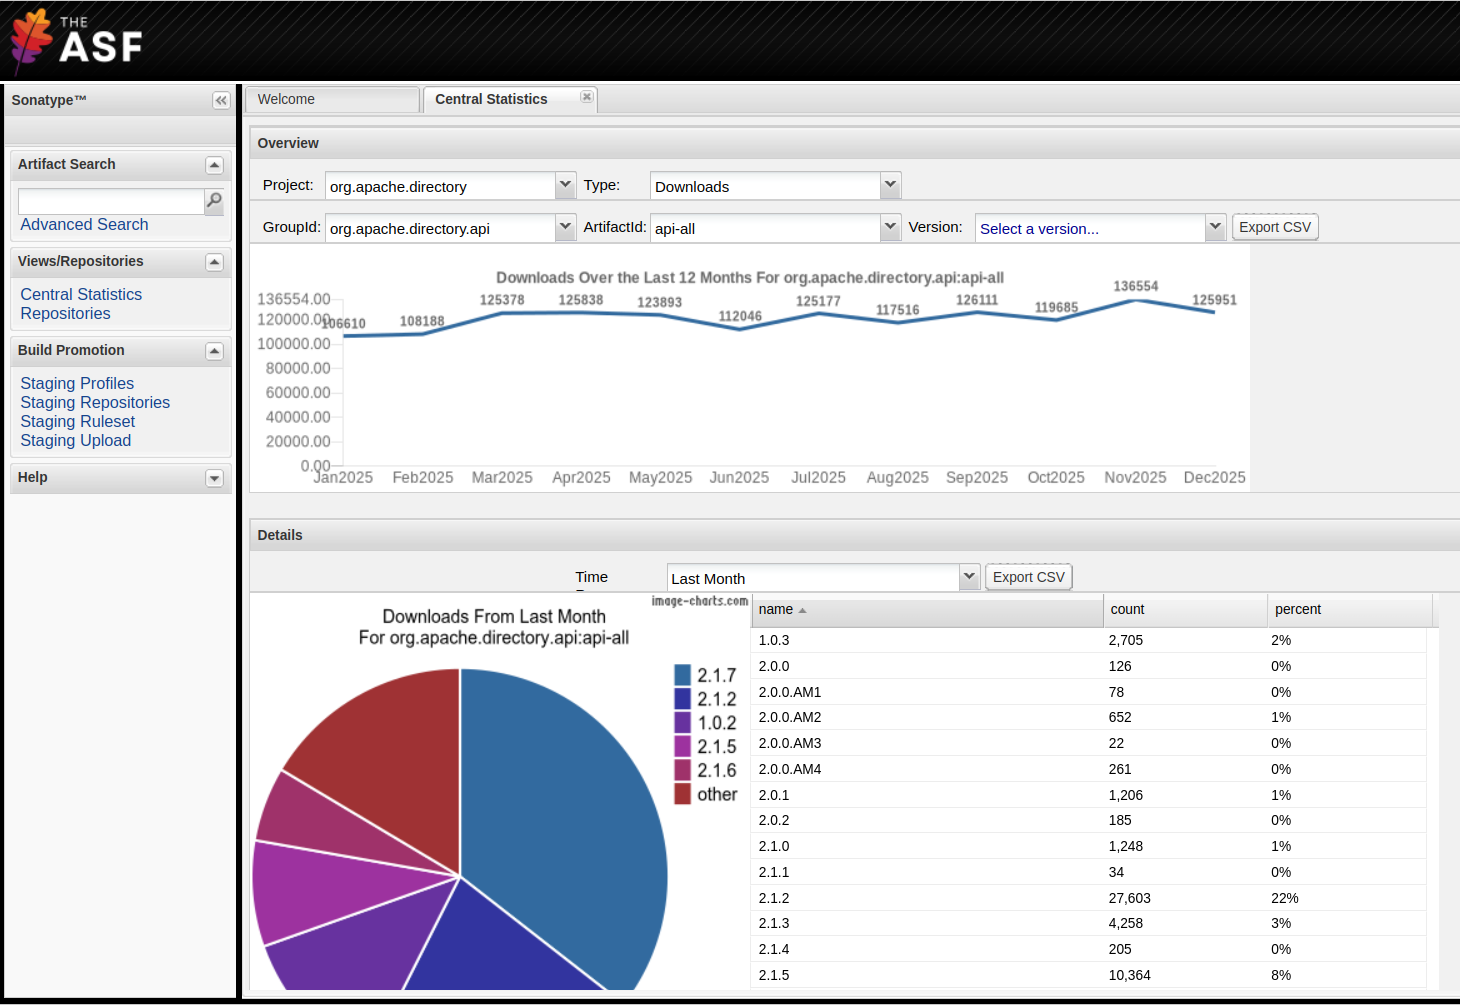
Pour illustrer ce propos, cette image représente les versions de l’API Apache LDAP téléchargées au mois de décembre 2025 : plus de 39 versions différentes, certaines datant de 12 ans (!!!) sont toujours utilisées…

Téléchargements Apache LDAP API

Les évolutions

On devra donc prendre en compte les évolutions de l’environnement d’exécution qui sont liées à plusieurs facteurs :

  • Les versions de l’OS,
  • Les versions de containers,
  • Les évolutions du ou des langages utilisés,
  • Les évolutions des librairies utilisées.

À cela s’ajoute les potentiels conflits de versions : il n’est pas rare que plusieurs composants intègrent eux-mêmes des librairies dont les versions sont incompatibles. C’est ce qu’on appelle classiquement le “dependency hell”.

En Java, cela peut se résoudre par l’utilisation d’une plateforme de service comme OSGi, qui permet d’isoler les composants entre eux. Il existe d’autres solutions, par exemple en JS où un composant va charger tout le code dont il dépend pour former un bloc de code autonome, au prix d’une croissance du code…

Dans tous les cas, il convient d’avoir en tête que cette gestion incombe au projet et que cela peut rapidement devenir complexe.

Les dépendances transitives

Pour aller plus loin, il est important de tenir compte des dépendances transitives, c’est à dire des dépendances utilisées par les composants choisis. C’est évidement récursif et il n’est pas rare d’avoir plusieurs niveaux de profondeur (ici, 9) :

[INFO] org.apache.directory.server:apacheds-installers:pom:2.0.0.AM28-SNAPSHOT
[INFO] +- org.apache.directory.server:apacheds-service:jar:2.0.0.AM28-SNAPSHOT:compile
…
[INFO] |  +- org.apache.directory.server:apacheds-service-builder:jar:2.0.0.AM28-SNAPSHOT:compile
…
[INFO] |  |  +- org.apache.directory.server:apacheds-http-integration:jar:2.0.0.AM28-SNAPSHOT:compile
[INFO] |  |  |  +- org.apache.directory.server:apacheds-http-directory-bridge:jar:2.0.0.AM28-SNAPSHOT:compile
[INFO] |  |  |  \- org.eclipse.jetty:jetty-webapp:jar:9.4.56.v20240826:compile
[INFO] |  |  |     +- org.eclipse.jetty:jetty-xml:jar:9.4.56.v20240826:compile
[INFO] |  |  |     |  \- org.eclipse.jetty:jetty-util:jar:9.4.56.v20240826:compile
[INFO] |  |  |     \- org.eclipse.jetty:jetty-servlet:jar:9.4.56.v20240826:compile
[INFO] |  |  |        +- org.eclipse.jetty:jetty-security:jar:9.4.56.v20240826:compile
[INFO] |  |  |        |  \- org.eclipse.jetty:jetty-server:jar:9.4.56.v20240826:compile
[INFO] |  |  |        |     +- javax.servlet:javax.servlet-api:jar:3.1.0:compile
[INFO] |  |  |        |     +- org.eclipse.jetty:jetty-http:jar:9.4.56.v20240826:compile
[INFO] |  |  |        |     \- org.eclipse.jetty:jetty-io:jar:9.4.56.v20240826:compile
…

Il faudra vérifier toutes les dépendances transitives, leur licence, leur version, leur signature. Ne pas négliger non plus qu’un repository peut également avoir été attaqué ou certaines dépendances avoir été modifiées…[4]

Les SBOMs, une solution ?

Le SBOM (Software Bill Of Material, ou Nomenclature Logicielle) est la liste officielle des dépendances. Il permet de contrôler les licences, de lister les dépendances transitives, de donner la version de chaque composant, de vérifier les signatures et éventuellement d’identifier les CVE associées aux versions utilisées. Il peut (et devrait !) être généré automatiquement. Il existe des outils qui génèrent le SBOM en différents formats, par exemple :

  • Pour CycloneDX[5], qui fonctionne pour C/C++, Node.js, Python, Go, Ruby, Java, .NET, PHP, Javascript.
  • Pour SPDX[6], qui fonctionne pour Java, Python et Go.

Ils génèrent une liste des dépendances, leur version, leur licence…

L’importance de cette nomenclature n’est pas à négliger. Un “Executive order”[7] a stipulé qu’un logiciel ne peut être utilisé par une entité publique aux USA si un SBOM n’est pas fourni. Par ailleurs, en Europe, le Cyber Resilient Act (CRA) en a fait un prérequis et le SBOM doit être livré en même temps que la documentation.

Il s’agit donc d’un élément de confiance à fournir, qui ne règle certainement pas tout, mais permet de s’assurer que l’utilisateur dispose de la liste des composants embarqués, ce qui simplifie le travail des utilisateurs.

Les licences

Dans le cadre du développement d’un produit, il faut définir la licence d’utilisation. Il n’est pas toujours possible de choisir celle que l’on souhaite adopter pour son produit. Dans certains cas, l’utilisation de composants Open Source impose le choix de la licence à utiliser.

Comme indiqué plus haut, la catégorie de licence à laquelle appartiennent les composants utilisés peut imposer le choix. C’est le cas de la licence GPL, qui est dite “contaminante”. Si vous choisissez une licence permissive, vous devrez en faire mention dans votre code et cette mention devra être accessible aux utilisateurs. Prenez votre iPhone, par exemple, allez sur Réglage -> Général -> Mentions légales et certifications -> Mentions légales, vous y trouverez la liste de toutes les licences de chaque composant utilisé. Et il y en a beaucoup ;-)

Quels sont les risques à ne pas respecter les licences, ou à en choisir une qui ne soit pas adaptée ? En réalité, tout dépend de la provenance du composant utilisé. Si celui-ci est maintenu par une société disposant d’un service juridique solide, cela peut s’avérer coûteux. En pratique, les deux risques principaux sont surtout l’obligation de publier l’intégralité de ses sources, si on a choisi un composant GPL par exemple, et l’obligation de basculer sur un autre composant dans un délai assez court. Dans tous les cas, ce n’est ni agréable, ni simple. Autant faire le bon choix dès le départ.

Le support

Partant du principe que le choix du composant a été effectué en tenant compte des différents points exposés précédemment, la suite logique est de se préoccuper de la vie de ce composant. Qui dit logiciel dit bugs, évolutions, améliorations… et l’obligation d’en tenir compte. On cherche ici à comprendre quels sont les besoins en support, qui en est responsable et les modalités de maintenance du composant choisi.

Quoi ?

La première étape est d’identifier les besoins. Cela passe par la qualification du composant sur les points suivants :

  • Sa criticité dans la solution construite.
  • La façon dont on a détourné les anomalies ou les manques fonctionnels lors de l’intégration.
  • Le niveau de performance obtenu et attendu dans un futur proche ou moins proche.
  • La présence ou non de système de supervision, de gestion d’alertes, de logs.

Il faut aussi tenir compte de la façon dont on l’utilise, selon qu’il est intégré au produit, ou hébergé (solution PaaS ou SaaS). Chacun de ses points doit être géré en amont et tout au long de la vie du produit.

Qui ?

Une fois que l’on sait ce qu’on attend d’un composant et ce qu’implique son usage, se pose la question de la responsabilité de son intégration et de sa maintenance en condition opérationnelle.

Il est possible de devenir un membre actif de la communauté, bénéficiant ainsi d’un levier important sur l’évolution du composant. C’est une des raisons pour lesquelles les éditeurs de logiciels recrutent des membres de communautés actives. Le cas de Red Hat est assez significatif, mais ce ne sont pas les seuls. Le bémol étant que la communauté est généralement diverse et que des agendas différents peuvent entrer en conflit.

On peut aussi s’appuyer sur la communauté pour obtenir un support. Rien n’est garanti, mais cela fonctionne étonnamment bien. L’être humain est doué d’empathie et, à condition de demander poliment, on obtient généralement les réponses à ses questions. Reste à voir dans quel délai…

Enfin, on peut aussi avoir recours à des experts externes (consultants, sociétés spécialisées dans le logiciel libre). La principale difficulté est la disponibilité de ces experts, leur coût et leurs compétences réelles. On peut également passer un contrat de service, charge au contractant de faire sienne cette recherche de compétences disponibles.

Comment ?

Une fois identifiée la ou les ressources pouvant répondre au besoin de support à court, moyen ou long terme, reste à définir un cadre de travail.

Dans le cas où le projet internalise ces ressources, il faudra prévoir des formations et/ou des embauches. Et sur une durée longue. L’acquisition de compétences internes est une solution solide.

L’alternative immédiate est le recours à des ressources externes. Il faut s’assurer de la compétence des intervenants, de la surface couverte par le prestataire et du coût induit. Cette solution a l’avantage de ne pas nécessiter une présence permanente : on peut y faire appel ponctuellement en fonction des besoins.

Il est également possible de ne pas internaliser le composant, mais de le ‘louer’, c’est la solution PaaS. L’avantage c’est qu’on s’adresse à une entité dont c’est le cœur d’activité, elle a donc un bon niveau de connaissance et de maîtrise du composant. C’est une solution absolument classique dès qu’on parle d’hébergement de sites web ou de bases de données. L’inconvénient est son coût, à quoi s’ajoute le risque de Vendor Lock-in : changer d’hébergeur n’est jamais simple. On l’a constaté lors du récent changement tarifaire chez VMware, la migration vers des solutions moins coûteuses (Proxmox par exemple) ne s’est pas faite sans peine…

Enfin la dernière possibilité est d’estimer que le composant est fiable, qu’une fois qu’il est intégré il n’y a pas lieu de s’en préoccuper et que, dans le pire des cas, on trouvera toujours une solution. Cela peut sembler inconséquent, mais c’est une pratique assez courante quand il s’agit de composants non critiques ou relativement simples. Les outils de test (Junit ou autre), de log (Log4J), les petites briques simples (il y en a des milliers dans le monde JS) sont fréquemment gérés de cette façon. Les risques sont de deux ordres :

  • L’abandon du composant, qui n’évolue plus, faute de développeur,
  • La faille de sécurité (CVE) qu’il faut corriger en urgence.

Sur ce second point, on a tous en mémoire les mésaventures de Log4J. Vous pouvez regarder la présentation qui a été faite en 2022 à ce sujet[8] et l’histoire de la correction du bug par celui qui était en charge du projet Log4j2[9].

Forker ou pas ?

Il y a de multiples raisons pour vouloir forker un composant. Il y a également de multiples raisons de ne pas le faire ;-)

Quand est-il intelligent de forker un composant ? Voici quelques raisons pertinentes :

  • Quand la gouvernance du projet est inadaptée : exemple avec BDFL qui devient un Dictateur tout court, communauté fermée, projet focalisé sur un agenda commercial, projet en état de mort cérébrale, etc.
  • Quand le projet change de “propriétaire” et que le nouveau ne respecte plus l’esprit initial du projet, ou risque de ne plus le respecter. Ça a été le cas de Hudson (remplacé par Jenkins après son rachat par Oracle), MySQL (remplacé par MariaDB après son rachat par SUN), OpenOffice (devenu Libre Office après son abandon par Oracle). Les exemples sont nombreux.
  • Quand le projet n’est simplement plus maintenu. L’exemple le plus notable est le serveur Web NCSA qui a donné naissance à Apache httpd.

Mais il y a également autant de cas où forker est simplement une perte de temps ou une dilution de l’effort commun.

L’exemple de OpenSSL

L’histoire de OpenSSL est intéressante. Le projet a commencé comme un fork d’un autre projet (SSLEay, projet démarré en 1995, mais pour lequel les efforts de développement avaient cessés en 1998).

Jusqu’en 2014, OpenSSL a suivi une vie assez paisible, jusqu’à la survenue de la faille de sécurité HeartBleed, qui a été une des plus importantes de par son ubiquité. Cela a donné lieu à la création de forks pour diverses mauvaises raisons :

  • Fork LibreSSL par des équipes de OpenBDS, suite à un audit du code. Plutôt que de décider de contribuer, ils ont préféré forker. En une semaine, 90 000 lignes de code ont été supprimées du projet initial… Le succès de ce fork reste à démontrer.
  • Fork BoringSSL par Google. Pas de release, pas de communauté. Mais au moins Google a la main dessus pour son propre usage.
  • Fork AWS-LC par Amazon. Au moins, il y a des releases…
  • Fork QuicTLS, par Akaimai et Microsoft : l’objectif est d’intégrer la couche transport QUIC au dessus de OpenSSL 3.3. Une volonté d’intégrer la fondation Apache a été exprimée.

Au final, l’épisode malheureux a permis la création d’une fondation dédiée (OpenSSL Foundation), l’embauche de 14 salariés et la mise en place d’un budget de développement significatif.

LTS ou pas ?

Autre problème : la maintenance des composants à longue durée de vie ? Le serveur Apache httpd n’existe que dans 2 versions majeures, la 1.X et la 2.X. Aujourd’hui, seule la version 2.4 est supportée. D’autres projets proposent des versions appelées LTS (Long Time Support) avec un engagement de maintenance sur une durée garantie. Cela signifie que les bugs découverts sur les dernières versions seront éventuellement back-portés vers les anciennes versions si nécessaire et qu’une correction des anomalies est assurée.

On doit se poser la question d’opter pour de telles versions LTS, plutôt que pour des versions intermédiaires à rotation rapide. Le cas de Java est assez typique :

  • des LTS toutes les 4 versions,
  • un support (gratuit) de la version sur 5 ans,
  • des versions intermédiaires qui ne sont supportées que jusqu’à la sortie de la nouvelle version.

En ce sens, opter pour une LTS semble raisonnable, on utilisera les versions intermédiaires comme un moyen d’anticiper les migrations ultérieures à moindre coût.

C’est également le cas d’Ubuntu qui a une politique de release de LTS et de versions intermédiaires.

Retrouver de l’information

Il faut aussi mentionner qu’il ne suffit pas d’utiliser un composant Open Source, il faut également disposer de sources d’informations fiables. Et ce n’est pas simple.

  • Les versions évoluent vite et il faut constamment se tenir au courant des modifications apportées. En espérant que les projets fournissent un Change Log adapté et des outils de migration, ce qui n’est pas toujours le cas…
  • Les sociétés qui supportent des projets Open Source se font racheter et il devient difficile de trouver les informations originelles.
  • Internet est vivant et il arrive que les liens sur les documentations ou sources que l’on conservait précieusement soient cassés (parfois parce que le nom de domaine n’est plus renouvelé). Il n’y a plus qu’à espérer qu’InternetArchives a conservé une copie (généralement partielle) des pages.
  • Le contenu peut également disparaître. Toutes les entités gérant des projets Open Source ne proposent pas de récupérer les versions historiques.

Tout cela sans compter les IA qui aujourd’hui rendent difficilement accessibles la documentation ou les échanges sur les anciennes versions, puisque entraînées sur les dernières versions, couplé au fait que les moteurs de recherche ont aujourd’hui tendance à pousser en avant la production de ces IA.

Open Source is One Person

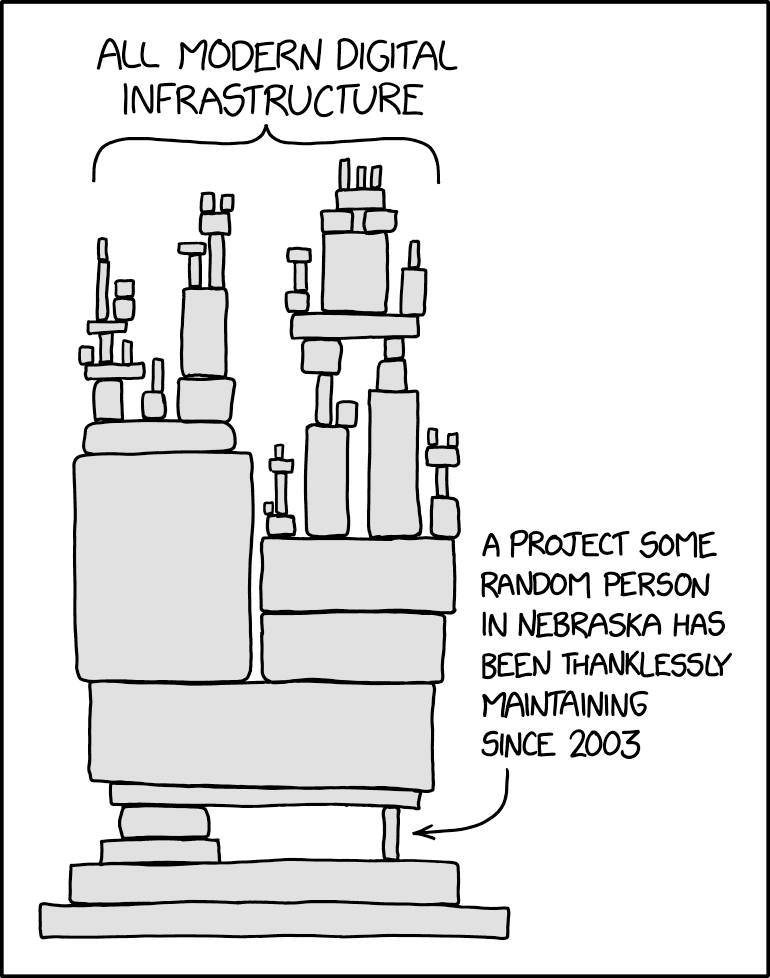
Pour finir, il faut quand même pointer le fait qu’un composant Open Source n’est généralement pas développé ni maintenu par une structure pléthorique. Ceci est parfaitement résumé par le dessin suivant :

https://xkcd.com/2347/

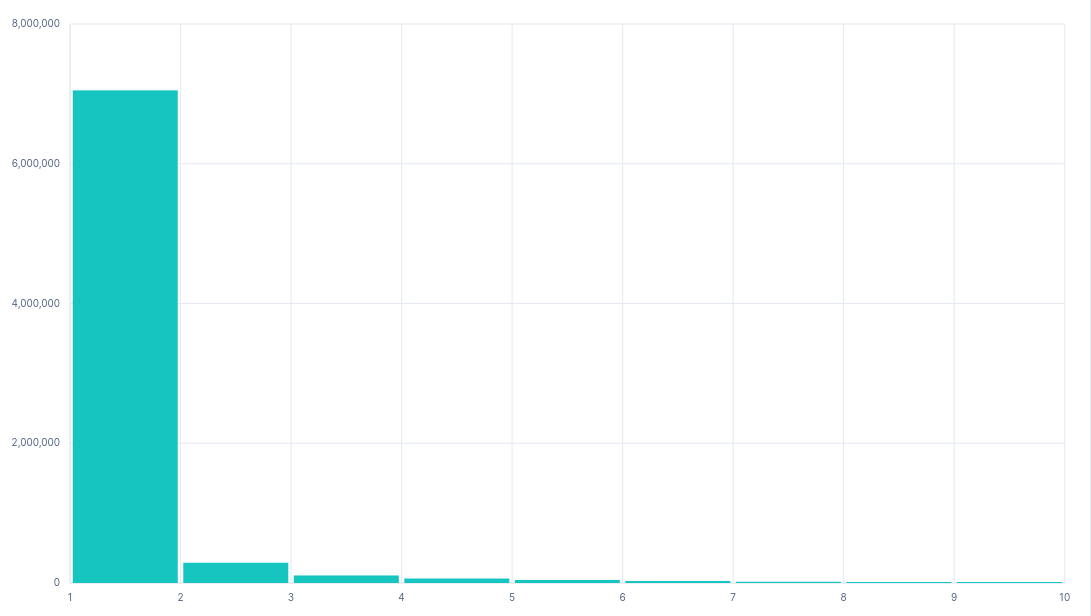
Le projet ecosyste.ms[10] recense un grand nombre de projets Open Source et ses conclusions sont sans appel : sur 11,6 millions de projets analysés, 7 millions sont gérés par une seule personne :

Nombre de mainteneurs par projet

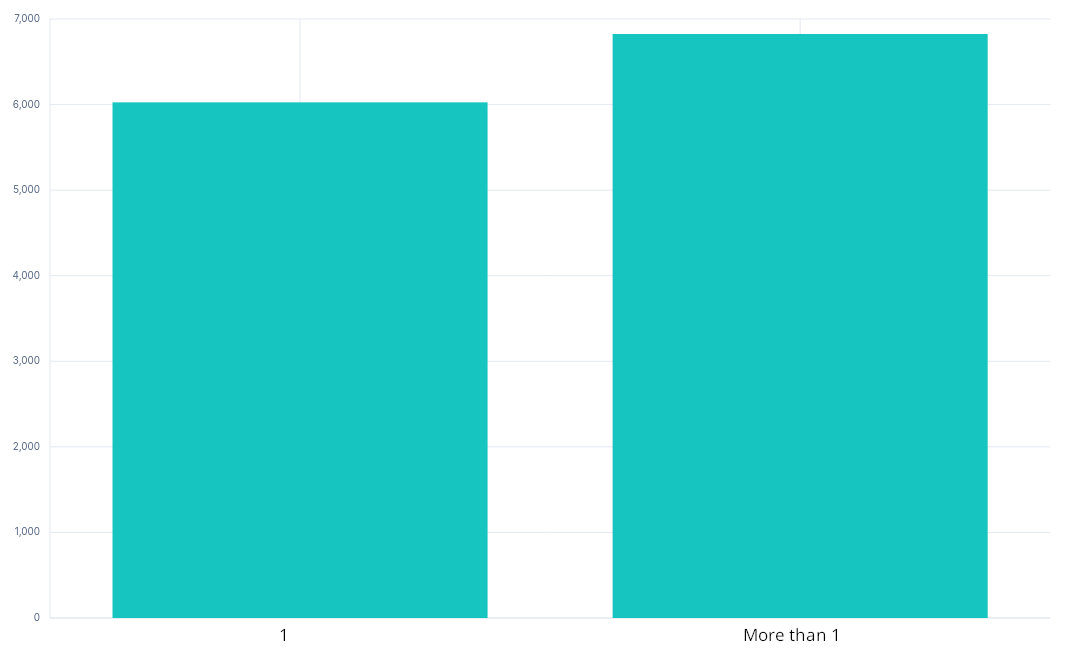
Et si on analyse les projets avec plus de 1 million de téléchargements par mois, près de la moitié n’ont qu’un seul mainteneur :

Nombre de mainteneurs par projet téléchargés plus de 1M de fois par mois

Le résumé est donné sur la page “Open Source is one person”[11].

Exemple : Apache Log4j2

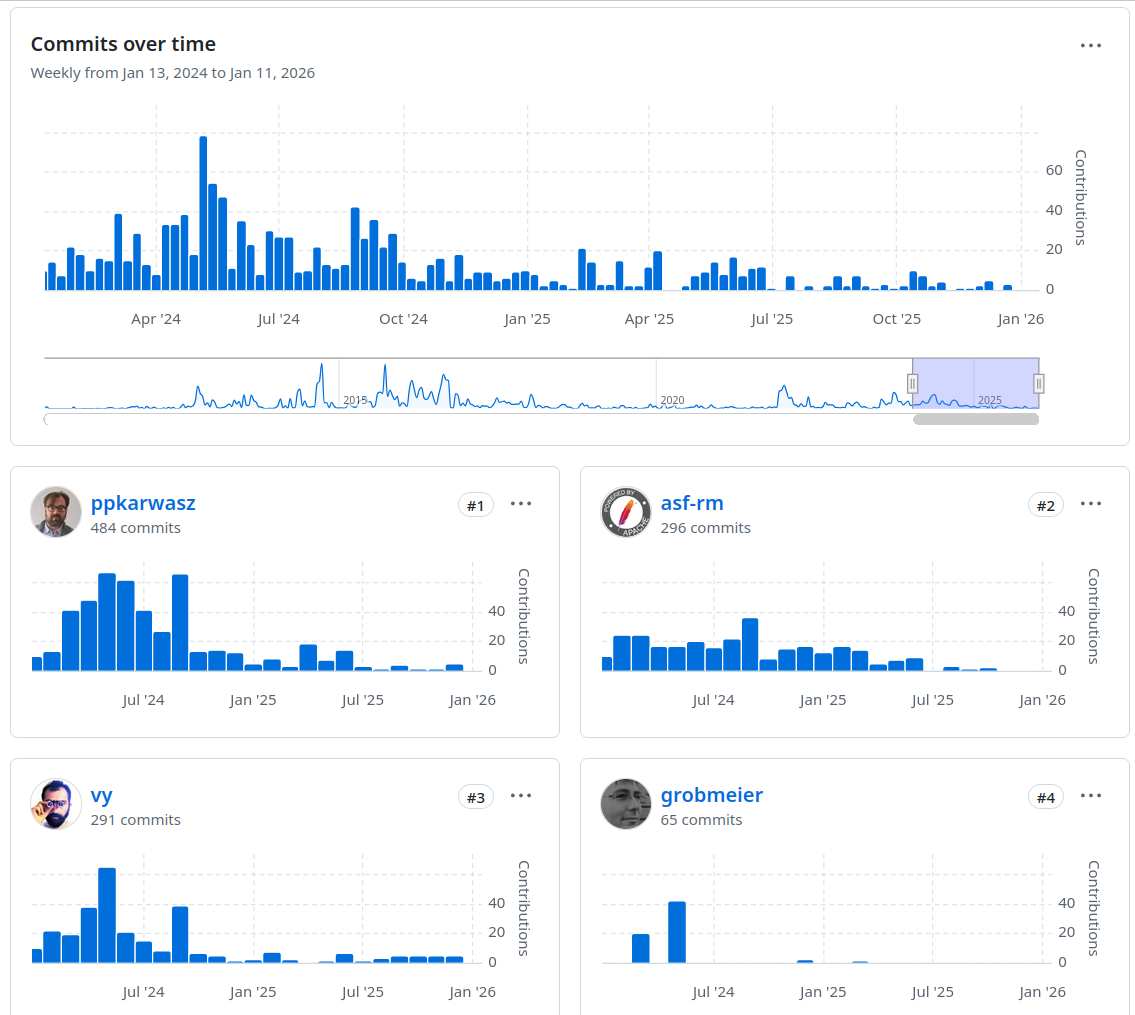
Prenons un premier exemple, le projet Apache Log4j2. Sur les deux dernières années :

  • Il y a eu 1 313 commits,
  • Dont 354 par des outils (Dependabot, ASF CI release Manager), soit 27% des commits,
  • Le développeur le plus actif a effectué 484 modifications, soit 50% du total
  • Le second développeur a effectué 291 modifications, soit 30% du total
  • Le troisième développeur a effectué 65 modifications, soit 7% du total.
  • Les trois premiers développeurs sont donc responsables de près de 88% des modifications
  • Les 34 développeurs ayant participés au projet ont collectivement produit 119 modifications, 3,5 chacun en moyenne…

Apache Log4j2

Exemple : Apache Tomcat

Apache Tomcat est certainement un des composants Open Source de la fondation Apache le plus utilisé. On pourrait se dire qu’il est maintenu par une grosse équipe :

  • Il y a environ 100 contributeurs sur les 20 dernières années,
  • Cela représente environ 25 000 commits,
  • Le premier développeur, Mark Thomas, représente plus de 75% de ces modifications,
  • Le second développeur, Rémy Maucherat, a contribué à hauteur de 10% des modifications,
  • Le troisième développeur, Filip Hanik, a contribué à 4% des modifications,
  • Ces trois développeurs sont donc responsables de 91% des contributions de ces 20 dernières années !

Exemple : LibXML2

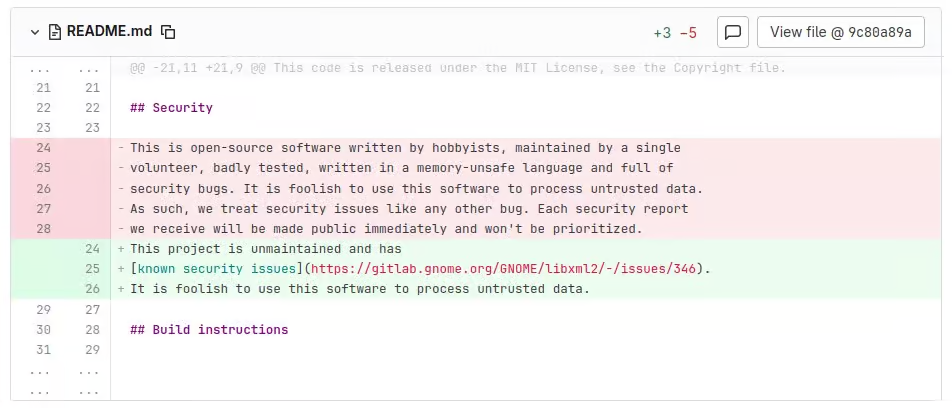
LibXML2 est une (petite) librairie en C utilisée pour parser des documents XML. Elle est largement utilisée par des milliers de packages sous Linux. À la fin de l’année 2025, son unique mainteneur, Nick Wellnhofer, a décidé de se retirer du projet. Son dernier commit est le suivant :

Dernier commit de LibXML2

On peut légitimement s’inquiéter de cette situation[12].

Open Source et développement - Partie 3 : Questions ouvertes : bugs, IA, souveraineté et autres

Bibliographie

[4] Hundred of NPM packages compromised
[5] CycloneDX
[6] SPDX
[7] Executive Order 14028
[8] Log4shell, c’est la faute à la fondation Apache ?
[9] L’histoire inédite de Log4j et Log4Shell
[10] Open source intelligence for your project
[11] Open Source is one person
[12] Libxml2 Becomes Officially Unmaintained After Maintainer Steps Down

🔲 ☆

Questions ouvertes : bugs, IA, souveraineté et autres - 3/3

Cet article a pour objectif de lister les différents points à ne pas négliger quand on commence un projet intégrant des composants Open Source.

Toutes les parties de cet article sont accessibles ci-dessous :

Une fois ce panorama (partiel) présenté, certaines questions restent en suspens. Ce dernier chapitre va essayer de les lister, sans prétendre à l’exhaustivité.

Quid de la longévité ?

Ayant recherché un composant récemment pour un besoin client, voici le dernier message posté sur la page du projet[13] :

“This repository is now archived. Thank you all for your excellent contributions. May it continue to live in all your wonderful forks.” OPENLDAP Exporter

C’est juste un exemple, et fort heureusement il a été forké 65 fois, mais cela ouvre d’autres questions :

  • Quel fork utiliser ?
  • Quelle garanties a-t-on que le fork que l’on choisira survivra ?
  • Le problème ne va-t-il pas se reproduire ?

Encore une fois, dans le monde Open Source, l’utilisateur est le responsable de ses choix. Ceux-ci doivent être pesés.

La gestion des CVEs

Les CVE sont des failles de sécurité identifiées. Elles couvrent l’ensemble des logiciels depuis 1999. Ce système d’alerte est géré par The MITRE Corporation. Aujourd’hui, il s’agit de la référence conservant toutes les failles connues et elle est alimentée en continue. Le 15 avril 2025, le contrat qui liait cette organisation et le gouvernement américain a été rompu par ce dernier à la veille de la date d’expiration contractuelle[14]. Vu l’urgence, une extension de 11 mois a été mise en place, mais rien n’est prévu sur ce qui se passera en avril 2026… On peut légitimement se poser la question de savoir pourquoi l’industrie ne finance pas ce service essentiel.

En Europe, un service équivalent (EUVD, European Union Vulnerability Database[15]) a été mis en place et délégué à l’ENISA[16].

Que faire en cas de bug ?

Donc vous avez trouvé un bug dans un des composants que vous utilisez. Quelle est la démarche à suivre ? Il n’y a pas de procédure toute faite.

La première démarche est de vérifier que ce bug n’a pas été corrigé dans une version plus récente. Si ce n’est pas le cas, peut-être qu’un ticket d’anomalie a déjà été rempli ? Sinon, le plus simple est de créer un nouveau ticket. Mais encore faut-il que le projet propose un mécanisme qui le permette. Si le projet est sous GitHub, par exemple, vous pouvez certainement remplir un rapport d’anomalie (mais attention, tous les projets sous GitHub ne le permettent pas). Si le projet dispose d’un système de gestion des anomalies (JIRA, Redmine, Mantis, Bugzilla, etc), c’est sans doute votre point d’entrée. Une autre solution pourrait être de poster un message sur la liste de diffusion du projet, à condition qu’il y en ait une… Comme on le voit, il n’y a pas de mécanisme standardisé pour signaler une anomalie, chaque projet les gère à son gré et il faut en tenir compte.

En espérant qu’une correction sera proposée ! Et si ce n’est pas le cas, mais qu’on est à même d’apporter cette correction, la question suivante est de savoir comment la gérer : faut-il forker le projet en attendant une éventuelle release ?

Dans tous les cas, les utilisateurs sont fortement encouragés à remonter les anomalies et idéalement à proposer des patchs sous toutes formes possibles.

Et l’IA ?

Un nouveau venu est en train de bouleverser la façon dont on développait : l’IA. Depuis un ou deux ans, les progrès des solutions basées sur des LLM permettent de générer du code qui n’est pas totalement inutilisable. On prétend même que ces IA vont remplacer les développeurs, qui ne seront plus que des prompteurs avec une productivité 10 fois supérieure…

On peut rêver. En attendant, cela pose quand même un certain nombre de questions :

  • Quel est la qualité du code proposé par ces IAs ?
  • Quid de la licence ?
  • Qu’en est-il des tests associés ?
  • Les rapports d’anomalies générés par des IAs sont-ils pertinent ?
  • Quel sera le coût de ces solutions à long terme ?

Aujourd’hui, de nombreux mainteneurs de projets Open Source se plaignent d’être inondés de propositions de correction de piètre qualité générées par des IA. Le temps passé à relire les propositions, à les tester et à les corriger n’est pas forcément en rapport avec le gain obtenu. Sans compter les faux positifs à éliminer.

De plus, on peut se poser la question du coût d’usage de ces outils. S’ils sont aujourd’hui quasi gratuits, ils risquent de devenir payants quand les sociétés qui ont investit des dizaines de milliards de dollars dans ces solutions demanderont un retour sur investissement.

Certains sites se protègent (difficilement) contre ces robots en tentant de leur interdire l’accès aux sources. En effet, ces requêtes incessantes consomment de la bande passante et du temps CPU, ce qui se traduit en frais d’hébergement en forte augmentation. Le second problème est qu’on risque d’aboutir à une “moyennisation” des solutions proposées, puisque l’alimentation de ces outils se fait par la récupération des sources sur internet. A partir du moment où les IA se mettent à produire du code qui sera intégré dans les bases, elles vont se nourrir de ce qu’elles ont elles-même produit. Il ne faut pas oublier qu’il s’agit d’outil de génération probabilistique.

Sans vouloir dépeindre un tableau apocalyptique, il est important de questionner la portée de ces outils et d’en faire un usage raisonné.

Qui finance ?

La grande question… Puisqu’il s’agit d’Open Source, le modèle économique est compliqué à identifier. Aujourd’hui on peut considérer que les contributions sont financées de différentes façons :

  • Par de grosses sociétés comme Google, IBM, Microsoft, qui ont une politique Open Source assez poussée.
  • Par des fondations qui assurent non pas le financement des développements, mais au moins l’infrastructure nécessaire à sa mise à disposition. C’est le cas des fondations Apache ou Eclipse, etc.
  • Par des organisations gouvernementales qui couvrent tout ou partie des développements (NGI, NLNET…).
  • De nombreuses PMI/PME qui soit utilisent des composants et les maintiennent, soit développent ces composants en les mettant à disposition, soit ont une politique de contribution.
  • Par des initiatives publiques ou privées (Bug Bounties, GitHub sponsoring…).
  • Mais également par beaucoup de personnes travaillant sur leur temps personnel.

Parlons de souveraineté

L’Open Source n’a pas de frontière mais… savez-vous que les USA peuvent interdire l’accès à GitHub à certains pays, comme l’Iran ? Cela a été le cas jusqu’en 2021.

Il peut être utile de se poser la question de la disponibilité de certains composants en terme de souveraineté. Pendant de nombreuses années, toute partie de code qui relevait de la cryptographie relevait de mesures d’autorisation d’exportation de la part du gouvernement américain. Rien n’interdit de penser que des règles plus strictes pourraient être imposées.

L’Open Source offre plus de souplesse que le code privatif, mais il convient de rester prudent. Les demandes récurrentes de la mise en place de backdoors par les administrations sont autant d’éléments inquiétants, par exemple.

Sans aller jusqu’à la paranoïa, il semblerait utile que les administrations s’approprient l’Open Source, non seulement en tant qu’utilisatrices, mais également en tant qu’actrices au sein de projets d’importance vitale. Voilà un autre débat, qui ne sera pas ouvert ici et ce long post de blog se clôturera sur ce point en suspens !

Bibliographie

[13] OpenLDAP exporter
[14] CVE program averts swift end after CISA executes 11-month contract extension
[15] European Union Vulnerability Database
[16] ENISA

🔲 ☆

Comment choisir votre composant Open Source - 1/3

Cet article a pour objectif de lister les différents points à ne pas négliger quand on commence un projet intégrant des composants Open Source.

On va tout d’abord présenter l’impact économique de l’Open Source et de son emploi. On s’attachera ensuite à définir les critères de choix des composants, puis les contraintes associées. On terminera par quelques exemples du monde réel pour mettre en exergue les points d’achoppement et la difficulté de s’appuyer sur ces composants.

Toutes les parties de cet article sont accessibles ci-dessous :

Commençons par définir les besoins et les contraintes au niveau technique et économique, mais aussi juridique et organisationnel.

Rapide balayage historique

Le mouvement Open Source n’est pas récent. Il fut un temps où la notion de “propriété intellectuelle” n’existait tout simplement pas. Il faut attendre le 18ème siècle pour que soit instauré le droit d’auteur. Le partage était néanmoins limité par la difficulté de se procurer des supports à moindre coût. Les copistes du Moyen-Age étaient un parfait exemple de système de partage de connaissances, certes limité à un domaine assez restreint…

Dans le domaine de l’informatique, le partage de code et de spécifications se pratique très vite. Les RFC (“Request for Comments”) sont publiées à partir de 1969. Toutefois, le partage de code a existé depuis au moins1955, quand les membres du groupe SHARE mettaient à disposition de tous les modifications logicielles du code tournant sur des serveurs IBM.

Le mouvement “Open Source” se développe fortement dans les années 1980 et 1990. On parlait alors de “free software”. Mais pour supprimer l’ambiguïté du mot “free”, le terme Open Source a été validé qu’en 1998.

À cette même période, voient le jour des projets comme GNU et Linux et des fondations comme The ASF, qui deviennent rapidement des acteurs incontournables de l’Open Source. Considérés comme un “cancer” par certains gros éditeurs, ils vont effectivement métastaser l’écosystème, au point qu’il est difficile aujourd’hui d’imaginer un développement informatique ne comportant pas de composants Open Source. Et cela sans tuer les sociétés qui les utilisent ;-)

L’OSS en 2026

On peut donc considérer qu’en 2026, l’Open Source (OSS) est partout. Dans l’étude “The Value of Open Source Software”[1], on peut lire :

…recent studies have come to similar conclusions showing that open source software (OSS) – software whose source code is publicly available for inspection, use, and modification and is often created in a decentralized manner and distributed for free – appears in 96% of codebases (Synopsys 2023), and that some commercial software consists of up to 99.9% freely available OSS (Musseau et al., 2022)

La quasi totalité du logiciel produit s’appuie donc sur des composants Open Source. Il est illusoire d’imaginer un retour en arrière.

Quelle est la valeur de l’OSS et comment la mesurer ?

Se pose la question de la valorisation de l’Open Source et de son coût. Tout d’abord, on peut évaluer son coût de “remplacement”, à savoir combien coûterait le développement des composants Open Source si chaque acteur économique les utilisant devait les réécrire, ou les acheter. Sur quelle base cette valorisation est-elle effectuée ? Un produit commercial a une valeur théorique qui correspond à un prix de vente multiplié par une quantité vendue. Dans le cas de l’Open Source, le prix de vente peut être considéré comme nul (même s’il est toujours possible de vendre un logiciel Open Source, si on trouve un acheteur…). On calcule alors la valeur de remplacement à partir :

  • du coût du logiciel s’il devait être réécrit,
  • du nombre d’entreprises l’utilisant,
  • Ou de l’achat d’un logiciel propriétaire équivalent, avec le coût du support récurant.

L’étude “The Value of Open Source Software” citée plus haut donne cette évaluation :

  • Le coût de remplacement s’élèverait à 8,8T$, soit environ le PIB du Japon et de l’Inde combinés.
  • Le coût d’écriture unitaire représenterait 4,15G$.
  • Les acteurs économiques dépenseraient 3,5 fois plus en logiciels si l’Open Source n’existait pas.

Un petit exemple

Apache Directory Studio est un logiciel assez largement utilisé dans le monde LDAP.

Il comporte environ 260 000 lignes de code (sans compter les sauts de ligne ou les commentaires, ce qui en double le nombre), soit 10 millions de dollars (selon le modèle COCOMO - Constructive Cost Model -). Le remplacement de ce logiciel Open Source représenterait un effort total de 2,7 ans pour une équipe de 26 développeurs.

En réalité, Apache Directory Studio a été développé à 98% par 3 personnes. Le projet a démarré il y a 20 ans même si l’essentiel du travail s’est concentré sur 7 années.

Il est donc clair que les contraintes du monde professionnel ne s’appliquent pas à l’Open Source, en général. Néanmoins cela donne une idée de ce que peut représenter le coût du développement d’un logiciel Open Source.

Les choix techniques

Bien choisir un composant est essentiel, puisqu’on ne va pas le réécrire. Il est primordial de déterminer les critères de sélection. Ils se répartissent en deux catégories :

  • Les critères mesurables
    • L’adéquation au besoin
    • La compétence interne sur le composant choisi
    • Les performances attendues du composant
    • L’intégration avec les autres composants
    • Les limitations du composant
    • La facilité à administrer et à monitorer le composant
  • Les critères non mesurables
    • La maintenance du projet d’où est issu le composant
    • La possibilité d’y apporter des corrections
    • La qualité de la documentation
    • Le support des failles de sécurité

Cette liste n’est pas exhaustive, mais représente tout de même un ensemble de points pertinents permettant de comparer les composants disponibles et de faire un choix.

Les critères mesurables

De toute évidence, le composant doit répondre à votre besoin technique et fonctionnel. C’est la première étape. Pour valider cette adéquation, il convient de conduire des tests et de réaliser des études de cas ainsi qu’une évaluation fonctionnelle.

Cela suppose que les personnes en charge de cette étude aient la compétence requise pour la mener à bien ou aient recours à des compétences extérieures, ce qui engendre un coût supplémentaire.

La notion de performance est importante, elle sera un des facteurs de dimensionnement de la plateforme sur laquelle tournera le logiciel. Il faut tenir compte des effets de saturation, où les performances peuvent diminuer de façon non linéaire.

L’intégration est à mettre en regard des technologies déjà utilisées et maîtrisées (langage, OS, etc). De même les APIs doivent être étudiées avec soin pour s’assurer qu’elles sont adaptées au besoin.

Un composant Open Source a des limitations, de même qu’un composant privatif. S’il est possible de demander des corrections et des évolutions à une société commerciale, c’est beaucoup plus compliqué pour un projet Open Source, dont le développement est généralement assuré par des volontaires.

Enfin une fois le composant intégré, il faudra le maintenir : montées de versions, analyse des problèmes, corrections des anomalies, sans compter la formation des utilisateurs.

Tout ces critères mesurables vont représenter un coût à internaliser, qu’il ne faut pas négliger lors du choix.

Les critères non mesurables

Ils regroupent les facteurs qu’il n’est pas possible d’évaluer techniquement.

Quand on choisit un composant Open Source, on choisit une communauté : celle qui développe et maintient le produit. Cette communauté n’a aucune obligation autre que celles qu’elle s’impose. Il faut en être conscient, accepter ce risque et l’intégrer dans son plan produit. Un composant Open Source développé au sein d’une fondation comme The ASF ou Eclipse Foundation offre tout de même une garantie plus poussée de pérennité et de qualité sur le long terme, du fait des contraintes imposées aux projets. Par exemple, en ce qui concerne The ASF, on peut citer ces règles :

  • Un projet ne peut rejoindre la fondation que s’il a atteint un niveau de maturité suffisant.
  • Il doit passer par une phase d’incubation sous la supervision d’au moins trois membres de la fondation.
  • Il ne peut sortir de l’incubation tant qu’une release n’a été fournie.
  • Un projet doit disposer d’au moins trois participants actifs de trois sociétés différentes, ce qui interdit la main-mise d’une seule entreprise sur ce projet.
  • Des revues trimestrielles sont à fournir au Board par le responsable de chaque projet.
  • Enfin un projet inactif sera reversé dans l’Attic.

Il est également possible de corriger par soi-même une anomalie critique ou bloquante, ou de développer une fonctionnalité manquante, puisqu’il s’agit d’Open Source. Reste à savoir dans quelle mesure ces corrections ou ajouts vont être intégrés dans les futures versions. Le risque étant d’avoir à maintenir un “fork”.

Un autre aspect qui est souvent reproché aux composants Open Source est la qualité de la documentation. Les projets Open Source n’ont pas nécessairement les moyens de disposer de rédacteurs techniques en charge de la documentation, et c’est généralement du “best effort”. Il n’est pas rare d’avoir des composants dont la seule documentation est le code source, et l’API exposée. Internet reste souvent un moyen d’obtenir l’information manquante, en s’appuyant sur la communauté des utilisateurs.

Enfin il faut tenir compte de la capacité d’une communauté Open Source à prendre en compte les failles de sécurité critiques. L’information est généralement fournie trop tard, lorsqu’elle est déjà publique. En effet, il y a rarement une politique d’alerte privée permettant d’informer les utilisateurs principaux avant la divulgation de la faille corrigée, ce qui est plutôt logique étant donné qu’un projet Open Source ne connaît pas ses utilisateurs (sauf cas d’espèce). Si un processus documenté de gestion des CVE (Common Vulnerabilities and Exposures) existe déjà, c’est un plus. The ASF dispose d’un tel processus[2], par exemple.

Au final, il est compliqué d’associer un coût à ces critères, mais il est nécessaire à tout le moins de les intégrer en terme de gestion du risque.

Les choix organisationnels

Les éléments qui doivent être pris en compte lors du choix d’un composant Open Source sont également directement liés à des choix organisationnels :

  • Disponibilité des ressources internes,
  • Disponibilité de support,
  • Vitalité du projet,
  • État de la communauté,
  • Type de communauté.

Le composant sélectionné doit être pris en main par les équipes internes. Il leur faut l’intégrer, en comprendre le fonctionnement, le tester, valider les performances par rapport aux besoins, gérer les alarmes, le monitorer… En un mot, se l’approprier.

Il est possible d’employer des consultants externes connaissant le composant, encore faut-il les trouver ! Plus le composant est connu, plus il est facile de trouver une ressource externe.

On peut également se poser la question du support : les composants les plus connus sont généralement supportés par de nombreuses entreprises. Reste à qualifier leur niveau de compétence…

Un aspect à ne pas négliger est l’état de la communauté autour du projet. Y-a-t-il une liste de diffusion sur laquelle envoyer les questions que l’on se pose ? Est-elle active ? Les releases sont-elles fréquentes ? Les anomalies remontées sont-elles prises en charge rapidement et efficacement ? Plus généralement, combien y-a-t-il de participants actifs ? Github permet par exemple de vérifier l’activité sur une période de temps afin de se rendre compte si le projet est toujours activement maintenu et développé, pour autant qu’il soit hébergé sur cette plateforme.

Quand aux contributeurs, il faut également se poser la question de leur implication et du cadre de leurs contributions. S’ils sont salariés par des entreprises qui financent leurs travaux, la question de savoir s’ils continueront en cas de changement de cadre professionnel se pose. L’âge des contributeurs est également un facteur à prendre en considération : personne n’est éternel (et chacun va prendre sa retraite à un moment donné…) !

Enfin le type de communauté donne une idée de la direction que peut prendre un projet. Il existe plusieurs modes de fonctionnement, du ‘‘one man show’’ en passant par le BDFL (Benevolent Dictator For Life) jusqu’à un système totalement décentralisé sans direction formelle, où les décisions se prennent collégialement. En pratique, on se trouve souvent confronté à de très petites communautés, ou bien à des communautés adossées à des entreprises commerciales.

Les choix économiques

À ne pas négliger ! Sauf à disposer d’une équipe “couteau suisse” capable de prendre en charge la totalité des composants choisis, il sera sans doute nécessaire d’avoir recours à des experts sur quelques composants essentiels. Et ce n’est pas gratuit !

L’alternative est de souscrire à un contrat de support, ce qui se pratique fréquemment. On entre alors dans un modèle proche de celui d’un éditeur logiciel dont on a acheté un produit, le prix du produit en moins. En réalité, c’est ainsi que se financent de nombreux éditeurs Open Source.

Si votre composant est amené à être exécuté dans le cloud, ou si vous recourez à un service PaaS, il y aura des coûts induits, qui peuvent être conséquents. De nombreux éditeurs logiciels Open Source ont modifié leur modèle de licence pour interdire l’utilisation de leurs produits par des fournisseurs PaaS pour des raisons évidentes. L’impact est alors majeur pour les utilisateurs. Par exemple, une base de données comme MongoDB ne peut pas être utilisée dans sa version Open Source en mode “as a service”. Les coûts peuvent vite se monter à plusieurs dizaines de milliers d’euros par mois pour des volumétries importantes, si on a recours à des solutions basées sur ce produit.

Globalement, les services de type PaaS ne sont pas gratuits et nécessitent une évaluation de l’impact financier lié à ce choix.

Les choix juridiques

Un dernier aspect à prendre en compte, qui n’est pas le moins important, est le type de licence du composant. Toutes les licences Open Source ne se valent pas, certaines sont permissives, d’autres non. Il est primordial d’en comprendre les tenants et aboutissants avant d’opter pour une solution. Il y a trois grandes catégories de licences :

  • “copyleft”, ou “contaminantes” : GPL et dérivées. Ce type de licence impose que les versions dérivées sont soumises aux règles de la licence d’origine.
  • “Permissives” : AL, MIT, BSD… Ce type de licence autorise l’utilisation des composants sans imposer de règles autre que celle de tracer la paternité du code (en l’occurrence, rendre accessible le texte de la licence dans le produit final).
  • “Asymétriques” : Il s’agit de licences autorisant l’utilisation du composant dans un certain cadre, tout en limitant son usage en dehors de ce cadre. C’est, par exemple, une autorisation d’utiliser le composant pour le propre usage d’une entreprise, mais une interdiction d’en permettre l’usage pour les clients de cette même entreprise.

Il existe plusieurs dizaines d’autres licences. Il est nécessaire d’en faire le recensement et d’en étudier les contraintes juridiques avant d’intégrer les composants associés. A ce titre, il peut être judicieux de recourir aux conseils d’un juriste.

Enfin, il faut tenir compte des dépendances transitives ! Un composant Open Source n’arrive jamais seul, il est la plupart du temps lui même consommateur d’autres composants Open Source. Il convient de faire l’étude de chacune de ces dépendances pour faire son choix en connaissance de cause.

Le document produit par The Linux Foundation[3] donne une idée assez précise de ce qu’il convient de prendre en compte lors d’une étude de “compliance” d’un composant.

Lire la suite : Open Source et développement - Partie 2 : Versions, licences, évolutions et maintenance, la vie du composant Open Source après son intégration

Bibliographie

[1] The Value of Open Source Software
[2] ASF Project Security for Committers
[3] Open Source Compliance

🔲 ☆

AiFormat – Un outil en ligne de commande pour formater vos fichiers pour Claude

Si vous vous intéressez un peu aux outils IA, vous connaissez sûrement Claude, l’assistant IA dernière génération d’Anthropic. Depuis la sortie de sa version 3, c’est d’ailleurs devenu mon meilleur pote pour coder à la vitesse de l’éclair. j’ai même pris un abonnement payant en rusant un peu.

Toutefois, le seul truc qui me ralentissait dans mes grandes ambitions, c’était de devoir copier-coller à la main tous mes fichiers de code dans la fenêtre de contexte de Claude pour ensuite lui demander d’analyser ça, et me proposer des corrections ou une nouvelle fonction. Mais ça, c’était avant car je suis tombé sur un petit bijou opensource qui va vous changer la vie : AiFormat.

Ce petit outil en ligne de commande vous permet de sélectionner des fichiers et dossiers, et de les convertir automatiquement dans un format optimisé pour Claude. En deux clics, tout est dans le presse-papier, prêt à être envoyé à votre IA préférée.

Sous le capot, AiFormat utilise Ink, une chouette librairie pour créer des CLI avec une belle interface utilisateur. Ça vous permet de filtrer et naviguer dans vos fichiers, de les sélectionner avec les flèches, et tout ça de façon super intuitive.

Pour l’installer et le prendre en main, c’est hyper simple, tout est expliqué sur la page Github du projet. Ça commence par un simple :

npm install --global aiformat

Ensuite, pour utiliser aiformat, accédez au répertoire contenant les fichiers et dossiers que vous souhaitez partager avec Claude puis lancez la commande suivante :

aiformat

Le créateur a eu la bonne idée de mettre le projet en opensource (MIT license), du coup n’hésitez pas à y jeter un œil et même contribuer si le cœur vous en dit. La communauté vous dira merci !

Franchement, si vous utilisez souvent Claude pour coder ou analyser des projets, c’est un indispensable à avoir dans sa boîte à outils. Ça vous fera gagner un temps fou au quotidien.

❌