❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
☑️ ☆

Graphite – l’éditeur graphique open source qui va bousculer la création graphique

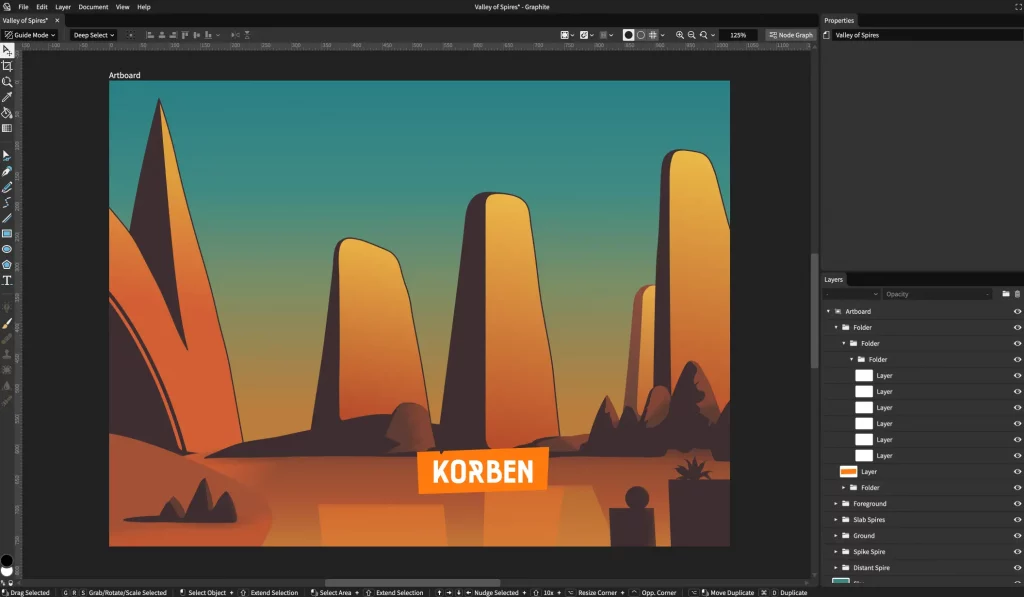
Vous êtes accros aux logiciels de retouche photo et de création graphique mais vous en avez marre de vider votre compte en banque pour des licences hors de prix ? Et si je vous disais qu’une solution très sympa open source et totalement gratuite était en train de voir le jour ? Laissez-moi vous présenter Graphite, un projet de dingue porté par une communauté de développeurs et d’artistes passionnés.

Alors, qu’est-ce que c’est que ce truc ? En gros, le but c’est de pondre une appli de graphics editing nouvelle génération qui coche toutes les cases : retouche photo, dessin vectoriel, peinture numérique, PAO, compositing, motion design… Rien que ça ! On est clairement sur un couteau suisse de la création 2D.

Bon, je vous vois venir avec vos gros sabots : « Ouais mais c’est encore un énième logiciel qui va essayer de faire comme Photoshop et cie mais en moins bien ! » Eh bah non, justement ! L’idée c’est pas de copier bêtement ce qui existe déjà mais d’innover en s’inspirant de ce qui se fait de mieux dans d’autres domaines, comme la 3D.

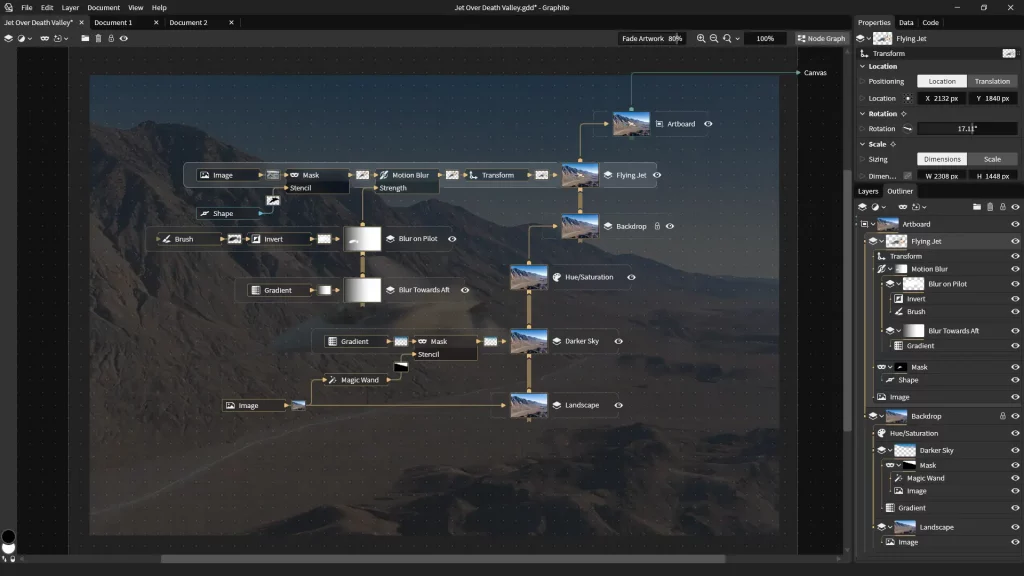
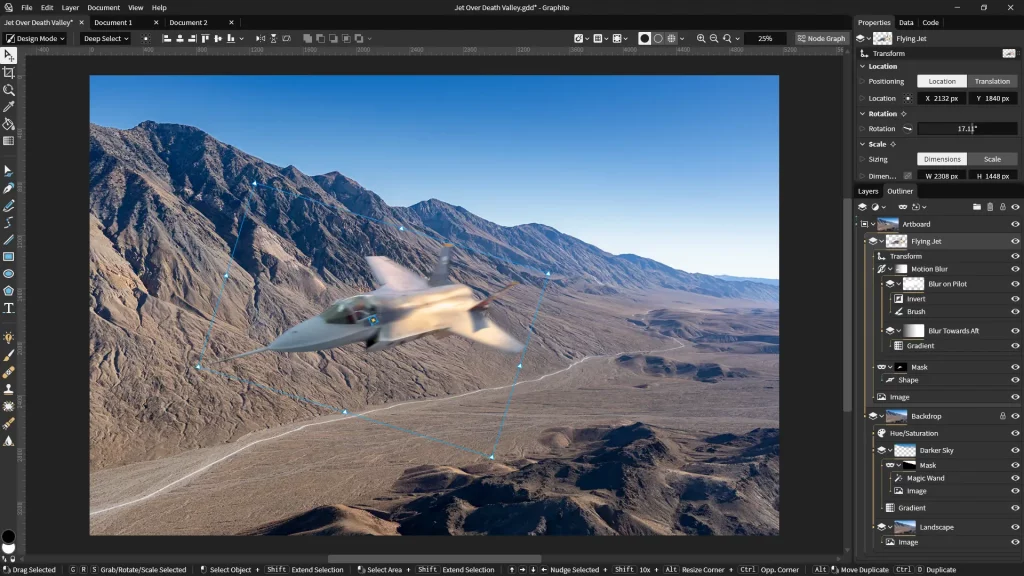
Le truc de malade dans Graphite, c’est qu’il est construit autour d’un node graph, une sorte de « compo visuel » où on branche des nœuds entre eux pour manipuler nos calques et leur appliquer des filtres et des effets à l’infini. Ça permet de garder la main à chaque étape et de pouvoir revenir en arrière sans perdre en qualité, ce qui est juste im-po-ssible dans les logiciels de retouche photo traditionnels. On appelle ça du non-destructif.

Autre point fort : Graphite gère aussi bien les images matricielles (bitmap) que vectorielles, et le tout avec une qualité d’affichage toujours au taquet, même si on zoom dans tous les sens ! Plus besoin d’avoir 36 000 applis et de jongler entre elles. C’est un peu le mix parfait entre le pixel et le vecteur (avec un soupçon de génération procédurale en plus).

Bon, alors, il sort quand ce petit bijou ? Figurez-vous que Graphite est déjà dispo en version alpha et qu’on peut le tester directement dans son navigateur. Pas besoin d’install, ça tourne full JavaScript côté client. Évidemment, à ce stade, c’est encore un peu brut de décoffrage et y’a pas mal de features prévues sur la roadmap qui ne sont pas encore implémentées. Mais ça donne déjà un bon aperçu du potentiel de la bête !

Et en parlant de potentiel, vous allez voir que les possibilités de création sont assez dingues. Vous pouvez par exemple générer des centaines de cercles de façon procédurale pour obtenir des motifs super stylés. Ou encore créer des structures complexes qui s’adaptent automatiquement, comme ces guirlandes de Noël dont les ampoules se replacent toutes seules quand on déforme le chemin. Magique !

Donc, si vous voulez voir ce projet de dingue prendre son envol, n’hésitez pas à mettre la main au portefeuille et à faire un don. C’est vous qui voyez, mais je pense que ça en vaut carrément le coup ! En tout cas, moi, j’ai déjà mis une étoile sur le repo Github 😉

☑️ ☆

IA générative : le MICS lance CroissantLLM, un modèle open source bilingue français-anglais

Les équipes de recherche du laboratoire MICS de CentraleSupélec ont développé avec Illuin Technology un nouveau modèle de langage (LLM) appelé CroissantLLM. Totalement ouvert, comptant 1,3 milliard de paramètres, il fonctionne efficacement sur du matériel local grand public y compris sur les ordinateurs personnels et smartphones d’entrée de gamme. Le modèle, qui est disponible sur la plateforme Hugging Face, sera présenté ce 7 mars dans le cadre de l’événement “Les Ateliers de l’IA”, à Paris La Défense et en distanciel.

CroissantLLM est présenté comme un modèle de langage souverain, ouvert, éthique, frugal, étant le fruit d’une collaboration entre académie et industrie, comme Céline Hudelot, professeure, Directrice du laboratoire MICS, l’explique :

“Ce travail est le fruit d’une collaboration étroite entre académie et industrie, illustrant l’importance de la synergie dans l’avancée de la recherche en IA. CroissantLLM résulte en effet des travaux menés par CentraleSupélec en collaboration avec plusieurs partenaires académiques de renom tels que Sorbonne Université, INESC-ID, Instituto Superior Técnico, Carnegie Mellon University et Institut DATAIA. Elle a aussi pu voir le jour grâce au soutien précieux de partenaires industriels : ILLUIN Technology ainsi que Unbabel, Diabolocom, et EqualAI”.

Le modèle a été développé par une équipe de recherche française qui s’est appuyée sur le supercalculateur Jean Zay au sein du GENCI. Plutôt que de l’entraîner sur des corpus à dominante anglaise comme l’ont été les modèles les plus récents, l’équipe a choisi de le faire sur une quantité égale de données en français et en anglais, ce qui lui permet d’intégrer et de maîtriser les spécificités de la langue et de la culture françaises.

Dans ce but, l’équipe a collecté plus de 303 milliards de tokens de données françaises ainsi que 36 milliards de tokens de données de traduction français-anglais, toutes publiques. L’ensemble d’entraînement compte 3 000 milliards de données de jetons après suréchantillonnage, soit plus que celui de Llama 2.

CroissantLLM, basé sur l’architecture Llama, compte 1,3 milliard de paramètres, une taille qui permet une exécution rapide sur des serveurs GPU bas de gamme et une vitesse décente sur des appareils mobiles ou des processeurs. Le modèle est ainsi accessible à un large éventail d’utilisateurs, que ce soit pour des applications industrielles spécifiques, des traductions ou le chat.

Les évaluations du modèle

Pour évaluer les performances du modèle en français, les chercheurs ont introduit FrenchBench, qui se compose de diverses tâches de classification et de génération. Ils l’ont par ailleurs également évalué sur des benchmarks anglais.

Les évaluations montrent que CroissantLLM offre des performances compétitives tant en anglais qu’en français. Sur les benchmarks de classification français, CroissantLLM surpasse largement les modèles de tailles similaires entraînés principalement sur des données monolingues anglais ou français, ainsi que les modèles multilingues. Il devance des modèles jusqu’à 3 fois plus grands sur la plupart des tâches (Bloom 3B).

Pour CroissantLLM Chat, les chercheurs ont affiné CroissantLLM sur des données de chat, notamment sur des interactions avec ChatGPT, afin de développer ses compétences de conversation dans les deux langues.

Un modèle transparent et éthique

L’équipe de recherche a veillé au respect des règles fixées par le récent AI Act afin de faire de CroissantLLM un modèle éthique.

Manuel Faysse, l’un des membres de l’équipe de recherche, explique dans un blog sur Hugging Face :

“L’initiative CroissantLLM a été conçue dès le départ dans un souci de transparence. Nous validons 81 % des critères de transparence du cadre FMTI, bien au-delà des scores des initiatives les plus ouvertes, en publiant les données, les modèles, la procédure de formation et tout le code utilisé pour conserver les données et entraîner le modèle”. 

Les modèles, ensembles de données, codes de formation, critères d’évaluation et données sont entièrement open source :

Références de l’article : blog Manuel Faysse

IA générative le MICS lance CroissantLLM, un modèle open source bilingue français-anglais

☑️ ☆

GitHub Accelerator : Lancement de l’appel à candidatures pour la Cohorte 2024

GitHub, la plateforme de développement collaboratif et de partage de code, a ouvert les candidatures pour sa deuxième cohorte du programme GitHub Accelerator, qui vise à aider les développeurs à travailler sur l’IA open source. Le programme, qui durera 10 semaines, offrira aux participants, notamment aux start-ups en phase d’amorçage, un financement de 40 000 $, un mentorat d’experts et de partenaires, ainsi qu’un accès à des ressources et des opportunités exclusives. Les candidats ont jusqu’au 5 mars prochain pour déposer leur projet.

L’initiative GitHub Accelerator a pour objectif de créer des carrières et des entreprises viables dans l’open source, en reconnaissant la valeur et l’impact des projets qui innovent et résolvent des problèmes réels. Après une première cohorte réussie, qui a couvert divers domaines tels que le web, le mobile, le design, la mode, l’éducation, la biologie…, la seconde se concentrera sur les nouvelles frontières et technologies de l’IA.

Stormy Peters, vice-présidente des communautés chez GitHub, déclare :

“La création d’une entreprise d’IA prospère à l’air libre comporte son lot de défis. En plus des obstacles liés au temps et au financement que nous connaissons déjà dans l’open source, les dépenses accrues et les considérations éthiques, sécuritaires et juridiques sont décourageantes. Nous considérons ces défis comme un risque pour l’innovation mondiale et nous espérons y contribuer.

Cette cohorte d’accélérateurs se concentrera sur le financement des personnes et des projets qui construisent des solutions basées sur l’IA sous une licence open source pour améliorer le monde qui les entoure”.

Dix projets seront sélectionnés, évalués sur la base de critères tels que la qualité, la pertinence, la diversité et la viabilité, qu’ils soient ou non hébergés sur GitHub. Un nombre croissant d’utilisateurs actifs sera un plus.

Les détails du programme

Le programme GitHub Accelerator débutera le 22 avril et comprendra un mélange de sessions individuelles, de sessions de groupe, de travaux de projet et de mentorat. Les participants recevront également :

  • 40 000 $ par projet en financement non dilutif.
  • 5 à 10 heures par semaine d’instruction en direct, d’ateliers et de devoirs.
  • Des heures de bureau avec l’équipe GitHub pour des revues de sécurité.
  • Des séances de questions-réponses avec des sponsors d’entreprise GitHub, des membres de la communauté et des leaders de GitHub.
  • Une introduction et au moins une heure de bureau avec M12, le fonds de capital-risque de Microsoft.
  • Un accès gratuit aux produits GitHub pertinents, y compris une année complète de GitHub Copilot.
  • Les projets éligibles recevront des crédits gratuits d’infrastructure Azure AI, y compris un accès privilégié à des clusters de machines virtuelles GPU haut de gamme et un support personnalisé de mise sur le marché.
  • Un canal Slack partagé avec la cohorte pour collaborer et se soutenir mutuellement.

Les projets sélectionnés seront présentés lors d’un événement virtuel organisé par GitHub à la fin du programme, où ils pourront montrer leurs progrès, leurs défis et leurs ambitions. Le programme GitHub Accelerator espère ainsi contribuer à faire avancer l’IA open source, en mettant en lumière les talents et les idées qui la font vivre.

GitHub Accelerator Lancement de l'appel à candidatures pour la Cohorte 2024

☑️ ☆

Comment Hugging Face reste à la pointe de l’innovation

Hugging Face ne cesse d’innover : fin janvier, l’entreprise a non seulement annoncé de nouveaux LLM open-source en tant qu’agents LangChain, un partenariat stratégique avec Google Cloud, l’optimisation de StarCoder mais également  Hugging Chat Assistants, une boutique de chatbots personnalisés sur Hugging Chat à l’instar de GPT Store, mais contrairement à ce dernier, ceux de Hugging Face sont gratuits et open source.

Passée au rang de licorne après une levée de fonds de 235 millions de dollars en août dernier, Hugging Face, start-up créée à Paris en 2016, continue de jouer un rôle fondamental dans l’accélération de la recherche en IA grâce à son approche open source.

Dans son article de blog le 24 janvier dernier, Hugging Face expliquait comment construire et évaluer des agents de raisonnement à usage général basés sur les grands modèles de langage (LLM) open source comme Mixtral-8x7B , en utilisant la classe ChatModel de LangChain et l’approche ReAct.

L’article du 30 janvier suivant présentait les résultats de l’optimisation de son modèle de génération de code développé en collaboration avec Service Now, StarCoder (15B) sur Intel Xeon de 4e génération, en utilisant la quantification 8 bits et 4 bits et la génération assistée. En combinant la quantification 8 bits et la génération assistée, le modèle StarCoder atteint une accélération d’inférence de plus de 7 fois par rapport au modèle de référence, sans perte de qualité.

Entre temps, Hugging Face annonçait un partenariat stratégique avec Google Cloud, afin de rendre l’IA plus accessible et plus performante pour les entreprises, en s’appuyant sur les modèles ouverts et les technologies open source.

Le partenariat vise à combiner les avantages de la plateforme ouverte de Hugging Face, qui permet aux scientifiques des données, aux ingénieurs en ML et aux développeurs d’accéder aux derniers modèles de la communauté, et de les utiliser sur la plateforme de leur choix à ceux de la plateforme Vertex AI de Google Cloud qui permet de déployer des modèles d’IA ainsi que d’assurer leur maintenance.

Il facilite ainsi l’intégration des modèles ouverts de Hugging Face dans Vertex AI et GKE (Google Kubernetes Engine) et permet aux clients de Google Cloud d’exploiter les modèles de Hugging Face et les fonctionnalités avancées de Google Cloud, comme Vertex AI et les TPU, pour développer et déployer des applications d’IA plus efficacement.

Les deux entreprises ont également annoncé qu’elles allaient collaborer sur les plans de la science ouverte, de l’open source, du cloud et du matériel, pour rendre les dernières innovations en intelligence artificielle plus accessibles à la communauté.

Hugging Face Assistants, l’alternative open source et gratuite à GPT Store

Le 2 février dernier, Hugging Face présentait Hugging Chat Assistants, qui permet de créer des chatbots après avoir créé un compte Hugging Face (gratuit), sa boutique fonctionne comme le GPT Store déployé en janvier dernier par Open AI.

Alors que celui-ci permet aux abonnés de ChatGPT Plus, Enterprise et de la nouvelle offre ChatGPT Team de créer leurs assistants à partir de ChatGPT, ceux de Hugging Face le seront à partir du chatbot open source Hugging Chat.

Pour le personnaliser, les utilisateurs peuvent s’appuyer sur les modèles open source Mixtral 8x7B et mistral 7B Instruct de Mistral AI, Llama-2 70B et CodeLlama 70B Instruct de Meta, Hermes 2 – Mixtral 8x7B – DPO , formé par Nous Research sur le LLM Mixtral 8x7B MoE et OpenChat 3.5.

Selon Julien Chaumond, cofondateur et CTO de Hugging Face, en à peine 3 jours, 4 000 assistants avaient été créés et 1 500 utilisateurs  avaient discuté avec son  propre clone  “Clone of HF CTO”.

Il ajoute que suite aux premiers retours de la communauté, Hugging Face envisage d’introduire les éléments suivants :

  • Possibilité de modifier vos assistants via l’API, permettant ainsi d’envoyer des informations actualisées à vos assistants à tout moment.
  • Intégration de RAG (et de la fonctionnalité de recherche sur le Web) à l’Assistant, enrichissant ainsi ses capacités de recherche et de réponse.
  • Fonctionnalité pour générer votre assistant de vignettes via l’IA, offrant une manière intuitive et automatisée de créer des représentations visuelles pour vos assistants.
  • Proposition de modifications sur les assistants d’autres utilisateurs, favorisant ainsi la collaboration et l’amélioration collective des assistants.
  • Ajout régulier de nouveaux modèles à HuggingChat et aux Assistants, garantissant une variété et une qualité constantes des modèles disponibles pour les utilisateurs.


Comment-Hugging-Face-pointe-innovation

☑️ ☆

Start of an Era

Bing Create’s visual answer to the prompt, “A world of open source software and hardware.”

After 17 years and 761 episodes, FLOSS Weekly ended its run on the TWiT network yesterday. I hosted the last 179 of those shows. My career as a professional (meaning paid) advocate of open source also ended with that show. The full span ran from 1996, when I first appeared on the Linux Journal masthead, until yesterday: about 27 years.

I still participate in market conversations around the many topics I covered in that span, but I’m mostly working on other stuff now. For example, in random-ish order:

All of those are cars in a cluetrain, about which more below.

They are also featured now and then on Reality 2.o, the podcast Katherine Druckman and I have been doing since our Linux Journal days.

For many decades now, I’ve been spoiled by success. For example, open source, an expression whose current meaning was born in 1998, is now beyond huge. Here’s VentureBeat:

Today, open-source software underpins almost everything: A whopping 97% of applications leverage open-source code, and 90% of companies are applying or using it in some way.

GitHub alone had 413 million open-source software (OSS) contributions in 2022.

“Open-source software is the foundation of 99% of the world’s software,” said Martin Woodward, VP of developer relations at GitHub.

By covering open source for Linux Journal from the start, I helped make that happen.

Same with The Cluetrain Manifesto. “Markets are conversations,” a one-liner of mine that became the first thesis in the manifesto, grew to become a meme that hasn’t gone away. The word cluetrain also appears almost daily in tweets on X, almost a quarter century after it was coined. (When Twitter was still itself, cluetrain was mentioned in tweets several times daily. The decline in cluetrain mentions is one small measure of how lame X has become.)

Also blogging!

Hmmm… I don’t think I ever blogged about my only encounter with Robin Williams. It was at some trade show in the early aughts. There was a scrum of attendees gathered around something or someone unseen in the middle. On the periphery was my old friend Tom Rielly, who quickly grabbed me and pulled me into the middle of the crowd, where stood Robin Williams, with two bags of swag. I almost said, “Hey, you look like Robin Williams, only shorter.” Then Tom introduced me, saying “This is Doc. He’s one of the top five bloggers in the world.” I said, “More like one of the top sixteen, but most of the others are duplicates.” Robin then said something funny, and I responded with something funny of my own, and an all-funny exchange ensued during which my separate self said, “Holy shit! I’m doing humor schtick with Robin Williams and holding my own!” After maybe half a minute of this, I excused myself, saying something like, “I’ll leave you to your private audience here,” and exited the crowd.

Oh, and photography. As of this moment, my photos have had 16,855,107 views on one Flickr account, and 1,470,281 on the other. Visits to those run from the hundreds to thousands per day. A search for my name on Wikimedia Commons also brings up 1850 results, nearly all of which are photos I’ve shared using Creative Commons licensing that encourages use and re-use, which is why many (or most) of them find their way into Wikipedia articles.

I’ve had less luck with the other missions I’ve listed above. But I believe in all of them, and in faith, I truck onward.

By the way, FLOSS Weekly has not slipped below the waves. I expect it will be picked up somewhere else on the Web, and wherever you get your podcasts. (I love that expression because it means podcasting isn’t walled into some giant’s garden.) When FLOSS Weekly becomes re-manifest, I’ll point to it here.

☑️ ☆

Syndication and the Live Web Economy

This is from a December 2009 newsletter called Suitwatch, which I wrote for Linux Journal, and was 404’d long ago. (But I kept the original.) I’m re-posting it here because I think syndication may be the most potent power any of us have in the Internet age—and because the really simple kind, RSS, has been with us since before I wrote this piece. (I also think RSS has VRM implications as well, but I’ll leave those for another post.) My only edits here were to remove arcana and anachronisms that are pointless today. This graphic illustrates how entrenched and widespread RSS already is:

Until recently, the verb “syndication” was something big publishers and agencies did. As a kid, I recognized “© King Features Syndicate” was the one unfunny thing about Blondie or Dennis the Menace. All it meant to me was that some kind of Business was going on here.

Now millions of individual writers syndicate their own work, usually through RSS (Really Simple Syndication). Publishers and other large organizations do too. This article is syndicated. So are updates to product manuals, changes to development wikis, updates on SourceForge, and searches of keywords. You name it: if there’s something that updates frequently on the Web, there’s a better chance every minute that the new stuff is syndicated if it isn’t already.

Far as I know, not many sources are making money with it. Lots, however, are making money because of it. The syndicated world may not look like an economy yet. But trust me, it is.

At this early stage in its long future history, syndication is primarily a feature of blogging, which is primarily the product of too many people to count. Blogging is not about large-scale things. It’s about human beings who have no scale other than themselves. Only you can be good at being you, and nobody else is the same as you. Syndication does more to expand individual human potential than anything since the invention of type. Or perhaps ever. The syndicated world economy is the one that grows around unleashed personal powers of expression, productivity, creation, distribution, instruction, influence, leadership, whatever.

In a loose sense, syndication is one side of the conversation. Think about conversation in the best sense of the word: as the way people teach and learn from each other, the way topics start and move along. Syndication makes that happen in huge ways.

The notion that “markets are conversation”, popularized by The Cluetrain Manifesto, was borrowed from this case I used to make for a form of marketing that was far more natural and powerful than the formal kind:

  1. Markets are conversation, and
  2. Conversation is fire. Therefore,
  3. Marketing is arson.

If you want to set fires, start conversations that tend to keep going. Nothing does the latter better than syndication.

There are three reasons why we still don’t hear as much about syndication as we should (and will). First, it’s still new. Second, it didn’t come from The Big Guys. (It came from Dave Winer, father of RSS — Really Simple Syndication.) Third, it points toward a value system not grounded only in exchange — one especially suited for the Net, a deeply ironic worldwide environment where everybody is zero distance apart.

But let’s park the value system until later and talk about next week. That’s when I’ll be in San Francisco for Syndicate. It’s the second in a series of conferences by that name. The first was in New York last Spring.

Since I’m the conference chair (disclosure: it’s a paying gig), and since I’ll be giving both the introductory talk and the closing keynote, Syndication is on the front burner of my mind’s stove.

There are others subjects there as well, some of which will be visited in sessions at the show. RSS, for starters. And tagging—a practice so new it’s not even close to having standards of the sort we find at OASIS, the IETF, and the W3C. Instead, it has emerging standards, like the ones we find at microformats.org.

Like syndication, tagging is a long-tail activity. Something individuals do. Along with blogging and syndication, it helps outline a new branch of the Net we’re starting to call the Live Web — as opposed to the Static Web with “sites” that are “built” and tend not to change.

The World Live Web is the title of my December Linux For Suits column in Linux Journal. In it, I note that the directoryless nature of everything on the Web falls in the Unix file path east of the domain name. Every path to a document (or whatever) is a piece of straw in the static Web’s haystack. Google and Yahoo help us find needles in that haystack, but their amazing success at search also tends to confirm the haystack nature of the Static Web itself.

The Live Web is no less webby than the Static Web. They’re both parts of the same big thing. But the Live Web is new and very different. It cannot be understood in Static Web terms.

In that piece, I also observed that blogs, as continuing projects by human authors, leave chronological trails. These give the Live Web something of a structure: a chronological one that goes /year/month/day/date/post, even if that’s not the way each post’s URL is composed. There is an implicit organizational structure here, and it’s chronological.

Tagging, by which individuals can assign categorical tags of their own to everything from links to bookmarks to photos, has given the Live Web an ad hoc categorical structure as well.

So that’s what we’re starting to see emerge here: chronology and category. Rudimentary, sure, but real. And significant.

But not organized. New practices, and new ideas, are coming along too fast.

What matters, above all, is user-in-charge: a form of personal agency in the connected world. That’s a concept so key to everything else that’s happening on the Web, even on the Static one, that we may need a new word for it.

Or an old one, like independence, liberty, sovereignty, or autonomy. That’s my inner Libertarian, choosing those. If your sensibilities run a bit more to the social side, you may prefer words like actualization or fulfillment. Point is, the Big Boys aren’t in charge anymore. You are. I am. We are.

There’s an economy that will grow around us. I think free software and open-source practices (see various books and essays by Richard M. Stallman and Eric S. Raymond) put tracks in the snow that point in the direction we’re heading, but the phenomenon is bigger than that.

It’s also bigger than Google and Yahoo and Microsoft and IBM and Sun and Red Hat and Apple and the rest of the companies people (especially the media) look to for Leadership. For all the good those companies do in the world, the power shift is underway and is as certain as tomorrow’s dawn. The Big Boys will need to take advantage of it. We’ll need them to, as well.

This power shift is what I’d like to put in front of people’s attention when they come to Syndicate next week, or when they follow the proceedings in blogs and other reports.

Now more than ever, power is personal. Companies large and small will succeed by taking advantage of that fact. And by watching developments that aren’t just coming from The Usual Suspects. Including the Usual Economic Theories.

For example, not everything in an economy is about exchange, or the value chain, or about trade-offs of this for that. Many values come out of effort and care made without expectation of return. Consider your love for your parents, spouses, children, friends, and good work. Consider what you give and still get to keep. Consider debts erased by forgiveness. Consider how knowledge grows without its loss by anyone else.

Sayo Ajiboye, the Nigerian minister who so blew my mind in conversations we had on a plane nearly five years ago (Google them up if you like), taught me that markets are relationships, and not just conversations. Relationships, he said, are not just about exchange. They cannot be reduced to transactions. If you try, you demean the relationships themselves.

Also, in spite of the economic framings of our talk about morality and justice (owing favors, paying for crimes, just desserts), there is a deeper moral system that cannot be understood in terms of exchange. In fact, when you bring up exchange, you miss the whole thing. (Many great teachers have tried in futility to make this point, and I’m probably not doing any better.) Whatever it is, its results are positive. Growth in one place is not matched by shrinking in another. Value in both systems is created. But in the latter one, the purpose is not always, or exclusively, exchange, or profit. At least not from the activity itself. There are because effects at work. And we’re only beginning to understand them, much less practice them in new ways.

Toward that end, some questions…

Where did the Static Web, much less the Live Web, come from? What is it for? What are we doing with it? Whatever the answers, nothing was exchanged for them. (No, not even the record industry, the losses of which owe to their own unwillingness to take advantage of new opportunities opened by the Net.)

Nor was anything exchanged for Linux, which has grown enormously.

As Greg Kroah-Hartman said recently on the Linux-Elitists list,

Remember, Linux is a species, and we aren’t fighting anyone here, we are merely evolving around everyone else, until they aren’t left standing because the whole ecosystem changed without them realizing it.

Yes, we have living ends.
❌